Pytorch|零基础入门(六) 神经网络卷积层+池化层
conv2d
一、conv2d 核心概念(通俗解释)
conv2d 即二维卷积,你可以把它理解为:
- 用一个小的矩阵(卷积核/过滤器) 在大的输入矩阵(如图像) 上滑动;
- 每滑动到一个位置,就将卷积核与对应位置的输入矩阵元素相乘后求和;
- 最终得到一个特征图(Feature Map),这个过程能提取图像的边缘、纹理等特征。
举个直观例子:
- 输入:一张 5×5 的灰度图(二维矩阵);
- 卷积核:3×3 的矩阵(比如边缘检测核);
- 输出:通过卷积计算得到的 3×3 特征图(假设无填充、步长为1)。
二、conv2d 关键参数
PyTorch 的 torch.nn.Conv2d 是最常用的实现,核心参数如下:
| 参数 | 作用 | 通俗解释 |
|---|---|---|
in_channels | 输入通道数 | 灰度图=1,RGB彩色图=3 |
out_channels | 输出通道数 | 用多少个卷积核,就输出多少个特征图 |
kernel_size | 卷积核大小 | 如 3 表示 3×3 卷积核,(3,5) 表示 3×5 卷积核 |
stride | 步长 | 卷积核每次滑动的像素数,默认=1 |
padding | 填充 | 给输入矩阵边缘补0的层数,避免输出尺寸缩小 |
bias | 是否加偏置 | 每个输出通道是否加一个可学习的偏置,默认=True |
三、conv2d 代码示例(PyTorch)
下面是一个可直接运行的示例,演示如何用 Conv2d 处理图像数据:
import torch
import torch.nn as nn

# 1. 定义Conv2d层
# 输入通道=3(RGB图),输出通道=16(16个卷积核),卷积核3×3,步长1,填充1
conv_layer = nn.Conv2d(
    in_channels=3,
    out_channels=16,
    kernel_size=3,
    stride=1,
    padding=1,
    bias=True
)

# 2. 构造模拟输入:(batch_size, channels, height, width)
# 批量大小=2,3通道,高/宽=32(模拟32×32的RGB图)
input_data = torch.randn(2, 3, 32, 32)

# 3. 执行卷积操作
output = conv_layer(input_data)

# 4. 打印输入/输出尺寸
print(f"输入尺寸: {input_data.shape}")  # torch.Size([2, 3, 32, 32])
print(f"输出尺寸: {output.shape}")    # torch.Size([2, 16, 32, 32])
# 注:padding=1、stride=1时,输出尺寸 = 输入尺寸(32×32)
代码关键解释:
- 输入尺寸格式:PyTorch中
Conv2d要求输入为(批量数, 通道数, 高, 宽),这是深度学习框架的通用规范;
输出尺寸=⌊输入尺寸+2×padding−kernel_size]/stride+1
- 参数学习:
Conv2d的卷积核和偏置是可学习的参数,会在训练中通过反向传播更新。
四、conv2d 的实际应用场景
- 图像分类:提取图像的低级特征(边缘)→ 中级特征(纹理)→ 高级特征(物体部件);
- 目标检测/分割:作为特征提取的基础模块;
- 语音处理:将语音频谱图作为二维数据,用conv2d提取频谱特征。
总结
conv2d是处理二维数据的核心卷积操作,核心是卷积核滑动+元素乘加;- PyTorch中
nn.Conv2d的关键参数是通道数、卷积核大小、步长、填充,需根据需求调整; - 输出尺寸由输入尺寸、padding、stride、kernel_size共同决定,这是使用时的核心计算点。
神经网络卷积层(Convolutional Layer)使用
卷积层是卷积神经网络(CNN) 的核心组件,其设计灵感来源于生物视觉系统的感受野机制,主要作用是提取输入数据的局部特征(如图像的边缘、纹理、形状),同时通过权值共享和稀疏连接大幅降低模型参数数量,提升训练效率和泛化能力。
一、卷积层的核心概念
1. 输入与输出
- 输入:对于计算机视觉任务,输入通常是多维张量,形状为
[batch_size, in_channels, height, width]batch_size:批次大小(一次训练的样本数)in_channels:输入通道数(灰度图为1,RGB彩色图为3)height/width:输入特征图的高和宽
- 输出:称为特征图(Feature Map),形状为
[batch_size, out_channels, out_h, out_w]out_channels:输出通道数(等于卷积核的数量,决定提取特征的种类)out_h/out_w:输出特征图的高和宽
2. 卷积核(Kernel/Filter)
卷积核是卷积层的核心参数,本质是一个小型的可学习权重矩阵,形状为 [out_channels, in_channels, kernel_h, kernel_w]。
- 每个卷积核对应一个输出通道,负责提取一种特定的局部特征(如垂直边缘、水平边缘)。
- 卷积核的大小通常为奇数(如 3×3、5×5),便于设置填充(Padding) 时保持特征图尺寸对称。
3. 权值共享(Weight Sharing)
传统全连接层中,每个神经元与输入的所有神经元连接,参数数量巨大;而卷积层中,同一个卷积核的权重在整个输入特征图上重复使用。
- 例如:用 3×3 卷积核处理 28×28 的图像,仅需 9 个权重参数,而非全连接的 784 个。
- 优势:大幅减少参数数量,降低过拟合风险,同时保证特征提取的平移不变性(图像中相同特征在不同位置可被同一卷积核识别)。
4. 稀疏连接(Sparse Connectivity)
卷积核只与输入特征图的局部区域连接(局部感受野),而非全局连接。
- 局部感受野的大小等于卷积核的尺寸,例如 3×3 卷积核的感受野为 3×3。
- 优势:符合视觉系统的局部性原理(图像的局部特征关联性更强),进一步减少计算量。
二、卷积层的工作原理
卷积层的核心操作是二维卷积运算,步骤如下:
- 滑动卷积核:将卷积核在输入特征图上按固定步长(Stride)滑动,每次滑动覆盖一个局部感受野。
- 计算点积:将卷积核的权重与覆盖区域的输入值逐元素相乘,然后求和,得到输出特征图上的一个像素值。
- 偏置项(Bias):每个输出通道对应一个偏置,将点积结果加上偏置,得到最终的像素值。
- 激活函数:卷积运算后通常会接激活函数(如 ReLU),引入非线性,让模型能够拟合复杂特征。
关键公式
1. 输出特征图尺寸计算
out_size=⌊in_size+2×padding−kernel_size⌋/stride+1
- 小数点向下取整
padding:在输入特征图的四周填充的像素数(通常为 0 或(kernel_size-1)/2)
2. 卷积运算的数学表达式
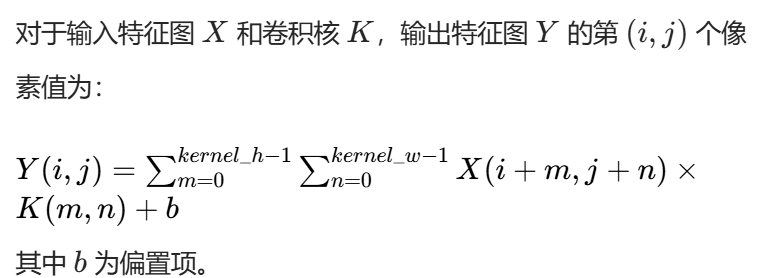
三种常见的卷积模式
根据 padding 和 stride 的设置,卷积层有三种常见模式:
| 模式 | Padding 设置 | 输出尺寸特点 | 适用场景 |
|---|---|---|---|
| 有效卷积(Valid) | padding=0 | 输出尺寸小于输入尺寸 | 需缩小特征图尺寸时 |
| 相同卷积(Same) | padding=(kernel_size-1)/2 | 输出尺寸等于输入尺寸 | 需保持特征图尺寸不变时 |
| 全卷积(Full) | padding=kernel_size-1 | 输出尺寸大于输入尺寸 | 需保留输入边缘信息时 |
三、卷积层的关键参数
在 PyTorch 中,卷积层通过 torch.nn.Conv2d 实现,核心参数如下:
| 参数名 | 作用 | 常用值 |
|---|---|---|
in_channels | 输入通道数 | 1(灰度图)、3(RGB图) |
out_channels | 输出通道数 | 16、32、64(随网络深度增加) |
kernel_size | 卷积核尺寸 | 3、5(元组如 (3,5) 表示非正方形核) |
stride | 滑动步长 | 1(默认)、2(下采样时) |
padding | 填充像素数 | 0、1、2(或字符串 "same"/"valid") |
dilation | 空洞卷积的膨胀率 | 1(普通卷积)、2(扩大感受野) |
groups | 分组卷积的组数 | 1(普通卷积)、等于 in_channels 为逐通道卷积 |
bias | 是否使用偏置项 | True(默认)、False |
扩展:空洞卷积(Dilated Convolution)
当 dilation > 1 时,卷积核会被“膨胀”,在权重之间插入 dilation-1 个零,从而扩大感受野而不增加参数数量。
- 例如:3×3 卷积核,
dilation=2时,感受野扩大为 5×5,而参数仍为 9 个。 - 适用场景:语义分割任务,需在不降低分辨率的前提下扩大感受野。
扩展:分组卷积(Group Convolution)
当 groups > 1 时,输入通道和输出通道会被分成 groups 组,每组独立进行卷积运算,最后拼接结果。
- 例如:
in_channels=64,out_channels=64,groups=32,则每组处理 2 个输入通道,输出 2 个通道。 - 优势:减少参数数量和计算量,是 MobileNet 等轻量级网络的核心技术。
四、手动计算示例(3×3 相同卷积)
以灰度图输入为例,直观理解卷积运算过程:
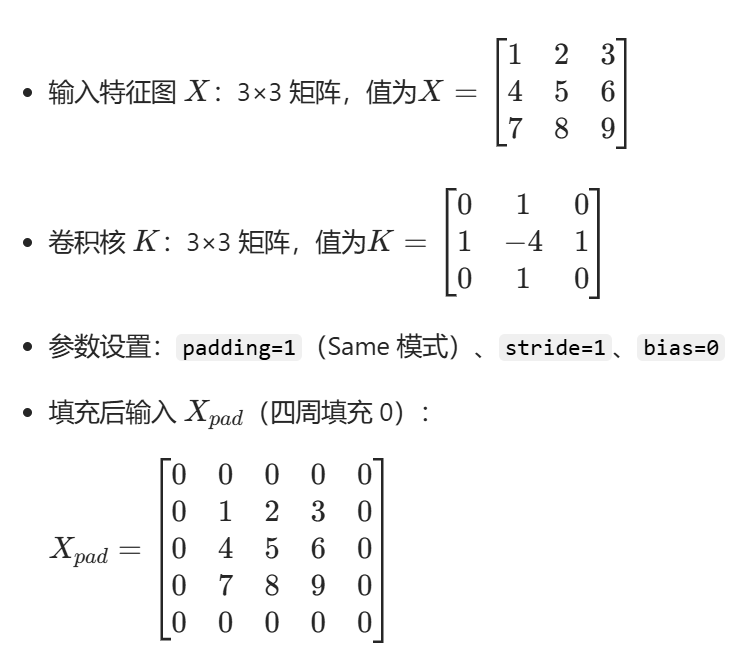
计算输出特征图 Y
- 卷积核滑动到左上角(覆盖 $X_{pad}$ 的 0-2 行、0-2 列): Y(0,0) = (0×0)+(0×1)+(0×0)+(0×1)+(1×-4)+(2×1)+(0×0)+(4×1)+(5×0) = -4 + 2 + 4 = 2
- 按步长 1 滑动卷积核,依次计算所有位置的点积,最终得到 3×3 的输出特征图Y
五、实战:卷积层的实现与应用
下面通过一个手写数字识别的简化示例,展示卷积层在 PyTorch 中的使用方法。
1. 导入必要库
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms
2. 定义 CNN 模型(含卷积层)
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        # 第一层卷积:输入通道1,输出通道16,卷积核3×3,Same卷积,步长1
        self.conv1 = nn.Conv2d(in_channels=1, out_channels=16, kernel_size=3, padding=1, stride=1)
        self.relu = nn.ReLU()  # 激活函数
        # 第二层卷积:输入通道16,输出通道32,卷积核3×3,Same卷积,步长1
        self.conv2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1, stride=1)
        # 池化层:下采样,降低特征图尺寸
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
        # 全连接层:将特征图展平为一维向量
        self.fc = nn.Linear(32 * 7 * 7, 10)  # 输入尺寸:32×7×7,输出类别数:10

    def forward(self, x):
        # 前向传播:卷积 -> 激活 -> 池化 -> 卷积 -> 激活 -> 池化 -> 展平 -> 全连接
        x = self.pool(self.relu(self.conv1(x)))  # 输出尺寸:16×14×14
        x = self.pool(self.relu(self.conv2(x)))  # 输出尺寸:32×7×7
        x = x.view(-1, 32 * 7 * 7)  # 展平:[batch_size, 32*7*7]
        x = self.fc(x)
        return x
3. 数据加载与模型训练
# 数据预处理:将PIL图像转换为张量,并归一化
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))])

# 加载MNIST手写数字数据集
train_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=64, shuffle=True)

# 初始化模型、损失函数和优化器
model = SimpleCNN()
criterion = nn.CrossEntropyLoss()  # 交叉熵损失
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)  # Adam优化器

# 训练模型
num_epochs = 3
for epoch in range(num_epochs):
    running_loss = 0.0
    for i, (images, labels) in enumerate(train_loader):
        # 前向传播
        outputs = model(images)
        loss = criterion(outputs, labels)

        # 反向传播与优化
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if (i+1) % 100 == 0:
            print(f'Epoch [{epoch+1}/{num_epochs}], Step [{i+1}/{len(train_loader)}], Loss: {running_loss/100:.4f}')
            running_loss = 0.0

print('训练完成!')
4. 关键代码解释
nn.Conv2d:实现二维卷积层,参数设置直接影响特征提取效果。forward函数:定义模型的前向传播路径,卷积层和激活函数、池化层交替使用。- 池化层(
nn.MaxPool2d):与卷积层配合使用,降低特征图尺寸,减少计算量,同时保留关键特征。
六、常见问题与注意事项
- 卷积核数量选择:网络浅层的卷积核数量较少(如 16、32),深层的卷积核数量较多(如 64、128),因为深层需要提取更复杂的特征。
- 步长与池化的区别:步长大于 1 时,卷积层本身可以实现下采样;池化层则是通过取局部最大值/平均值实现下采样,无参数。
- padding 的作用:避免卷积运算后特征图尺寸缩小过快,同时保留图像边缘的特征信息。
- 过拟合问题:卷积层虽然参数较少,但深层 CNN 仍可能过拟合,可通过 Dropout、数据增强等方法缓解。
七、实战延伸
- 可视化卷积核与特征图:通过提取卷积层的权重和中间输出,可直观查看卷积核学习到的特征和特征图的变化。
- 尝试不同卷积核尺寸:对比 3×3 和 5×5 卷积核的效果,理解小卷积核叠加(如 3×3+3×3)等价于大卷积核(5×5)的感受野,且参数更少。
三种常见的卷积模式
根据 padding 和 stride 的设置,卷积层有三种常见模式:
| 模式 | Padding 设置 | 输出尺寸特点 | 适用场景 |
|---|---|---|---|
| 有效卷积(Valid) | padding=0 | 输出尺寸小于输入尺寸 | 需缩小特征图尺寸时 |
| 相同卷积(Same) | padding=(kernel_size-1)/2 | 输出尺寸等于输入尺寸 | 需保持特征图尺寸不变时 |
| 全卷积(Full) | padding=kernel_size-1 | 输出尺寸大于输入尺寸 | 需保留输入边缘信息时 |
神经网络池化层使用
一、核心原理与类型
池化层通过滑动固定窗口对特征图做局部聚合计算,无训练参数,仅通过超参数控制输出特征图尺寸。
| 池化类型 | 核心计算 | 适用场景 | 特点 |
|---|---|---|---|
| 最大池化(Max Pooling) | 取窗口内最大值 | 图像分类、目标检测 | 保留显著特征,把数据量减小,抗干扰强 |
| 平均池化(Average Pooling) | 取窗口内平均值 | 医学影像、平滑特征 | 保留整体信息,抑制噪声 |
| 全局平均池化(GAP) | 对每个通道全局求平均 | 分类任务、替代全连接 | 固定输出维度,防过拟合 |
| 全局最大池化(GMP) | 对每个通道全局求最大 | 细粒度分类 | 突出通道最强响应 |
| 重叠池化 | 窗口步长小于窗口尺寸 | 需要密集特征的场景 | 增强特征多样性,计算量略增 |
二、关键参数与计算规则
- 核心参数
- 池化窗口(kernel_size):常用2×2、3×3,2×2兼顾降维与细节保留,3×3降维更明显但易丢细节。
- 步长(stride):窗口每次移动的像素数,默认等于kernel_size;stride=kernel_size时无重叠,stride<kernel_size为重叠池化。
- 填充(padding):在特征图边缘补0(valid/no padding)或补边至输出尺寸不变(same padding),用于控制输出尺寸。
- ceil_mode:输出尺寸计算是否向上取整,默认False(向下取整)。
- Floor:向下取整 Ceiling:向上取整
- 输出尺寸计算 输入尺寸为[B, C, H_in, W_in](批量、通道、高、宽),池化核F×F,步长S,填充P,则输出高H_out、宽W_out公式: H_out = 【(H_in − F + 2P)/S】 + 1(ceil_mode=True时用向上取整),W_out同理。 示例:输入224×224,F=2,S=2,P=0 → (224−2)/2+1 = 112,输出112×112。
三、PyTorch实现步骤与代码示例
1. 基础池化层实现(nn模块)
import torch
import torch.nn as nn
# 1. 构造输入张量 [batch, channels, height, width]
input_tensor = torch.arange(16, dtype=torch.float32).view(1, 1, 4, 4)
# 2. 最大池化层(2×2窗口,步长2,无填充)
max_pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
output_max = max_pool(input_tensor)
# 3. 平均池化层(2×2窗口,步长2,无填充)
avg_pool = nn.AvgPool2d(kernel_size=2, stride=2, padding=0)
output_avg = avg_pool(input_tensor)
print("输入张量:\\\\n", input_tensor)
print("最大池化输出:\\\\n", output_max)
print("平均池化输出:\\\\n", output_avg)
输出: 输入张量: tensor([[[[ 0., 1., 2., 3.], [ 4., 5., 6., 7.], [ 8., 9., 10., 11.], [12., 13., 14., 15.]]]]) 最大池化输出: tensor([[[[ 5., 7.], [13., 15.]]]]) 平均池化输出: tensor([[[[ 2.5000, 4.5000], [10.5000, 12.5000]]]])
2. 函数式接口实现(nn.functional)
import torch.nn.functional as F
# 最大池化函数式调用
output_max_func = F.max_pool2d(input_tensor, kernel_size=2, stride=2, padding=0)
# 平均池化函数式调用
output_avg_func = F.avg_pool2d(input_tensor, kernel_size=2, stride=2, padding=0)
print("函数式最大池化输出:\\\\n", output_max_func)
输出与nn模块一致。
3. 全局池化实现
# 全局平均池化(GAP)
gap = nn.AdaptiveAvgPool2d((1, 1))  # 输出固定为1×1
output_gap = gap(input_tensor)
print("全局平均池化输出形状:", output_gap.shape)  # torch.Size([1, 1, 1, 1])
# 全局最大池化(GMP)
gmp = nn.AdaptiveMaxPool2d((1, 1))
output_gmp = gmp(input_tensor)
print("全局最大池化输出形状:", output_gmp.shape)  # torch.Size([1, 1, 1, 1])
Adaptive系列池化层可直接指定输出尺寸,无需计算kernel_size与stride。
四、TensorFlow/Keras实现示例
import tensorflow as tf
from tensorflow.keras.layers import MaxPooling2D, AveragePooling2D, GlobalAveragePooling2D
# 构造输入张量 [batch, height, width, channels]
input_tensor = tf.random.uniform((1, 224, 224, 3))
# 2×2最大池化,步长2,无填充
max_pool = MaxPooling2D(pool_size=(2, 2), strides=2, padding='valid')
output_max = max_pool(input_tensor)
print("Keras最大池化输出形状:", output_max.shape)  # (1, 112, 112, 3)
# 全局平均池化
gap = GlobalAveragePooling2D()
output_gap = gap(input_tensor)
print("Keras全局平均池化输出形状:", output_gap.shape)  # (1, 3)
Keras输入格式为[batch, height, width, channels],与PyTorch的通道维度位置不同。
五、使用策略与调优建议
- 参数选择指南
- 池化类型:图像分类优先用最大池化;医学影像、需要平滑特征时用平均池化;分类任务结尾用GAP替代全连接防过拟合。
- 窗口与步长:2×2窗口+步长2是经典配置,可高效将特征图尺寸减半;3×3窗口适合需要更强降维的场景,步长建议≤窗口尺寸避免信息丢失。
- 填充:卷积层后接池化层常用valid填充;若需保持尺寸用same填充。
- 常见问题与解决方案
- 过拟合:用GAP替代全连接层,或减小池化窗口尺寸保留更多细节。
- 特征丢失:改用重叠池化(如3×3窗口,步长2),或降低池化层数。
- 梯度消失:减少池化层数量,或用BatchNorm与ReLU配合缓解。
- 高级池化应用
- 空间金字塔池化(SPP):对特征图用多尺度池化,将任意尺寸特征转为固定维度,适配不同输入尺寸的图像任务。
- 反池化:nn.MaxUnpool2d可根据最大池化保存的索引恢复特征图尺寸,用于语义分割等任务。
六、实战案例(PyTorch实现简单CNN)
import torch
import torch.nn as nn
import torch.nn.functional as F
class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.conv1 = nn.Conv2d(3, 16, 3, 1, 1)  # 输入3通道,输出16通道,3×3卷积,步长1,填充1
        self.pool1 = nn.MaxPool2d(2, 2)  # 2×2最大池化,步长2
        self.conv2 = nn.Conv2d(16, 32, 3, 1, 1)
        self.pool2 = nn.MaxPool2d(2, 2)
        self.gap = nn.AdaptiveAvgPool2d((1, 1))  # 全局平均池化
        self.fc = nn.Linear(32, num_classes)  # 全连接层
    def forward(self, x):
        x = F.relu(self.conv1(x))
        x = self.pool1(x)
        x = F.relu(self.conv2(x))
        x = self.pool2(x)
        x = self.gap(x)
        x = torch.flatten(x, 1)
        x = self.fc(x)
        return x
# 测试模型
model = SimpleCNN()
input = torch.randn(1, 3, 224, 224)
output = model(input)
print("模型输出形状:", output.shape)  # torch.Size([1, 10])
该模型用两次卷积+最大池化提取特征,最后用GAP与全连接层分类,结构简洁且防过拟合。
实战脚本包含以下核心功能:
- 环境检查与导入
- 统一输入数据准备
- PyTorch 各类池化层实现与输出验证
- TensorFlow/Keras 各类池化层实现与输出验证
- 池化效果可视化对比
- 完整 CNN 模型中池化层的应用演示
# -*- coding: utf-8 -*-
"""
神经网络池化层完整演示脚本
包含PyTorch/TensorFlow双框架实现、可视化、CNN实战
"""
import numpy as np
import matplotlib.pyplot as plt

# ======================== 环境检查与导入 ========================
try:
    import torch
    import torch.nn as nn
    import torch.nn.functional as F
    torch_available = True
except ImportError:
    torch_available = False
    print("PyTorch未安装,将跳过PyTorch相关演示")

try:
    import tensorflow as tf
    from tensorflow.keras.layers import (MaxPooling2D, AveragePooling2D,
                                       GlobalAveragePooling2D, GlobalMaxPooling2D)
    tf_available = True
except ImportError:
    tf_available = False
    print("TensorFlow未安装,将跳过TensorFlow相关演示")

# 设置中文字体(解决可视化中文显示问题)
plt.rcParams["font.family"] = ["SimHei", "WenQuanYi Micro Hei", "Heiti TC"]
plt.rcParams['axes.unicode_minus'] = False

# ======================== 1. 准备测试数据 ========================
# 创建4x4的测试特征图(模拟单通道、单样本)
test_data = np.arange(16, dtype=np.float32).reshape(1, 1, 4, 4)  # PyTorch格式 [B, C, H, W]
tf_test_data = np.transpose(test_data, (0, 2, 3, 1))  # TensorFlow格式 [B, H, W, C]

print("="*50)
print("原始测试数据 (4x4):")
print(test_data[0, 0])

# ======================== 2. PyTorch 池化层演示 ========================
if torch_available:
    print("\\n" + "="*50)
    print("PyTorch 池化层演示")
    print("-"*30)

    # 转换为torch张量
    torch_input = torch.from_numpy(test_data)

    # 2.1 最大池化 (2x2, stride=2)
    max_pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
    max_output = max_pool(torch_input)
    print("1. 最大池化输出 (2x2):")
    print(max_output[0, 0].numpy())

    # 2.2 平均池化 (2x2, stride=2)
    avg_pool = nn.AvgPool2d(kernel_size=2, stride=2, padding=0)
    avg_output = avg_pool(torch_input)
    print("\\n2. 平均池化输出 (2x2):")
    print(avg_output[0, 0].numpy())

    # 2.3 全局平均池化
    gap = nn.AdaptiveAvgPool2d((1, 1))
    gap_output = gap(torch_input)
    print("\\n3. 全局平均池化输出 (1x1):")
    print(f"值: {gap_output.item():.2f}, 形状: {gap_output.shape}")

    # 2.4 全局最大池化
    gmp = nn.AdaptiveMaxPool2d((1, 1))
    gmp_output = gmp(torch_input)
    print("\\n4. 全局最大池化输出 (1x1):")
    print(f"值: {gmp_output.item():.2f}, 形状: {gmp_output.shape}")

# ======================== 3. TensorFlow/Keras 池化层演示 ========================
if tf_available:
    print("\\n" + "="*50)
    print("TensorFlow/Keras 池化层演示")
    print("-"*30)

    # 转换为tf张量
    tf_input = tf.convert_to_tensor(tf_test_data)

    # 3.1 最大池化
    max_pool_tf = MaxPooling2D(pool_size=(2, 2), strides=2, padding='valid')
    max_output_tf = max_pool_tf(tf_input)
    print("1. 最大池化输出 (2x2):")
    print(max_output_tf.numpy()[0, :, :, 0])

    # 3.2 平均池化
    avg_pool_tf = AveragePooling2D(pool_size=(2, 2), strides=2, padding='valid')
    avg_output_tf = avg_pool_tf(tf_input)
    print("\\n2. 平均池化输出 (2x2):")
    print(avg_output_tf.numpy()[0, :, :, 0])

    # 3.3 全局平均池化
    gap_tf = GlobalAveragePooling2D()
    gap_output_tf = gap_tf(tf_input)
    print("\\n3. 全局平均池化输出:")
    print(f"值: {gap_output_tf.numpy()[0]:.2f}, 形状: {gap_output_tf.shape}")

    # 3.4 全局最大池化
    gmp_tf = GlobalMaxPooling2D()
    gmp_output_tf = gmp_tf(tf_input)
    print("\\n4. 全局最大池化输出:")
    print(f"值: {gmp_output_tf.numpy()[0]:.2f}, 形状: {gmp_output_tf.shape}")

# ======================== 4. 池化效果可视化 ========================
print("\\n" + "="*50)
print("池化效果可视化")
print("-"*30)

# 准备可视化数据
original = test_data[0, 0]
if torch_available:
    max_pooled = max_output[0, 0].numpy()
    avg_pooled = avg_output[0, 0].numpy()
else:
    max_pooled = max_output_tf.numpy()[0, :, :, 0]
    avg_pooled = avg_output_tf.numpy()[0, :, :, 0]

# 创建子图
fig, axes = plt.subplots(1, 3, figsize=(12, 4))

# 原始数据
im1 = axes[0].imshow(original, cmap='viridis')
axes[0].set_title('原始特征图 (4x4)')
axes[0].set_xticks(range(4))
axes[0].set_yticks(range(4))
plt.colorbar(im1, ax=axes[0], fraction=0.046, pad=0.04)

# 最大池化结果
im2 = axes[1].imshow(max_pooled, cmap='viridis')
axes[1].set_title('最大池化结果 (2x2)')
axes[1].set_xticks(range(2))
axes[1].set_yticks(range(2))
plt.colorbar(im2, ax=axes[1], fraction=0.046, pad=0.04)

# 平均池化结果
im3 = axes[2].imshow(avg_pooled, cmap='viridis')
axes[2].set_title('平均池化结果 (2x2)')
axes[2].set_xticks(range(2))
axes[2].set_yticks(range(2))
plt.colorbar(im3, ax=axes[2], fraction=0.046, pad=0.04)

plt.tight_layout()
plt.savefig('pooling_visualization.png', dpi=150, bbox_inches='tight')
print("可视化结果已保存为: pooling_visualization.png")
plt.show()

# ======================== 5. CNN模型中池化层实战 (PyTorch) ========================
if torch_available:
    print("\\n" + "="*50)
    print("CNN模型中池化层实战 (PyTorch)")
    print("-"*30)

    class SimpleCNN(nn.Module):
        def __init__(self, num_classes=10):
            super().__init__()
            # 卷积层1 + 最大池化
            self.conv1 = nn.Conv2d(3, 16, 3, 1, 1)  # 3通道输入,16通道输出
            self.pool1 = nn.MaxPool2d(2, 2)          # 2x2最大池化,步长2

            # 卷积层2 + 最大池化
            self.conv2 = nn.Conv2d(16, 32, 3, 1, 1)
            self.pool2 = nn.MaxPool2d(2, 2)

            # 全局平均池化 + 全连接层
            self.gap = nn.AdaptiveAvgPool2d((1, 1))  # 全局平均池化到1x1
            self.fc = nn.Linear(32, num_classes)     # 分类输出

        def forward(self, x):
            # 前向传播
            x = F.relu(self.conv1(x))
            x = self.pool1(x)
            x = F.relu(self.conv2(x))
            x = self.pool2(x)
            x = self.gap(x)
            x = torch.flatten(x, 1)  # 展平
            x = self.fc(x)
            return x

    # 初始化模型并测试
    model = SimpleCNN(num_classes=10)
    test_input = torch.randn(1, 3, 224, 224)  # 模拟一张224x224的RGB图片
    output = model(test_input)

    print(f"输入形状: {test_input.shape}")
    print(f"模型输出形状: {output.shape}")
    print(f"模型参数量: {sum(p.numel() for p in model.parameters()):,}")

    # 打印模型结构
    print("\\nCNN模型结构:")
    print(model)

print("\\n" + "="*50)
print("所有演示完成!")
-
运行方式:
- 将脚本保存为
pooling_tutorial.py - 在终端运行:
python pooling_tutorial.py - 运行后会自动:
- 输出各类池化层的计算结果
- 生成池化效果对比图
pooling_visualization.png - 演示完整 CNN 模型中池化层的应用
- 将脚本保存为
-
输出说明:
- 控制台会依次输出原始数据、PyTorch/TensorFlow 池化结果、模型信息
- 弹出可视化窗口显示原始特征图 vs 最大池化 vs 平均池化的效果对比
- 自动保存可视化图片到当前目录
- 实战用法:
- 运行脚本后,通过
pooling_visualization.png的热力图,能直观看到:- 最大池化会保留局部最显著的特征(比如 4x4 矩阵里的 5、7、13、15),对应实际图像中 “边缘、角点” 等关键特征;
- 平均池化会平滑局部信息(比如 (0+1+4+5)/4=2.5),对应实际图像中 “背景、纹理” 等整体信息。
- 对比 PyTorch/TensorFlow 的输出结果,能快速掌握两个框架的 API 差异(比如通道维度位置、参数命名),避免实际项目中因框架切换踩坑。
- 运行脚本后,通过
2. 项目开发:CNN 模型的 “池化层调试基准”
- 解决的问题:实际做图像分类 / 检测 / 分割时,经常需要调整池化层参数(比如 kernel_size、stride),但不知道参数调整后特征图尺寸会怎么变,容易出现 “维度不匹配” 报错。
- 实战用法:
- 把脚本中的
test_input换成你项目中的真实输入尺寸(比如 32x32 的 MNIST、640x640 的目标检测图像),修改池化层参数(比如把kernel_size=2改成 3),运行后能快速验证:- 输出特征图的尺寸是否符合预期(比如 224x224 输入,2x2 池化后是否变成 112x112);
- 全局池化是否能稳定输出 1x1 的特征(避免全连接层因输入尺寸变化报错)。
- 脚本中的
SimpleCNN类是工业界通用的 “卷积 + 池化 + 全局池化” 模板,你可以直接复制到自己的项目中,替换num_classes为你的任务类别(比如分类 100 类就改成 100),快速搭建基础 CNN 模型。
- 把脚本中的
3. 问题排查:定位池化层导致的 “维度 / 特征丢失” 问题
- 解决的问题:实际项目中,模型训练时出现 “维度不匹配”“准确率低”,大概率和池化层参数设置有关(比如池化窗口太大导致特征丢失,步长设置错误导致维度计算错误)。
- 实战用法:
- 如果模型报错
size mismatch,可以用脚本中的池化层代码,单独测试你的输入张量经过池化后的尺寸,定位是kernel_size/stride/padding哪个参数设置错了; - 如果模型准确率低,可对比脚本中 “最大池化 vs 平均池化” 的输出,验证是否选错了池化类型(比如图像分类用了平均池化导致关键特征丢失)。
- 如果模型报错
4. 团队协作:统一池化层的 “代码规范模板”
- 解决的问题:团队开发时,不同人对池化层的实现方式不同(比如有人用
nn.MaxPool2d,有人用F.max_pool2d),导致代码风格混乱,维护成本高。 - 实战用法:
- 把脚本中的池化层实现方式(比如类式 API
nn.MaxPool2d为主,函数式 API 为辅)作为团队规范,统一代码风格; - 脚本中的注释和参数命名(比如
kernel_size/stride/padding)可作为团队的参数命名规范,避免出现 “pool_size”“step” 等不统一的命名。
- 把脚本中的池化层实现方式(比如类式 API
二、实际项目中的典型应用举例
为了让你更有体感,我举 2 个真实项目中用到这个脚本核心逻辑的场景:
项目场景 脚本的具体应用 手写数字识别(MNIST) 用脚本中的 SimpleCNN模板,把输入通道改成 1(MNIST 是灰度图),num_classes=10,快速搭建基线模型;用可视化功能验证池化层是否保留了数字的边缘特征。工业缺陷检测(640x640) 修改脚本中的池化层为 “3x3 窗口 + 步长 2” 的重叠池化,避免池化窗口太大丢失缺陷细节;用全局池化替代全连接层,减少参数量,防止过拟合。
总结
池化层通过无参聚合操作实现特征降维与抗干扰,不同类型适配不同任务,核心参数需根据输入尺寸与任务需求调整。PyTorch与TensorFlow均提供灵活的API,结合卷积层与激活函数可构建高效CNN模型。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)