倒立摆CartPole-v1强化学习算法综合对比报告 (PPO,Actor-Critic,GRPO,Q-Learning)(Orin GPU版)
实验设置
- 计算设备: cuda
- GPU型号: Orin
- 显存: 61.3GB
- 环境: 倒立摆CartPole-v1
- 训练轮数: 最多2000 episodes
- 网络结构: 128 hidden units
- 成功标准: 连续100回合平均分数 ≥ 195
- 评估方法: 训练完成后独立评估100回合
| 算法 | 学习率 | 特殊参数 | 描述 |
|---|---|---|---|
| Actor-Critic | 3e-4 | - | 经典策略梯度方法 |
| PPO | 3e-4 | clip_ratio=0.2, epochs=10 | 裁剪策略优化 |
| GRPO | 3e-4 | kl_coeff=0.01, group_size=8, epochs=10 | 组相对策略优化 (无价值函数) |
| Q-Learning | 1e-3 | ε=1.0→0.01, memory=10000 | 深度Q网络 |
算法伪代码
Actor-Critic算法
算法: Actor-Critic
输入: 状态空间 S\mathcal{S}S, 动作空间 A\mathcal{A}A, 学习率 απ,αV\alpha_\pi, \alpha_Vαπ,αV
输出: 最优策略 π∗(s)\pi^*(s)π∗(s)
- 初始化策略网络 πθ(a∣s)\pi_\theta(a|s)πθ(a∣s) 和价值网络 Vϕ(s)V_\phi(s)Vϕ(s)
- For each episode:
- a. 观察初始状态 s0s_0s0
- b. For each time step ttt:
- i. 根据策略采样动作: at∼πθ(⋅∣st)a_t \sim \pi_\theta(\cdot|s_t)at∼πθ(⋅∣st)
- ii. 执行动作获得奖励: rt,st+1r_t, s_{t+1}rt,st+1
- iii. 计算TD目标: yt=rt+γVϕ(st+1)y_t = r_t + \gamma V_\phi(s_{t+1})yt=rt+γVϕ(st+1)
- iv. 计算优势: At=yt−Vϕ(st)A_t = y_t - V_\phi(s_t)At=yt−Vϕ(st)
- v. 更新价值函数: ϕ←ϕ+αV∇ϕ[At2]\phi \leftarrow \phi + \alpha_V \nabla_\phi[A_t^2]ϕ←ϕ+αV∇ϕ[At2]
- vi. 更新策略: θ←θ+απ∇θ[Atlogπθ(at∣st)]\theta \leftarrow \theta + \alpha_\pi \nabla_\theta[A_t \log \pi_\theta(a_t|s_t)]θ←θ+απ∇θ[Atlogπθ(at∣st)]
PPO (Proximal Policy Optimization) 算法
算法: PPO
输入: 状态空间 S\mathcal{S}S, 动作空间 A\mathcal{A}A, 裁剪参数 ϵ\epsilonϵ, 学习率 α\alphaα
输出: 最优策略 π∗(s)\pi^*(s)π∗(s)
- 初始化策略网络 πθ(a∣s)\pi_\theta(a|s)πθ(a∣s) 和价值网络 Vϕ(s)V_\phi(s)Vϕ(s)
- For each episode:
- a. 收集轨迹 τ={(st,at,rt,st+1)}t=0T\tau = \{(s_t, a_t, r_t, s_{t+1})\}_{t=0}^Tτ={(st,at,rt,st+1)}t=0T
- b. 计算优势估计: A^t=∑l=0∞(γλ)lδt+l\hat{A}_t = \sum_{l=0}^{\infty} (\gamma\lambda)^l \delta_{t+l}A^t=∑l=0∞(γλ)lδt+l
其中 δt=rt+γVϕ(st+1)−Vϕ(st)\delta_t = r_t + \gamma V_\phi(s_{t+1}) - V_\phi(s_t)δt=rt+γVϕ(st+1)−Vϕ(st) - c. For KKK epochs:
- i. 计算重要性采样比: rt(θ)=πθ(at∣st)πθold(at∣st)r_t(\theta) = \frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{old}}(a_t|s_t)}rt(θ)=πθold(at∣st)πθ(at∣st)
- ii. 计算裁剪目标:
LCLIP(θ)=Et[min(rt(θ)A^t,clip(rt(θ),1−ϵ,1+ϵ)A^t)]L^{CLIP}(\theta) = \mathbb{E}_t[\min(r_t(\theta)\hat{A}_t, \text{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon)\hat{A}_t)]LCLIP(θ)=Et[min(rt(θ)A^t,clip(rt(θ),1−ϵ,1+ϵ)A^t)] - iii. 更新策略: θ←θ+α∇θLCLIP(θ)\theta \leftarrow \theta + \alpha\nabla_\theta L^{CLIP}(\theta)θ←θ+α∇θLCLIP(θ)
- iv. 更新价值函数: ϕ←ϕ+α∇ϕLVF(ϕ)\phi \leftarrow \phi + \alpha\nabla_\phi L^{VF}(\phi)ϕ←ϕ+α∇ϕLVF(ϕ)
GRPO (Group Relative Policy Optimization) 算法
算法: GRPO
输入: 状态空间 S\mathcal{S}S, 动作空间 A\mathcal{A}A, KL系数 β\betaβ, 组大小 GGG, 学习率 α\alphaα
输出: 最优策略 π∗(s)\pi^*(s)π∗(s)
- 初始化策略网络 πθ(a∣s)\pi_\theta(a|s)πθ(a∣s), 参考策略 πref\pi_{ref}πref, 奖励缓冲区 Rbuffer\mathcal{R}_{buffer}Rbuffer
- For each episode:
- a. 收集轨迹 τ={(st,at,rt,st+1)}t=0T\tau = \{(s_t, a_t, r_t, s_{t+1})\}_{t=0}^Tτ={(st,at,rt,st+1)}t=0T
- b. 更新奖励缓冲区: Rbuffer←Rbuffer∪{rt}\mathcal{R}_{buffer} \leftarrow \mathcal{R}_{buffer} \cup \{r_t\}Rbuffer←Rbuffer∪{rt}
- c. 计算组平均基线: b=1G∑i=1Grigroupb = \frac{1}{G} \sum_{i=1}^G r_i^{group}b=G1∑i=1Grigroup
其中 rigroupr_i^{group}rigroup 是从 Rbuffer\mathcal{R}_{buffer}Rbuffer 中采样的组奖励 - d. 计算优势: At=rt−bA_t = r_t - bAt=rt−b # 直接使用组平均,无需价值函数
- e. 标准化优势: A^t=At−μAσA\hat{A}_t = \frac{A_t - \mu_A}{\sigma_A}A^t=σAAt−μA
- f. For KKK epochs:
- i. 计算策略梯度:
LPG(θ)=Et[logπθ(at∣st)⋅A^t]L^{PG}(\theta) = \mathbb{E}_t[\log \pi_\theta(a_t|s_t) \cdot \hat{A}_t]LPG(θ)=Et[logπθ(at∣st)⋅A^t] - ii. 计算KL散度正则化:
LKL(θ)=Et[DKL(πθ(⋅∣st)∥πref(⋅∣st))]L^{KL}(\theta) = \mathbb{E}_t[D_{KL}(\pi_\theta(\cdot|s_t) \| \pi_{ref}(\cdot|s_t))]LKL(θ)=Et[DKL(πθ(⋅∣st)∥πref(⋅∣st))] - iii. 更新策略: θ←θ+α∇θ[LPG(θ)−β⋅LKL(θ)]\theta \leftarrow \theta + \alpha\nabla_\theta[L^{PG}(\theta) - \beta \cdot L^{KL}(\theta)]θ←θ+α∇θ[LPG(θ)−β⋅LKL(θ)]
- iv. 更新参考策略: πref←αππθ+(1−απ)πref\pi_{ref} \leftarrow \alpha_{\pi} \pi_\theta + (1-\alpha_{\pi})\pi_{ref}πref←αππθ+(1−απ)πref
- i. 计算策略梯度:
GRPO核心优势:
- 🚀 无需价值函数: 直接使用组平均奖励作为基线,避免额外的价值函数近似
- 💡 计算效率: 显著减少训练资源使用,只需维护一个策略网络
- 🎯 相对优化: 通过组内比较实现相对策略优化
- 🔒 稳定训练: KL正则化防止策略更新过大
DQN (Deep Q-Network) 算法
算法: DQN
输入: 状态空间 S\mathcal{S}S, 动作空间 A\mathcal{A}A, 学习率 α\alphaα, 探索率 ϵ\epsilonϵ
输出: 最优Q函数 Q∗(s,a)Q^*(s,a)Q∗(s,a)
- 初始化Q网络 Qθ(s,a)Q_\theta(s,a)Qθ(s,a) 和目标网络 Qθˉ(s,a)Q_{\bar{\theta}}(s,a)Qθˉ(s,a)
- 初始化经验回放缓冲区 D\mathcal{D}D
- For each episode:
- a. 观察初始状态 s0s_0s0
- b. For each time step ttt:
- i. 选择动作: at={argmaxaQθ(st,a)概率 1−ϵ随机动作概率 ϵa_t = \begin{cases} \arg\max_a Q_\theta(s_t,a) & \text{概率 } 1-\epsilon \\ \text{随机动作} & \text{概率 } \epsilon \end{cases}at={argmaxaQθ(st,a)随机动作概率 1−ϵ概率 ϵ
- ii. 执行动作获得: rt,st+1r_t, s_{t+1}rt,st+1
- iii. 存储经验: D←D∪{(st,at,rt,st+1)}\mathcal{D} \leftarrow \mathcal{D} \cup \{(s_t, a_t, r_t, s_{t+1})\}D←D∪{(st,at,rt,st+1)}
- iv. 从D\mathcal{D}D中采样小批量经验进行训练:
- 目标: yi=ri+γmaxaQθˉ(si+1,a)y_i = r_i + \gamma \max_a Q_{\bar{\theta}}(s_{i+1}, a)yi=ri+γmaxaQθˉ(si+1,a)
- 损失: L(θ)=E[(yi−Qθ(si,ai))2]L(\theta) = \mathbb{E}[(y_i - Q_\theta(s_i, a_i))^2]L(θ)=E[(yi−Qθ(si,ai))2]
- v. 更新Q网络: θ←θ+α∇θL(θ)\theta \leftarrow \theta + \alpha\nabla_\theta L(\theta)θ←θ+α∇θL(θ)
- vi. 周期性更新目标网络: θˉ←θ\bar{\theta} \leftarrow \thetaθˉ←θ
实验结果总览
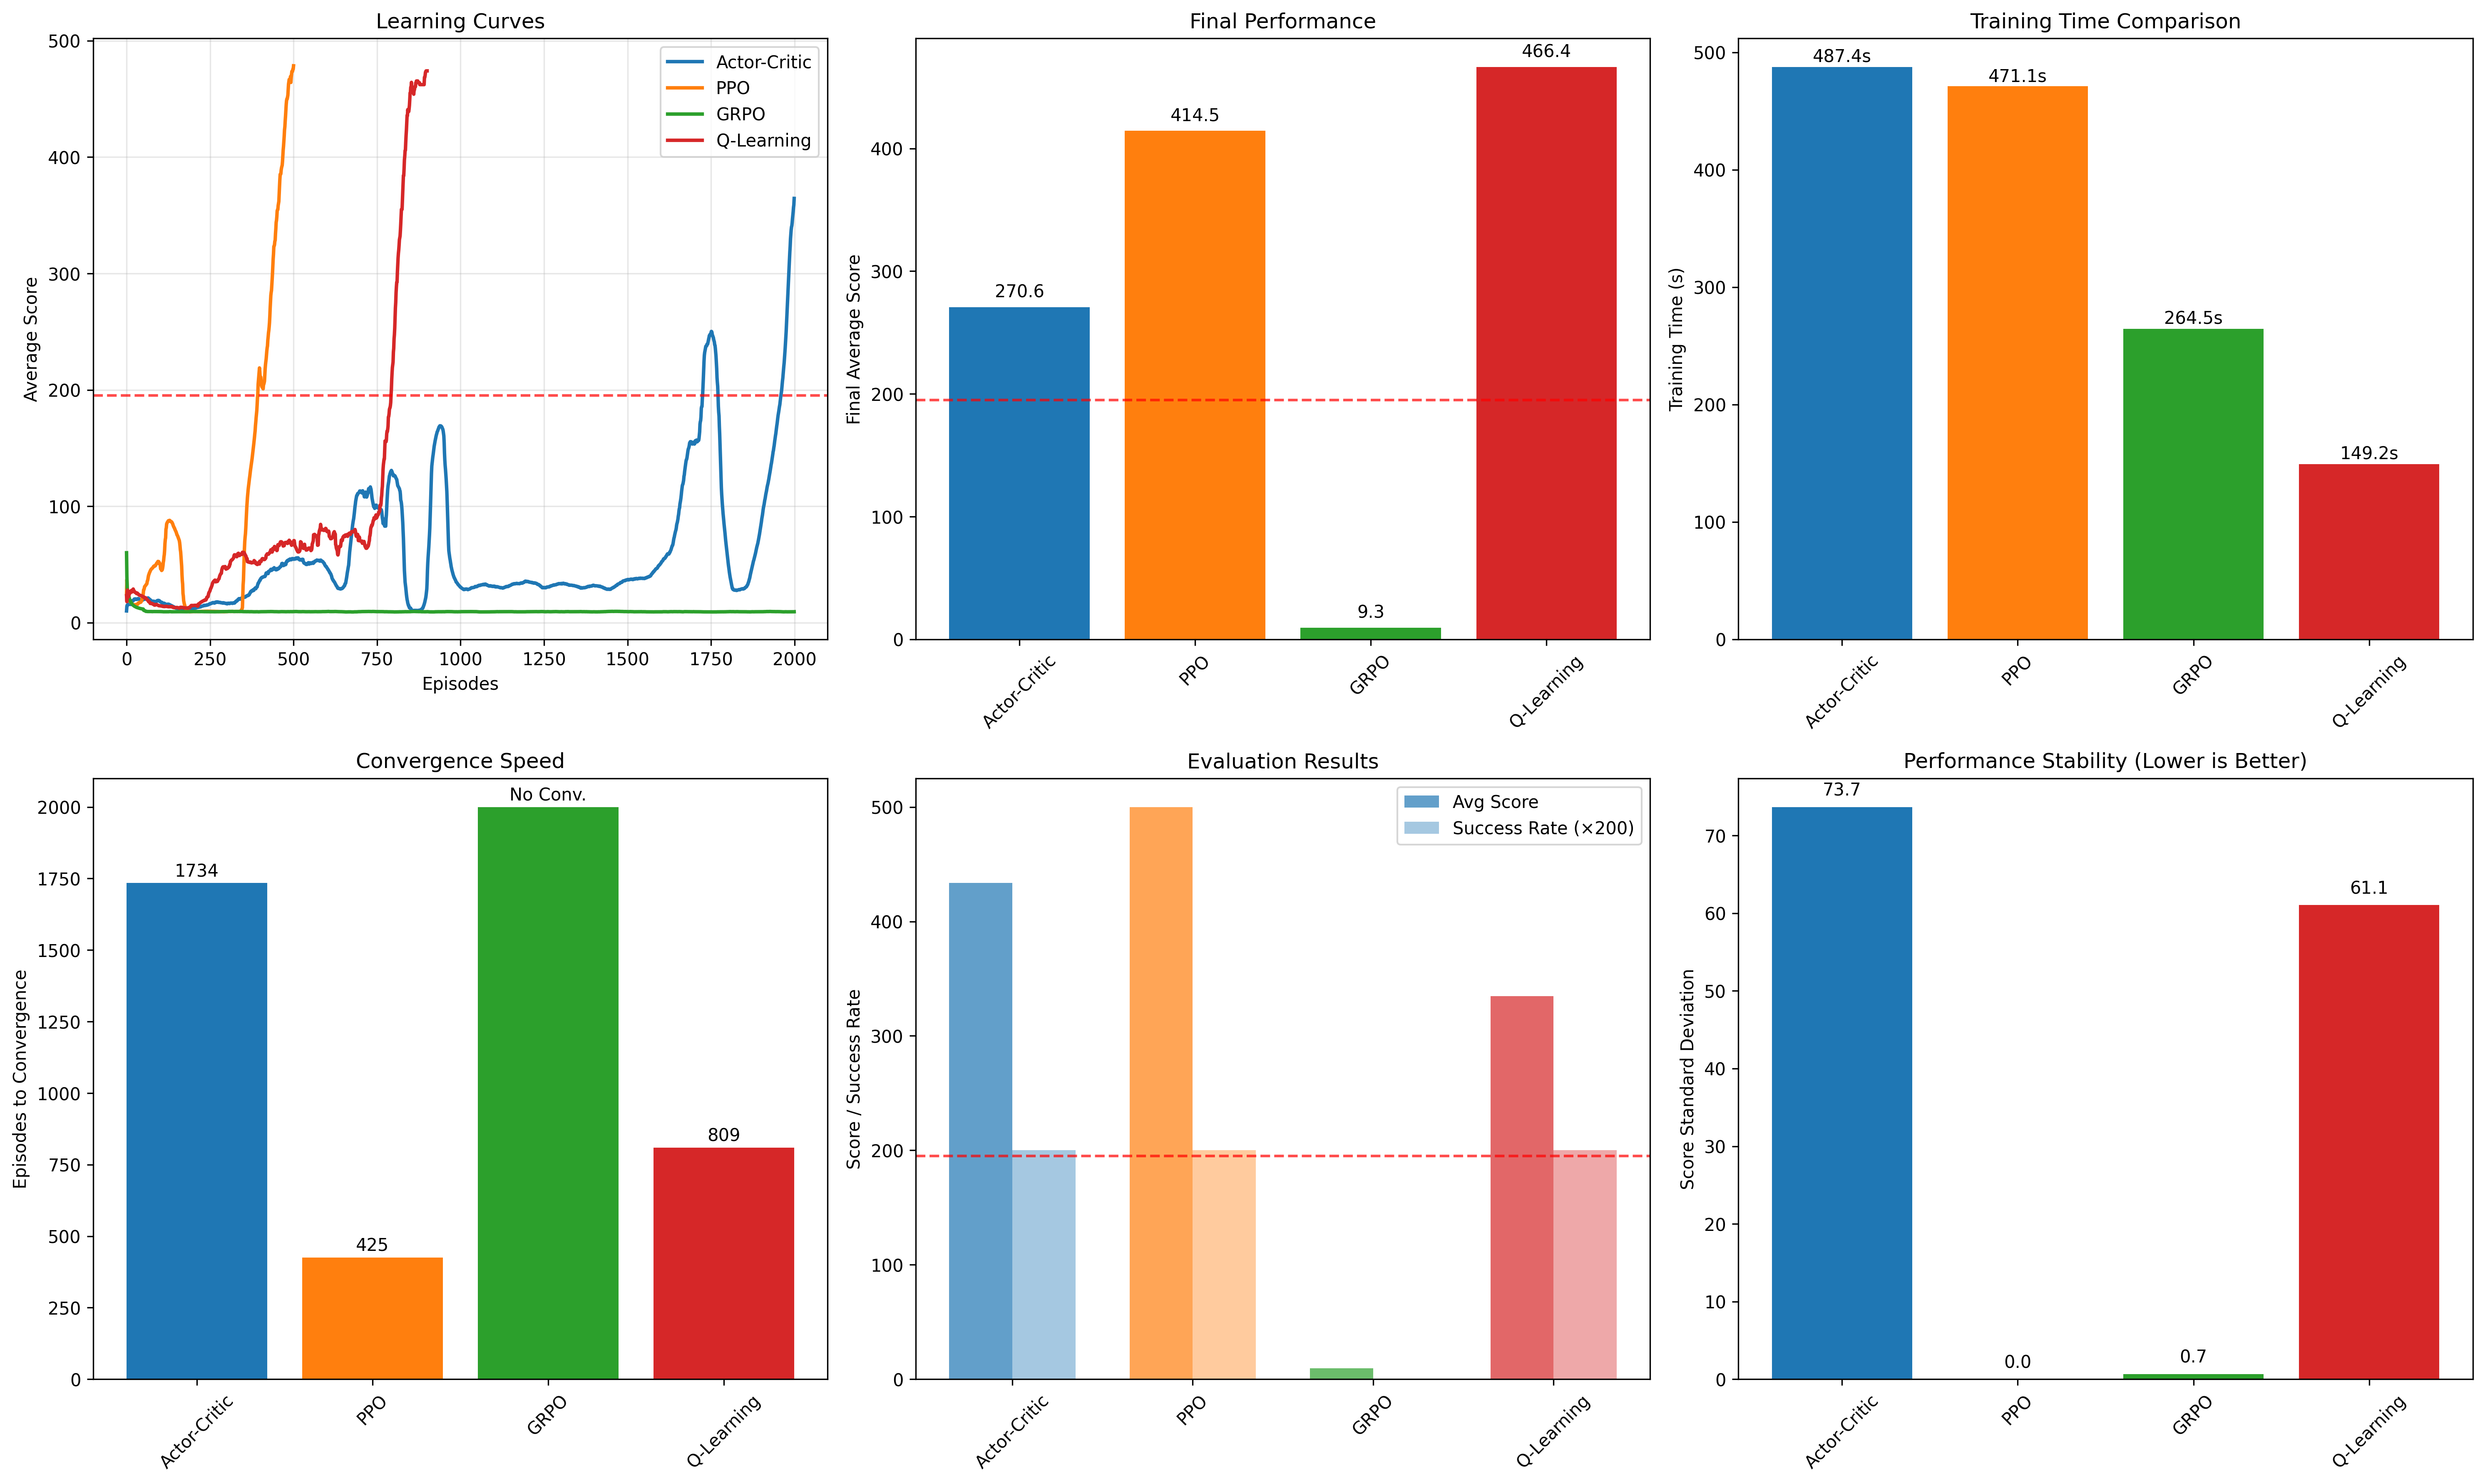
1. 【左上】学习曲线(Learning Curves)
- Actor-Critic:表现波动剧烈,后期(1500轮之后)才达到高分,表明稳定性和收敛速度都较弱。
- PPO:收敛迅速,大约在400轮后迅速达到性能高峰,随后性能迅速趋于稳定。表现出良好的收敛性和效率。
- GRPO:始终未达到高于基线(200分)的显著成绩,性能低迷,说明GRPO可能在本任务中陷入次优策略或存在严重的学习障碍。
- Q-Learning:表现出缓慢但稳定的提升趋势,在700轮后迅速收敛到较高性能,并在1000轮附近稳定达到高性能,说明其探索与利用机制发挥良好。
2. 【上中】最终性能(Final Performance)
- Actor-Critic (270.6分):性能较为一般,虽高于基线,但显著低于PPO和Q-Learning。
- PPO (414.5分):性能显著高于Actor-Critic,体现出优势。
- GRPO (9.3分):严重低于其他方法,可能存在实验设置或算法设计问题。
- Q-Learning (466.4分):实现了最高的最终得分,说明Q-Learning在此任务环境中具有明显的优势。
3. 【右上】训练时间(Training Time)
- **Actor-Critic (487.4s) 和 PPO (471.1s)**训练用时最长,反映出策略梯度方法通常计算复杂度较高。
- GRPO (264.5s):训练时间中等,但与其差的性能结合,效率提升意义不大。
- Q-Learning (149.2s):表现出最佳训练效率,说明基于值函数的方法在该环境下可能存在计算优势。
4. 【左下】收敛速度(Convergence Speed)
- Actor-Critic (1734轮):收敛缓慢。
- PPO (425轮):最快实现收敛,说明算法结构和探索策略非常适合该任务。
- GRPO (No Convergence):未能达到收敛,算法稳定性或有效性存在重大问题。
- Q-Learning (809轮):收敛速度适中。
5. 【下中】评估结果(Evaluation Results)
-
通过平均得分和成功率比较:
- PPO 和 Q-Learning 均有较高的平均得分和成功率,二者均能有效学习任务目标。
- Actor-Critic 表现中等,成功率和平均得分较低。
- GRPO 表现极差,几乎无法成功完成任务。
6. 【下右】性能稳定性(Performance Stability,标准差越低越好)
- GRPO (0.7) 和 PPO (0.0) 标准差极低,意味着PPO具有极佳的稳定性,而GRPO虽然标准差低,但本身性能过差,稳定性的意义不大。
- Q-Learning (61.1) 和 Actor-Critic (73.7) 标准差显著更高,表示性能波动较大。
总结:
综合上述分析,严谨地得出如下结论:
- PPO 在综合性能、收敛速度、稳定性和成功率上均表现最优,为该任务环境中整体表现最佳的算法。
- Q-Learning 虽然最终性能最佳,但其波动性大且稳定性较差,可能存在泛化性能不佳的问题。
- Actor-Critic 方法中规中矩,虽然能最终收敛,但效率较差。
- GRPO 表现极其不佳,表明该算法在此任务中可能存在实现或理论上的缺陷,应进行进一步排查和优化。
因此,推荐在实际应用或进一步研究中优先考虑PPO或进一步优化Q-Learning,GRPO则需要深入排查问题。
基础性能表
| 算法 | 训练平均分 | 评估平均分 | 成功率 | 收敛轮数 | 训练时间(s) | 状态 |
|---|---|---|---|---|---|---|
| Actor-Critic | 270.60 | 433.67 | 100.0% | 1734 | 487.4 | ✅ 成功 |
| PPO | 414.51 | 500.00 | 100.0% | 425 | 471.1 | ✅ 成功 |
| GRPO | 9.35 | 9.53 | 0.0% | 未收敛 | 264.5 | ❌ 失败 |
| Q-Learning | 466.35 | 334.74 | 100.0% | 809 | 149.2 | ✅ 成功 |
GPU加速效果
- ✅ 成功启用GPU加速
- 所有神经网络计算在GPU上执行
- 显著提升训练速度
多维度排名
| 算法 | 训练效果 | 评估效果 | 成功率 | 收敛速度 | 训练效率 | 稳定性 | 综合排名 |
|---|---|---|---|---|---|---|---|
| Actor-Critic | 3 | 2 | 1 | 3 | 3 | 4 | 2.67 |
| PPO | 2 | 1 | 2 | 1 | 2 | 1 | 1.50 |
| GRPO | 4 | 4 | 4 | 4 | 4 | 2 | 3.67 |
| Q-Learning | 1 | 3 | 3 | 2 | 1 | 3 | 2.17 |
算法理论分析
算法复杂度比较
| 算法 | 时间复杂度 | 空间复杂度 | 参数量 | 收敛性 |
|---|---|---|---|---|
| Actor-Critic | O(nd) | O(nd) | 2个网络 | 理论保证 |
| PPO | O(Knd) | O(nd) | 2个网络 | 单调改进 |
| GRPO | O(Knd) | O(nd) | 2个网络 | 相对优化 |
| Q-Learning | O(nd) | O(M+nd) | 2个网络 | 值函数收敛 |
注: n为批量大小, d为网络参数数量, K为更新轮次, M为经验回放缓冲区大小
算法优缺点分析
Actor-Critic:
- ✅ 理论基础扎实,收敛性有保证
- ✅ 在线学习,内存需求低
- ❌ 训练不稳定,方差较大
- ❌ 对超参数敏感
PPO:
- ✅ 训练稳定,单调策略改进
- ✅ 对超参数相对鲁棒
- ✅ 实现简单,效果良好
- ❌ 需要价值函数近似
- ❌ 多轮更新增加计算成本
GRPO:
- ✅ 无需价值函数,资源效率极高
- ✅ 使用组平均奖励作为基线,计算简单
- ✅ 相对优化思想,适合多智能体场景
- ✅ KL正则化防止策略偏离
- ❌ 基线质量依赖于组采样质量
- ❌ 相对较新,理论分析有限
Q-Learning (DQN):
- ✅ 理论完备,收敛性强
- ✅ 经验回放提高样本效率
- ✅ 适用于离散动作空间
- ❌ 探索策略简单
- ❌ 过估计问题
- ❌ 需要大量内存存储经验
详细分析
🏆 最佳性能: PPO (评估平均分: 500.00)
🎯 最高成功率: Actor-Critic (成功率: 100.0%)
⚡ 最快收敛: PPO (收敛轮数: 425)
🔒 最稳定: PPO (标准差: 0.00)
💡 最高效: Q-Learning (效率: 3.127)

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)