基于mindspore的Resnet18卷积神经网络的花卉分类
·
前言:
此篇博客是:基于mindspore的卷积神经网络的花卉的基础上完成的。上一篇中只使用了简单的卷积神经网络旨在让大家了解整个midspore搭建的过程。这一篇将更改卷积网络来增强网络的分类性能。
五分类花卉数据集:数据集下载
训练代码部分
1.导入相关库文件
from easydict import EasyDict as edict
#glob模块主要用于查找符合特定规则的文件路径名,类似使用windows下的文件搜索
import glob
#os模块主要用于处理文件和目录
import os

import numpy as np
import matplotlib.pyplot as plt

import mindspore
#导入mindspore框架数据集
import mindspore.dataset as ds
#vision.c_transforms模块是处理图像增强的高性能模块,用于数据增强图像数据改进训练模型。
import mindspore.dataset.vision.c_transforms as CV
# import mindspore.dataset.transforms.vision.c_transforms as CV
#c_transforms模块提供常用操作,包括OneHotOp和TypeCast
import mindspore.dataset.transforms.c_transforms as C
from mindspore.dataset.vision import Inter
# from mindspore.dataset.transforms.vision import Inter
from mindspore.common import dtype as mstype
from mindspore import context
#导入模块用于初始化截断正态分布
from mindspore.common.initializer import TruncatedNormal
from mindspore import nn
from mindspore.train import Model
from mindspore.train.callback import ModelCheckpoint, CheckpointConfig, LossMonitor, TimeMonitor
from mindspore.train.serialization import load_checkpoint, load_param_into_net
from mindspore import Tensor
# 设置MindSpore的执行模式和设备
context.set_context(device_target="GPU", mode=mindspore.GRAPH_MODE)
2.引入随机种子
import random

seed = 42  # 设定随机种子
random.seed(seed)
np.random.seed(seed)
mindspore.set_seed(seed)
3.设置相关文件存储地址与超参数
cfg = edict({
    'data_path': 'ex1/data/flower_photos',
    'data_size':3670,
    'image_width': 100,  # 图片宽度
    'image_height': 100,  # 图片高度
    'batch_size': 32,
    'channel': 3,  # 图片通道数
    'num_class':5,  # 分类类别
    'weight_decay': 0.01,
    'lr':0.0001,  # 学习率
    'dropout_ratio': 0.5,
    'epoch_size': 10,  # 训练次数
    'per_print_times': 10,  # 每10步打印一次
    'sigma':0.01,
    'save_checkpoint_steps': 1000,  # 添加检查点保存步数
    'keep_checkpoint_max': 10,  # 设置最大保存的检查点数量
    'output_prefix': 'restrain_output_10',  # 保存的模型文件前缀
    'output_directory': './restrain_output_10'  # 保存的模型文件路径
})
4.数据集的读取与划分
#从目录中读取图像的源数据集。
de_dataset = ds.ImageFolderDataset(cfg.data_path,
                                   class_indexing={'daisy':0,'dandelion':1,'roses':2,'sunflowers':3,'tulips':4})
#解码前将输入图像裁剪成任意大小和宽高比。
transform_img = CV.RandomCropDecodeResize([cfg.image_width,cfg.image_height], scale=(0.08, 1.0), ratio=(0.75, 1.333))  #改变尺寸
#转换输入图像;形状(H, W, C)为形状(C, H, W)。
hwc2chw_op = CV.HWC2CHW()
#转换为给定MindSpore数据类型的Tensor操作。
type_cast_op = C.TypeCast(mstype.float32)
#将操作中的每个操作应用到此数据集。
de_dataset = de_dataset.map(input_columns="image", num_parallel_workers=8, operations=transform_img)
de_dataset = de_dataset.map(input_columns="image", operations=hwc2chw_op, num_parallel_workers=8)
de_dataset = de_dataset.map(input_columns="image", operations=type_cast_op, num_parallel_workers=8)
de_dataset = de_dataset.shuffle(buffer_size=cfg.data_size)
#划分训练集测试集
(de_train,de_test)=de_dataset.split([0.8,0.2])
#设置每个批处理的行数
#drop_remainder确定是否删除最后一个可能不完整的批(default=False)。
#如果为True,并且如果可用于生成最后一个批的batch_size行小于batch_size行,则这些行将被删除,并且不会传播到子节点。
de_train=de_train.batch(cfg.batch_size, drop_remainder=True)
#重复此数据集计数次数。
de_train=de_train.repeat(cfg.epoch_size)
de_test=de_test.batch(cfg.batch_size, drop_remainder=True)
de_test=de_test.repeat(cfg.epoch_size)
print('训练数据集数量:',de_train.get_dataset_size()*cfg.batch_size)#get_dataset_size()获取批处理的大小。
print('测试数据集数量:',de_test.get_dataset_size()*cfg.batch_size)

data_next=de_dataset.create_dict_iterator()._get_next()
print('通道数/图像长/宽:', data_next['image'].shape)
print('一张图像的标签样式:', data_next['label'])  # 一共5类,用0-4的数字表达类别。
5.定义训练网络
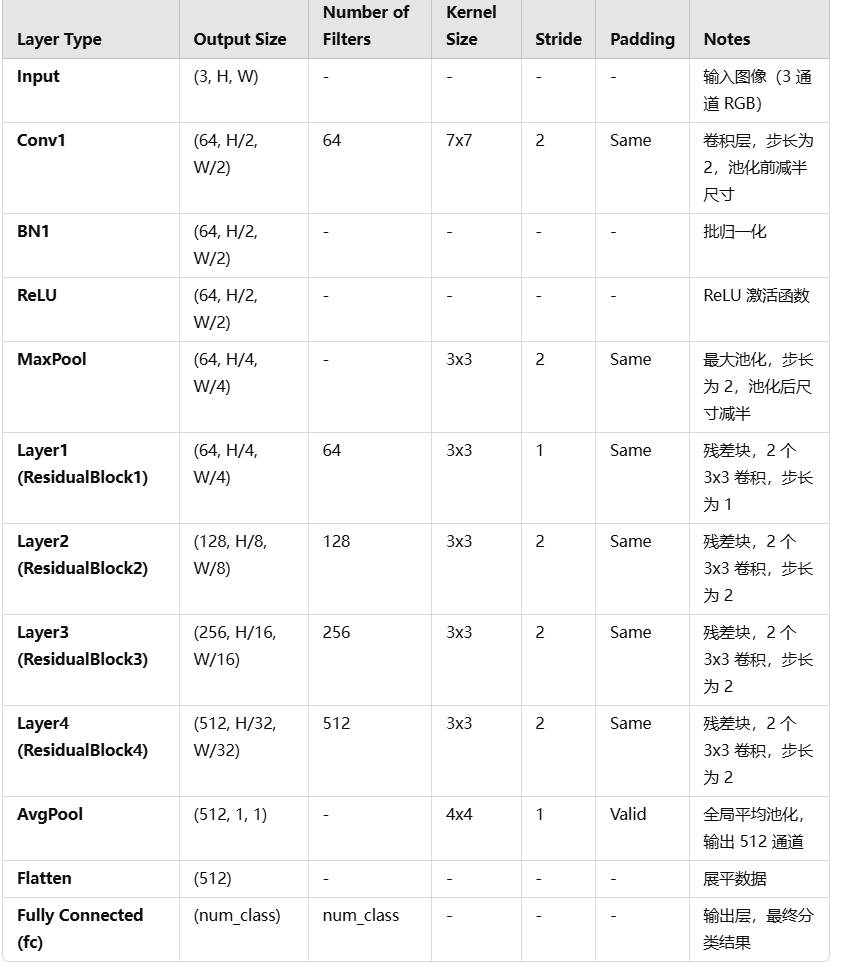
# 定义CNN图像识别网络
class ResidualBlock(nn.Cell):
    def __init__(self, in_channels, out_channels, stride=1):
        super(ResidualBlock, self).__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, pad_mode='same', weight_init=TruncatedNormal(0.02))
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU()
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, stride=1, pad_mode='same', weight_init=TruncatedNormal(0.02))
        self.bn2 = nn.BatchNorm2d(out_channels)

        self.downsample = None
        if stride != 1 or in_channels != out_channels:
            self.downsample = nn.SequentialCell([
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, pad_mode='same', weight_init=TruncatedNormal(0.02)),
                nn.BatchNorm2d(out_channels)
            ])

    def construct(self, x):
        identity = x
        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)
        out = self.conv2(out)
        out = self.bn2(out)

        if self.downsample:
            identity = self.downsample(x)

        out += identity
        out = self.relu(out)
        return out

class ResNet18(nn.Cell):
    def __init__(self, num_class=5):
        super(ResNet18, self).__init__()
        self.conv1 = nn.Conv2d(3, 64, kernel_size=7, stride=2, pad_mode='same', weight_init=TruncatedNormal(0.02))
        self.bn1 = nn.BatchNorm2d(64)
        self.relu = nn.ReLU()
        self.maxpool = nn.MaxPool2d(kernel_size=3, stride=2, pad_mode='same')

        self.layer1 = self._make_layer(64, 64, 2, stride=1)
        self.layer2 = self._make_layer(64, 128, 2, stride=2)
        self.layer3 = self._make_layer(128, 256, 2, stride=2)
        self.layer4 = self._make_layer(256, 512, 2, stride=2)

        self.avgpool = nn.AvgPool2d(kernel_size=4)
        self.flatten = nn.Flatten()
        self.fc = nn.Dense(512, num_class, weight_init=TruncatedNormal(0.02))

    def _make_layer(self, in_channels, out_channels, blocks, stride):
        layers = []
        layers.append(ResidualBlock(in_channels, out_channels, stride))
        for _ in range(1, blocks):
            layers.append(ResidualBlock(out_channels, out_channels))
        return nn.SequentialCell(layers)

    def construct(self, x):
        x = self.conv1(x)
        x = self.bn1(x)
        x = self.relu(x)
        x = self.maxpool(x)

        x = self.layer1(x)
        x = self.layer2(x)
        x = self.layer3(x)
        x = self.layer4(x)

        x = self.avgpool(x)
        x = self.flatten(x)
        x = self.fc(x)
        return x

net = ResNet18(num_class=cfg.num_class)
6.定义优化器与损失函数
#计算softmax交叉熵。
net_loss = nn.SoftmaxCrossEntropyWithLogits(sparse=True, reduction="mean")
#opt
fc_weight_params = list(filter(lambda x: 'fc' in x.name and 'weight' in x.name, net.trainable_params()))
fc_weight_param_ids = {id(param) for param in fc_weight_params}
else_params = [param for param in net.trainable_params() if id(param) not in fc_weight_param_ids]
group_params = [{'params': fc_weight_params, 'weight_decay': cfg.weight_decay},
                {'params': else_params}]
#设置Adam优化器
net_opt = nn.Adam(group_params, learning_rate=cfg.lr, weight_decay=0.0)

loss_list = []
class CustomLossMonitor(LossMonitor):
    def epoch_end(self, run_context):
        cb_params = run_context.original_args()
        loss_list.append(cb_params.net_outputs.asnumpy())  # 记录每个 epoch 的损失
        super().epoch_end(run_context)  # 调用原 LossMonitor 的方法
7.训练网络
model = Model(net, loss_fn=net_loss, optimizer=net_opt, metrics={"Accuracy": nn.Accuracy()})
loss_cb = CustomLossMonitor(per_print_times=de_train.get_dataset_size())
config_ck = CheckpointConfig(save_checkpoint_steps=cfg.save_checkpoint_steps,
                             keep_checkpoint_max=cfg.keep_checkpoint_max)
ckpoint_cb = ModelCheckpoint(prefix=cfg.output_prefix, directory=cfg.output_directory, config=config_ck)
print("============== Starting Training ==============")
model.train(cfg.epoch_size, de_train, callbacks=[loss_cb, ckpoint_cb], dataset_sink_mode=True)

plt.figure()
plt.plot(range(1, len(loss_list) + 1), loss_list, marker='o', linestyle='-')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Training Loss Curve')
plt.grid(True)
plt.savefig('./ex1/loss_curve/restrain_loss_curve.png')  # 保存图片
plt.close()  # 关闭图像,不显示
8.评估训练网络
# 使用测试集评估模型,打印总体准确率
metric = model.eval(de_test,dataset_sink_mode=False)
print(metric)
测试代码怒分:
#修改权重文件
CKPT = './restrain_output_10/restrain_output_10-10_910.ckpt'
load_checkpoint(CKPT, net=net)
model = Model(net)
# 预测
# 预测
class_indexing = {0:'daisy', 1:'dandelion', 2:'roses', 3:'sunflowers', 4:'tulips'}

# 获取数据集迭代器
de_test_iterator = de_test.create_dict_iterator()

# 遍历测试集
for test_ in de_test_iterator:
    test_images = Tensor(test_['image'], mindspore.float32)  # 转换为Tensor
    test_labels = test_['label']  # 获取标签

    # 进行预测
    predictions = model.predict(test_images)
    predictions = predictions.asnumpy()

    # 打印预测和真实结果
    for i in range(test_images.shape[0]):  # 处理每个样本
        p_np = predictions[i, :]
        p_list = p_np.tolist()
        predicted_class = class_indexing[p_list.index(max(p_list))]
        true_class = class_indexing[test_labels[i].asnumpy().item()]

        print(f'第{i + 1}个样本预测结果:{predicted_class}   真实结果:{true_class}')

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)