深度学习CV之相知VIT(附面试题)
本篇文章旨在以搭建相对简单的VIT模块,来帮助兄弟们学习transformer在CV领域的应用
废话不多说先把我个人认为结构容易并且附有代码注释的GitHub项目摆上:https://github.com/WZMIAOMIAO/deep-learning-for-image-processing/tree/master/pytorch_classification/vision_transformer
同样把结构图呈上:
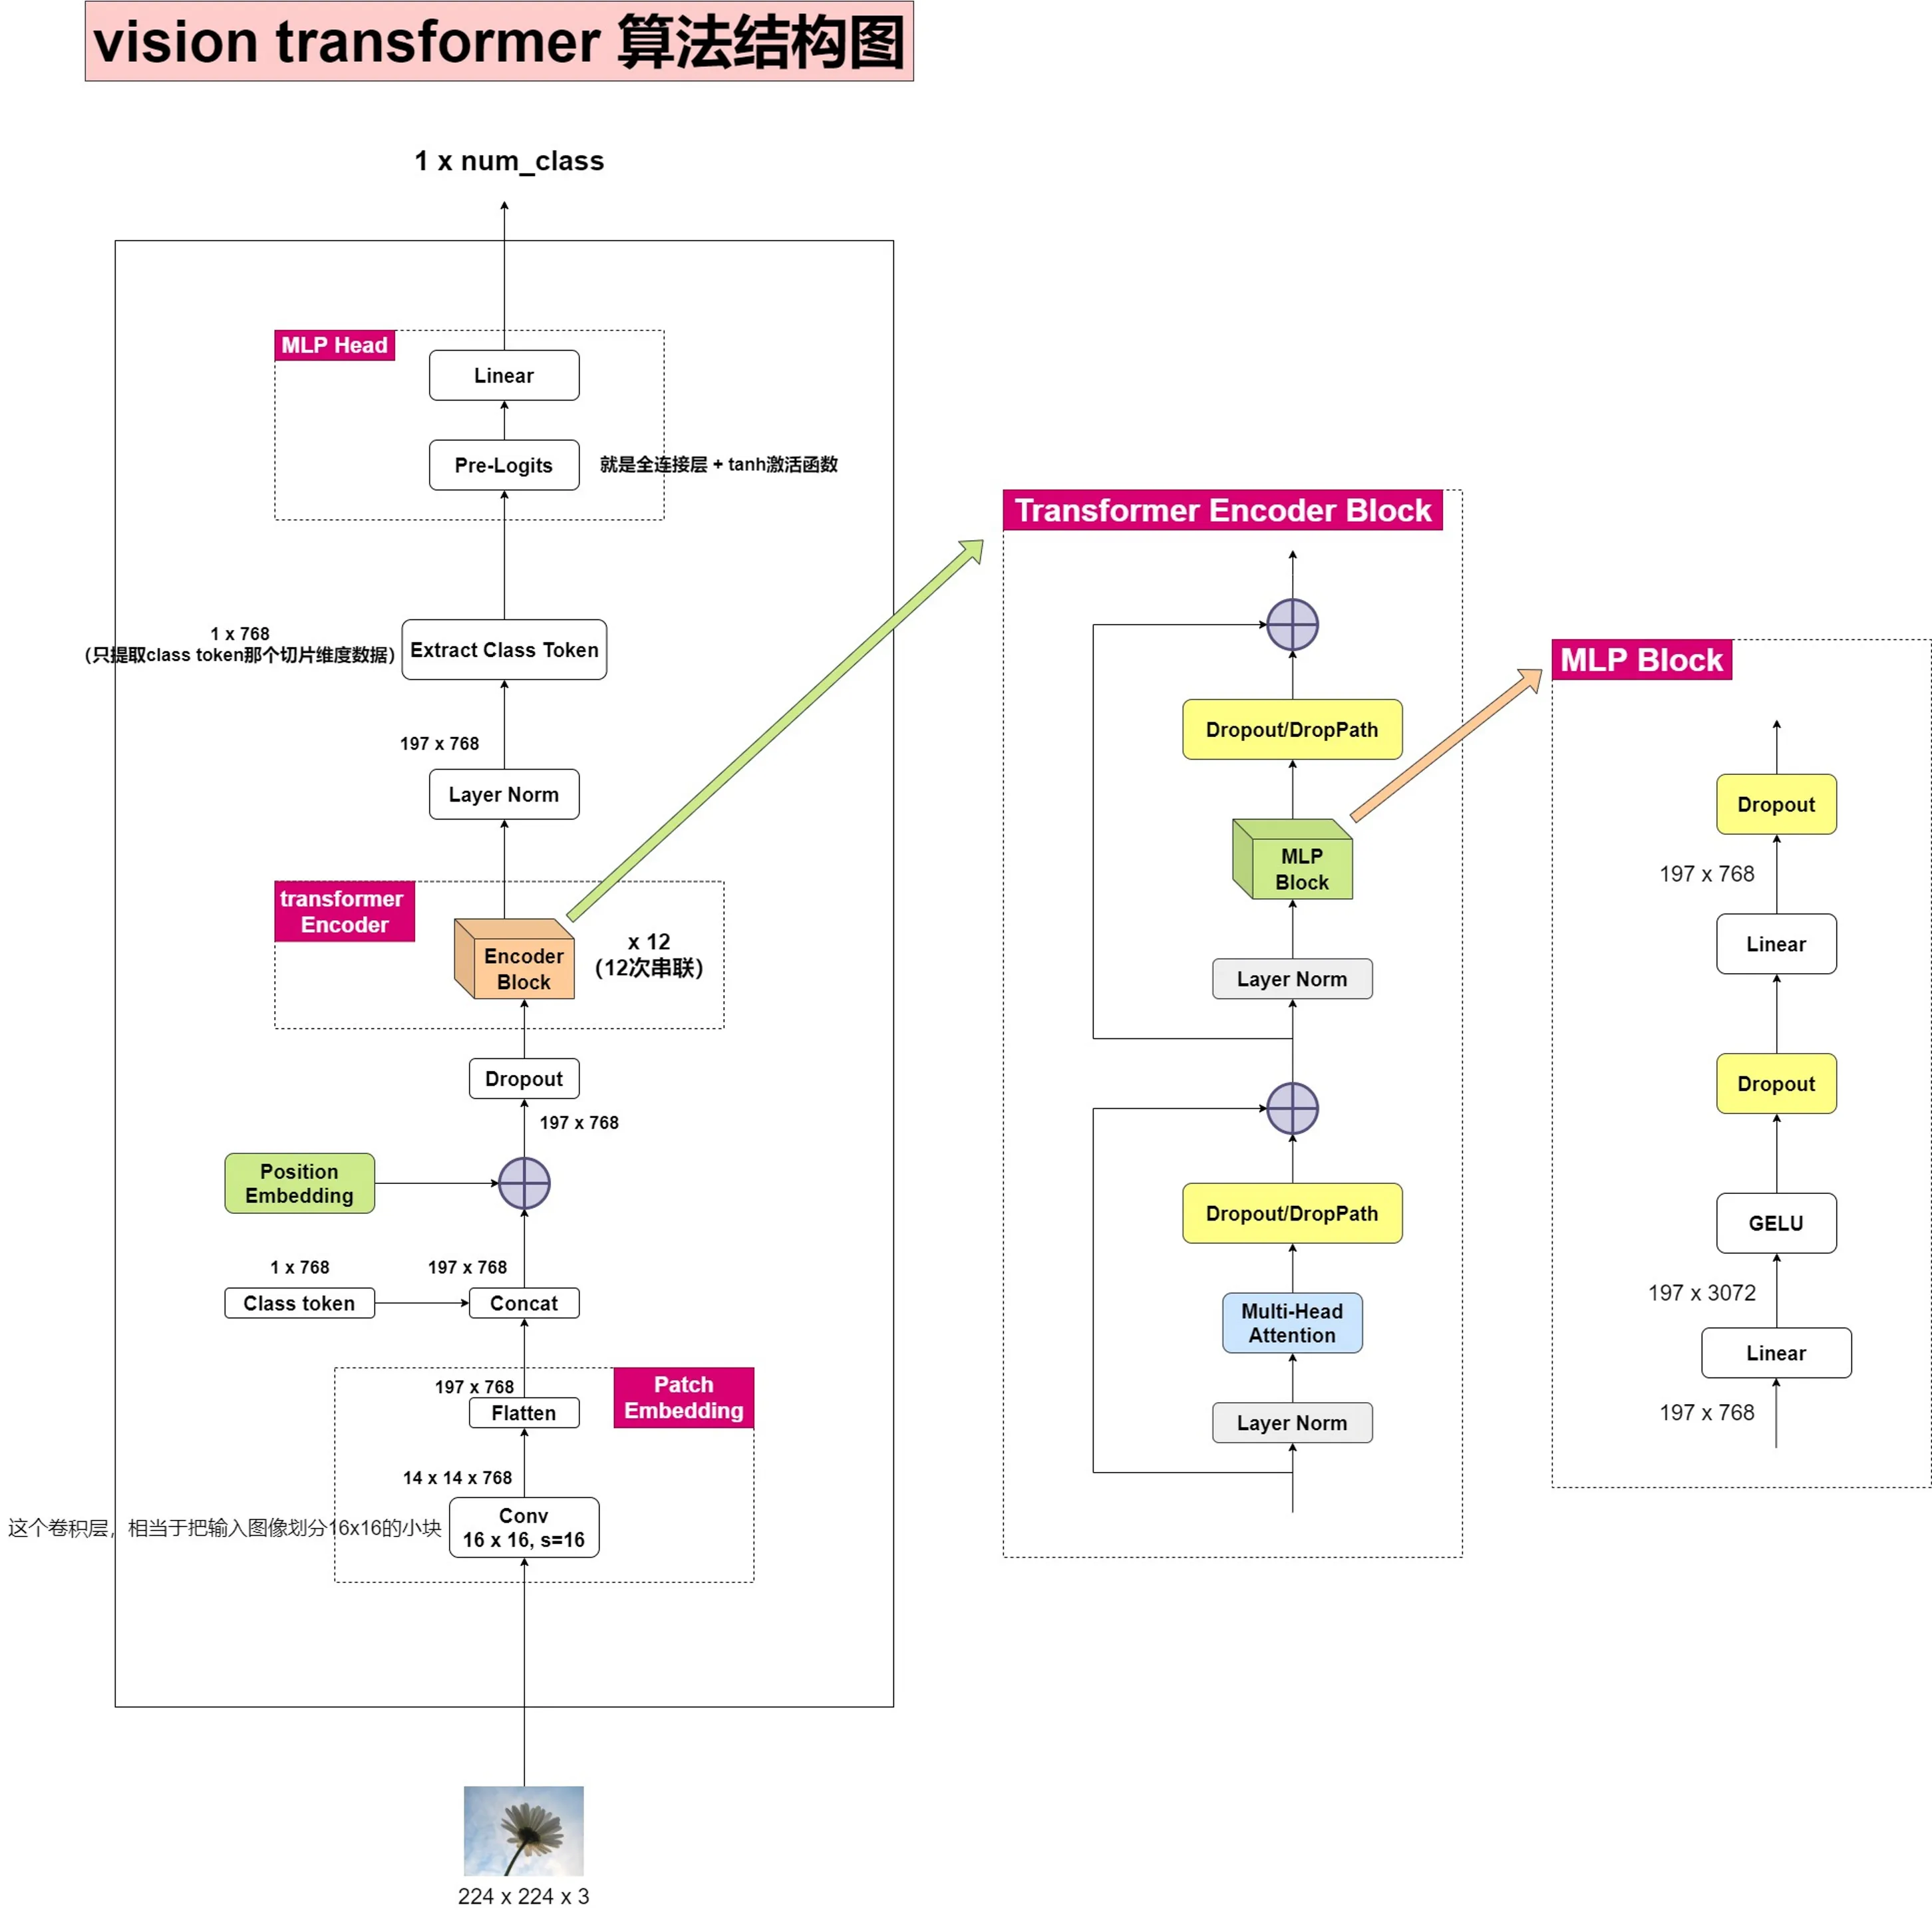
一,简化的PatchEmbed
import torch
import torch.nn as nn

# 简化的PatchEmbed
class PatchEmbed(nn.Module):
    def __init__(self):
        self.proj = nn.Conv2d(3, 16, kernel_size=4, stride=4)  # 假设patch_size=4,embed_dim=16
    def forward(self, x):
        return self.proj(x).flatten(2).transpose(1, 2)  # 把卷积结果摊平成[batch, patch_num, embed_dim]
函数解析
def forward(self, x):
    return self.proj(x).flatten(2).transpose(1, 2)
self.proj(x)
self.proj很可能是一个定义好的投影层(例如通过nn.Conv2d或nn.Linear创建),其作用是将输入张量x从一个空间映射到另一个空间。这通常用于调整特征维度大小。- 当调用
self.proj(x)时,输入张量x会经过这个投影层的转换,输出一个新的张量。
.flatten(2)
.flatten(start_dim)是PyTorch中的一个操作,它将从start_dim指定的维度开始的所有维度合并成一个单一的维度。- 在这里的
.flatten(2)表示从第2个维度(即第三个维度,因为维度索引是从0开始的)开始,将后续的所有维度展平为一个维度。 - 例如,如果输入的形状是
(batch_size, channels, height, width),那么在应用.flatten(2)后,输出的形状将会变成(batch_size, channels, height * width)。
.transpose(1, 2)
.transpose(dim0, dim1)操作用于交换一个张量中dim0和dim1两个维度的位置。- 这里的
.transpose(1, 2)会交换第二个维度和第三个维度的位置。 - 继续上面的例子,如果经过
.flatten(2)后的形状是(batch_size, channels, height * width),那么使用.transpose(1, 2)之后,最终的输出形状将是(batch_size, height * width, channels)。
参数解析
x:这是输入到forward函数的数据,通常是一个四维张量(对于图像数据而言),形状可能是(batch_size, channels, height, width),其中:
-
batch_size表示一次处理的样本数量。channels对于RGB图像来说通常是3,而对于灰度图像则是1;不过,在深度学习中,特别是在经过某些层之后,这个值可能会更大,代表不同的特征图数量。height和width分别代表输入图像的高度和宽度
二,简化的Attention
# 简化的Attention
class Attention(nn.Module):
    def __init__(self):
        self.qkv = nn.Linear(16, 16*3)  # qkv共用一个线性层
        self.proj = nn.Linear(16, 16)
    def forward(self, x):
        qkv = self.qkv(x).reshape(x.shape[0], -1, 3, 16).permute(2, 0, 1, 3)
        q, k, v = qkv[0], qkv[1], qkv[2]
        attn = (q @ k.transpose(-2, -1)) / (16**0.5)  # 计算注意力分数
        attn = attn.softmax(dim=-1)
        x = attn @ v  # 加权求和
        return self.proj(x)
1. 代码分解
qkv = self.qkv(x).reshape(x.shape[0], -1, 3, 16).permute(2, 0, 1, 3)
q, k, v = qkv[0], qkv[1], qkv[2]
(1) self.qkv(x)
- 作用:这是一个线性层(
nn.Linear),将输入x投影到一个更大的维度,准备拆分为 Q、K、V。 - 输入:假设
x的形状是(batch_size, num_patches, embedding_dim),例如(B, N, D)。 - 输出:
self.qkv的输出形状是(B, N, 3 * D_head * num_heads),其中D_head是每个注意力头的维度,num_heads是多头注意力的头数。
例如:如果 embedding_dim=512,num_heads=8,则 D_head=512/8=64,self.qkv 的输出维度是 (B, N, 3*8*64)=(B, N, 1536)。
(2) .reshape(x.shape[0], -1, 3, 16)
- 作用:将线性层的输出重新排列,显式分离 Q、K、V。
- 参数解释:
-
x.shape[0]:批大小B(保持不变)。-1:自动计算序列长度(通常是num_patches,即N)。3:对应 Q、K、V 三个矩阵。16:每个头的维度D_head(这里假设D_head=16,实际值可能不同)。
- 输出形状:
(B, N, 3, D_head),例如(B, N, 3, 16)。
(3) .permute(2, 0, 1, 3)
- 作用:调整维度顺序,将
3(Q/K/V的索引)放到最前面。 - 参数解释:
-
- 原形状:
(B, N, 3, D_head)。 permute(2, 0, 1, 3):交换维度顺序为(3, B, N, D_head)。
- 原形状:
- 输出形状:
(3, B, N, D_head)。
三,简化的ViT
# 简化的ViT
class SimpleViT(nn.Module):
    def __init__(self):
        self.patch_embed = PatchEmbed()
        self.attn = Attention()
        self.mlp = nn.Sequential(nn.Linear(16, 32), nn.GELU(), nn.Linear(32, 16))
        self.norm = nn.LayerNorm(16)
        self.cls_token = nn.Parameter(torch.zeros(1, 1, 16))
        self.head = nn.Linear(16, 10)  # 假设分10类
    def forward(self, x):
        b, c, h, w = x.shape
        x = self.patch_embed(x)  # [b, patch_num, 16]
        cls_token = self.cls_token.expand(b, -1, -1)
        x = torch.cat((cls_token, x), dim=1)  # [b, patch_num+1, 16]
        # 模拟一个Transformer块
        x = x + self.attn(x)  # 注意力+残差
        x = x + self.mlp(self.norm(x))  # 前馈网络+残差
        x = self.norm(x[:, 0])  # 取cls_token的输出
        x = self.head(x)
        return x

# 测试输入输出
img = torch.randn(2, 3, 16, 16)  # 假设图像尺寸16x16,batch=2
model = SimpleViT()
out = model(img)
print(out.shape)  # 应该是[2, 10],即2张图,10分类
模型结构
PatchEmbed:假设这是一个自定义的类或函数,用于将输入图像分割成多个小块(patches),并将其映射到指定维度(这里是16)。这一步骤类似于将图像转换为一系列特征向量。
Attention:实现了注意力机制,允许模型在处理信息时能够聚焦于更重要的部分。
MLP:一个多层感知机,包含两个线性层和一个激活函数GELU。这里作为前馈神经网络的一部分,用于进一步处理经过注意力机制的信息。
LayerNorm:层归一化,帮助加速训练过程并稳定梯度。
cls_token:一个可学习的参数,代表分类标记。在ViT中,它通常被添加到输入序列的开头,用于最终的分类任务。
head:最后的线性层,用于将特征映射到目标类别数(本例中是10类)。
前向传播过程
首先,patch_embed 将输入图像分割成多个小块,并映射到16维空间。
然后,在序列的开头添加cls_token,这是为了利用[CLS] token进行分类任务。
接下来,模拟了一个Transformer块的工作流程:
应用注意力机制,并加上残差连接(即原始输入x与经过注意力机制处理后的结果相加)。
经过层归一化、MLP处理后再加回原始输入x。
最后,取cls_token对应的输出(即处理后的序列的第一个元素),并通过线性层head将其映射到10个类别上。
测试输入输出
提供的测试代码创建了一个尺寸为16x16、batch大小为2的随机图像张量,并通过SimpleViT模型进行预测。预期输出是一个形状为 [2, 10] 的张量,表示对于每张图(共2张),模型对其属于10个类别的可能性进行了预测。
img = torch.randn(2, 3, 16, 16) # 创建一个随机输入张量
model = SimpleViT() # 实例化模型
out = model(img) # 获取模型输出
print(out.shape) # 打印输出形状,期望是[2, 10]
这样,通过上述步骤,兄弟们就可以构建并测试一个简化的视觉Transformer模型了。这个模型虽然简化了很多细节,但已经包含了ViT的核心思想:通过注意力机制处理图像块,并使用[CLS] token进行分类。
通过对照结构图,结合代码块,你已经相对清晰的知道了他的运营步骤。
如需要深入学习完整代码块可以看下面的视频:11.2 使用pytorch搭建Vision Transformer(vit)模型_哔哩哔哩_bilibili
四,VIT,面试题
以下是 15 道关于这份 vit.py 代码的面试题:
基础概念类
- 请简要解释视觉Transformer(ViT)的核心思想。
- 多头自注意力机制(Multi-Head Self-Attention)在ViT中起到什么作用?
代码细节类
pair函数的作用是什么?为什么需要这个函数?- 在
FeedForward类中,GELU激活函数相较于其他激活函数(如ReLU)有什么优势? - 在
Attention类中,to_qkv线性层的输出为什么要乘以3? - 请解释
Attention类中scale的作用。 - 在
Transformer类中,为什么要使用残差连接(x = attn(x) + x和x = ff(x) + x)? - 在
ViT类的__init__方法中,assert image_height % patch_height == 0 and image_width % patch_width == 0这一行代码的目的是什么? ViT类中的pos_embedding有什么作用?ViT类中的cls_token是什么,它在模型中起到什么作用?
模型设计与优化类
- 如何调整
ViT模型中的depth和heads参数来平衡模型的性能和复杂度? Dropout层在FeedForward和Attention类中起到什么作用?如何选择合适的dropout率?- 在
ViT类中,pool参数有两个可选值:'cls'和'mean',请解释它们的区别和适用场景。
代码实现与调试类
- 假设你在运行
ViT模型时遇到了RuntimeError: CUDA out of memory错误,你会采取哪些措施来解决这个问题? - 请描述如何对
ViT模型进行训练和评估,包括数据加载、模型初始化、损失函数选择和优化器设置等步骤。
#######################################################################
基础概念类
- 请简要解释视觉Transformer(ViT)的核心思想
-
- 视觉Transformer(ViT)的核心思想是将Transformer架构应用于计算机视觉任务。传统的Transformer主要用于自然语言处理,它通过自注意力机制捕捉序列中元素之间的依赖关系。在ViT中,首先将图像分割成多个固定大小的小块(patches),然后将这些小块展平并映射到低维向量空间,形成一系列的图像块嵌入。接着,为这些嵌入添加位置编码以保留图像的空间信息,并引入一个特殊的分类令牌(cls token)。最后,将这些嵌入输入到Transformer编码器中进行特征提取,利用自注意力机制让模型学习图像块之间的全局依赖关系。最终,使用分类令牌的输出通过全连接层进行图像分类等任务。
- 多头自注意力机制(Multi - Head Self - Attention)在ViT中起到什么作用
-
- 多头自注意力机制允许模型在不同的表示子空间中并行地关注输入序列的不同部分。在ViT中,它可以捕捉图像块之间的多种依赖关系。不同的头可以学习到不同类型的特征和关系,例如有的头可能关注图像的局部纹理,有的头可能关注图像的全局结构。通过将多个头的输出拼接并投影,模型能够综合利用这些不同的信息,从而增强模型的表达能力,提高对图像特征的提取和理解能力。
代码细节类
pair函数的作用是什么?为什么需要这个函数
-
pair函数的作用是将输入转换为元组形式。如果输入本身就是元组,则直接返回;否则,将输入重复为一个二元组。在ViT类的__init__方法中,需要处理图像尺寸(image_size)和块尺寸(patch_size),这些参数既可以是单个整数,表示图像的边长或块的边长,也可以是二元组,表示图像或块的高度和宽度。使用pair函数可以方便地处理这两种输入情况,确保后续代码能够统一处理图像和块的尺寸。
# 示例
print(pair(224))  # 输出: (224, 224)
print(pair((224, 224))) # 输出: (224, 224)- 在
FeedForward类中,GELU激活函数相较于其他激活函数(如ReLU)有什么优势
-
GELU(Gaussian Error Linear Unit)激活函数是一种非线性激活函数,相较于ReLU有一些优势。ReLU函数在输入小于 0 时输出为 0,这可能导致部分神经元死亡,即这些神经元在训练过程中不再更新。而GELU函数是一种平滑的激活函数,它考虑了输入的概率分布,能够根据输入的大小动态地调整输出,具有更好的梯度特性。在某些任务中,GELU可以使模型收敛更快,并且在处理复杂的输入模式时表现更好,能够更好地拟合数据。
- 在
Attention类中,to_qkv线性层的输出为什么要乘以3
-
- 在多头自注意力机制中,需要为每个输入生成查询(Q)、键(K)和值(V)三个张量。
to_qkv线性层的作用就是将输入的特征向量同时映射到 Q、K、V 三个空间。因此,其输出维度需要是每个头的维度(dim_head)乘以头的数量(heads)的 3 倍,以便后续将输出分割成 Q、K、V 三个部分。
- 在多头自注意力机制中,需要为每个输入生成查询(Q)、键(K)和值(V)三个张量。
# 示例
dim = 256
heads = 8
dim_head = 64
inner_dim = dim_head * heads
to_qkv = nn.Linear(dim, inner_dim * 3, bias=False)
# 这里 to_qkv 的输出维度为 inner_dim * 3- 请解释
Attention类中scale的作用
-
- 在计算注意力分数时,使用了
dots = torch.matmul(q, k.transpose(-1, -2)) * self.scale,其中self.scale = dim_head ** -0.5。scale的作用是对注意力分数进行缩放,避免点积运算的结果过大。当dim_head较大时,点积运算的结果可能会变得非常大,导致 Softmax 函数的梯度变得很小,从而影响模型的训练效果。通过对注意力分数进行缩放,可以缓解这个问题,使梯度更加稳定,有助于模型的训练。
- 在计算注意力分数时,使用了
- 在
Transformer类中,为什么要使用残差连接(x = attn(x) + x和x = ff(x) + x)
-
- 残差连接(Residual Connection)是一种在深度学习中常用的技术,在
Transformer类中使用残差连接有以下几个好处:
- 残差连接(Residual Connection)是一种在深度学习中常用的技术,在
-
-
- 缓解梯度消失问题:在深度神经网络中,随着网络层数的增加,梯度在反向传播过程中可能会变得非常小,导致模型难以训练。残差连接允许梯度直接跳过中间层,使得梯度能够更有效地传播,从而缓解梯度消失问题。
- 促进信息流动:残差连接使得输入信息能够直接传递到输出,有助于模型保留更多的原始信息,避免信息在传递过程中丢失。
- 提高模型性能:实验表明,使用残差连接可以提高模型的训练速度和泛化能力,使模型更容易学习到有效的特征表示。
-
- 在
ViT类的__init__方法中,assert image_height % patch_height == 0 and image_width % patch_width == 0这一行代码的目的是什么
-
- 这行代码的目的是确保图像的高度和宽度能够被块的高度和宽度整除。在
ViT模型中,需要将图像分割成多个固定大小的小块(patches),如果图像的尺寸不能被块的尺寸整除,就无法均匀地分割图像,会导致后续的处理出现问题。因此,通过这行代码进行检查,如果不满足条件,会抛出AssertionError异常,提示用户调整图像或块的尺寸。
- 这行代码的目的是确保图像的高度和宽度能够被块的高度和宽度整除。在
ViT类中的pos_embedding有什么作用
-
pos_embedding是位置编码,其作用是为图像块嵌入添加位置信息。在将图像分割成多个小块并进行嵌入后,这些嵌入本身并不包含图像块的位置信息,而位置信息对于理解图像的结构和语义非常重要。通过添加位置编码,模型能够学习到不同图像块之间的相对位置关系,从而更好地捕捉图像的空间特征。在forward方法中,将位置编码与图像块嵌入相加,使得模型在处理输入时能够考虑到图像块的位置信息。
ViT类中的cls_token是什么,它在模型中起到什么作用
-
cls_token是一个特殊的分类令牌,它是一个可学习的参数,形状为(1, 1, dim)。在forward方法中,将cls_token复制到每个样本的输入中,并与图像块嵌入拼接在一起。在经过 Transformer 编码器处理后,模型会对cls_token的输出进行分类预测。cls_token的作用是作为整个图像的表示,它在 Transformer 编码器中与其他图像块进行交互,聚合了图像的全局信息。最终,使用cls_token的输出通过全连接层进行图像分类等任务。
模型设计与优化类
- 如何调整
ViT模型中的depth和heads参数来平衡模型的性能和复杂度
-
depth参数:depth表示 Transformer 编码器中堆叠的层数。增加depth可以让模型学习到更复杂的特征和依赖关系,从而提高模型的性能。但是,随着depth的增加,模型的复杂度也会显著增加,训练时间会变长,并且可能会出现过拟合问题。因此,在调整depth时,需要在性能和复杂度之间进行权衡。可以通过实验不同的depth值,观察模型在训练集和验证集上的表现,选择一个合适的值。heads参数:heads表示多头自注意力机制中的头的数量。增加heads可以让模型在不同的表示子空间中并行地关注输入序列的不同部分,从而增强模型的表达能力。但是,增加heads也会增加模型的计算量和参数量。在调整heads时,同样需要考虑性能和复杂度的平衡。可以从较小的heads值开始,逐步增加,观察模型的性能变化,找到一个既能提高性能又不会过度增加复杂度的heads值。
Dropout层在FeedForward和Attention类中起到什么作用?如何选择合适的dropout率
-
- 作用:
Dropout层是一种常用的正则化技术,在FeedForward和Attention类中,Dropout层的作用是防止模型过拟合。在训练过程中,Dropout层会随机地将一部分神经元的输出置为 0,这样可以使模型更加鲁棒,减少对特定神经元的依赖,从而提高模型的泛化能力。 - 选择合适的
dropout率:dropout率是指在Dropout层中随机置为 0 的神经元的比例。选择合适的dropout率需要通过实验来确定。一般来说,可以从较小的dropout率(如 0.1 - 0.3)开始,逐步增加,观察模型在训练集和验证集上的表现。如果dropout率太小,可能无法有效地防止过拟合;如果dropout率太大,模型可能会欠拟合。通常,选择一个能够使模型在验证集上取得最佳性能的dropout率。
- 作用:
- 在
ViT类中,pool参数有两个可选值:'cls'和'mean',请解释它们的区别和适用场景
-
- 区别:
-
-
- 当
pool参数为'cls'时,模型使用cls_token的输出作为整个图像的表示,通过全连接层进行分类预测。cls_token在 Transformer 编码器中与其他图像块进行交互,聚合了图像的全局信息。 - 当
pool参数为'mean'时,模型对所有图像块的输出取平均值作为整个图像的表示,然后通过全连接层进行分类预测。
- 当
-
-
- 适用场景:
-
-
'cls'适用于需要捕捉图像全局信息的任务,因为cls_token能够更好地聚合图像的全局特征。例如,图像分类任务通常使用'cls'方式。'mean'适用于希望综合考虑所有图像块信息的场景,当图像的局部特征对任务也很重要时,可以使用'mean'方式。
-
代码实现与调试类
- 假设你在运行
ViT模型时遇到了RuntimeError: CUDA out of memory错误,你会采取哪些措施来解决这个问题
-
- 减小批量大小(Batch Size):批量大小是指每次训练时输入模型的样本数量。减小批量大小可以减少内存的使用,因为每次处理的样本数量减少了。可以尝试逐步减小批量大小,直到不再出现内存不足的错误。
- 释放不必要的变量:在训练过程中,及时释放不再使用的变量,避免内存泄漏。可以使用
del关键字删除不需要的变量,并调用torch.cuda.empty_cache()函数释放 GPU 缓存。 - 使用混合精度训练:混合精度训练是一种在训练过程中同时使用单精度(FP32)和半精度(FP16)浮点数的技术。半精度浮点数占用的内存较少,可以显著减少内存使用。在 PyTorch 中,可以使用
torch.cuda.amp模块来实现混合精度训练。 - 减小模型规模:可以尝试减小模型的参数数量,例如减少
depth、heads或dim等参数的值。这样可以降低模型的复杂度,减少内存使用。 - 使用梯度累积:梯度累积是一种在多个小批量上累积梯度,然后在一定步数后进行一次参数更新的技术。通过梯度累积,可以在不改变批量大小的情况下,减少每次更新所需的内存。
- 请描述如何对
ViT模型进行训练和评估,包括数据加载、模型初始化、损失函数选择和优化器设置等步骤
-
- 数据加载:
-
-
- 首先,需要准备好数据集,并将其划分为训练集和验证集。可以使用
torchvision库中的datasets和transforms模块来加载和预处理图像数据。例如:
- 首先,需要准备好数据集,并将其划分为训练集和验证集。可以使用
-
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

# 定义数据预处理
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

# 加载训练集和验证集
train_dataset = datasets.ImageFolder(root='path/to/train', transform=transform)
val_dataset = datasets.ImageFolder(root='path/to/val', transform=transform)

# 创建数据加载器
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
- **模型初始化**:
- 初始化 `ViT` 模型,并将其移动到 GPU 上(如果有可用的 GPU)。例如:import torch
# 初始化模型
model = ViT(
image_size=224,
patch_size=16,
num_classes=10,
dim=256,
depth=6,
heads=8,
mlp_dim=512
)
# 将模型移动到 GPU 上
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)- **损失函数选择**:
- 对于图像分类任务,通常使用交叉熵损失函数(`CrossEntropyLoss`)。例如:import torch.nn as nn
criterion = nn.CrossEntropyLoss()- **优化器设置**:
- 可以选择 Adam 优化器来更新模型的参数。例如:import torch.optim as optim
optimizer = optim.Adam(model.parameters(), lr=0.001)- **训练和评估循环**:num_epochs = 10
for epoch in range(num_epochs):
# 训练阶段
model.train()
train_loss = 0.0
for images, labels in train_loader:
images, labels = images.to(device), labels.to(device)
optimizer.zero_grad()
outputs = model(images)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
train_loss += loss.item()
# 评估阶段
model.eval()
val_loss = 0.0
correct = 0
total = 0
with torch.no_grad():
for images, labels in val_loader:
images, labels = images.to(device), labels.to(device)
outputs = model(images)
loss = criterion(outputs, labels)
val_loss += loss.item()
_, predicted = torch.max(outputs.data, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
print(f'Epoch {epoch + 1}/{num_epochs}, Train Loss: {train_loss / len(train_loader)}, Val Loss: {val_loss / len(val_loader)}, Val Acc: {100 * correct / total}%')以上就是对 ViT 模型进行训练和评估的基本步骤。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)