西湖大学赵世钰老师【强化学习的理论基础】01总述
·
基础知识总结
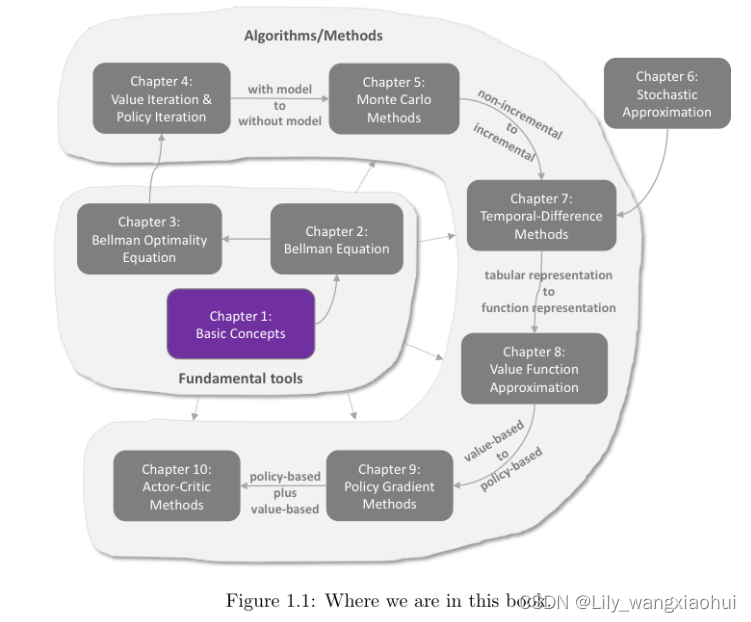
上图为赵老师在正式课程之前总述其课程的所有内容,可以看出这门课对于RL的基础原理层层递进,听完之后可以勾勒出这一条线清晰的流程。
第一章 基本概念
- 概念:state、action、reward、return、episode、policy……
- Grid-word网格世界的例子,一个机器人要在里面找到一个目标区域
- Markov decision process(MDP)框架下
- 基本概念会在之后广泛使用
第二章 贝尔曼公式
- 一个概念:state value(状态值)从一个状态出发沿着一个策略所得到的奖励回报的平均值,状态值可以评价策略的好坏
vπ(s)=E[Gt∣St=s] v_\pi(s)=E[G_t|S_t=s] vπ(s)=E[Gt∣St=s] - 一个工具:贝尔曼公式(描述所有状态状态值之间的关系)
vπ=rπ+γPπvπ v_\pi=r_\pi+\gamma P_\pi v_\pi vπ=rπ+γPπvπ - 策略评价(Policy evaluation)广泛使用
第三章 贝尔曼最优公式
- 对应一个最优策略(强化学习的终极目标)
- 两个概念:最优策略&最优的state value
- 一个工具:贝尔曼公式
v=maxπ(rπ+γPπv)=f(v) v=\max\limits_{\pi}(r_\pi+\gamma P_\pi v)=f(v) v=πmax(rπ+γPπv)=f(v)
- 不动点原理
- 基本问题:最优策略是否存在
- 解决公式的算法
第四章 值迭代&策略迭代
- 第一批能够求解最优策略的三个算法
- Value iteration(VI)
- Policy iteration(PI)
- Truncated policy iteration
- Policy update和value update
- 这一章介绍的算法需要模型
第五章 蒙特卡洛
- Gap:how to do model-free learning?
- 学习什么:随机变量的期望
E[X]≈x‾=1n∑i=1n(xi) E[X]\approx\overline{x}=\frac{1}{n}\sum_{i=1}{n}(x_i) E[X]≈x=n1i=1∑n(xi) - 没有模型要有数据,没有数据要有模型
- 第一个不需要模型的算法
- 算法
- MC Basic
- MC Exploring Starts
- MC epsilon-greedy
第六章 随机近似理论(Stochastic Approximation)
- Gap:from non-incremental(所有采样采到了一次性求平均) to incremental(开始对它有一个估计,得到一个采样就有一个更新)
- Mean estimation
- 算法
- Robbins-Monro(RM)算法 相当于一个等式为0
- Stochastic gradient descent(SGD)随机梯度下降
- SGD,BGD,MBGD
第七章 时序差分
- 典型的RL算法
- 算法(3种)
- TD learning of action values
- Sarsa:TD learning of action values
- Q-learning:TD learning of optimal action values
- on-policy & off-policy概念
behavior-policy用来生成经验数据和target-policy目标策略,如果两者相同就是on-policy,如果两者不同就是off-policy
- Unified point of view(统一化的视角)
第八章 值函数
- Gap:前面全部都是基于表格形式,现在要用函数的形式去代替
- 算法:
- State value estimation with value function approximation(VAF):
minwJ(w)=E[vπ(S)−v^(S,w)] \min\limits_{w} J(w)=E[v_\pi(S)-\widehat{v}(S,w)] wminJ(w)=E[vπ(S)−v(S,w)] - Saras with VAF
- Q-learning with VAF
- Deep Q-learning
- 神经网络引入到RL
第九章 Policy Gradient Methods
- Gap:from value-based to policy-based
- 步骤
- 定义目标函数
J(θ)=v‾π,r‾π J(\theta)=\overline{v}_\pi,\overline{r}_\pi J(θ)=vπ,rπ - 目标函数的梯度
∇J(θ)=E[∇θlnπ(A∣S,θ)qπ(S,A)] \nabla J(\theta)=E[\nabla_\theta ln\pi(A|S,\theta) q_\pi(S,A)] ∇J(θ)=E[∇θlnπ(A∣S,θ)qπ(S,A)] - 梯度上升算法(REINFORCE)
θt+1=θt+α∇θlnπ(at∣st,θt)qt(st,at) \theta_{t+1}=\theta_t+\alpha\nabla_\theta ln\pi(a_t|s_t,\theta_t)q_t(s_t,a_t) θt+1=θt+α∇θlnπ(at∣st,θt)qt(st,at)
第十章Actor-Critic方法
- policy-bsed和value-based方法
θt+1=θt+α∇θlnπ(at∣st,θt)qt(st,at) \theta_{t+1}=\theta_t+\alpha\nabla_\theta ln\pi(a_t|s_t,\theta_t)q_t(s_t,a_t) θt+1=θt+α∇θlnπ(at∣st,θt)qt(st,at) - 算法
- The simple actor-critic(QAC)
- Advantage actor-critic(A2C)
- Off-policy actor-critic(important sampling方法)
- Deterministic actor-critic

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 45
 0
- 0


 已为社区贡献1条内容

所有评论(0)