spark streaming(实时流词频统计)
·
首先在idea里
导入maven依赖包
 <dependency>
      <groupId>org.apache.kafka</groupId>
      <artifactId>kafka_2.11</artifactId>
      <version>2.0.0</version>
    </dependency>
    <dependency>
      <groupId>org.apache.kafka</groupId>
      <artifactId>kafka-streams</artifactId>
      <version>2.0.0</version>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-core_2.11</artifactId>
      <version>2.4.5</version>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-streaming_2.11</artifactId>
      <version>2.4.5</version>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-streaming-kafka-0-10_2.11</artifactId>
      <version>2.4.5</version>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-sql_2.11</artifactId>
      <version>2.4.5</version>
    </dependency>
    <dependency>
      <groupId>com.fasterxml.jackson.core</groupId>
      <artifactId>jackson-databind</artifactId>
      <version>2.6.6</version>
    </dependency>
注意,如果运行有报错依赖包冲突,需要加入如下依赖
<dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-client</artifactId>
            <version>2.6.0</version>
	</dependency>
1.spark streaming(实时词频统计案列)
1.spark版本代码展示
object SparkStreamDemo1 {
  def main(args: Array[String]): Unit = {
    val sparkconf = new SparkConf().setAppName("sparkStream").setMaster("local[2]")
    //采集周期,指定的3秒为每次采集的时间间隔
     val streamingContext = new StreamingContext(sparkconf,Seconds(3))

    // 指定采集的方法
    val sockerLineStream
    = streamingContext.socketTextStream("192.168.195.20",7777)
    //将采集来的信息进行处理,统计数据(wordcount)
    val wordStream=sockerLineStream.flatMap(line=>line.split("\\s+"))
    val mapStream = wordStream.map(x=>(x,1))
    val wordcountStream = mapStream.reduceByKey(_+_)

    //打印
    wordcountStream.print()

    //启动采集器
    streamingContext.start()
    streamingContext.awaitTermination()
  }
}
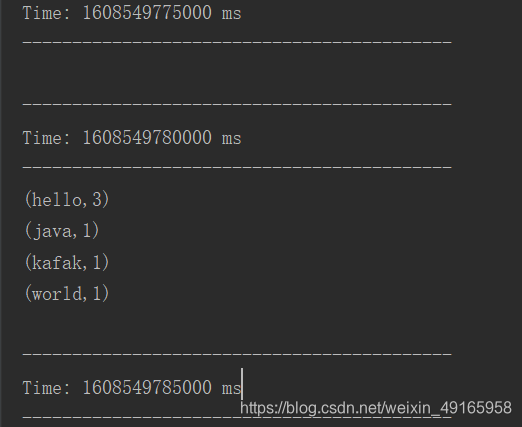
打开moba,打开测试端进行测试输出,是否为实时数据分析
nc -lk 7777
测试结果如图所示:
2.java版本代码展示
public class SparkStreamJavaDemo1 {
    public static void main(String[] args) {
        SparkConf sparkConf = new SparkConf().setMaster("local[*]").setAppName("sparkjavademo");
        JavaStreamingContext jsc = new JavaStreamingContext(sparkConf, Durations.seconds(3));

        JavaReceiverInputDStream<String> lines = jsc.socketTextStream("192.168.195.20", 7777);
        JavaDStream<String> fm = lines.flatMap(new FlatMapFunction<String, String>() {

            @Override
            public Iterator<String> call(String s) throws Exception {
                String[] split = s.split("\\s+");
                return Arrays.asList(split).iterator();
            }
        });
        JavaPairDStream<String, Integer> pair = fm.mapToPair(new PairFunction<String, String, Integer>() {
            @Override
            public Tuple2<String, Integer> call(String s) throws Exception {

                return new Tuple2<String, Integer>(s, 1);
            }
        });
        JavaPairDStream<String, Integer> reduceByKey = pair.reduceByKey(new Function2<Integer, Integer, Integer>() {
            @Override
            public Integer call(Integer v1, Integer v2) throws Exception {
                return v1 + v2;
            }
        });

        reduceByKey.print();
        jsc.start();
        try {
            jsc.awaitTermination();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
}
2.spark streaming 文件导入实时分析
object SparkStreamFileDataSourceDemo2 {
  def main(args: Array[String]): Unit = {
    val sparkConf = new SparkConf().setMaster("local[2]").setAppName("filesouce")
    val streamingConmtext = new StreamingContext(sparkConf,Seconds(5))
     //需要实时分析的文件路径
    val fileDstream = streamingConmtext.textFileStream("in/test")
    val wordStream = fileDstream.flatMap(line=>line.split("\\s+"))
    val mapStream = wordStream.map((_,1))
    val sumStream = mapStream.reduceByKey(_+_)
    sumStream.print()
    streamingConmtext.start()
    streamingConmtext.awaitTermination()
  }
}
注意:这个方法经过验证几次,有时候不会输出数据,不太稳定,
我采取的措施时,更改好a.txt文档的内容后,在对它进行重命名操作,即可实时输出数据分析
3.spark streaming 连接kafka ,进行实时分析数据
1.spark代码展示
object SparkStreamKafkaSource {
  def main(args: Array[String]): Unit = {
    val sparkConf = new SparkConf().setAppName("kafaksource").setMaster("local[2]")
   val streamingContext = new StreamingContext(sparkConf,Seconds(5))

    val kafkaParams = Map(
      (ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG -> "192.168.195.20:9092"),
      (ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG -> "org.apache.kafka.common.serialization.StringDeserializer"),
      (ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG -> "org.apache.kafka.common.serialization.StringDeserializer"),
      (ConsumerConfig.GROUP_ID_CONFIG, "KafkaGroup1")
    )//以上都为固定格式,没什么好说的

    val kafkaStream:InputDStream[ConsumerRecord[String,String]]
    = KafkaUtils.createDirectStream(streamingContext, LocationStrategies.PreferConsistent,
      ConsumerStrategies.Subscribe(Set("sparkKafkaDemo"), kafkaParams)
    )//sparkKafkaDemo为Kafka里的topic生产者,通过它生产数据来进行实时分析
    val wordStream = kafkaStream.flatMap(v=>v.value().toString.split("\\s+"))
    //这里要注意取value值进行切割
    val mapStream = wordStream.map((_,1))
    val sumStream = mapStream.reduceByKey(_+_)
    sumStream.print()
    streamingContext.start()
    streamingContext.awaitTermination()
  }
}
2.打开moba,开启Kafka,创建sparkKafkaDemo的topic
kafka-topics.sh --create --zookeeper 192.168.195.20:2181 --topic sparkKafkaDemo --partitions 1 --replication-factor 1
3.kafka生产数据,测试实时输出
kafka-console-producer.sh --topic sparkKafkaDemo --broker-list 192.168.195.20:9092
4.Spark Streaming自定义采集器 reciver
声明一个receiver类,通常需要继承原有的基类,在这里需要继承自Receiver,该基类有两个方法需要重写分别是:
- onstart() 接收器开始运行时触发方法,在该方法内需要启动一个线程,用来接收数据。
- onstop() 接收器结束运行时触发的方法,在该方法内需要确保停止接收数据。
当然在接收数据流过程中也可能会发生终止接收数据的情况,这时候onstart内可以通过isStoped()来判断 ,是否应该停止接收数据
数据存储。一旦接收完数据,则必须要进行数据的存储,并交由SparkStreaming 来处理,Spark以store(data)方法来支持此流程。由于数据格式的不同,当然store方法必须要支持各种类型的数据存储。store方法是以一次存储一条记录或者一次性收集全部的序列化对象。
代码展示:
采集端口内输入内容,接收到 ‘‘end’’ 停止
 class MyReceiver(host:String,port:Int) extends Receiver[String](StorageLevel.MEMORY_ONLY) {
  var socket:java.net.Socket=null
  def receive():Unit={
     socket=new java.net.Socket(host,port)
    val reader = new BufferedReader(new InputStreamReader(socket.getInputStream,"UTF-8"))
    var line:String =null;
    while((line=reader.readLine())!=null){
      if(line.equals("end")){
        return
    }else{
        this.store(line)
      }
  }
  }
    override def onStart(): Unit =
      new Thread(new Runnable {
        override def run(): Unit ={
          receive()
        }
      }).start()
  override def onStop(): Unit = {
    if(socket!=null){
      socket.close()
      socket=null
    }
  }
  }
测试输出代码展示:
object  MyReceiverDemo{
  def main(args: Array[String]): Unit = {
    val sparkConf = new SparkConf().setMaster("local[2]").setAppName("demo")
    val streamContext = new StreamingContext(sparkConf,Seconds(5))
    val receiverStream
    = streamContext.receiverStream(new MyReceiver("192.168.195.20",7777))
    val lineSrtream = receiverStream.flatMap(line=>line.split("\\s+"))
    val mapStream = lineSrtream.map((_,1))
    val sumStream = mapStream.reduceByKey(_+_)
    sumStream.print()
    streamContext.start()
    streamContext.awaitTermination()
  }
}
moba上运行代码测试输出:
nc -lk 7777

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)