spark报错Initial job has not accepted any resources; check your cluster UI to ensure that workers are
·
报错:
Initial job has not accepted any resources; check your cluster UI to ensure that workers are registered and have sufficient resources
我在jupyter notebook中以:
spark = SparkSession.builder.master('spark://hadoop101:7077').appName('apply123').getOrCreate() 创建的application的Executor会使用spark-env.sh配置文件中设置的内存和core数量,如下:
export SPARK_WORKER_CORES=2
export SPARK_EXECUTOR_MEMORY=900m

900m<1024,不会报错。
如果改为:
export SPARK_EXECUTOR_MEMORY=1900m
然后在jupyter notebook中以:
spark = SparkSession.builder.master('spark://hadoop101:7077').appName('apply123').getOrCreate() 创建的application,如图:
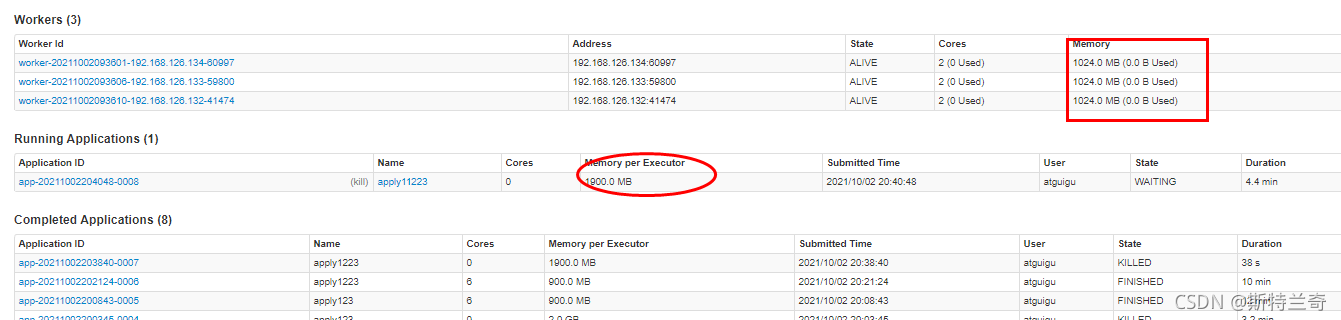
会报错。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 2
 0
- 0


 已为社区贡献9条内容

所有评论(0)