神经网络与深度学习5---循环神经网络
本文是邱锡鹏教授撰写的《神经网络与深度学习》一书中 第6章:循环神经网络 的读书笔记,主要内容是一些本人觉得比较值得记录的内容,中间也会包括一些拓展和思考。
循环神经网络
传统的前馈神经网络在处理带有时序的数据(例如文本,语音等)时往往能力有限:1. 由于其全连接的结构使得无法学到数据的时序信息,2. 时序数据的输入长度通常是不定的,而前馈神经网络的输入是定长的。针对以上这些特性,研究员们推出了一类称为 循环神经网络 的深度模型结构。其主要模块结构如下:
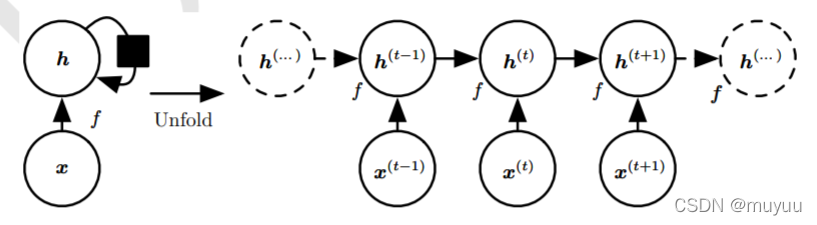
写成数学表达式即为:
h
(
t
)
=
f
(
h
(
t
−
1
)
,
x
(
t
)
;
Θ
)
\boldsymbol h^{(t)}=f(\boldsymbol h^{(t-1)},\boldsymbol x^{(t)};\Theta)
h(t)=f(h(t−1),x(t);Θ)
为了让模型能够处理不定长的序列,其中 函数 f f f 的参数 Θ \Theta Θ 在所有时间步 t t t 上是共享的。通过这个模块结构,循环神经网络同时解决了 无法学到时序信息 和 输入不定长 两个问题。
参数量
以最简单的单隐藏层RNN为例,输入层大小是:step_size × \times × batch_size × \times × vocab_size = s × \times × b × \times × v
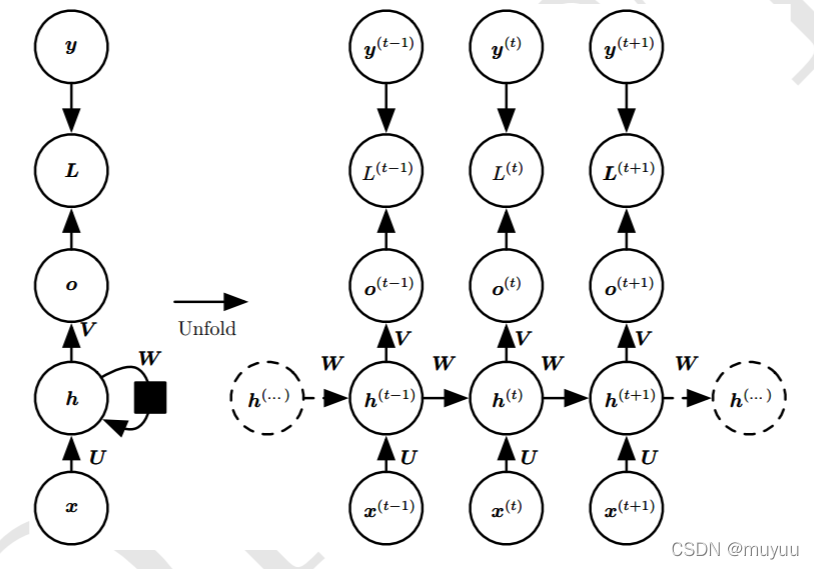
输入层到隐藏层的公式为:
H
t
=
ϕ
(
X
t
U
+
H
t
−
1
W
+
b
h
)
\boldsymbol H_t = \phi(\boldsymbol X_t \boldsymbol U + \boldsymbol H_{t-1} \boldsymbol W + \boldsymbol b_h)
Ht=ϕ(XtU+Ht−1W+bh)
其中 X t ∈ R b × v \boldsymbol X_t \in \mathbb{R}^{b\times v} Xt∈Rb×v, U ∈ R v × h \boldsymbol U \in \mathbb{R}^{v\times h} U∈Rv×h, H t , H t − 1 ∈ R b × h \boldsymbol H_t, \boldsymbol H_{t-1} \in \mathbb{R}^{b\times h} Ht,Ht−1∈Rb×h, W ∈ R h × h \boldsymbol W \in \mathbb{R}^{h\times h} W∈Rh×h。因此该层参数量为 v × h + h × h + h v\times h + h\times h + h v×h+h×h+h。
隐藏层到输出层公式为:
O
t
=
softmax
(
H
t
V
+
b
o
)
\boldsymbol O_t = \text{softmax}(\boldsymbol H_t \boldsymbol V + \boldsymbol b_o)
Ot=softmax(HtV+bo)
其中 H t ∈ R b × h \boldsymbol H_t \in \mathbb{R}^{b\times h} Ht∈Rb×h, V ∈ R h × o \boldsymbol V \in \mathbb{R}^{h\times o} V∈Rh×o, O t ∈ R b × o \boldsymbol O_t \in \mathbb{R}^{b\times o} Ot∈Rb×o。因此该层参数量为 h × o + h h\times o + h h×o+h。由于输出维度 b × o b\times o b×o = batch_size × \times × vocab_size,即 O t \boldsymbol O_t Ot 每一行为词表内所有词在位置 t 出现的概率大小。
计算参数量时,只需考虑一个时间步所需的参数,因为所有时间步是共享参数的。
梯度不稳定性(长程依赖问题)
仍以上述单隐藏层RNN为例,在不影响我们对反向传播过程分析的情况下,考虑偏置都为零,激活函数 ϕ ( x ) = x \phi(x) = x ϕ(x)=x,那么有:
h t = x t U + h t − 1 W o t = h t V \begin{aligned} \boldsymbol h_t &= \boldsymbol x_t \boldsymbol U + \boldsymbol h_{t-1} \boldsymbol W\\ \boldsymbol o_t &= \boldsymbol h_t \boldsymbol V \end{aligned} htot=xtU+ht−1W=htV
目标函数的总体损失,是所有时间步上损失的均值:
L
=
1
T
∑
t
=
1
T
l
(
o
t
,
y
t
)
L = \frac{1}{T} \sum_{t=1}^T l(\boldsymbol o_t, y_t)
L=T1t=1∑Tl(ot,yt)
输出层参数
V
\boldsymbol V
V 的梯度计算比较简单:
∂
L
∂
V
=
∑
t
=
1
T
∂
L
∂
o
t
⋅
∂
o
t
∂
V
=
1
T
∑
t
=
1
T
h
t
T
∂
l
(
o
t
,
y
t
)
∂
o
t
\frac{\partial L}{\partial \boldsymbol V} = \sum_{t=1}^T \frac{\partial L}{\partial \boldsymbol o_t} \cdot \frac{\partial \boldsymbol o_t}{\partial \boldsymbol V} = \frac{1}{T} \sum_{t=1}^T \boldsymbol h_t^T \frac{\partial l(\boldsymbol o_t, y_t)}{\partial \boldsymbol o_t}
∂V∂L=t=1∑T∂ot∂L⋅∂V∂ot=T1t=1∑ThtT∂ot∂l(ot,yt)
对于隐藏层,目标函数
L
L
L 通过隐状态
h
1
,
⋯
,
h
T
\boldsymbol h_1, \cdots, \boldsymbol h_T
h1,⋯,hT 依赖于隐藏层参数
U
,
W
\boldsymbol U, \boldsymbol W
U,W,那么应用链式法则有:
∂
L
∂
U
=
∑
t
=
1
T
∂
L
∂
h
t
⋅
∂
h
t
∂
U
=
∑
t
=
1
T
x
t
T
∂
L
∂
h
t
∂
L
∂
W
=
∑
t
=
1
T
∂
L
∂
h
t
⋅
∂
h
t
∂
W
=
∑
t
=
1
T
h
t
−
1
T
∂
L
∂
h
t
\begin{aligned} \frac{\partial L}{\partial \boldsymbol U} &= \sum_{t=1}^T \frac{\partial L}{\partial \boldsymbol h_t} \cdot \frac{\partial \boldsymbol h_t}{\partial \boldsymbol U} = \sum_{t=1}^T \boldsymbol x_t^T \frac{\partial L}{\partial \boldsymbol h_t} \\ \frac{\partial L}{\partial \boldsymbol W} &= \sum_{t=1}^T \frac{\partial L}{\partial \boldsymbol h_t} \cdot \frac{\partial \boldsymbol h_t}{\partial \boldsymbol W} = \sum_{t=1}^T \boldsymbol h_{t-1}^T \frac{\partial L}{\partial \boldsymbol h_t} \end{aligned}
∂U∂L∂W∂L=t=1∑T∂ht∂L⋅∂U∂ht=t=1∑TxtT∂ht∂L=t=1∑T∂ht∂L⋅∂W∂ht=t=1∑Tht−1T∂ht∂L
下面只需要计算
∂
L
∂
h
t
\frac{\partial L}{\partial \boldsymbol h_t}
∂ht∂L。观察循环神经网络的参数流动,不难发现目标函数
L
L
L 对
h
t
\boldsymbol h_t
ht 的依赖有两条路径 :
h
t
→
o
t
→
L
\boldsymbol h_t \rightarrow \boldsymbol o_t \rightarrow L
ht→ot→L 以及
h
t
→
h
t
+
1
→
o
t
+
1
→
L
\boldsymbol h_t \rightarrow \boldsymbol h_{t+1} \rightarrow \boldsymbol o_{t+1} \rightarrow L
ht→ht+1→ot+1→L,那么:
∂
L
∂
h
t
=
∂
L
∂
o
t
⋅
∂
o
t
∂
h
t
+
∂
L
∂
h
t
+
1
⋅
∂
h
t
+
1
∂
h
t
=
∂
L
∂
o
t
V
T
+
∂
L
∂
h
t
+
1
W
T
\frac{\partial L}{\partial \boldsymbol h_t} = \frac{\partial L}{\partial \boldsymbol o_t} \cdot \frac{\partial \boldsymbol o_t}{\partial \boldsymbol h_t} + \frac{\partial L}{\partial \boldsymbol h_{t+1}} \cdot \frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t} = \frac{\partial L}{\partial \boldsymbol o_t} \boldsymbol V^T + \frac{\partial L}{\partial \boldsymbol h_{t+1}} \boldsymbol W^T
∂ht∂L=∂ot∂L⋅∂ht∂ot+∂ht+1∂L⋅∂ht∂ht+1=∂ot∂LVT+∂ht+1∂LWT
上式满足等比关系,将其展开递归计算得:
∂
L
∂
h
t
=
∑
i
=
t
T
(
W
)
T
−
i
V
∂
L
∂
o
T
+
t
−
i
\frac{\partial L}{\partial \boldsymbol h_t} = \sum_{i=t}^T (\boldsymbol W)^{T-i} \boldsymbol V \frac{\partial L}{\partial \boldsymbol o_{T+t-i}}
∂ht∂L=i=t∑T(W)T−iV∂oT+t−i∂L
因此当 T − i T-i T−i 足够大时,矩阵 W \boldsymbol W W 小于1的特征值趋于消失,大于1的特征趋于发散,这会导致数值的不稳定。
代回到隐藏层参数的梯度 ∂ L ∂ U , ∂ L ∂ W \frac{\partial L}{\partial \boldsymbol U}, \frac{\partial L}{\partial \boldsymbol W} ∂U∂L,∂W∂L,当时间步 t t t 距离 T T T 比较远时, 这个时间步位置的梯度 x t T ∂ L ∂ h t , h t − 1 T ∂ L ∂ h t \boldsymbol x_t^T \frac{\partial L}{\partial \boldsymbol h_t},\boldsymbol h_{t-1}^T \frac{\partial L}{\partial \boldsymbol h_t} xtT∂ht∂L,ht−1T∂ht∂L容易产生梯度消失和梯度爆炸的现象,导致难以建模这种长距离的依赖关系。(注:由于总梯度是各个时间步梯度分量的和,因此总梯度并不会消失,只是被近距离梯度所主导了)
由于RNN是在时间步上循环的,理论上这个循环可以发生在全数据集上,也就是说隐状态可以从数据集的第一个词循环流动到最后一个词。但这样会导致计算量巨大并且更容易发生梯度消失或梯度爆炸,因此一种常见的做法是在每一个batch结束时分离梯度,也就是说 T − i ≤ T-i \leq T−i≤ 截断长度 σ \sigma σ。这样会使得该模型主要侧重于短期影响,而不是长期影响。 这在现实中是可取的,因为它会将估计值偏向更简单和更稳定的模型。
基于门控的循环神经网络
前面提到减轻梯度消失or爆炸的一种方式是适当得分离梯度,也就是说放弃长期的历史影响,只保留短期的历史影响。但现实的情况可能是更复杂的:
- 某些早期词元对于后面词元的预测有非常重要的影响,我们希望有某种机制能够在一个记忆元里存储重要的早期信息。
- 一些词元没有相关的观测值。 例如,在对网页内容进行情感分析时, 可能有一些辅助HTML代码与网页传达的情绪无关。 我们希望有一些机制来跳过隐状态表示中的此类词元。
针对上面的需求,研究人员设计出了一系列基于“门控”的循环神经网络,这些“门”的主要作用就是控制每一个时间步历史信息的去留。下面介绍两类有代表性的门控系统:
LSTM
LSTM在隐状态
h
t
\boldsymbol h_t
ht 和输入特征
x
t
\boldsymbol x_t
xt 之外还引入了一个新单元:记忆单元
c
t
\boldsymbol c_t
ct。并且隐状态
h
t
\boldsymbol h_t
ht 直接由记忆单元
c
t
\boldsymbol c_t
ct 决定:
h
t
=
o
t
⊙
tanh
(
c
t
)
\boldsymbol h_t = \boldsymbol o_t \odot \text{tanh}(\boldsymbol c_t)
ht=ot⊙tanh(ct)
其中 ⊙ \odot ⊙ 指按元素乘积。 注意上式的 o t \boldsymbol o_t ot 不是上一节中使用的输出层神经元,而是LSTM中的“输出门控单元”。
记忆单元
c
t
\boldsymbol c_t
ct 顾名思义,是用来控制输入和遗忘(跳过)的单元,它记录了到当前步为止的历史信息,具体定义为:
c
t
=
f
t
⊙
c
t
−
1
+
i
t
⊙
c
t
~
\boldsymbol c_t = \boldsymbol f_t \odot \boldsymbol c_{t-1} + \boldsymbol i_t \odot \tilde{\boldsymbol c_t}
ct=ft⊙ct−1+it⊙ct~
其中
f
t
\boldsymbol f_t
ft 是 “遗忘门控单元”,
i
t
\boldsymbol i_t
it 是 “输入门控单元”。而
c
t
~
\tilde{\boldsymbol c_t}
ct~ 称为 “候选记忆单元”,它是上一时间步隐状态
h
t
−
1
\boldsymbol h_{t-1}
ht−1 和该时间步输入特征
x
t
\boldsymbol x_t
xt 的非线性函数:
c
t
~
=
tanh
(
x
t
U
c
+
h
t
−
1
W
c
+
b
c
)
\tilde{\boldsymbol c_t} = \text{tanh}(\boldsymbol x_t \boldsymbol U_c + \boldsymbol h_{t-1}\boldsymbol W_c + \boldsymbol b_c)
ct~=tanh(xtUc+ht−1Wc+bc)
到此为止,我们就引出了LSTM中定义的全部三个门控单元:
- 遗忘门控单元 f t \boldsymbol f_t ft,用于控制上一个时间步记忆单元 c t − 1 \boldsymbol c_{t-1} ct−1 对当前时间步记忆单元 c t \boldsymbol c_t ct 的影响
- 输入门控单元 i t \boldsymbol i_t it,用于控制当前时间步候选记忆单元 c t ~ \tilde{\boldsymbol c_t} ct~ 对当前时间步记忆单元 c t \boldsymbol c_t ct 的影响
- 输出门控单元 o t \boldsymbol o_t ot,用于控制当前时间步记忆单元 c t \boldsymbol c_t ct 有多少信息要输出给当前步隐状态 h t \boldsymbol h_t ht
标准的“门”应该是一个{0,1}的二值函数,但是为了求导方便,以及门控的灵活性,我们使用sigmiod函数来模拟“门”的效果:
f
t
=
sigmoid
(
x
t
U
f
+
h
t
−
1
W
f
+
b
f
)
i
t
=
sigmoid
(
x
t
U
i
+
h
t
−
1
W
i
+
b
i
)
o
t
=
sigmoid
(
x
t
U
o
+
h
t
−
1
W
o
+
b
o
)
\begin{aligned} \boldsymbol f_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_f + \boldsymbol h_{t-1}\boldsymbol W_f + \boldsymbol b_f)\\ \boldsymbol i_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_i + \boldsymbol h_{t-1}\boldsymbol W_i + \boldsymbol b_i)\\ \boldsymbol o_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_o + \boldsymbol h_{t-1}\boldsymbol W_o + \boldsymbol b_o)\\ \end{aligned}
ftitot=sigmoid(xtUf+ht−1Wf+bf)=sigmoid(xtUi+ht−1Wi+bi)=sigmoid(xtUo+ht−1Wo+bo)
当 f t = 0 , i t = 1 \boldsymbol f_t = 0, \boldsymbol i_t = 1 ft=0,it=1 时,记忆单元将历史信息清空,并将候选状态向量 c t ~ \tilde{\boldsymbol c_t} ct~ 写入。但此时记忆单元 c t \boldsymbol c_t ct 依然和上一时刻的历史信息相关。当 f t = 1 , i t = 0 \boldsymbol f_t = 1, \boldsymbol i_t = 0 ft=1,it=0 时,记忆单元将复制上一时刻的内容,不写入新的信息 。
总结一下LSTM的计算流程:
- 用上一时间步隐状态 h t − 1 \boldsymbol h_{t-1} ht−1 和该时间步输入特征 x t \boldsymbol x_t xt 分别计算出三个门 f t , i t , o t \boldsymbol f_t, \boldsymbol i_t, \boldsymbol o_t ft,it,ot 以及候选记忆单元 c t ~ \tilde{\boldsymbol c_t} ct~:
f t = sigmoid ( x t U f + h t − 1 W f + b f ) i t = sigmoid ( x t U i + h t − 1 W i + b i ) o t = sigmoid ( x t U o + h t − 1 W o + b o ) c t ~ = tanh ( x t U c + h t − 1 W c + b c ) \begin{aligned} \boldsymbol f_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_f + \boldsymbol h_{t-1}\boldsymbol W_f + \boldsymbol b_f)\\ \boldsymbol i_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_i + \boldsymbol h_{t-1}\boldsymbol W_i + \boldsymbol b_i)\\ \boldsymbol o_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_o + \boldsymbol h_{t-1}\boldsymbol W_o + \boldsymbol b_o)\\ \tilde{\boldsymbol c_t} &= \text{tanh}(\boldsymbol x_t \boldsymbol U_c + \boldsymbol h_{t-1}\boldsymbol W_c + \boldsymbol b_c) \end{aligned} ftitotct~=sigmoid(xtUf+ht−1Wf+bf)=sigmoid(xtUi+ht−1Wi+bi)=sigmoid(xtUo+ht−1Wo+bo)=tanh(xtUc+ht−1Wc+bc)- 结合遗忘门 f t \boldsymbol f_t ft 和 输入门 i t \boldsymbol i_t it 来更新记忆单元 c t \boldsymbol c_t ct:
c t = f t ⊙ c t − 1 + i t ⊙ c t ~ \boldsymbol c_t = \boldsymbol f_t \odot \boldsymbol c_{t-1} + \boldsymbol i_t \odot \tilde{\boldsymbol c_t} ct=ft⊙ct−1+it⊙ct~- 结合输出门 o t \boldsymbol o_t ot 将记忆单元 c t \boldsymbol c_t ct 的信息传递给隐状态 h t \boldsymbol h_t ht:
h t = o t ⊙ tanh ( c t ) \boldsymbol h_t = \boldsymbol o_t \odot \text{tanh}(\boldsymbol c_t) ht=ot⊙tanh(ct)
LSTM为什么可以缓解梯度不稳定现象
回忆上一节中解释传统RNN的梯度不稳定性,主要问题出在:
∂ L ∂ h t = ∑ i = t T ( ∂ h t + 1 ∂ h t ) T − i ∂ o t ∂ h t ∂ L ∂ o T + t − i = ∑ i = t T ( W ) T − i V ∂ L ∂ o T + t − i \frac{\partial L}{\partial \boldsymbol h_t} = \sum_{i=t}^T (\frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t})^{T-i} \frac{\partial \boldsymbol o_t}{\partial \boldsymbol h_t} \frac{\partial L}{\partial \boldsymbol o_{T+t-i}} = \sum_{i=t}^T (\boldsymbol W)^{T-i} \boldsymbol V \frac{\partial L}{\partial \boldsymbol o_{T+t-i}} ∂ht∂L=i=t∑T(∂ht∂ht+1)T−i∂ht∂ot∂oT+t−i∂L=i=t∑T(W)T−iV∂oT+t−i∂L
由于不同时间步的 ∂ h t + 1 ∂ h t \frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t} ∂ht∂ht+1 恒为 W \boldsymbol W W,造成了 W \boldsymbol W W 矩阵的连乘,引发了梯度不稳定现象。
而在LSTM中,隐状态间的循环关系转变成了记忆单元间的循环关系,因此我们只需要看 ∂ c t ∂ c t − 1 \frac{\partial \boldsymbol c_t}{\partial \boldsymbol c_{t-1}} ∂ct−1∂ct 的值。观察LSTM的流动图,不难发现 c t − 1 \boldsymbol c_{t-1} ct−1 到 c t \boldsymbol c_t ct 的流动要经过 f t , i t , c t ~ \boldsymbol f_t, \boldsymbol i_t, \tilde{\boldsymbol c_t} ft,it,ct~:
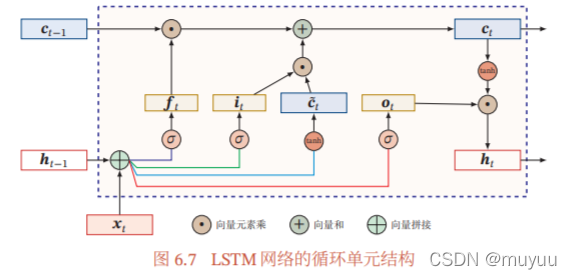
为了公式简洁,同样先假设激活函数导数都是1,那么有:
∂
c
t
∂
c
t
−
1
=
∂
c
t
∂
f
t
∂
f
t
∂
h
t
−
1
∂
h
t
−
1
∂
c
t
−
1
+
∂
c
t
∂
i
t
∂
i
t
∂
h
t
−
1
∂
h
t
−
1
∂
c
t
−
1
+
∂
c
t
∂
c
t
~
∂
c
t
~
∂
h
t
−
1
∂
h
t
−
1
∂
c
t
−
1
+
∂
c
t
∂
c
t
−
1
=
c
t
−
1
W
f
o
t
−
1
+
c
t
~
W
i
o
t
−
1
+
i
t
W
c
o
t
−
1
+
f
t
\begin{aligned} \frac{\partial \boldsymbol c_t}{\partial \boldsymbol c_{t-1}} &= \frac{\partial \boldsymbol c_t}{\partial \boldsymbol f_t} \frac{\partial \boldsymbol f_t}{\partial \boldsymbol h_{t-1}} \frac{\partial \boldsymbol h_{t-1}}{\partial \boldsymbol c_{t-1}} + \frac{\partial \boldsymbol c_t}{\partial \boldsymbol i_t} \frac{\partial \boldsymbol i_t}{\partial \boldsymbol h_{t-1}} \frac{\partial \boldsymbol h_{t-1}}{\partial \boldsymbol c_{t-1}} + \frac{\partial \boldsymbol c_t}{\partial \tilde{\boldsymbol c_t}} \frac{\partial \tilde{\boldsymbol c_t}}{\partial \boldsymbol h_{t-1}} \frac{\partial \boldsymbol h_{t-1}}{\partial \boldsymbol c_{t-1}} + \frac{\partial \boldsymbol c_t}{\partial \boldsymbol c_{t-1}}\\ &= \boldsymbol c_{t-1} \boldsymbol W_f \boldsymbol o_{t-1} + \tilde{\boldsymbol c_t} \boldsymbol W_i \boldsymbol o_{t-1} + \boldsymbol i_t \boldsymbol W_c \boldsymbol o_{t-1} + \boldsymbol f_t \end{aligned}
∂ct−1∂ct=∂ft∂ct∂ht−1∂ft∂ct−1∂ht−1+∂it∂ct∂ht−1∂it∂ct−1∂ht−1+∂ct~∂ct∂ht−1∂ct~∂ct−1∂ht−1+∂ct−1∂ct=ct−1Wfot−1+ct~Wiot−1+itWcot−1+ft
观察到加式前三项中的 W f , W i , W c \boldsymbol W_f, \boldsymbol W_i, \boldsymbol W_c Wf,Wi,Wc, 跟传统RNN中的 ∂ h t + 1 ∂ h t = W \frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t} = \boldsymbol W ∂ht∂ht+1=W 一样,都是不随时间步发生变化的,这会导致矩阵连乘,进而造成梯度不稳定现象。 但是最后一项 f t \boldsymbol f_t ft 对于不同时间步是不一样的,因此不会发生上述那种出现矩阵的幂的情况,缓解了梯度消失的情况。
而且根据上面的分析,我们也可以得出结论:遗忘门 f t \boldsymbol f_t ft 有助于捕获序列中的长期依赖关系。
LSTM更多是解决梯度消失的问题,仍然有可能出现梯度爆炸。但由于 LSTM 的其他路径非常崎岖,和普通 RNN 相比多经过了很多次激活函数(导数都小于 1),因此 LSTM 发生梯度爆炸的频率要低得多。而且实践中梯度爆炸一般可以通过梯度裁剪来解决。
GRU
另一个常用的门控单元是GRU,它实际是对LSTM的一种简化,首先抛弃了记忆单元
c
t
\boldsymbol c_t
ct,循环部分依然在隐状态间发生。而且注意到LSTM中互补关系的遗忘门
f
t
\boldsymbol f_t
ft 和输入门
i
t
\boldsymbol i_t
it,具有一定冗余性,因此GRU只用一个 更新门
z
t
\boldsymbol z_t
zt 来控制输入和遗忘间的平衡 :
h
t
=
z
t
⊙
h
t
−
1
+
(
1
−
z
t
)
⊙
h
t
~
\boldsymbol h_t = \boldsymbol z_t \odot \boldsymbol h_{t-1} + (1-\boldsymbol z_t) \odot \tilde{\boldsymbol h_t}
ht=zt⊙ht−1+(1−zt)⊙ht~
对候选隐状态的定义也跟LSTM有所不同,引入了一个新的门控单元 重置门
r
t
\boldsymbol r_t
rt:
h
t
~
=
tanh
(
x
t
U
h
+
(
r
t
⊙
h
t
−
1
)
W
h
+
b
h
)
\tilde{\boldsymbol h_t} = \text{tanh}(\boldsymbol x_t \boldsymbol U_h + (\boldsymbol r_t \odot \boldsymbol h_{t-1})\boldsymbol W_h + \boldsymbol b_h)
ht~=tanh(xtUh+(rt⊙ht−1)Wh+bh)
- 当 z t = 0 , r t = 1 \boldsymbol z_t = 0,\boldsymbol r_t = 1 zt=0,rt=1 时,GRU退化为简单循环网络
- 当 z t = 0 , r t = 0 \boldsymbol z_t = 0,\boldsymbol r_t = 0 zt=0,rt=0 时,GRU退化为前馈神经网络
- 当 z t = 1 \boldsymbol z_t = 1 zt=1 时,当前状态 h t \boldsymbol h_t ht 等于上一时刻状态 h t − 1 \boldsymbol h_{t-1} ht−1,和当前输入 x t \boldsymbol x_t xt 无关
重置门
r
t
\boldsymbol r_t
rt 和 更新门
z
t
\boldsymbol z_t
zt 的定义方式与LSTM中的门控单元一致:
r
t
=
sigmoid
(
x
t
U
r
+
h
t
−
1
W
r
+
b
r
)
z
t
=
sigmoid
(
x
t
U
z
+
h
t
−
1
W
z
+
b
z
)
\begin{aligned} \boldsymbol r_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_r + \boldsymbol h_{t-1}\boldsymbol W_r + \boldsymbol b_r)\\ \boldsymbol z_t &= \text{sigmoid}(\boldsymbol x_t \boldsymbol U_z + \boldsymbol h_{t-1}\boldsymbol W_z + \boldsymbol b_z) \end{aligned}
rtzt=sigmoid(xtUr+ht−1Wr+br)=sigmoid(xtUz+ht−1Wz+bz)
再来看看GRU是否也可以解决梯度消失问题,计算 ∂ h t ∂ h t − 1 \frac{\partial \boldsymbol h_t}{\partial \boldsymbol h_{t-1}} ∂ht−1∂ht,观察GRU的计算图,从 h t − 1 \boldsymbol h_{t-1} ht−1 到 h t \boldsymbol h_t ht 要经过 z t \boldsymbol z_t zt 和 h t ~ \tilde{\boldsymbol h_t} ht~:
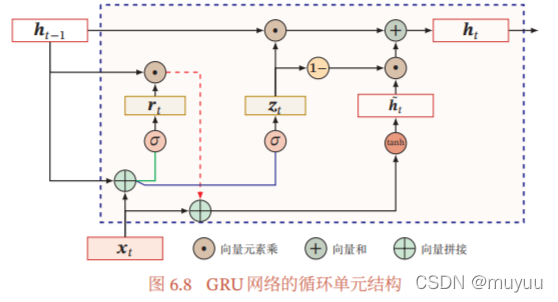
∂ h t ∂ h t − 1 = ∂ h t ∂ z t ∂ z t ∂ h t − 1 + ∂ h t ∂ h t ~ ∂ h t ~ ∂ h t − 1 + ∂ h t ∂ h t − 1 = ( h t − 1 − h t ~ ) W z + ( 1 − z t ) r t W h + z t \begin{aligned} \frac{\partial \boldsymbol h_t}{\partial \boldsymbol h_{t-1}} &= \frac{\partial \boldsymbol h_t}{\partial \boldsymbol z_t} \frac{\partial \boldsymbol z_t}{\partial \boldsymbol h_{t-1}} + \frac{\partial \boldsymbol h_t}{\partial \tilde{\boldsymbol h_t}} \frac{\partial \tilde{\boldsymbol h_t}}{\partial \boldsymbol h_{t-1}} + \frac{\partial \boldsymbol h_t}{\partial \boldsymbol h_{t-1}}\\ &= (\boldsymbol h_{t-1} - \tilde{\boldsymbol h_t})\boldsymbol W_z + (1-\boldsymbol z_t)\boldsymbol r_t \boldsymbol W_h + \boldsymbol z_t \end{aligned} ∂ht−1∂ht=∂zt∂ht∂ht−1∂zt+∂ht~∂ht∂ht−1∂ht~+∂ht−1∂ht=(ht−1−ht~)Wz+(1−zt)rtWh+zt
与LSTM一样,上式的最后一项 z t \boldsymbol z_t zt 在不同时间步是不一样的,因此连乘也不会出现矩阵幂,缓解了梯度消失的问题。
同样类似LSTM的分析,可以得出结论:GRU中更新门 z t \boldsymbol z_t zt 更有助于捕获序列中的长期依赖关系。
LSTM的参数量是传统RNN的四倍(分别是三个门以及候选记忆单元),而GRU对LSTM做了简化,参数量只有传统RNN的三倍(两个门及候选隐状态)
贪心搜索,束搜索
由于循环网络的输入和输出一般都是序列,当输出序列的长度为 n,输出类别的大小为 | Y \mathcal{Y} Y| 时,求解最优序列是一个复杂度为 O ( ∣ Y ∣ n ) O(|\mathcal{Y}|^n) O(∣Y∣n) 的问题,而这样的计算量在许多实际问题中是高得惊人,以至于计算机几乎不可能计算出来。
考虑到计算成本,在实际使用中,我们通常会牺牲一定的精度,采用更有效率的搜索方法。其中使用最广泛的是 贪心搜索 和 束搜索 。
贪心搜索
贪心搜索是指在输出序列的每一个时间步
t
t
t,都直接选择概率最高的词元作为该时间步的输出,即:
y
t
p
r
e
d
=
argmax
y
t
∈
Y
P
(
y
t
∣
y
1
,
⋯
,
y
t
−
1
,
X
)
y_{t}^{pred} = \text{argmax}_{y_t \in \mathcal{Y}} \ P(y_t|y_1,\cdots, y_{t-1}, X)
ytpred=argmaxyt∈Y P(yt∣y1,⋯,yt−1,X)
注意, { argmax y 1 ∈ Y P ( y 1 ) , ⋯ , argmax y n ∈ Y P ( y n ) } \{\text{argmax}_{y_1 \in \mathcal{Y}} \ P(y_1), \cdots, \text{argmax}_{y_n \in \mathcal{Y}} \ P(y_n)\} {argmaxy1∈Y P(y1),⋯,argmaxyn∈Y P(yn)} 等价于 argmax P ( y 1 , y 2 , ⋯ , y n ) \text{argmax} \ P(y_1,y_2,\cdots,y_n) argmax P(y1,y2,⋯,yn) 当且仅当 y 1 , ⋯ , y n y_1, \cdots, y_n y1,⋯,yn 相互独立。但是循环网络中,每一个时间步的输出 y t y_t yt 是依赖于前面 t − 1 t-1 t−1 个时间步的输出 y 1 , ⋯ , y t − 1 y_1, \cdots, y_{t-1} y1,⋯,yt−1 的。因此贪心搜索不能保证全局最优。
但是贪心搜索将计算量由原来的 O ( ∣ Y ∣ n ) O(|\mathcal{Y}|^n) O(∣Y∣n) 降到了 O ( ∣ Y ∣ n ) O(|\mathcal{Y}|n) O(∣Y∣n)。
束搜索
束搜索是介于穷举搜索和贪心搜索之间的方法。它有一个超参数 k,在每一个时间步,束搜索会选择所有候选序列里面概率最高的 k 个序列。
假设输出词表 Y = { A , B , C , D , E } \mathcal{Y} = \{A, B, C, D, E\} Y={A,B,C,D,E},束宽 k=2,时间步1处概率最高的为 A和C。那么在时间步2处,我们有十个候选序列:{AA, AB, AC, AD, AE} 和 {CA, CB, CC, CD, CE}。 假如其中最大的两个是 AB 和 CE,那么时间步3处依然有十个候选序列:{ABA, ABB, ABC, ABD, ABE} 和 {CEA, CEB, CEC, CED, CEE},我们依然是在其中选两个概率最大的序列 …
如果最终候选序列的长度不一致,那么在计算每个候选序列的概率时,需要乘上一个长度惩罚因子 1 ∣ L ∣ α \frac{1}{|L|^{\alpha}} ∣L∣α1( α \alpha α 一般取0.75),即 P ( L ) = 1 ∣ L ∣ α ∑ t = 1 ∣ L ∣ log P ( y t ∣ y 1 , ⋯ , y t − 1 , X ) P(L) = \frac{1}{|L|^{\alpha}} \sum_{t=1}^{|L|} \text{log} P(y_t|y_1,\cdots,y_{t-1},X) P(L)=∣L∣α1∑t=1∣L∣logP(yt∣y1,⋯,yt−1,X)
束搜索的计算量是 O ( ∣ Y ∣ n k ) O(|\mathcal{Y}|nk) O(∣Y∣nk),介于穷举搜索和贪心搜索之间。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)