使用nvidia_gpu_expoter配合prometheus+grafana监控GPU性能
项目地址: GitHub - utkuozdemir/nvidia_gpu_exporter: Nvidia GPU exporter for prometheus using nvidia-smi binary
根据git上面的nvidia监控项目,可以实现grafana监控GPU,但是git上面提供的utkuozdemir/nvidia_gpu_exporter:0.3.0这个镜像只可以在ubuntu系统上面运行,如果在centos上运行,日志会提示无法获取到GPU信息,也就导致无法接到k8s的prometheus.目前使用的方法是将nvidia_gpu_exporter这个可执行访问下载到centos系统中,然后通过系统命令运行,最终得到一个服务,也就是gpu的metircs。然后在k8s中,创建endpoinst、service、servicemonitor,实现prometheus收集到gpu-metrics信息,最后通过grafana进行可视化展示。下面是具体操作步骤:
1 在centos系统中有创建nvidia_gpu_exporter服务
安装nvidia_gpu_exporter服务
# VERSION=0.3.0
# wget https://github.com/utkuozdemir/nvidia_gpu_exporter/releases/download/v${VERSION}/nvidia_gpu_exporter_${VERSION}_linux_x86_64.tar.gz
# tar -xvzf nvidia_gpu_exporter_${VERSION}_linux_x86_64.tar.gz
# mv nvidia_gpu_exporter /usr/local/bin
# ./nvidia_gpu_exporter
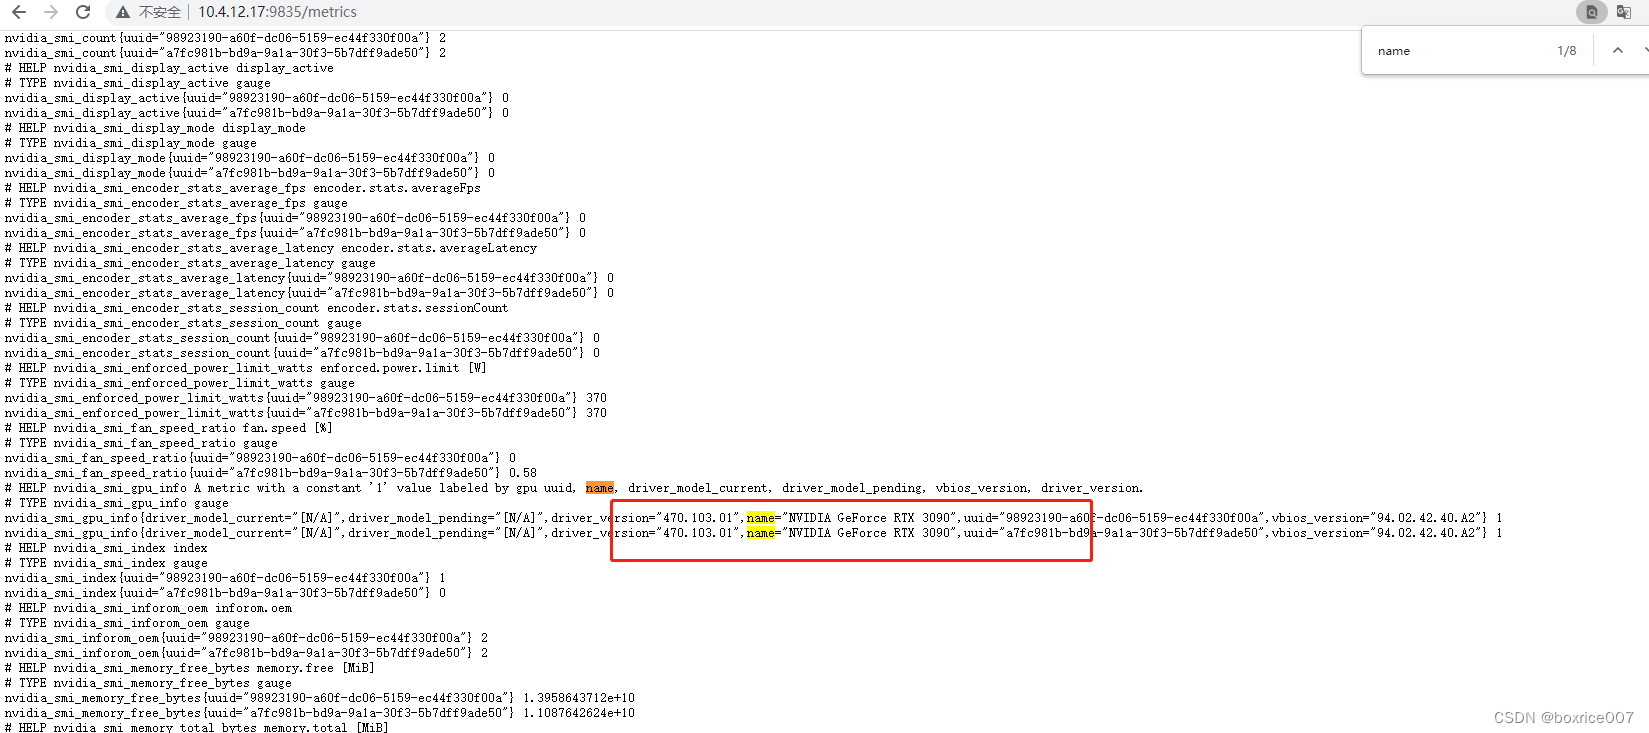
此时通过web页面就可查看此台GPU服务器的gpu-metircs信息,如下图

可以看到GPU相关信息
创建nvidia_gpu_exporter服务
# vim /etc/systemd/system/nvidia_gpu_exporter.service
[Unit]
Description=Nvidia GPU Exporter
After=network-online.target
[Service]
Type=simple
User=nvidia_gpu_exporter
Group=nvidia_gpu_exporter
ExecStart=/usr/local/bin/nvidia_gpu_exporter
SyslogIdentifier=nvidia_gpu_exporter
Restart=always
RestartSec=1
NoNewPrivileges=yes
ProtectHome=yes
ProtectSystem=strict
ProtectControlGroups=true
ProtectKernelModules=true
ProtectKernelTunables=yes
ProtectHostname=yes
ProtectKernelLogs=yes
ProtectProc=yes
[Install]
WantedBy=multi-user.target
# systemctl daemon-reload
[root@k8s-gpu4 ~]# systemctl enable nvidia_gpu_exporter
[root@k8s-gpu4 ~]# systemctl start nvidia_gpu_exporter.service
[root@k8s-gpu4 ~]# systemctl status nvidia_gpu_exporter.service
● nvidia_gpu_exporter.service - Nvidia GPU Exporter
Loaded: loaded (/etc/systemd/system/nvidia_gpu_exporter.service; enabled; vendor preset: disabled)
Active: active (running) since Fri 2022-05-13 17:36:03 CST; 5s ago
Main PID: 80178 (nvidia_gpu_expo)
Tasks: 6
Memory: 5.6M
CGroup: /system.slice/nvidia_gpu_exporter.service
└─80178 /usr/local/bin/nvidia_gpu_exporter
May 13 17:36:03 k8s-gpu4 systemd[1]: Started Nvidia GPU Exporter.
May 13 17:36:04 k8s-gpu4 nvidia_gpu_exporter[80178]: ts=2022-05-13T09:36:04.005Z caller=main.go:68 level=info msg="Listening on add...=:9835
May 13 17:36:04 k8s-gpu4 nvidia_gpu_exporter[80178]: ts=2022-05-13T09:36:04.006Z caller=tls_config.go:195 level=info msg="TLS is di...=false
Hint: Some lines were ellipsized, use -l to show in full.
-----------------------------------
©著作权归作者所有:来自51CTO博客作者boxrice的原创作品,请联系作者获取转载授权,否则将追究法律责任
使用nvidia_gpu_expoter配合prometheus+grafana监控GPU性能
https://blog.51cto.com/u_11229048/5291377服务启动成功,通过页面查看
2 在k8s中创建endpoints、service、servicemonitor
创建endpoints
# cat gpu-exporter-endpoint.yaml
apiVersion: v1
kind: Endpoints
metadata:
 name: nvidia-gpu-exporter
 namespace: monitoring
subsets:
 - addresses:
 - ip: 10.1.12.17
 ports:
 - name: http
 port: 9835
 protocol: TCP
上面的ip为GPU服务器地址,如果是多台GPU,可在下面继续添加,如
- ip: *.*.*.*
- ip: *.*.*.*
# kubectl create -f gpu-exporter-endpoint.yaml
endpoints/nvidia-gpu-exporter created
# kubectl get endpoints -n monitoring nvidia-gpu-exporter
NAME ENDPOINTS AGE
nvidia-gpu-exporter 10.1.12.17:9835 39s
# kubectl describe endpoints -n monitoring nvidia-gpu-exporter
Name: nvidia-gpu-exporter
Namespace: monitoring
Labels: <none>
Annotations: <none>
Subsets:
Addresses: 10.1.12.17
NotReadyAddresses: <none>
Ports:
Name Port Protocol
---- ---- --------
http 9835 TCP
Events: <none>
创建service
# cat gpu-exporter-svc.yaml
apiVersion: v1
kind: Service
metadata:
labels:
app: nvidia-gpu-exporter
name: nvidia-gpu-exporter
namespace: monitoring
spec:
ports:
- name: http
protocol: TCP
port: 9835
targetPort: http
type: ClusterIP
# kubectl delete -f gpu-exporter-svc.yaml
service "nvidia-gpu-exporter" deleted
kubectl create -f gpu-exporter-svc.yaml
service/nvidia-gpu-exporter created
# kubectl get svc -n monitoring nvidia-gpu-exporter
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
nvidia-gpu-exporter ClusterIP 10.10.75.226 <none> 9835/TCP 12s
# kubectl describe svc -n monitoring nvidia-gpu-exporter
Name: nvidia-gpu-exporter
Namespace: monitoring
Labels: app=nvidia-gpu-exporter
Annotations: <none>
Selector: <none>
Type: ClusterIP
IP: 10.10.235.70
Port: http 9835/TCP
TargetPort: http/TCP
Endpoints: 10.1.12.17:9835
Session Affinity: None
Events: <none>
上面的endpioins一定要为上面创建的endpoints中的IP和port
创建servicemonitor
#cat gpu-exporter-serviceMonitor.yaml
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
 labels:
 app: nvidia-gpu-exporter
 name: nvidia-gpu-exporter
 namespace: monitoring
spec:
 endpoints:
 - interval: 30s
 port: http
 jobLabel: app
 selector:
 matchLabels:
 app: nvidia-gpu-exporter
kubectl create -f gpu-exporter-serviceMonitor.yaml
servicemonitor.monitoring.coreos.com/nvidia-gpu-exporter created
[root@k8s-master dongtai]# kubectl get servicemonitors.monitoring.coreos.com -n monitoring nvidia-gpu-exporter
NAME AGE
nvidia-gpu-exporter 12s
# kubectl describe servicemonitors.monitoring.coreos.com -n monitoring nvidia-gpu-exporter
Name: nvidia-gpu-exporter
Namespace: monitoring
Labels: app=nvidia-gpu-exporter
Annotations: <none>
API Version: monitoring.coreos.com/v1
Kind: ServiceMonitor
Metadata:
 Creation Timestamp: 2022-05-13T09:50:35Z
 Generation: 1
 Managed Fields:
 API Version: monitoring.coreos.com/v1
 Fields Type: FieldsV1
 fieldsV1:
 f:metadata:
 f:labels:
 .:
 f:app:
 f:spec:
 .:
 f:endpoints:
 f:jobLabel:
 f:selector:
 .:
 f:matchLabels:
 .:
 f:app:
 Manager: kubectl-create
 Operation: Update
 Time: 2022-05-13T09:50:35Z
 Resource Version: 14080381
 Self Link: /apis/monitoring.coreos.com/v1/namespaces/monitoring/servicemonitors/nvidia-gpu-exporter
 UID: 7fdb365b-8bcd-4fc2-9772-9ad7de6155bf
Spec:
 Endpoints:
 Interval: 30s
 Port: http
 Job Label: app
 Selector:
 Match Labels:
 App: nvidia-gpu-exporter
Events: <none>
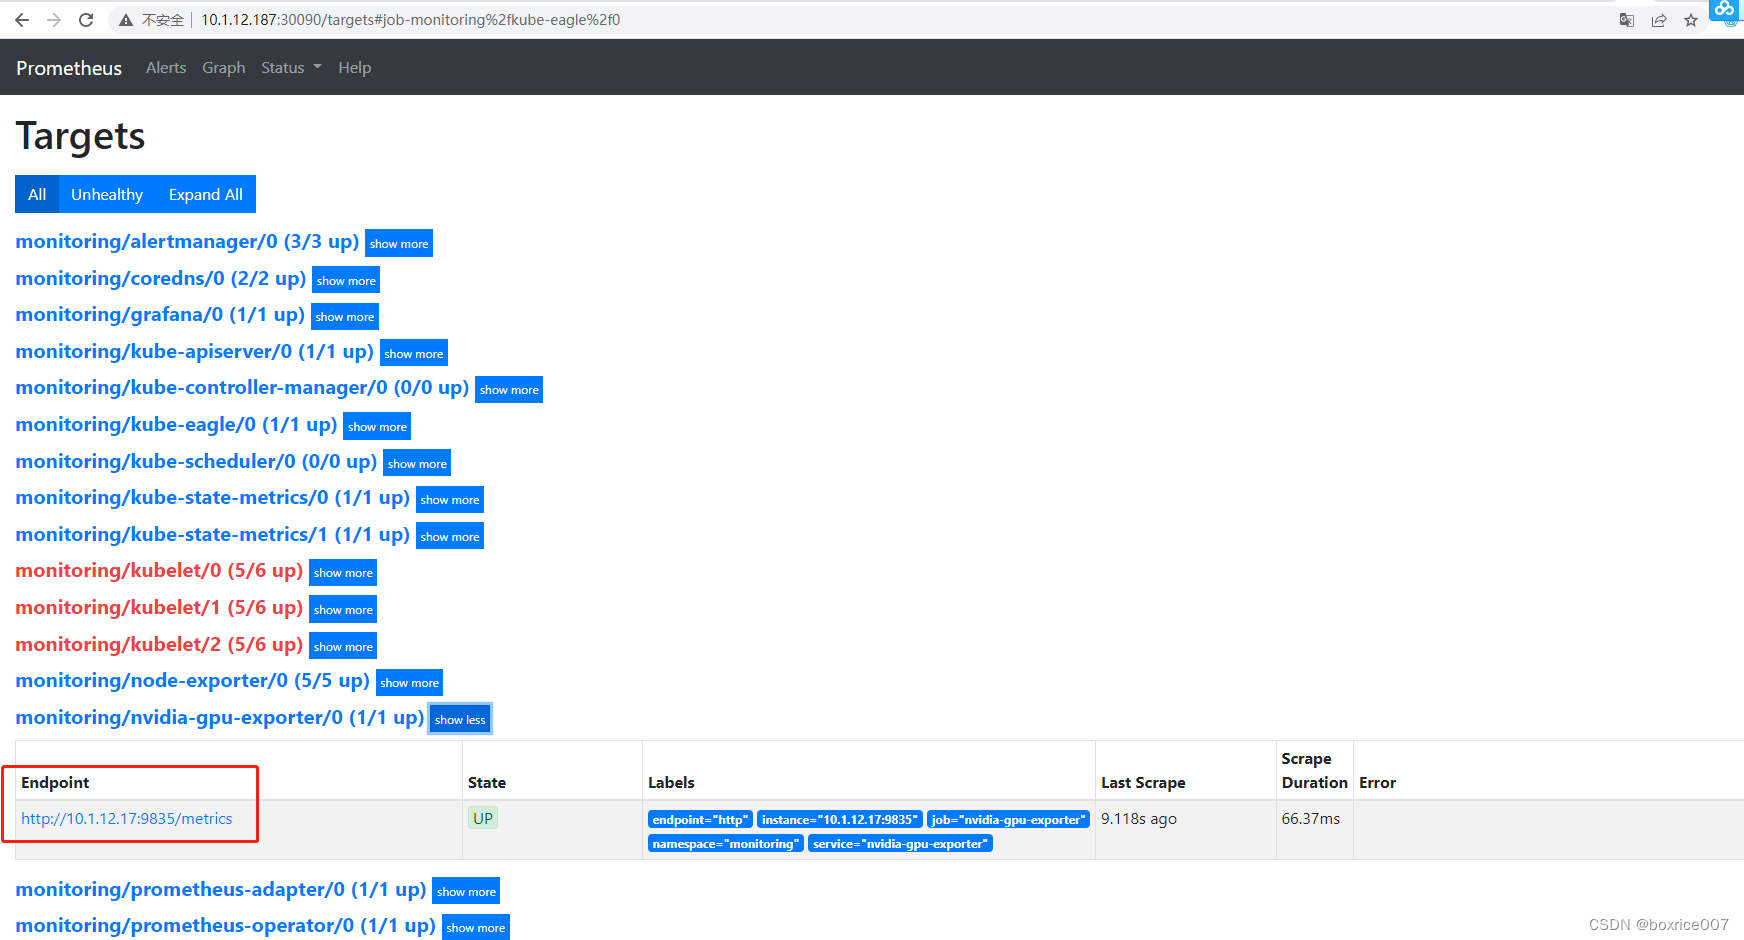
prometheus页面验证
在prometheus页面的targets中查看nvidia_gpu_exporter
在Graph页面中进行nvidia搜索
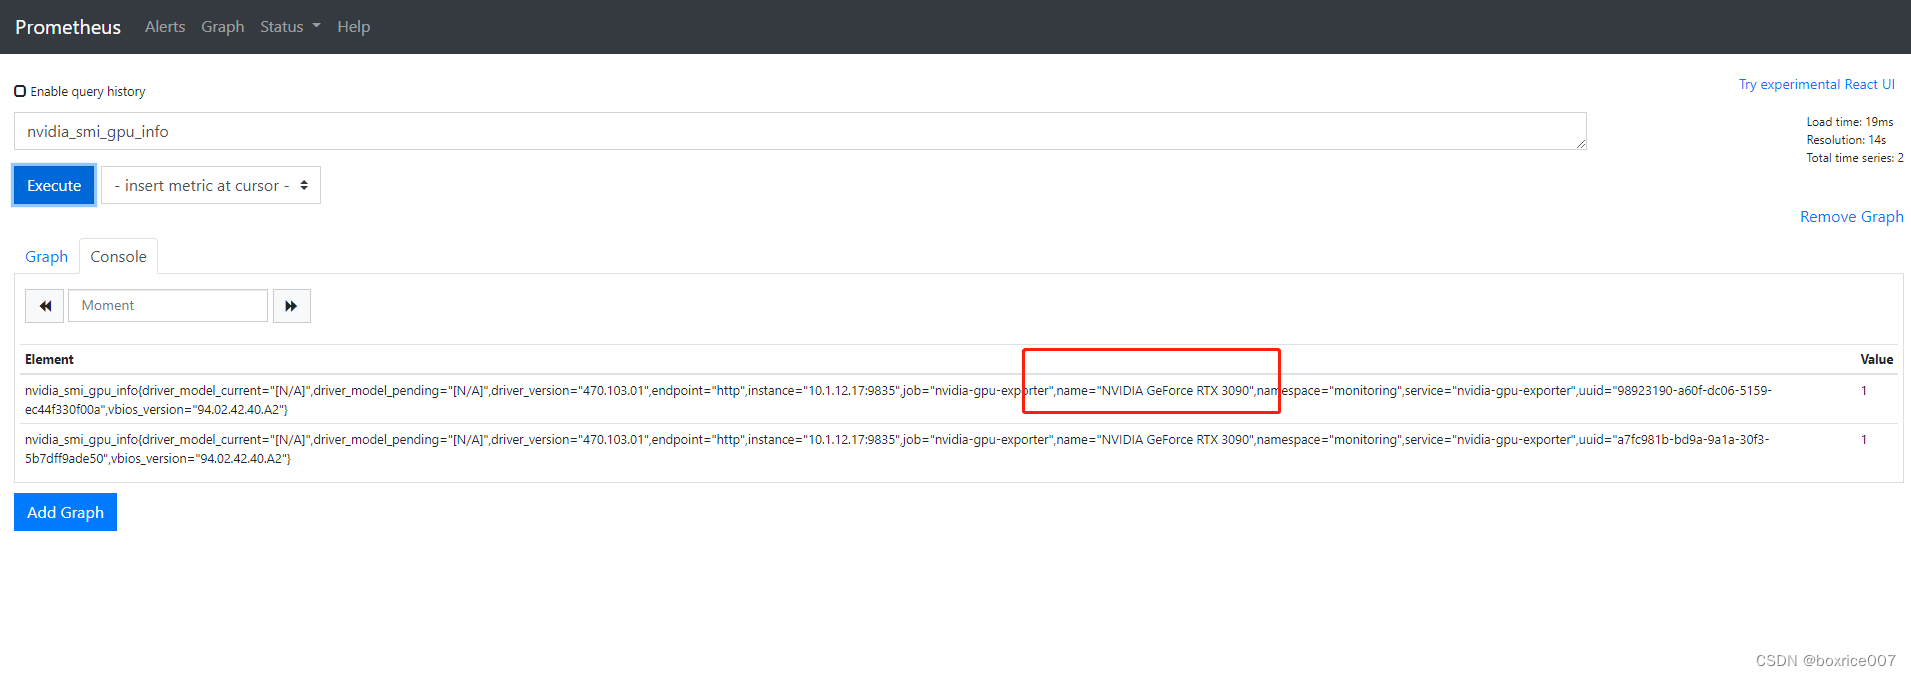
通过搜索可以得到这台GPU服务器有两张3090GPU
3 在grafana中创建GPU监控面板
在grafana导入本人提供的json文件
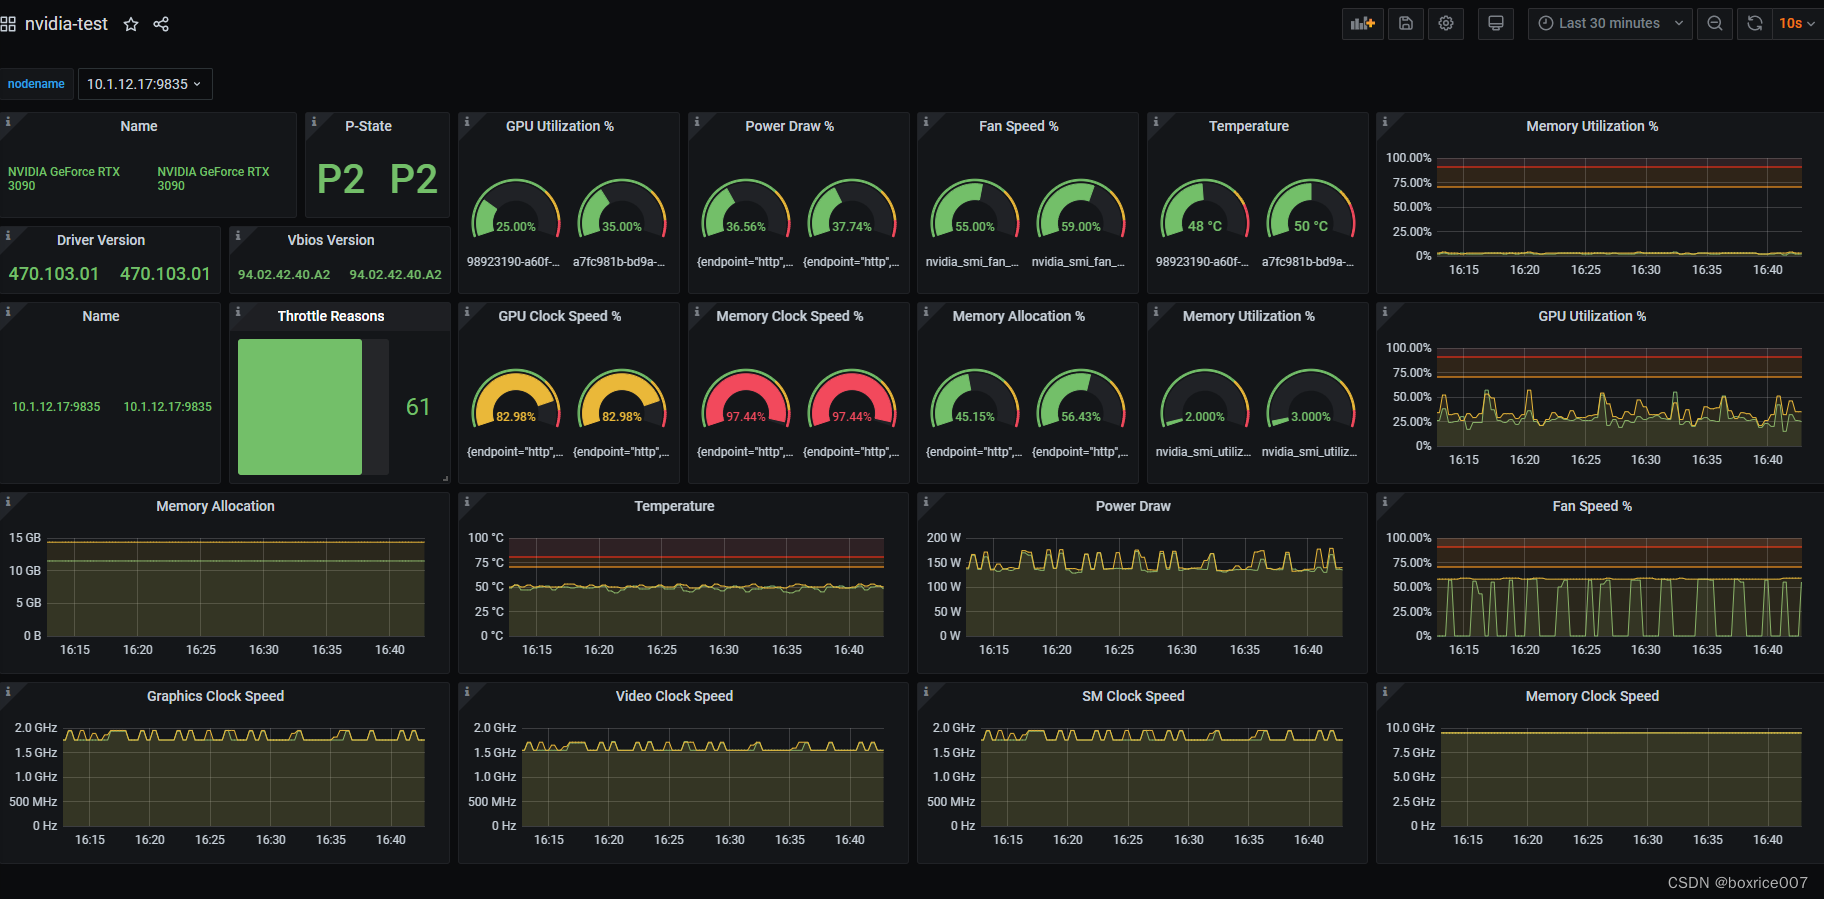
最终展示效果如下,好需要json文件,可评论获取

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)