神经网络概述
引言
机器学习
机器学习通俗点来说就是研究计算机怎样模拟或实现人类的学习行为,以获取新的知识或技能,重新组织已有的知识结构使之不断改善自身的性能。机器学习是人工智能技术的核心。
机器学习的流程:
· 数据获取
· 特征工程
· 建立模型
· 评估与应用
其中最重要的步骤就是特征工程。也就是特征的提取。可以说数据特征决定了模型的上限,预处理和特征提取是最核心的部分,算法于参数决定了如何逼近这个上限。
那么如何提取特征?
首先,传统特征的提取复杂,且准确率不高,这也就是为什么我们需要深度学习的原因。深度学习,它相当于一个黑盒子,它是真正学习什么样的特征是最合适的,解决了如何提取特征的问题。
深度学习
深度学习是真正学习什么样的特征是最合适的,解决了如何提取特征的问题。
深度学习应用领域
深度学习目前主要应用于计算机视觉,自然语言处理当中。也就是图像和语言。其中在计算机视觉领域中,深度学习主要应用于图像处理,如:图像分类,计算机要提取出图像的主要特征,并给出该图像隶属于什么类别。
深度学习是基于神经网络算法的。科学家们从生物神经网络的运作机制得到启发,构建了人工神经网络。
深度学习,机器学习和神经网络之间的关系
以计算机视觉分类任务来说,传统分类算法存在一些问题,如K近邻算法:
K近领算法的流程
1、计算已知类别数据集中的点与当前点的距离
2、按照距离以此排序
3、选取与当前点距离最小的K个点
4、确定前K个点所在类别的出现概率
5、返回前K个点出现频率最高的类别作为当前点预测分类
k近邻算法,通俗来说,就是看这个点离已知的所有点,那个近,那么这个点就预测属于那一类点
但是k近邻并不适合用于图像分类算法,因为其算法并没有关注到我们想要的主体。这导致背景主导成为了一个最大的问题,从而对图像分类任务造成影响
神经网络基础
线性函数
从输入–>输出的映射
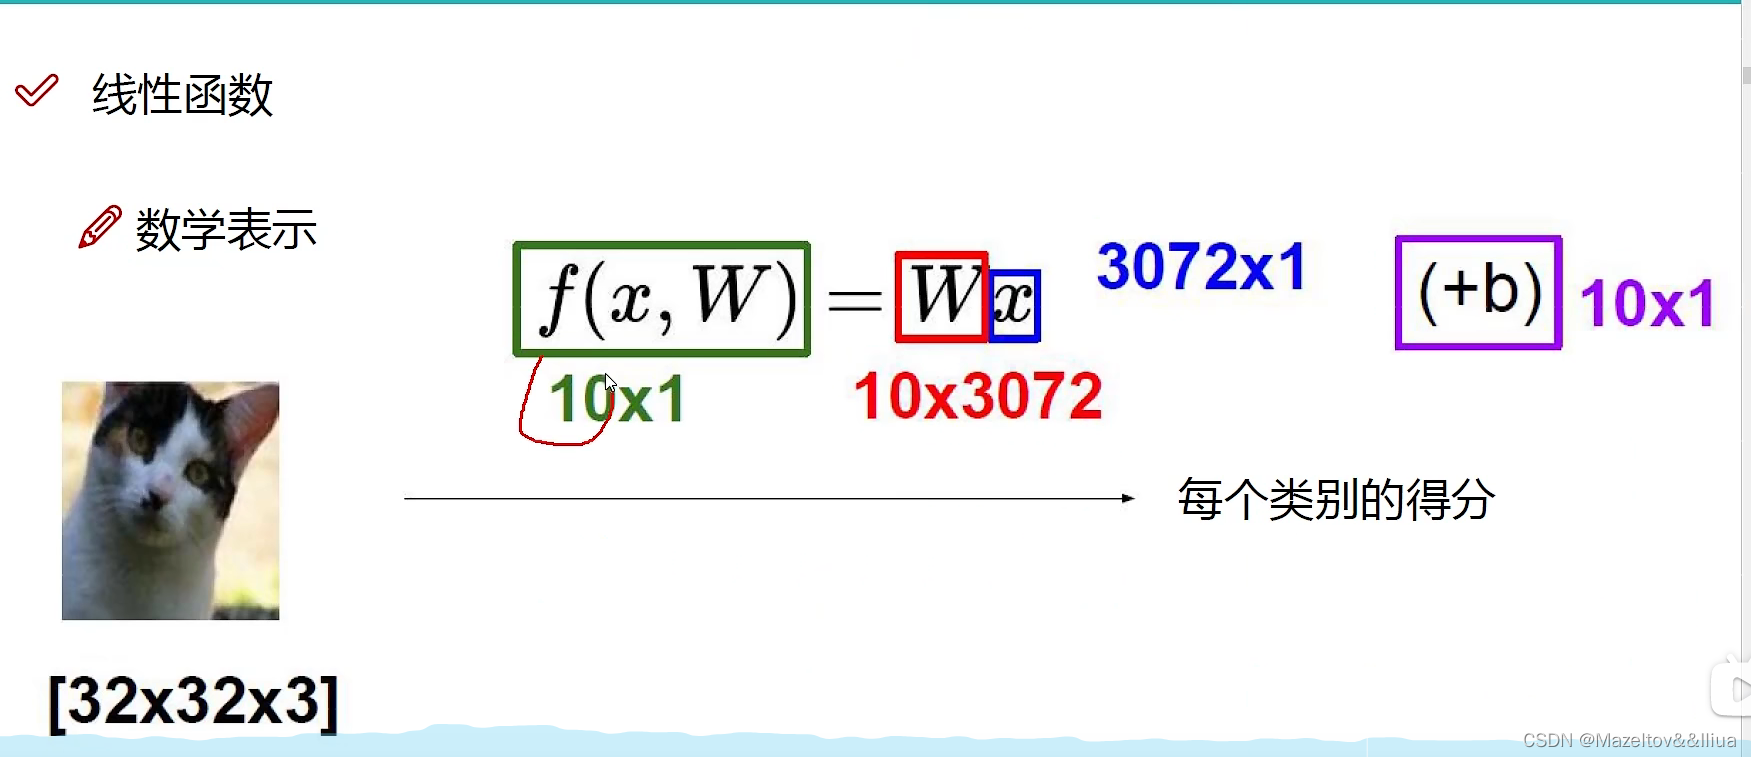
对于一个32x32x3的图像来说(这里的三是指颜色通道),通过一个函数f(x,W)最后可以得到每个类别的得分。
这里x可以认为是一个像素点所构成的矩阵(32x32x3=3072)该矩阵为3072x1。这里的W是权重参数,即对于每一个像素点,其权重是不一样的,代表其对结果的影响因素也是不一样的。那么对于3072个像素点来说就有3072个权重参数,即形成1x3072的矩阵。权重与像素点所形成的矩阵相乘,代表这个类别的可能得分。
那么现在假如有10个类别,就会有10个1x3072的权重参数,即构成了一个10 x 3072的矩阵,
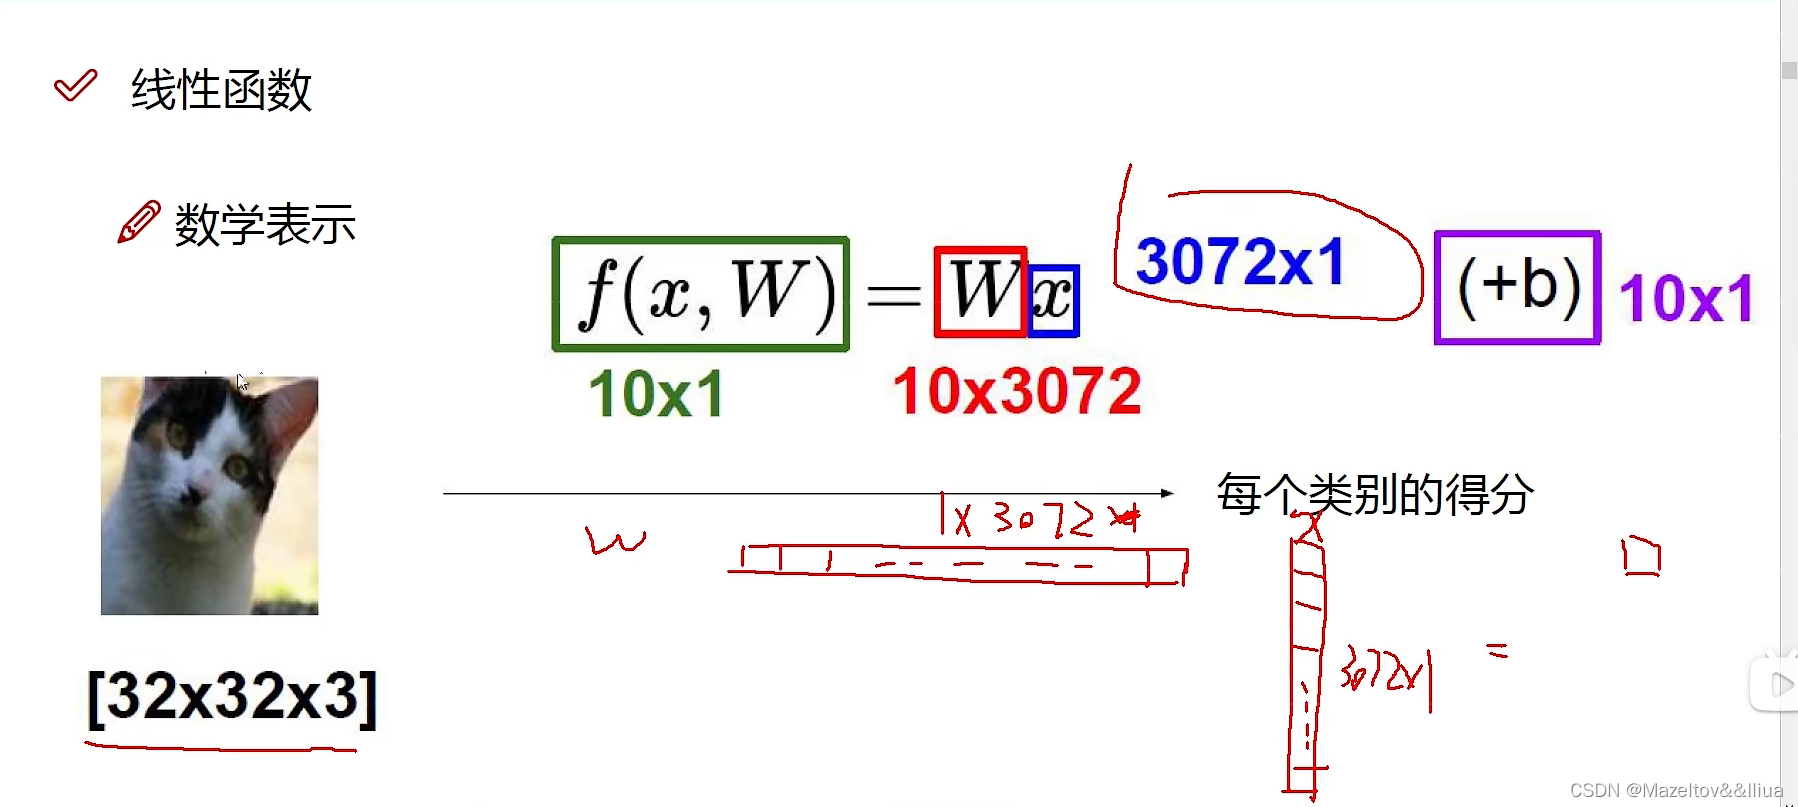
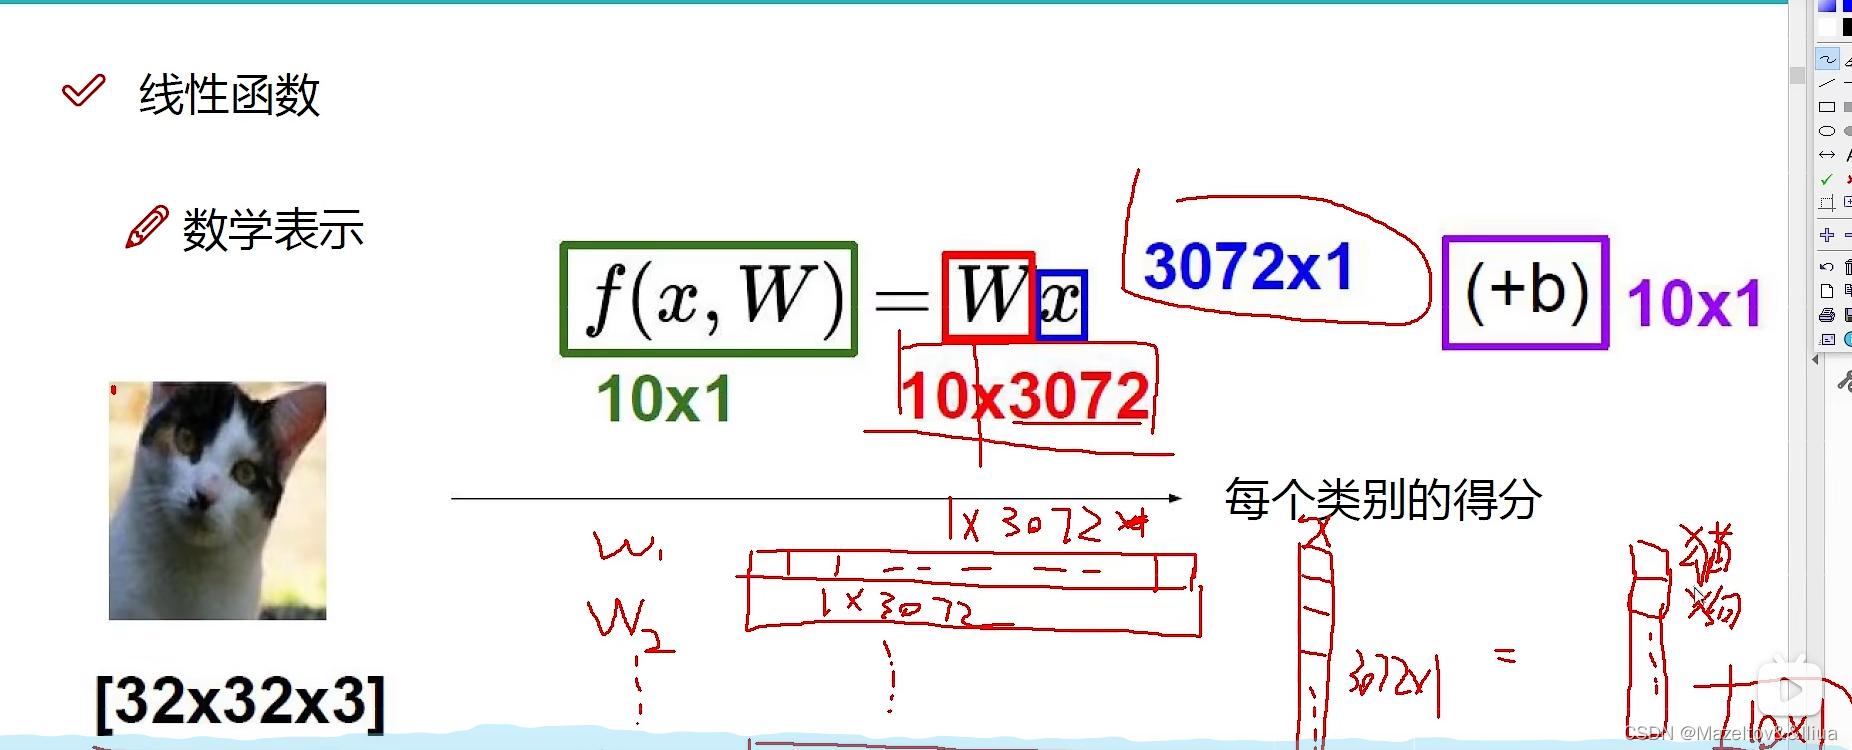
这个10x3072的权重矩阵与像素点所构成的矩阵x相乘得到一个10x1的矩阵,在这个矩阵中,每个元素代表每个类别的得分,最后该线性函数再加上一个偏置参数b,b也是一个10x1的矩阵,代表对最终结果的每个类别的得分进行微调,从而通过该线性函数得到最终每个类别的得分。
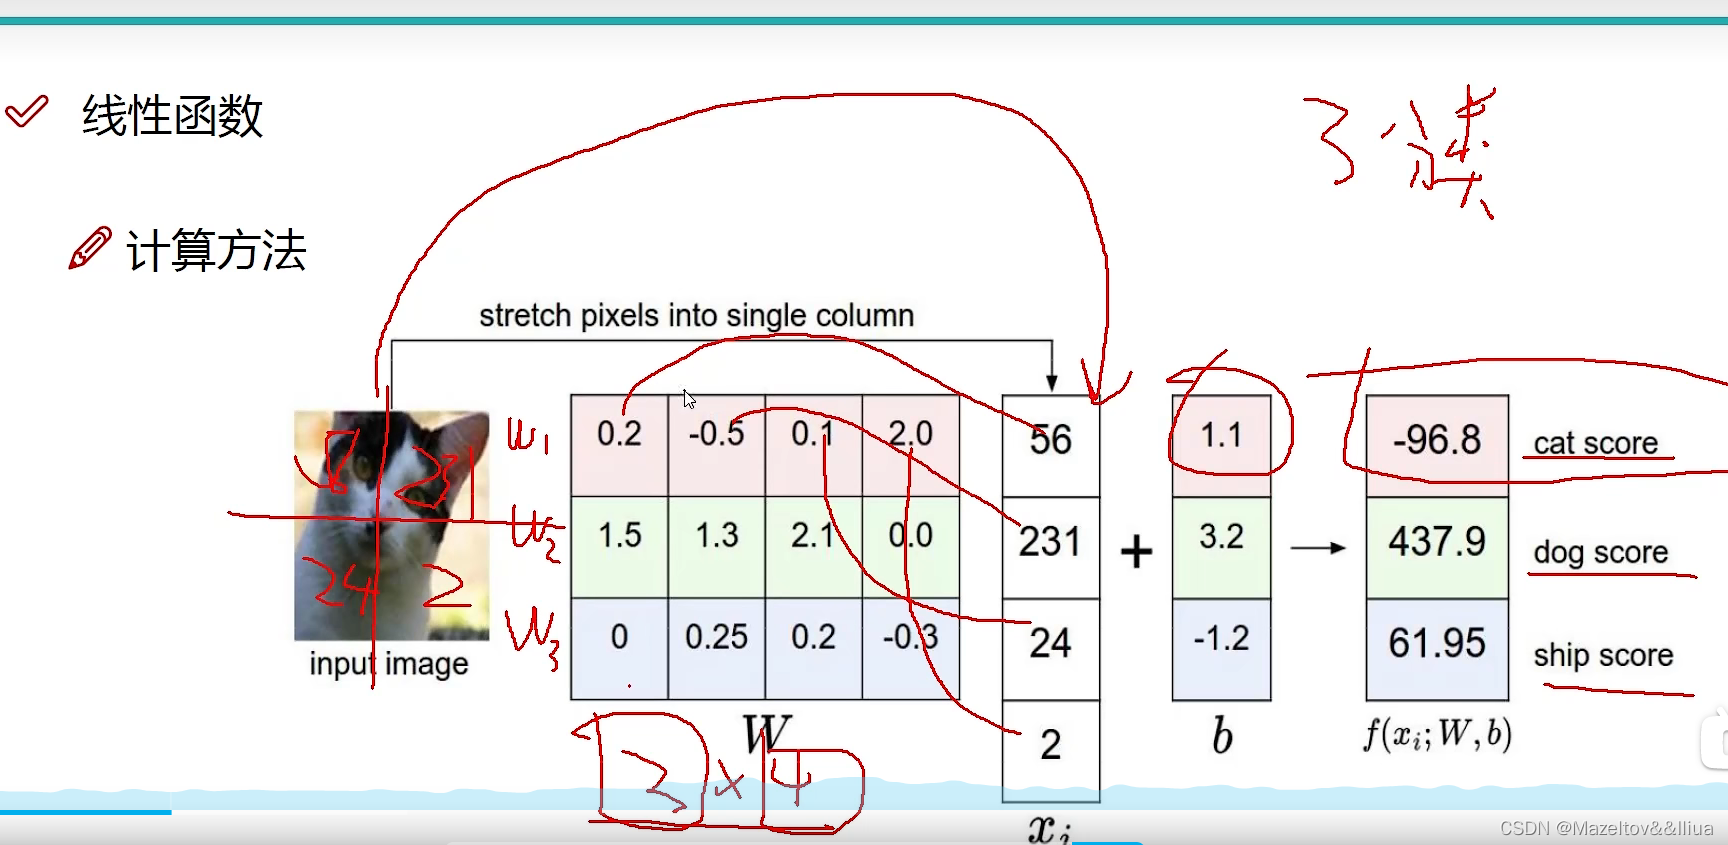
比如上述图像,将图像分为四个部分,进行一个三分类的计算,其中W为权重参数矩阵,数值越大,代表该部分的影响因素越高,数值为负,代表该因素起抑制作用1,通过线性函数最终计算出每个分类得到的数值。
损失函数
损失函数的作用:为了衡量分类的结果。
每个分类得到的数值,有着明显的差异,我们需要明确的知道模型的当前效果,有多好或是多差。
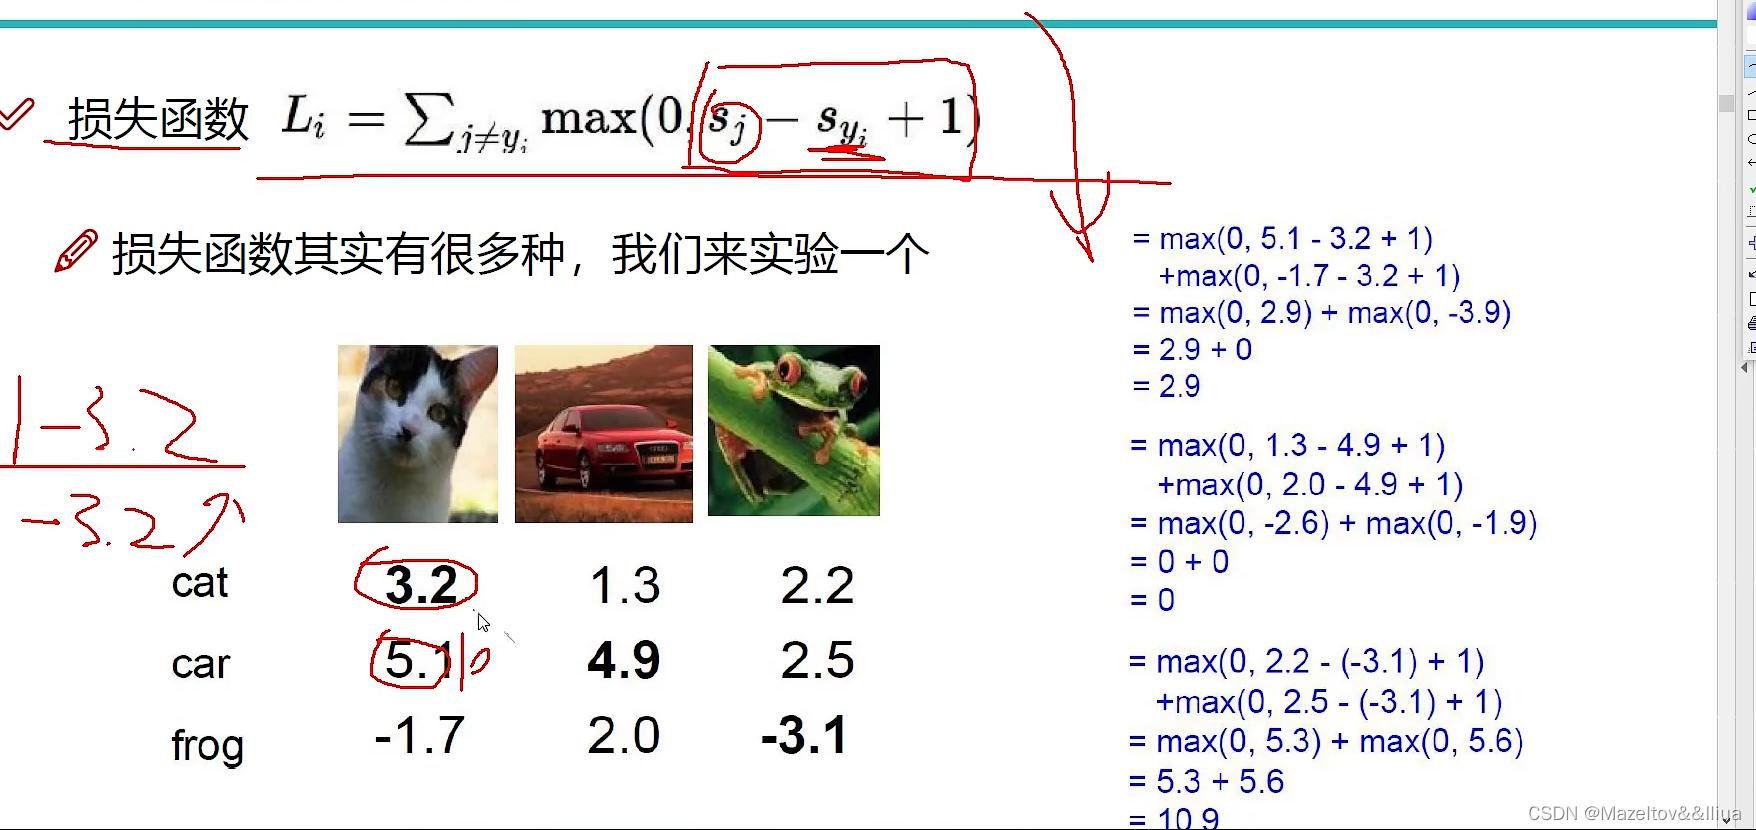
如上述这组图的损失函数的计算,用每个类别的得分-实际类别的得分+1,与0比较取最大值。用每个类别的得分-实际类别的得分目的在于判断该类别的得分与实际类别的差值,如果某个类别的得分比实际类别的得分大,那么说明,预测的结果应该是有问题的。因此这个差值越小越好。理论上,预测正确的话,该差值应该是负值
那么为什么要加1,这个可以认为是一个容忍度,假设某个数据的得分与实际得分相差不大,仅仅是低了一点点,那么该数据-实际数据得分的值也是负值,与0取最大,则还是0,但是,这种预测结果并不好,因为它们之间的数据仅仅差了一点点的距离,可能在本次任务中预测正确,但是,在下次任务重预测可能就是错误,而+1的作用就体现了出来。也就是说正确类别起码要比错误类别的差值高1以上,我们才可以认为是没有损失的。
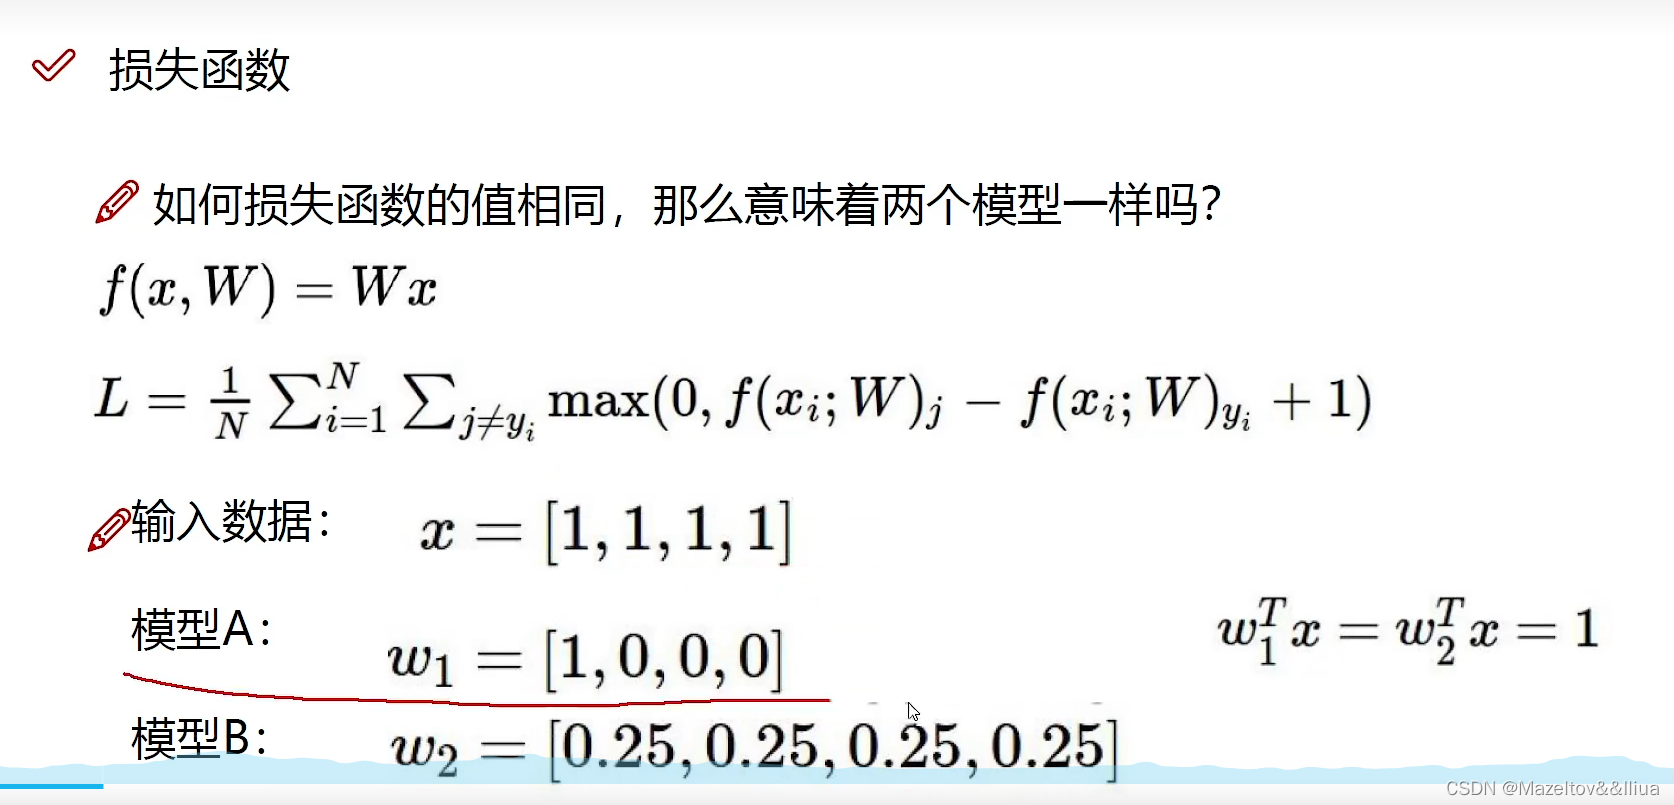
如果损失函数的值相同,那么意味着两个模型一样吗?显然不是的,对于上述例子来说,对于模型A来说,其只考虑了第一个权重参数,而对于模型B来说,其考虑了所有的权重参数,趋于稳定。而对于模型A来说,其会产生过拟合。因此在计算损失函数时,需要考虑额外的因素
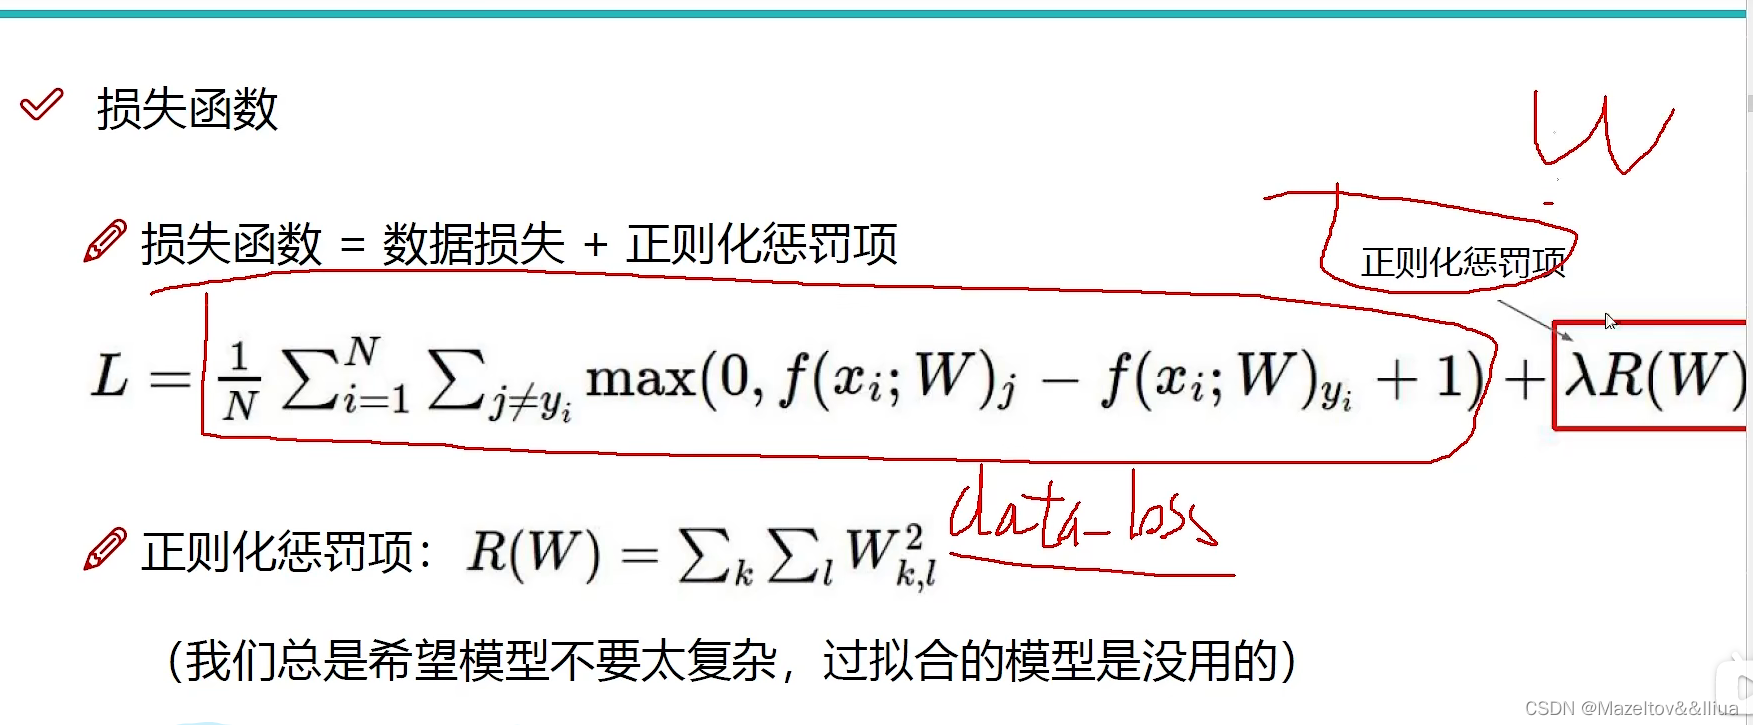
如上图所示,损失函数在原始的数据造成的损失上加上了一个由权重参数所造成的损失,其中权重参数R(W)前面的系数代表了惩罚力度,当其系数越大,表示越不以往过拟合的产生。
什么是过拟合?
过拟合是指为了得到一致假设而使假设变得过度严格。避免过拟合是分类器设计中的一个核心任务。通常采用增大数据量和测试样本集的方法对分类器性能进行评价
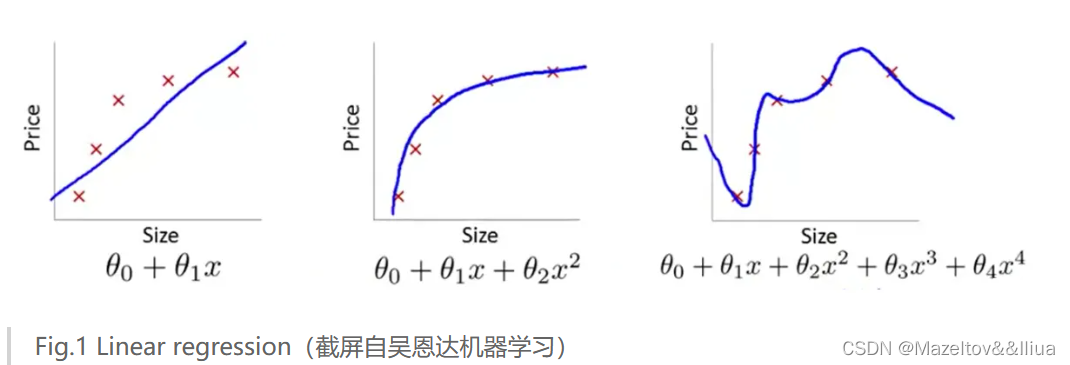
如上图所示,第一种是欠拟合,与原始存在偏差,也称为高偏差,第二种就刚刚好,而第三种就是过拟合。
前向传播
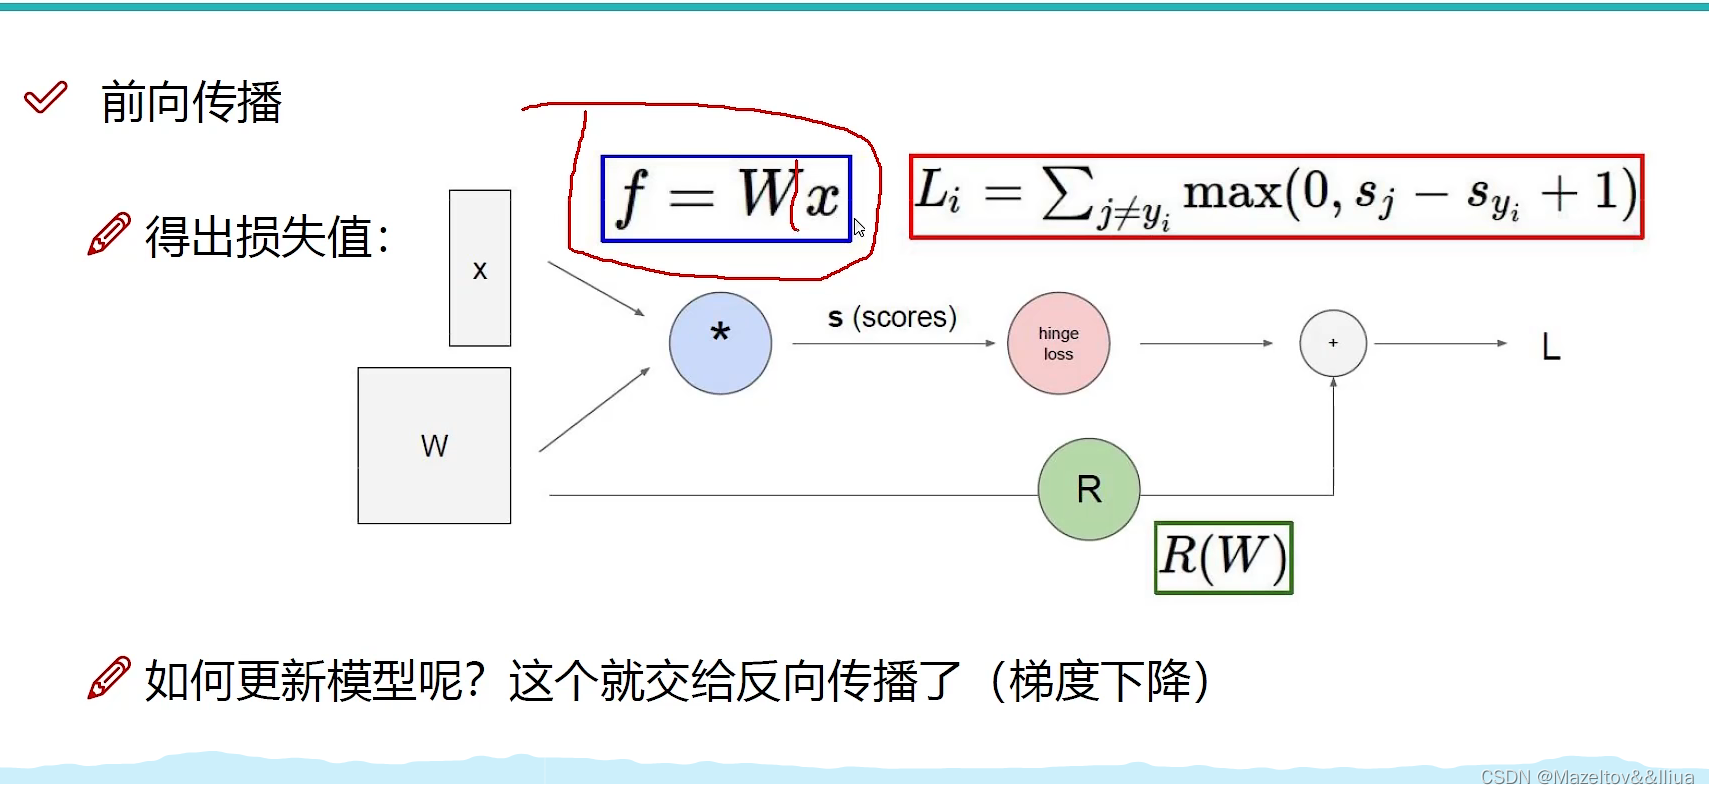
通过输入的数据和权重参数,再通过线性函数进行计算,我们可以得到一个得分值,再通过得分值结合和权重参数R(W)结合损失函数可以得到损失值,这就是前向传播的过程。
softmax分类器
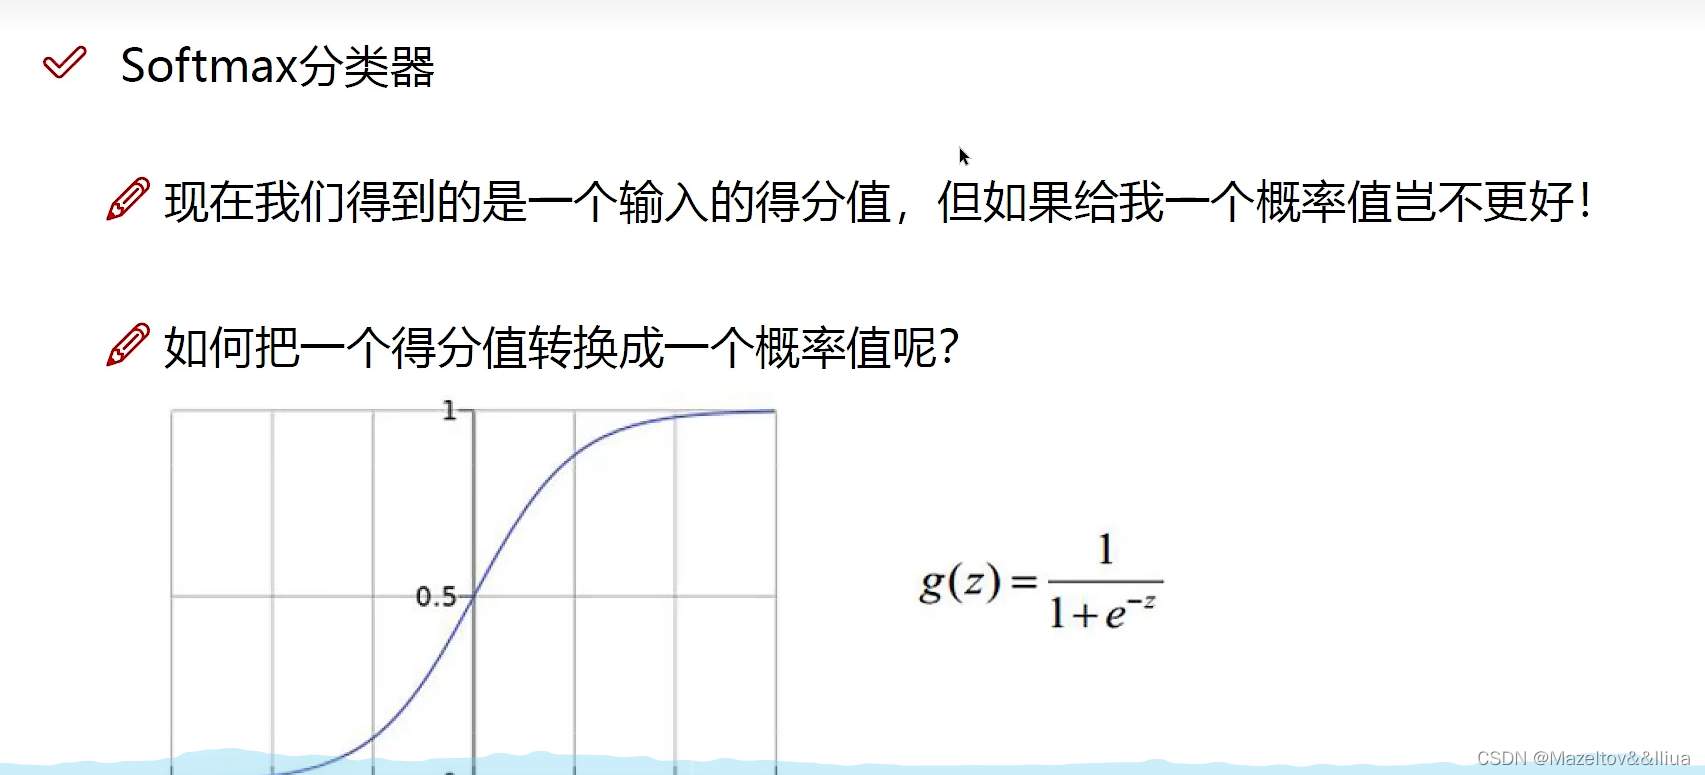
对于每一个得分值,我们可以通过softmax函数转化为对应的概率值。
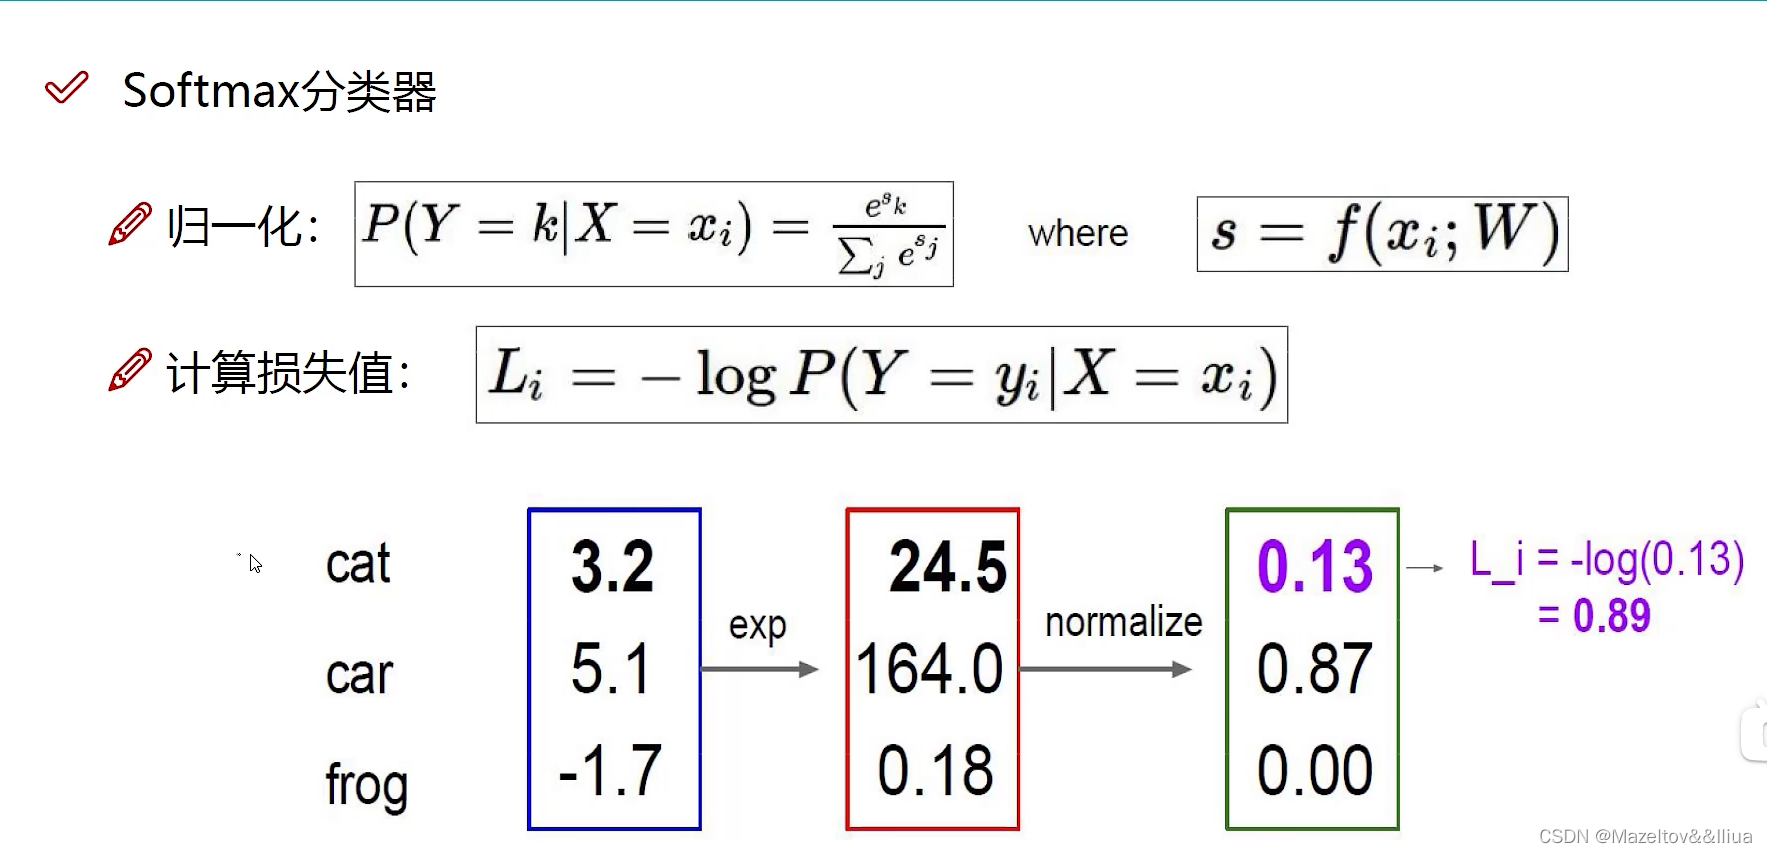
softmax如何将得分值转化概率值?
(1)首先对于类别得分矩阵来说,每个参数之间的差别是比较小的,为了增大这个之间的差别,那么我们将其数值进行e的x幂映射,也就是图中的exp过程,
(2)再进行normalize的过程,就是计算概率的过程,也就是将每个类别的数值除于其他所有类别的数值之和,也就是这个类别的概率。每个类别以此以这种方式计算,即可得到每个类别的概率值。
softmax如何计算损失函数
softmax计算损失函数时,主要利用实际类别的概率。通过log函数进行计算。因为概率处于0到1之间,因此映射的结果为小于等于0的数,因此,要在原先的基础上加负号。设想,假设实际类别对应的概率越大,那么通过log函数映射的值也就越接近于0,相应的损失函数所对应的值也越小。
反向传播
反向传播也就是使用梯度下降法,不断更改线性函数的W和b值,从而最小化损失函数的过程。
要理解,在实际的神经网络的学习过程中,权重参数组W不仅仅只有一组,往往会有多组W参数,每一组表示对数据进行不同的更改。因此在利用梯度下降法进行最小化损失函数的时候,往往需要对多组损失函数进行计算。
梯度下降法的讲解
神经网络的结构
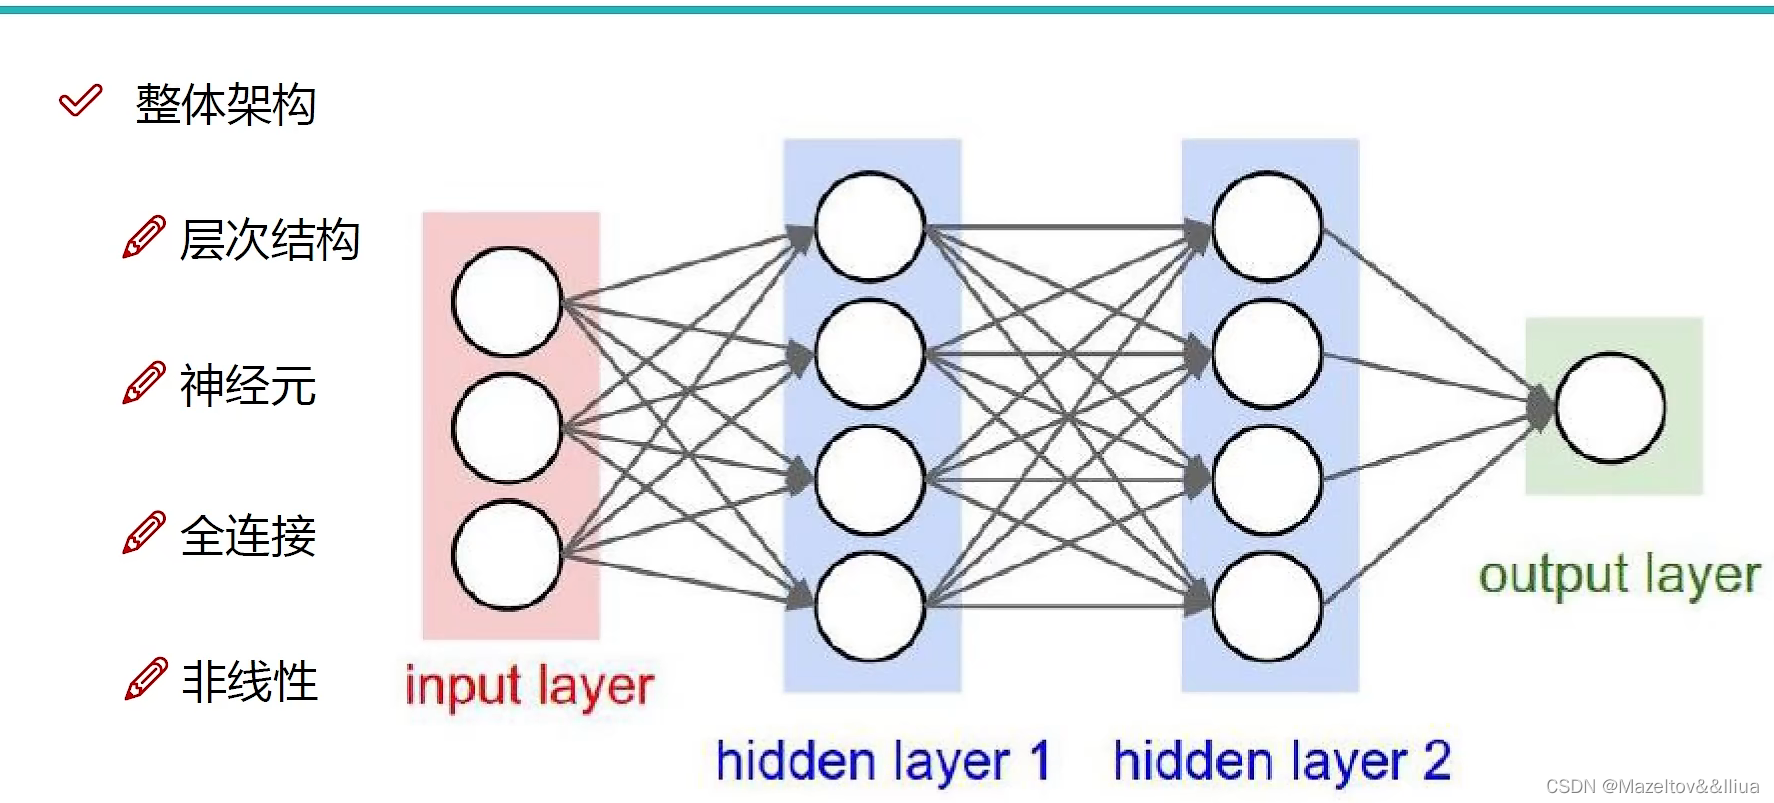
(1)首先,神经网络是具有层次结构的,也就是说起隐藏层并不仅仅只有一层,有多层,每一层对数据进行不同的变化。 这个如何变化是通过权重参数矩阵W来进行的。
(2)其次神经元在输入层可以理解为输入的矩阵维数,如前面的图像识别任务中,输入的就是像素点3071所形成的矩阵,通过一个W参数矩阵,映射成为隐藏层1的矩阵。
(3)全连接即每个神经元与其他神经元之间全部相连,这个过程也是通过W进行的;
(4)从输入层到隐层1中有个权重参数,从隐层1到隐层2中也有一个权重参数矩阵,从隐层2到输出层也有权重参数矩阵,这几个权重参数之间是不同的。那么能不能直接用这几个权重参数矩阵相乘得到最终的权重矩阵,直接与输入层进行计算呢?这个是不行的,因为在进行变换后的每个矩阵后会进行非线性变换,如之间的sigmoid函数,或者max函数都可以进行线性变换,将矩阵值进行调整后再进行于权重矩阵计算。
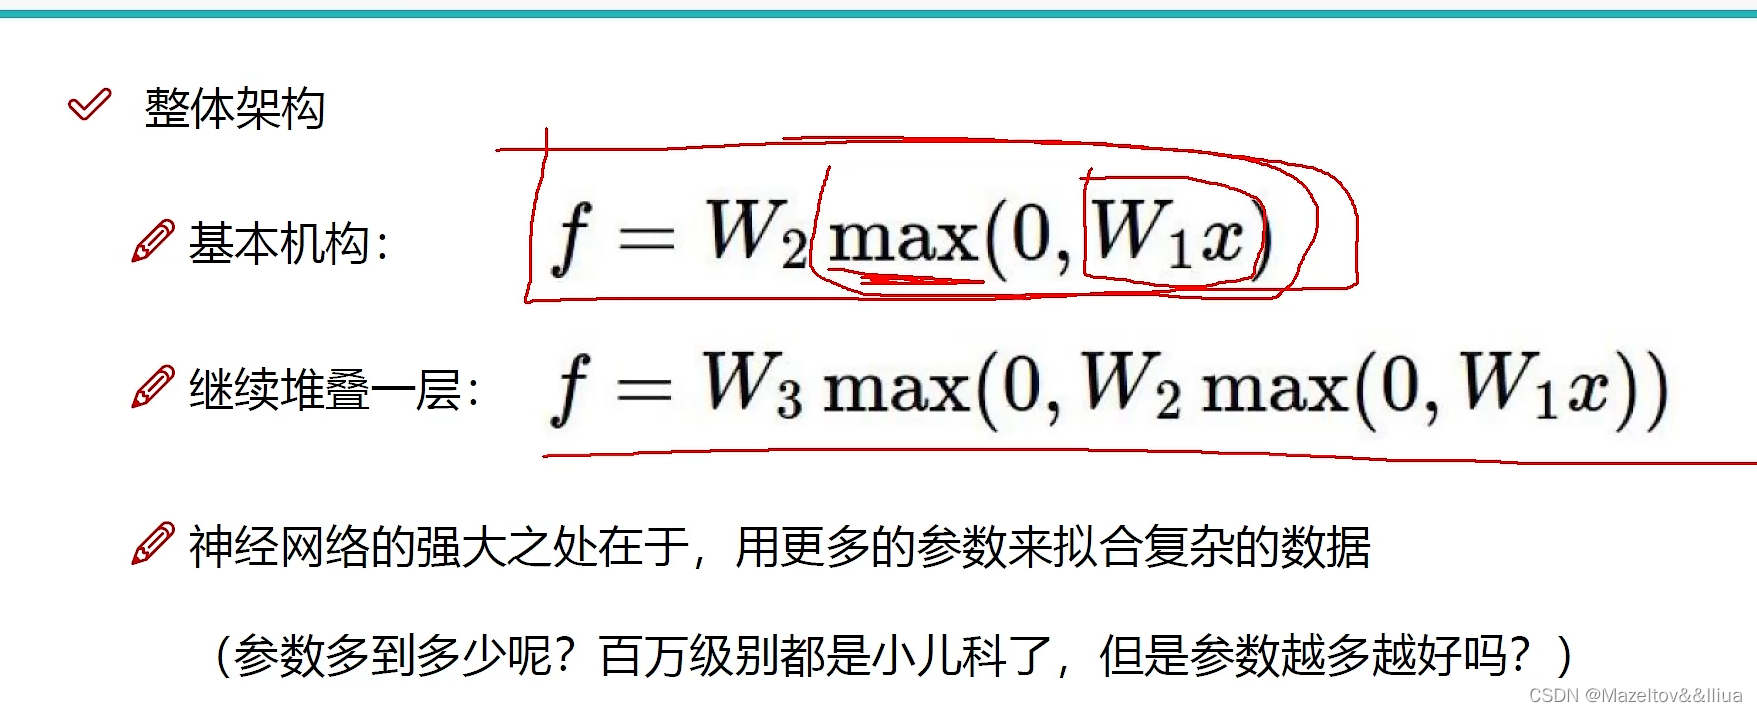
这里隐层神经元的数量可以理解为从输入的几位
正则化与激活函数
正则化的作用:防止神经网络过拟合,通过设定正则化的惩罚力度,可以使相应的损失函数进行变化,从而防止神经网络的过拟合。
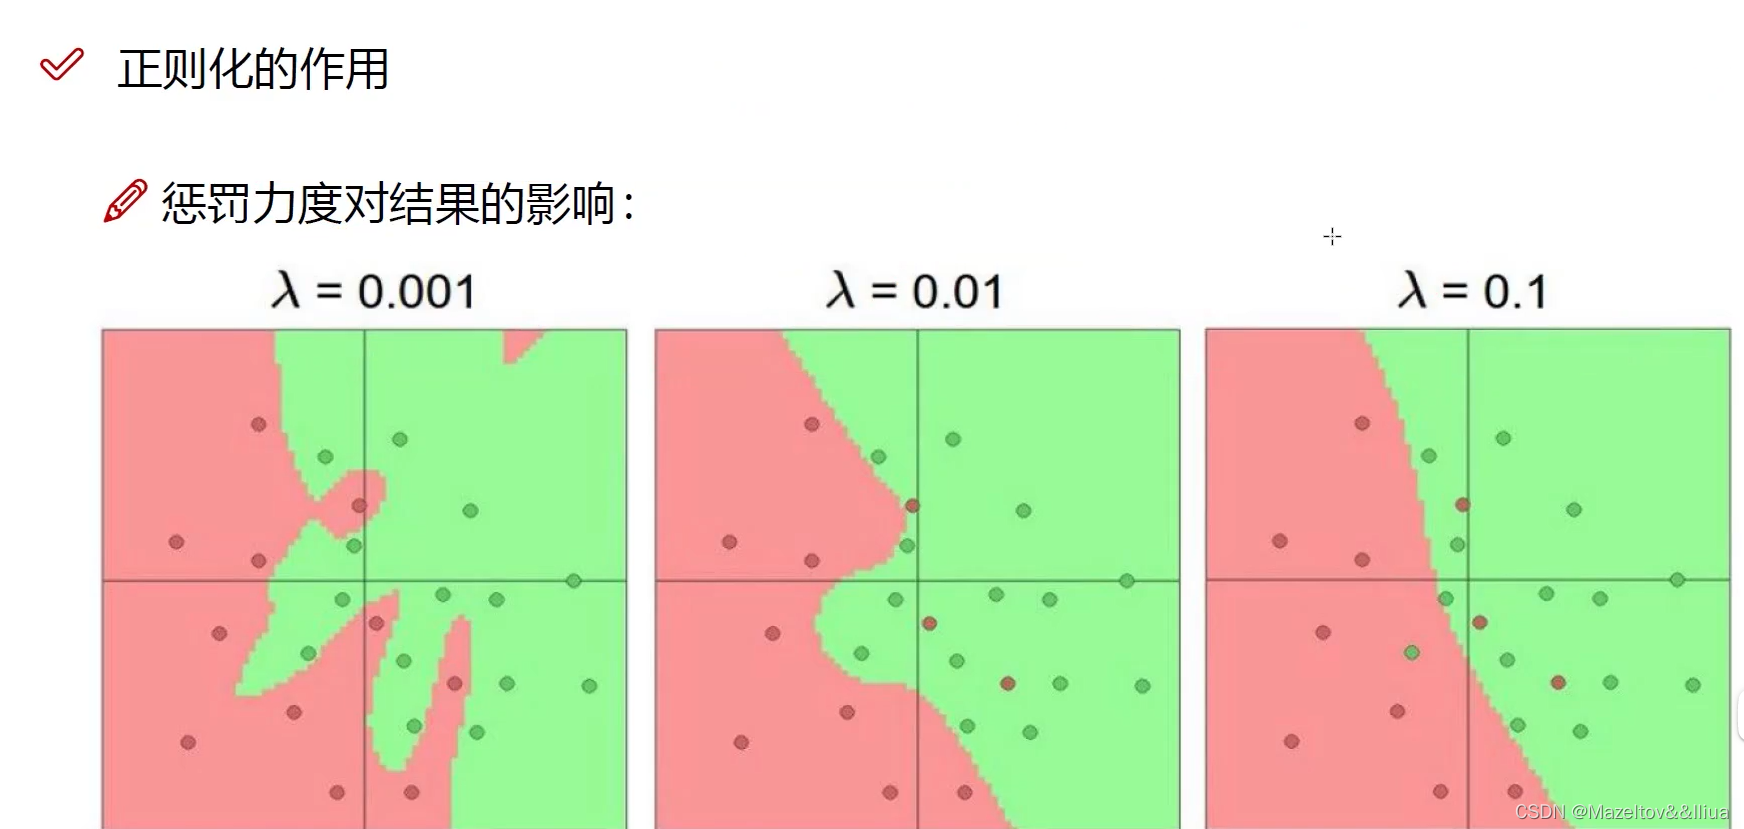
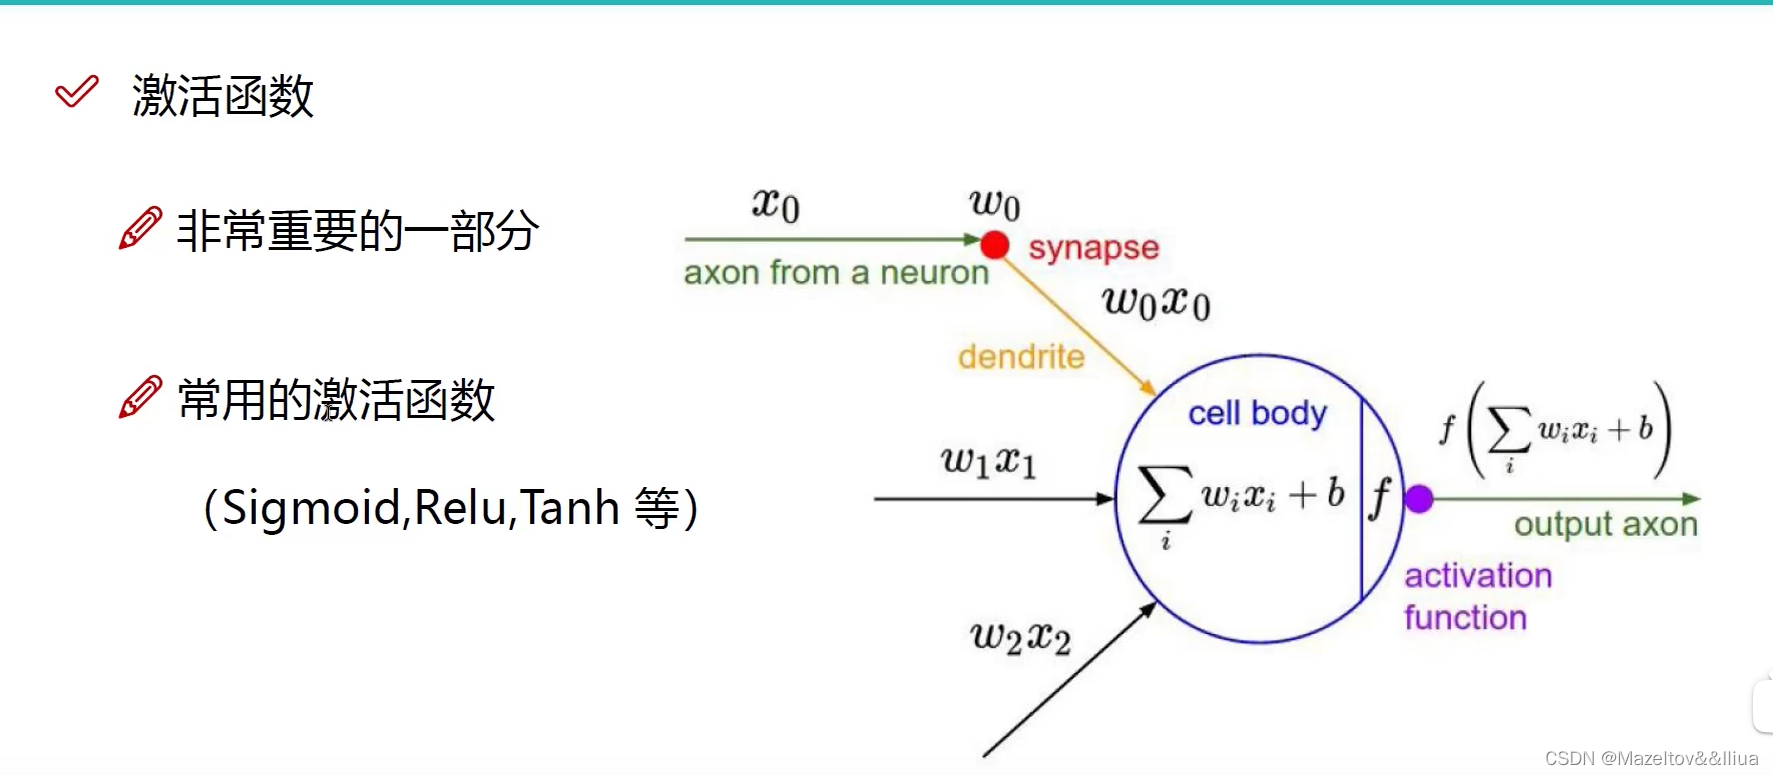
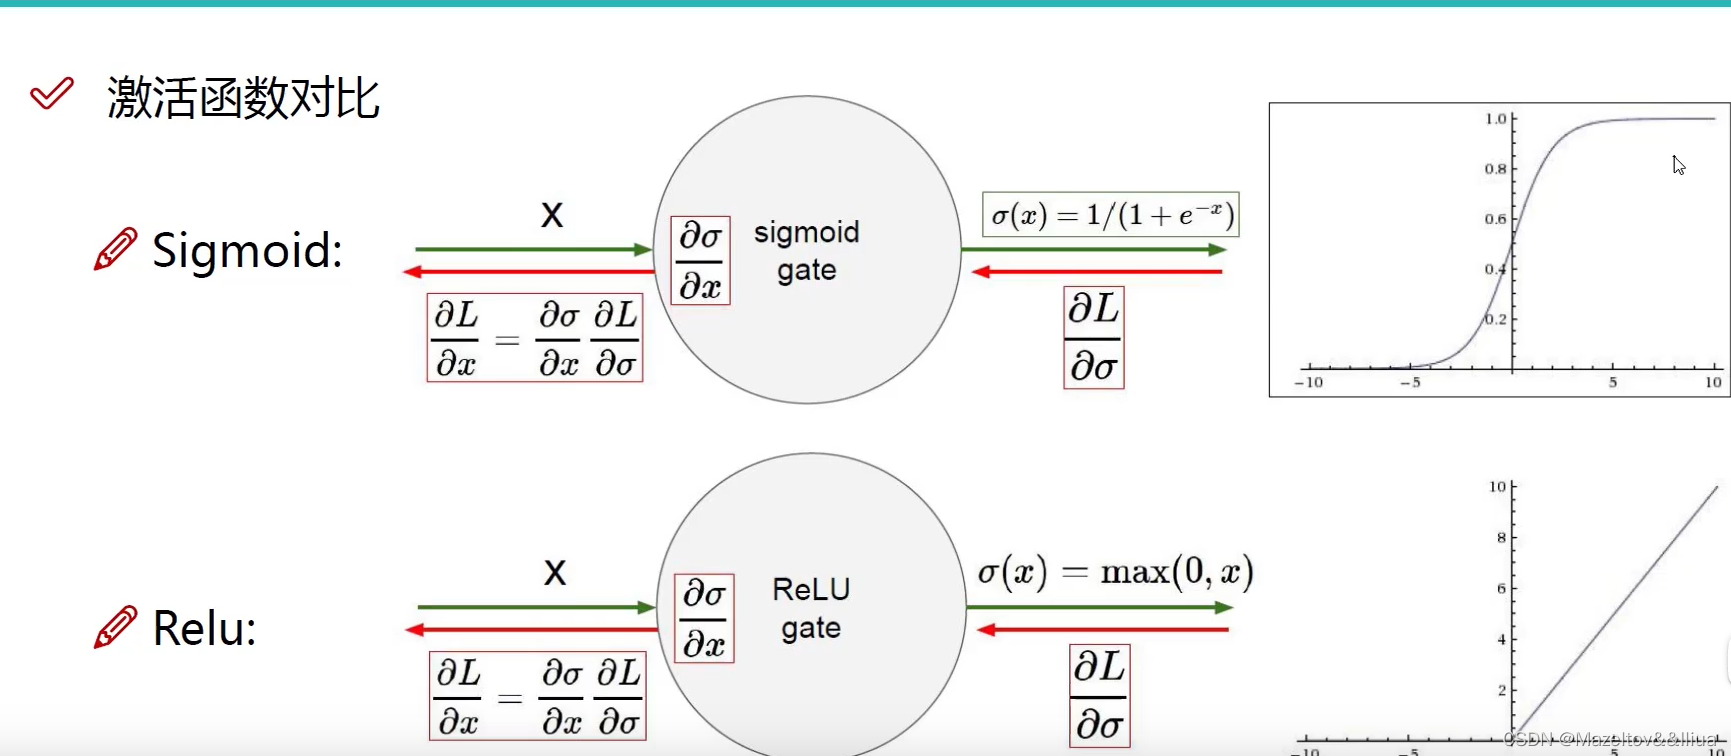
激活函数:可以理解为进行非线性变化的函数。在传统神经网络中,常用的激活函数是sigmoid函数。但这种函数有个问题,就是会产生梯度消失的问题,这时会导致反向传播不能进行更新。因此目前常用的激活函数是Relu函数。
数据预处理
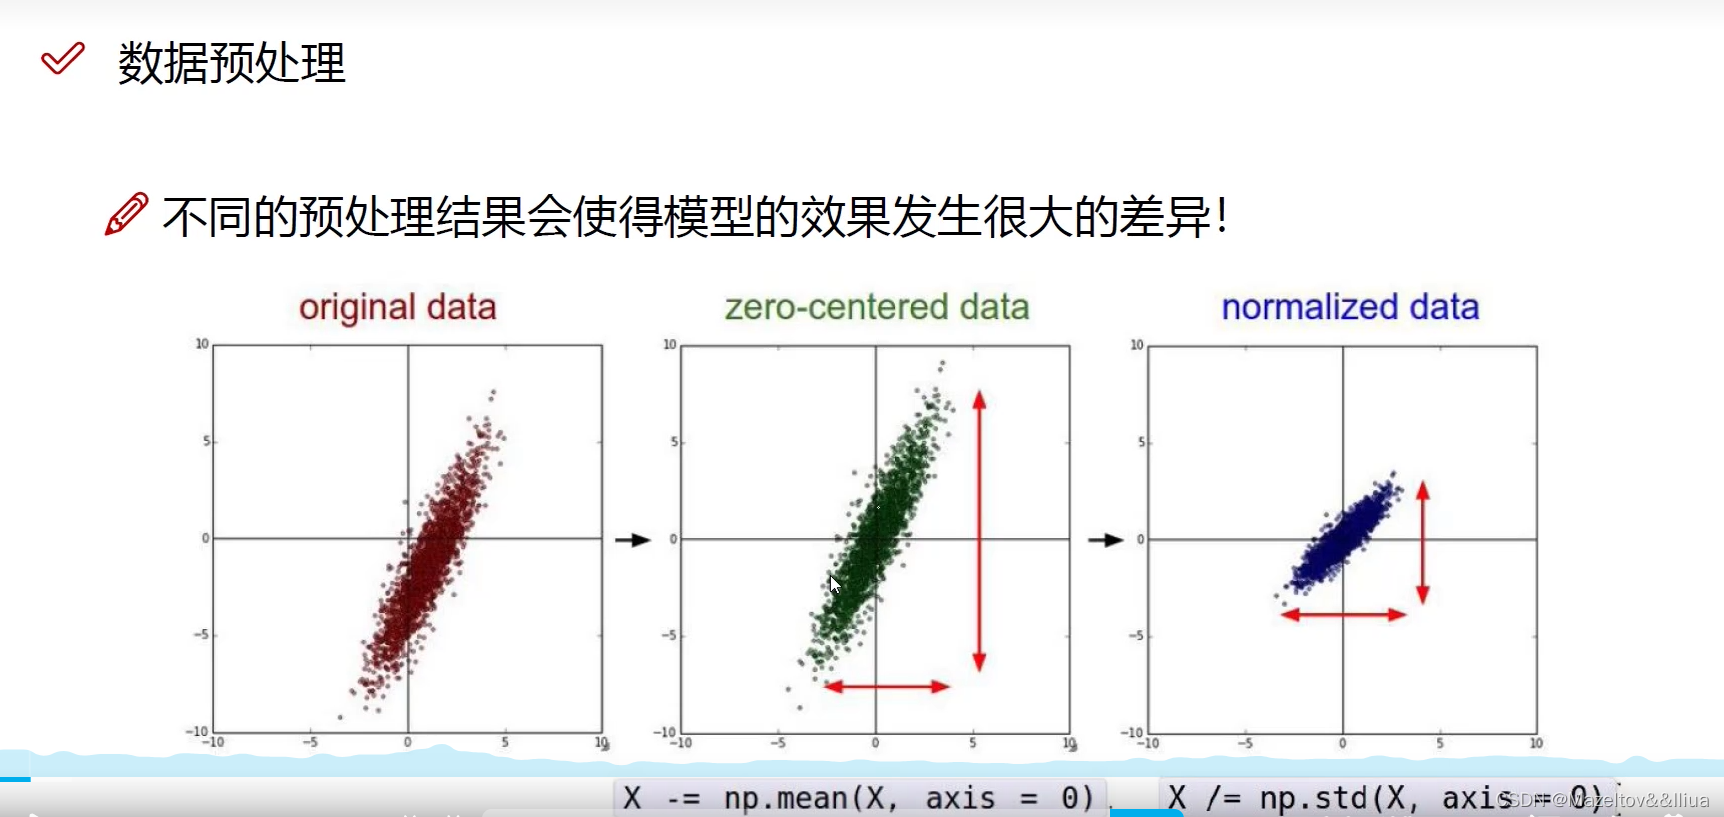
对神经网络中的输入数据,并不是原始数据,而是经过中心化和标准化之后的数据
参数初始化
那么权重矩阵如何而来,一般我们都通过使用随机策略来进行参数初始化,再通过神经网络的反向传播不断的更新权重矩阵参数和偏置矩阵b,从而找到最合适的W和b,这也是神经网络训练的目的。
过拟合的解决方法:
我们可以通过前面的正则化来减少过拟合,也可以通过drop-out解决过拟合。
drop-out可以通俗理解为在某次反向传播过程中,会使某些神经元的值保持不变。而在下一次反向传播中,可以使另外的某些神经元保持不变。这种方式在训练过程中,可以防止由于网络模型太过复杂,从而选择随机的杀死某些神经元,从而防止过拟合的产生。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)