动手学深度学习v2 ------ 笔记4
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
前言
提示:本文要记录的大概内容:
动手学深度学习v2 ------ 沐神
提示:以下是本篇文章正文内容
一、现代卷积神经网络
1.深度卷积神经网络(AlexNet)
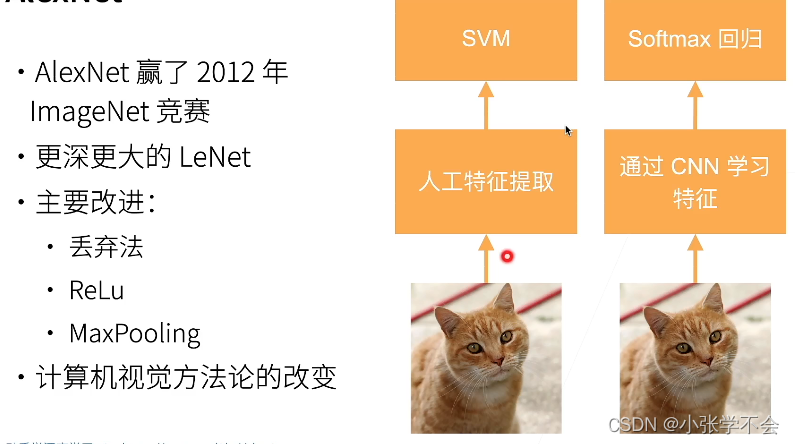
1.架构
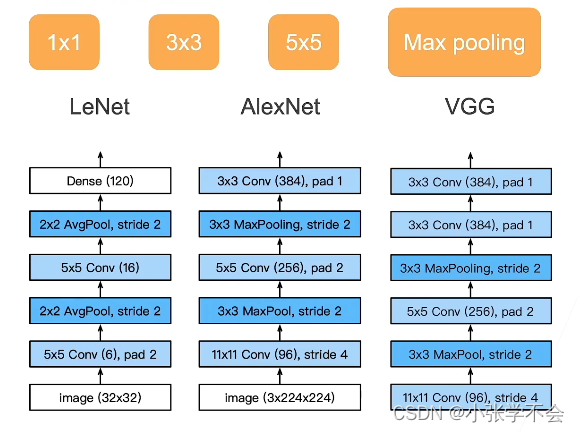
AlexNet和LeNet的架构非常相似
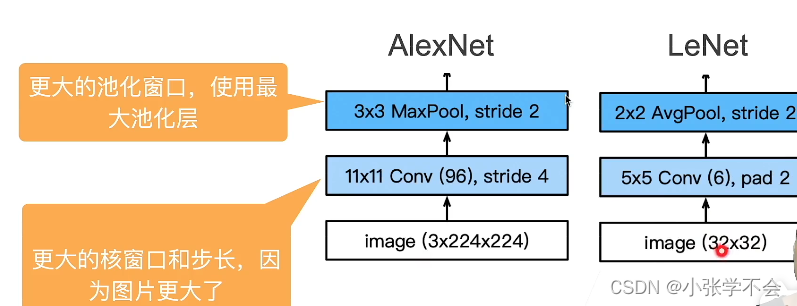
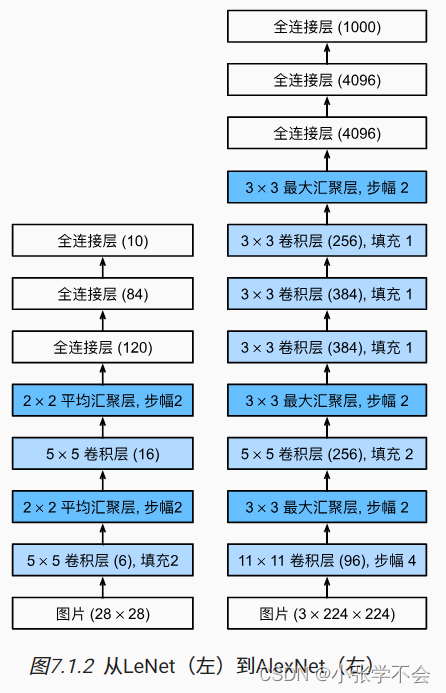
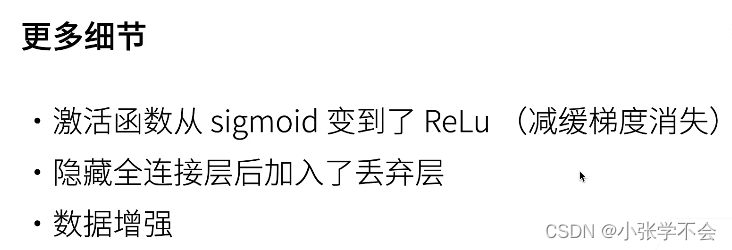
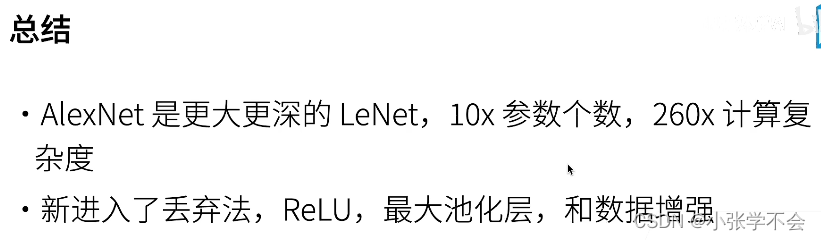
2.细节
使用Sequential一层一层的串起来。
net = nn.Sequential(
    # 这里使用一个11*11的更大窗口来捕捉对象。
    # 同时,步幅为4,以减少输出的高度和宽度。
    # 另外,输出通道的数目远大于LeNet
    nn.Conv2d(1, 96, kernel_size=11, stride=4, padding=1), nn.ReLU(),
    nn.MaxPool2d(kernel_size=3, stride=2),
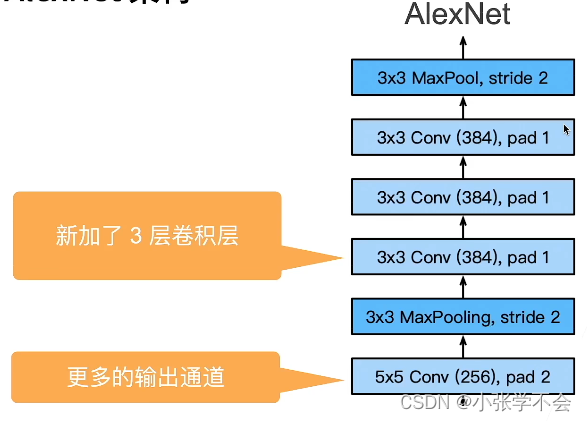
    # 减小卷积窗口,使用填充为2来使得输入与输出的高和宽一致,且增大输出通道数
    nn.Conv2d(96, 256, kernel_size=5, padding=2), nn.ReLU(),
    nn.MaxPool2d(kernel_size=3, stride=2),
    # 使用三个连续的卷积层和较小的卷积窗口。
    # 除了最后的卷积层,输出通道的数量进一步增加。
    # 在前两个卷积层之后,汇聚层不用于减少输入的高度和宽度
    nn.Conv2d(256, 384, kernel_size=3, padding=1), nn.ReLU(),
    nn.Conv2d(384, 384, kernel_size=3, padding=1), nn.ReLU(),
    nn.Conv2d(384, 256, kernel_size=3, padding=1), nn.ReLU(),
    nn.MaxPool2d(kernel_size=3, stride=2),
    nn.Flatten(),#拉成向量
    # 这里,全连接层的输出数量是LeNet中的好几倍。使用dropout层来减轻过拟合
    nn.Linear(6400, 4096), nn.ReLU(),#得先打印一下每层的输出的形状,才能知道高宽,然后再256*高宽,就是这个6400,5*5是卷积后图片的大小,视频往后看就知道怎么回事了,池化出来的维度和卷积核算法一样((n-f+2p)/s)+1;n为输入维度,f为核维度,p为填充值,s为步幅,可以参考吴恩达的理论课
    nn.Dropout(p=0.5),
    nn.Linear(4096, 4096), nn.ReLU(),
    nn.Dropout(p=0.5),
    # 最后是输出层。由于这里使用Fashion-MNIST,所以用类别数为10,而非论文中的1000
    nn.Linear(4096, 10))
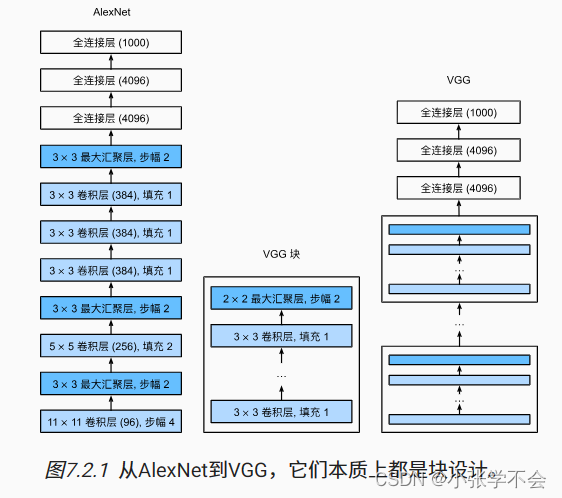
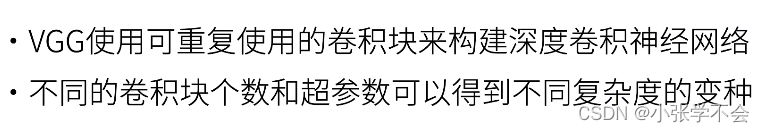
2.使用块的网络 VGG
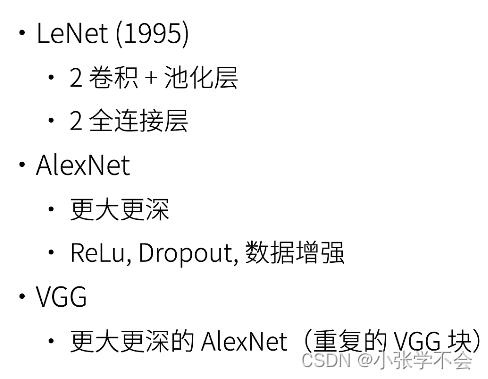
1、从单个神经元的角度思考问题,发展到整个层,现在又转向块,重复层的模式。
2、通过使用循环和子程序,可以很容易地在任何现代深度学习框架的代码中实现这些重复的架构。
1.VGG块
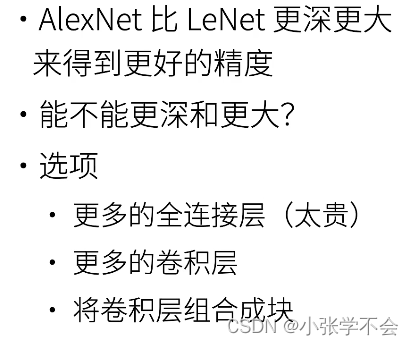
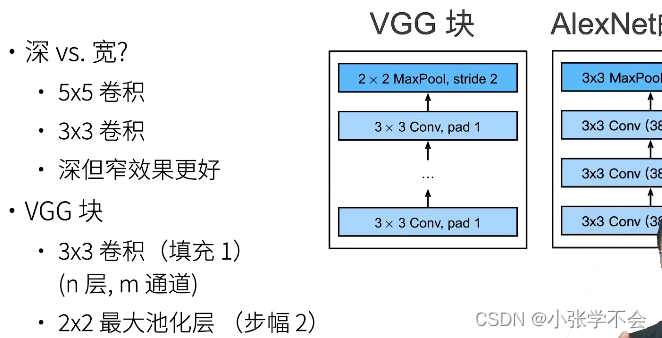
2.经典卷积神经网络
经典卷积神经网络的基本组成部分是下面的这个序列:
1、带填充以保持分辨率的卷积层;
2、非线性激活函数,如ReLU;
3、汇聚层,如最大汇聚层。
3.VGG网络
1、与AlexNet、LeNet一样,VGG网络可以分为两部分:第一部分主要由卷积层和汇聚层组成,第二部分由全连接层组成。
2、原始VGG网络有5个卷积块,其中前两个块各有一个卷积层,后三个块各包含两个卷积层。
4.演变
5.总结
3.网络中的网络(NiN)
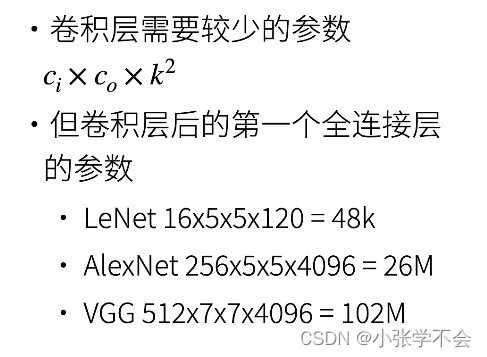
1、LeNet、AlexNet和VGG都有一个共同的设计模式:通过一系列的卷积层与汇聚层来提取空间结构特征;然后通过全连接层对特征的表征进行处理。
2、AlexNet和VGG对LeNet的改进主要在于如何扩大和加深这两个模块。然而,如果使用了全连接层,可能会完全放弃表征的空间结构。
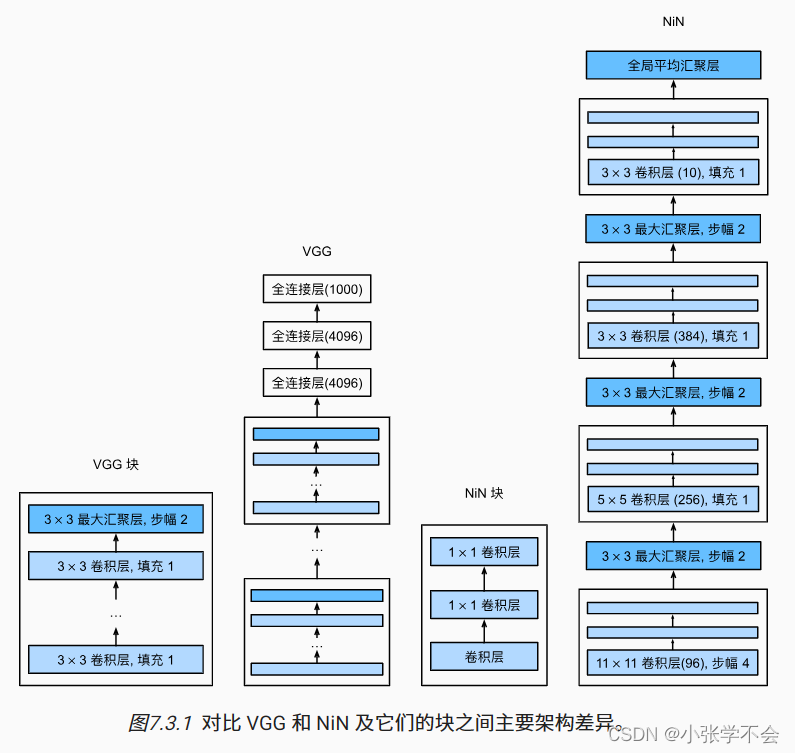
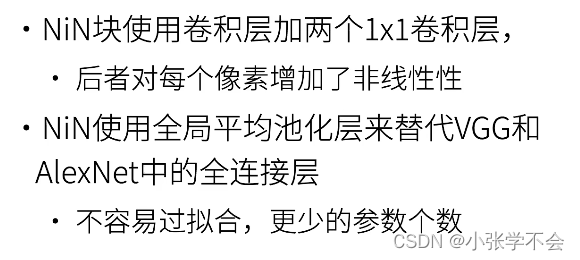
3、网络中的网络(NiN)提供了一个非常简单的解决方案:在每个像素的通道上分别使用多层感知机。
1.全连接层的问题
2.NiN块
1、卷积层的输入和输出由四维张量组成,张量的每个轴分别对应样本、通道、高度和宽度。
2、全连接层的输入和输出通常是分别对应于样本和特征的二维张量。
3、NiN的想法是在每个像素位置(针对每个高度和宽度)应用一个全连接层。
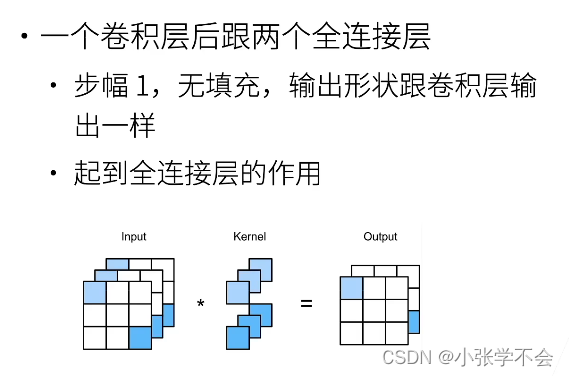
1*1卷积层当全连接层使用。在每个像素位置上独立作用的全连接层。
3.NiN架构
4.总结
5.NiN模型

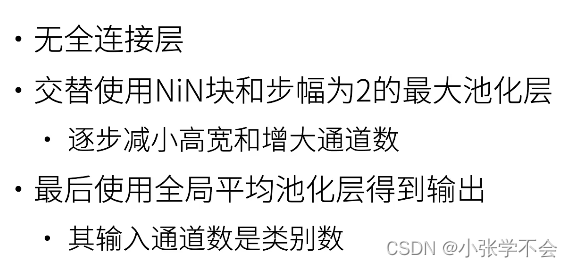
NiN和AlexNet之间的一个显著区别是NiN完全取消了全连接层。
NiN使用一个NiN块,其输出通道数等于标签类别的数量。
最后放一个全局平均汇聚层。
4.含并行连结的网络(GoogLeNet)
1、GoogLeNet吸收了NiN中串联网络的思想,并在此基础上做了改进。
2、重点是解决了什么样大小的卷积核最合适的问题。
3、本文的一个观点是,有时使用不同大小的卷积核组合是有利的。
1.Inception块
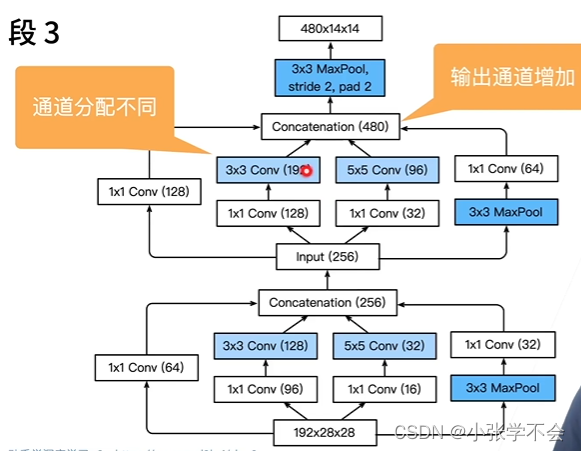
在GoogLeNet中,基本的卷积块被称为Inception块。我全要。
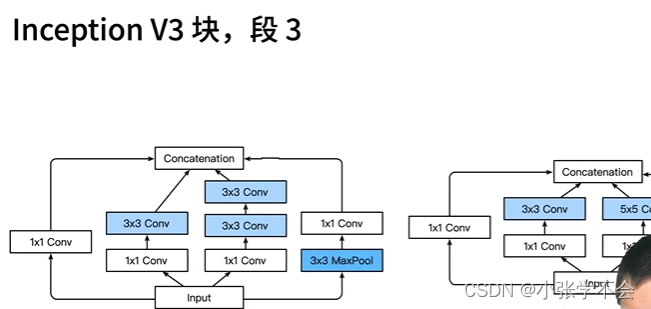
白色的1X1的卷积只是用来改变通道数。蓝色的卷积层是用来抽取信息。
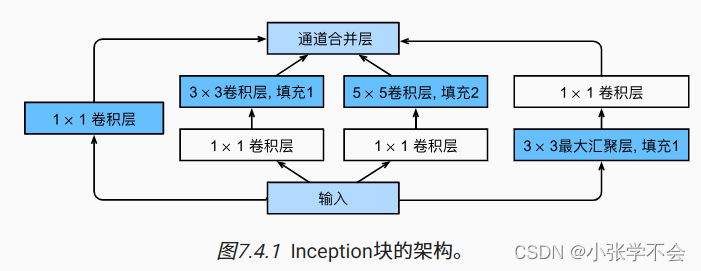
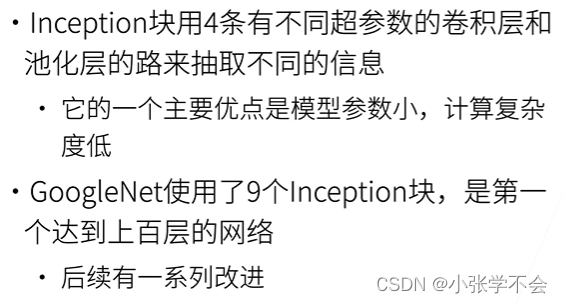
这四条路径都使用合适的填充来使输入与输出的高和宽一致,最后我们将每条线路的输出在通道维度上连结,并构成Inception块的输出。在Inception块中,通常调整的超参数是每层输出通道数。也就是说变的只有通道数,高和宽不变。
2.GoogLeNet模型
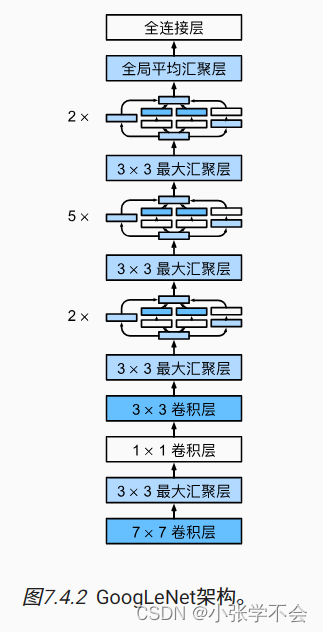
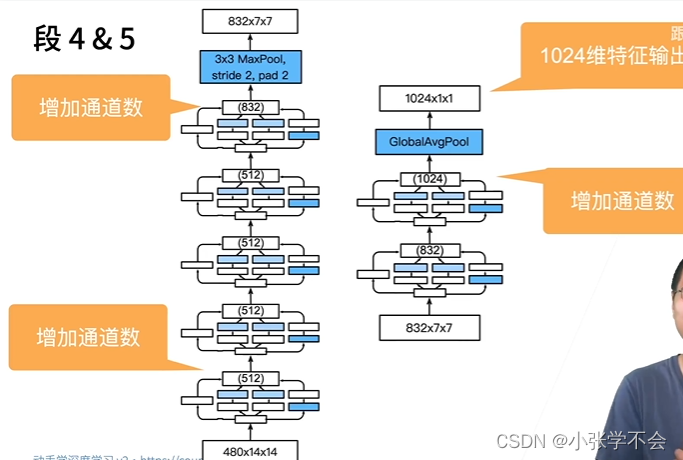
1.GoogLeNet一共使用9个Inception块和全局平均汇聚层的堆叠来生成其估计值。
2.Inception块之间的最大汇聚层可降低维度。
3.第一个模块类似于AlexNet和LeNet,Inception块的组合从VGG继承,全局平均汇聚层避免了在最后使用全连接层。
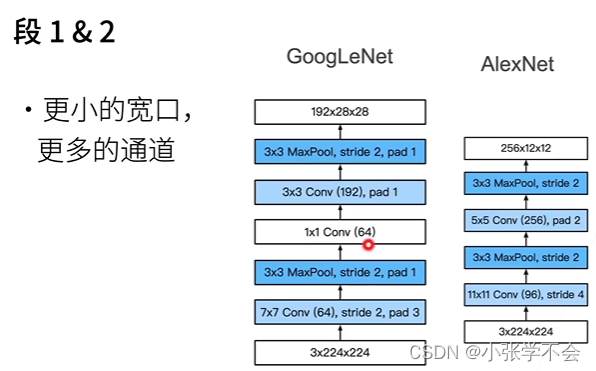
1.模块1和模块2
1.第一个模块使用64个通道、(7\times 7)卷积层。
2.第二个模块使用两个卷积层:第一个卷积层是64个通道、(1\times 1)卷积层;第二个卷积层使用将通道数量增加三倍的(3\times 3)卷积层。
升通道降低高宽。
2.模块3
3.模块4和模块5
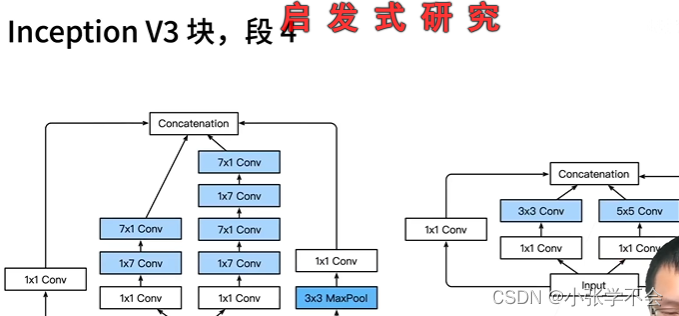
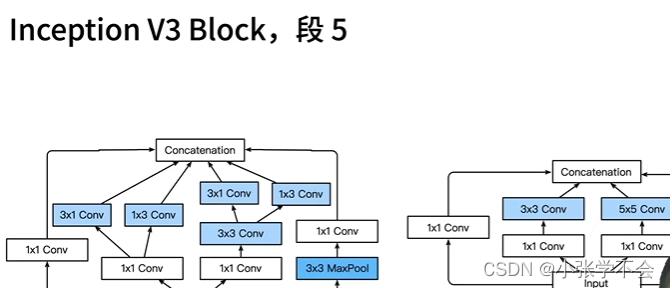
3.InceptionV3块
4.总结
5.批量归一化BN
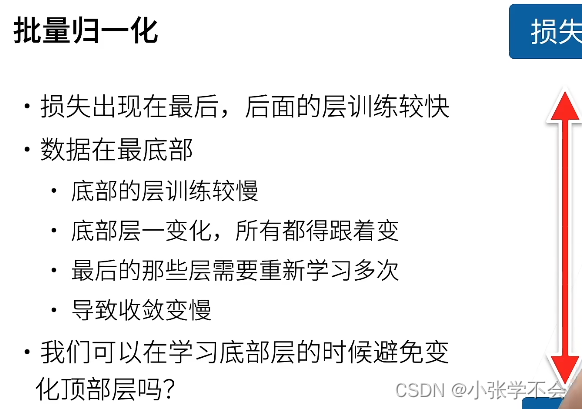
可持续加速深层网络的收敛速度。
1.现象
2.核心想法
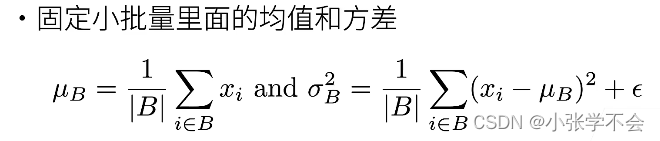
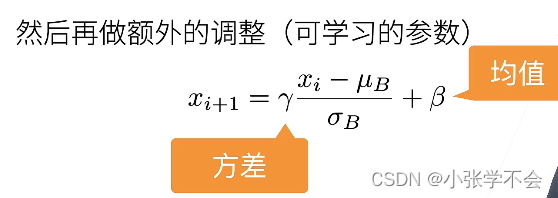
3.批量归一化层
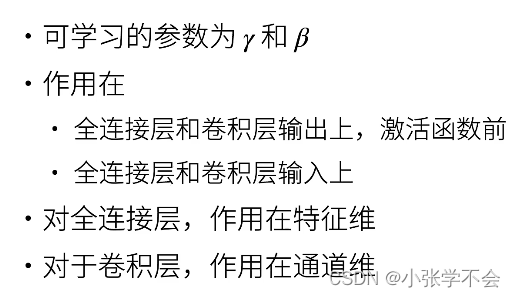
4.批量归一化在做什么
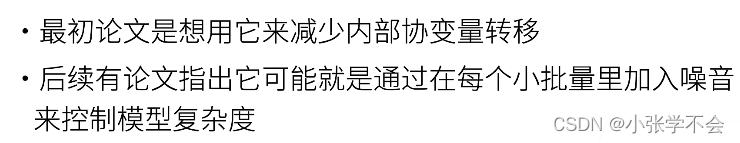
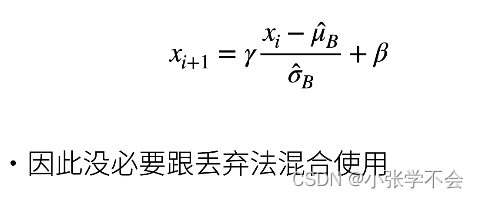
5.总结
预测用全局的mean,训练用当前的mean。
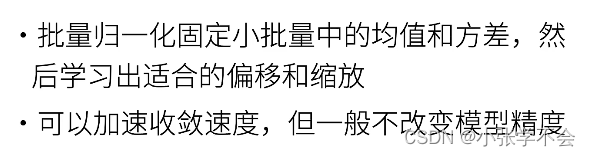
在训练过程中,我们无法得知使用整个数据集来估计平均值和方差,所以只能根据每个小批次的平均值和方差不断训练模型。
6.残差网络(ResNet)
1.加更多的层总是改善精度嘛?
新添加的层如何提升神经网络的性能。
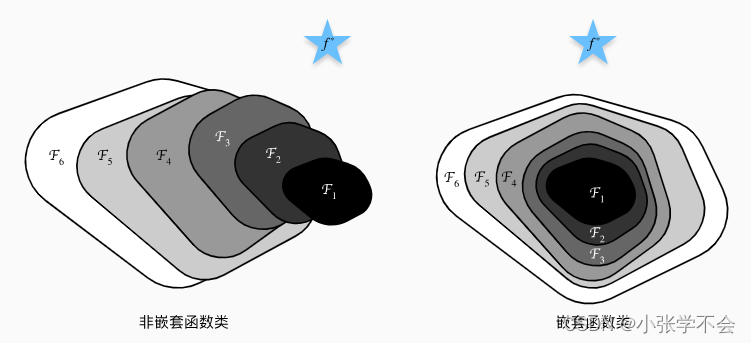
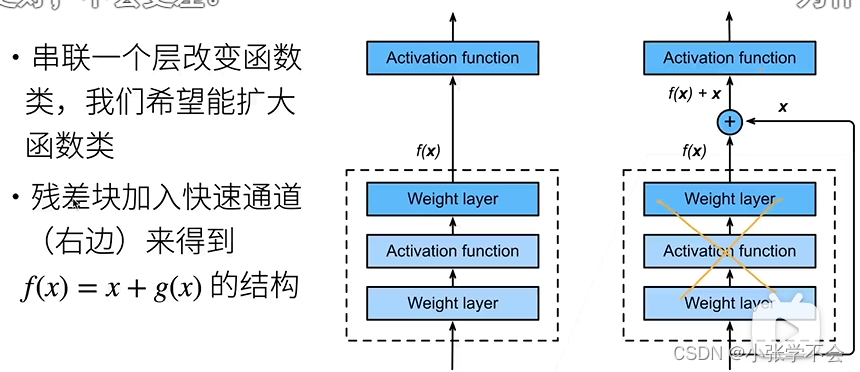
2.残差块
新添加的层如何提升神经网络的性能
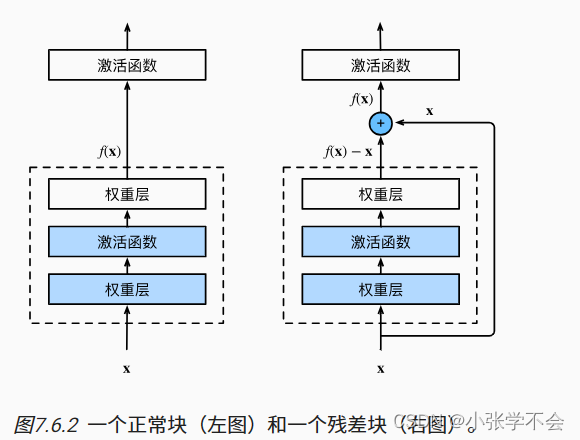
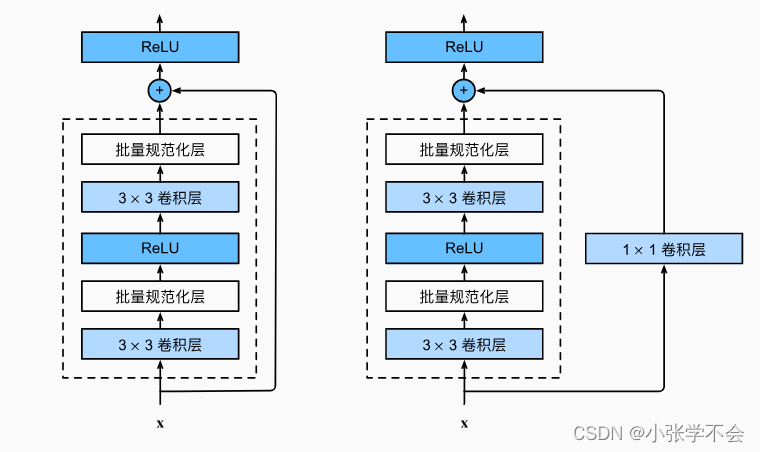
3.ResNet细节
最后输出的时候多加了一下
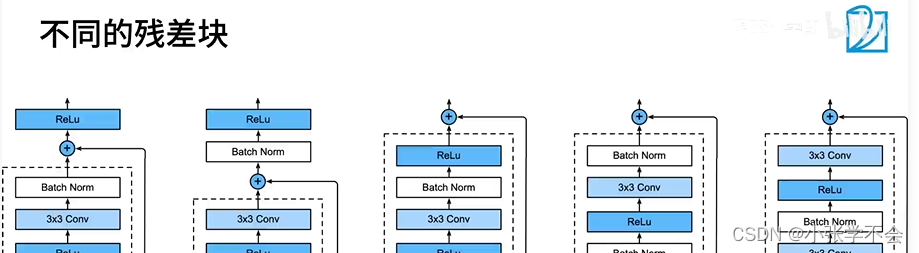
4.四篇小论文
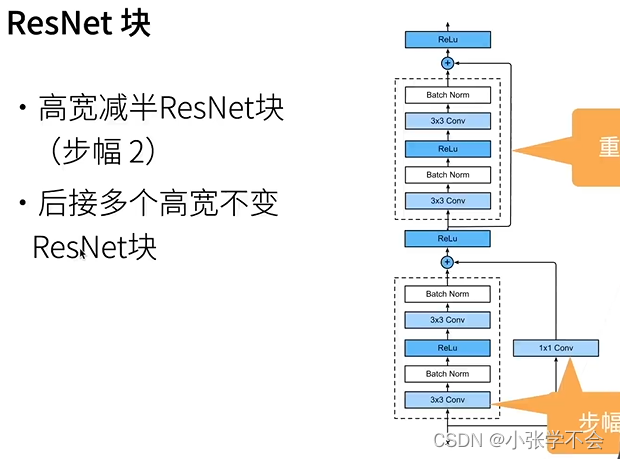
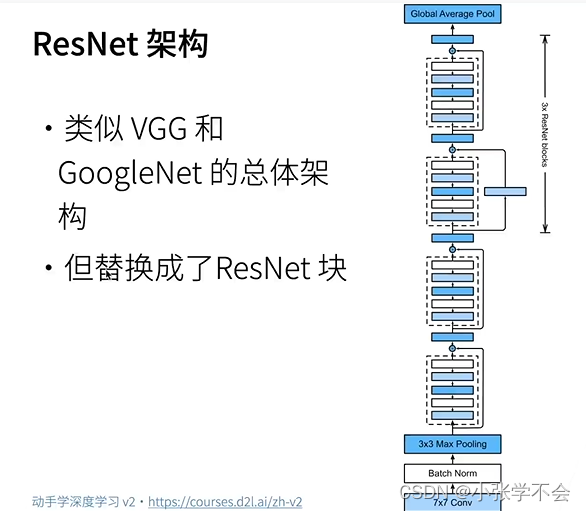
5.ResNet架构
6.总结
7.ResNet为什么能训练出1000层的模型

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)