C/C++精品项目之图床共享云存储(5):FastDFS存储原理,文件的秒传
目录
C/C++精品项目之图床共享云存储(1):基础组件-CSDN博客
C/C++精品项目之图床共享云存储(2):MySql连接池_mysql 连接池c++ ping-CSDN博客
C/C++精品项目之图床共享云存储(3):网络缓冲区类和main-CSDN博客
C/C++精品项目之图床共享云存储(4):注册,登录,token,排序文件-CSDN博客
C/C++精品项目之图床共享云存储(6):图片的共享,浏览,获取,以及短链的生成
一:FastDFS的存储原理
1:海量小文件存储
通常我们认为大小在1MB以内的文件称为小文件,百万级数量及以上称为海量,由此量化定义海量小文件问题。 如社交网站、电子商务、广电、网络视频、高性能计算,这里举几个典型应用场景。
0:著名的社交网站Facebook存储了600亿张以上的图片,推出了专门针对海量小图片定制优化的Haystack进行存储。
0:淘宝目前应该是最大C2C电子商务网站,存储超过200亿张图片,平均大小仅为15KB,也推出了针对小文件优化的TFS文件系统存储这些图片,并且进行了开源。
0:歌华有线可以进行图书和视频的在线点播,图书每页会扫描成一个几十KB大小的图片,总图片数量能够超过20亿;视频会由切片服务器根据视频码流切割成1MB左右的分片文件,100个频道一个星期的点播量,分片文件数量可达到1000万量级。
那么小文件存储能带来什么问题呢?
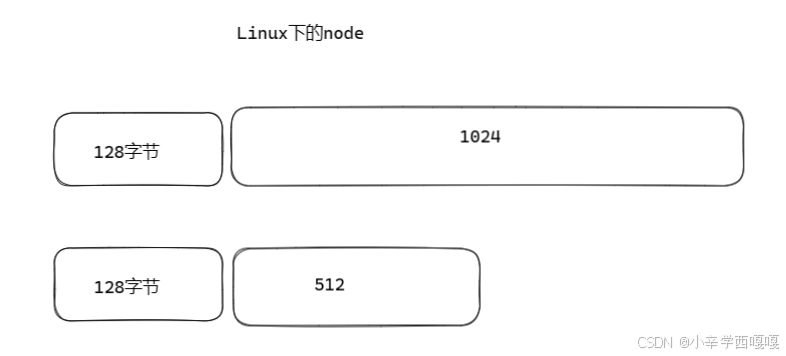
Linux通过node存储文件信息,但inode也会消耗硬盘空间,所以硬盘格式化的时候,操作系统自动将硬盘分成两个区域。
1. 一个是数据区,存放文件数据;
2. 另一个是inode区(inode table),存放inode所包含的信息。
每个inode节点的大小,一般是128字节或256字节。inode节点的总数,在格式化时就给定,一般是每1KB或每2KB就设置一个inode。假定在一块1GB的硬盘中,每个inode节点的大小为128字节,每1KB就设置一个inode,那么inode table的大小就会达到128MB,占整块硬盘的12.8%。
小文件主要有2个问题:
1. 如果小文件都小于<1KB,而系统初始化的时候每个2K设置一个node,则此时一个文件还是至少占用2K的空间,最后导致磁盘空间利用率不高,< 50%。
2. 大量的小文件,导致在增加、查找、删除文件的时候需要遍历过多的node节点,影响效率。
2:和并存储小文件
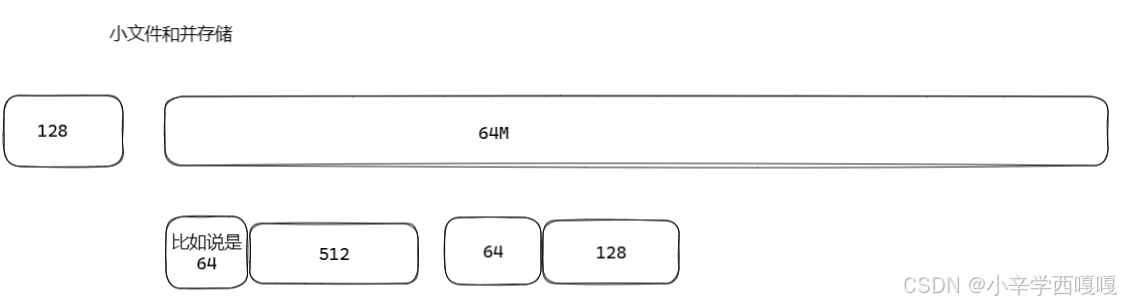
还好我们的FastDFS有解决小文件存储的方案:use_trunk_file 和并存储文件。合并文件存储相关的配置都在tracker.conf中
#是否启用trunk存储,缺省false,需要打开配置
use_trunk_file = true
#trunk文件最小分配单元 字节,缺省256,即使上传的文件只有10字节,也会分配这么多空间。
slot_min_size = 256
#trunk内部存储的最大文件,超过该值会被独立存储,缺省16M,超过这个size的文件,不会存储到trunk file中,而是作为一个单独的文件直接存储到文件系统中,这里设置为1M只是为了更方便测试。
slot_max_size = 1MB
#trunk文件大小,默认 64MB,不要配置得过大或者过小,最好不要超过256MB。
trunk_file_size = 64MB
向FastDFS上传文件成功时,服务器返回该文件的存取ID叫做fileid:
当没有启动合并存储时该fileid和磁盘上实际存储的文件一一对应
当采用合并存储时就不再一一对应而是多个fileid对应的文件被存储成一个大文件。
注:下面将采用合并存储后的大文件统称为Trunk文件,没有合并存储的文件统称为源文件;
请大家注意区分三个概念:
1)Trunk文件:storage服务器磁盘上存储的实际文件,默认大小为64MB
2)合并存储文件的FileId:表示服务器启用合并存储后,每次上传返回给客户端的FileId,注意此时该FileId与磁盘上的文件没有一一对应关系;
3)没有合并存储的FileId:表示服务器未启用合并存储时,Upload时返回的FileID
Trunk文件文件名格式:fdfs_storage1/data/00/00/000001 文件名从1开始递增,类型为int。
//创建一个10M文件
truncate -s 10M testfile10M.bin

//创建一个512K文件
truncate -s 512K testfile512K.bin

ll testfile*
//看到创建的测试文件
10485760 Jul 27 15:43 testfile10M.bin
  524288 Jul 27 15:43 testfile512K.bin

//上传10M的文件,会独立存储
/usr/bin/fdfs_upload_file /etc/fdfs/client.conf ./testfile10M.bin
返回:
group1/M00/00/00/wKgBG2akp02AT-ScAKAAAJ7KKsw455.bin

//上传512K的文件,当作小文件存储
/usr/bin/fdfs_upload_file /etc/fdfs/client.conf ./testfile512K.bin
返回:
group1/M00/00/00/wKgBG2akp0-IE7pCAAgAAHVmCqwAAAAAQAIAQAACAEA765.bin

//查看存储目录,可以看到trunk文件
ls -al /home/fastdfs/storage/data/00/00/
total 90712
drwxr-xr-x   2 root root     4096 Jul 27 15:52 .
drwxr-xr-x 258 root root     4096 Jul 22 21:13 ..
-rw-r--r--   1 root root 67108864 Jul 27 15:52 000001  这个是trunk文件,大小为64M
....
-rw-r--r--   1 root root 10485760 Jul 27 15:52 wKgBG2akp02AT-ScAKAAAJ7KKsw455.bin 这
个是上传的10M文件
3:文件的上传原理和负载均衡
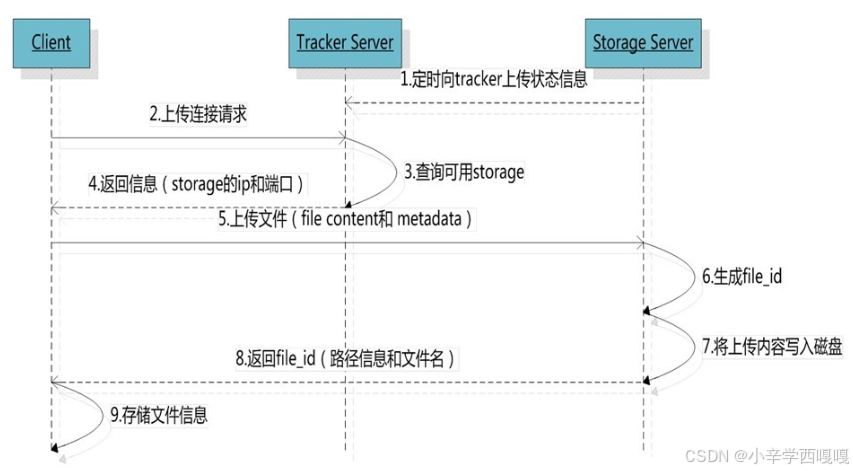
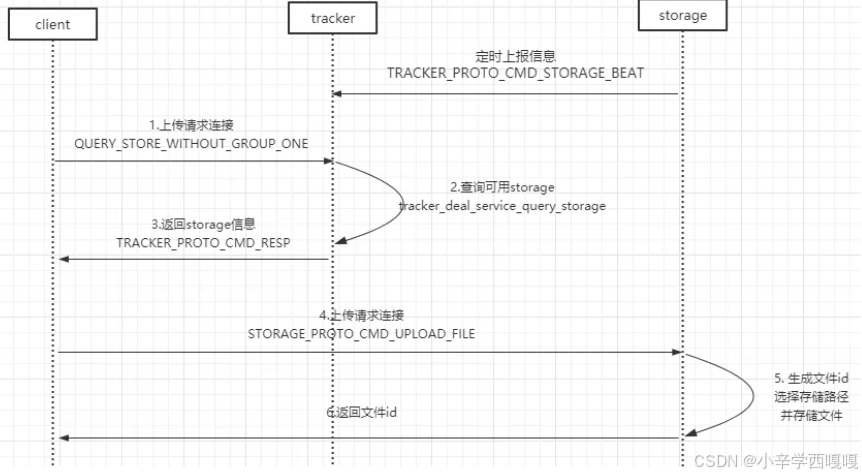
1:选择tracker server
当集群中不止一个tracker server时,由于tracker之间是完全对等的关系,客户端在upload文件时可以任意选择一个trakcer。 --》 高可用,通过冗余的方式提供服务。
2:选择存储的group
(注意不同的负载均衡算法)
当tracker接收到upload file的请求时,会为该文件分配一个可以存储该文件的group,支持如下选择group的规则:
1. Round robin,所有的group间轮询
2. Specified group,指定某一个确定的group
3. Load balance,选择最大剩余空 间的组上传文件
3:选择storage server
(注意不同的负载均衡算法)
当选定group后,tracker会在group内选择一个storage server给客户端,支持如下选择storage的规则:1. Round robin,在group内的所有storage间轮询
2. First server ordered by ip,按ip排序
3. First server ordered by priority,按优先级排序(优先级在storage上配置)
4:选择storage path
(注意不同的负载均衡算法)
当分配好storage server后,客户端将向storage发送写文件请求,storage将会为文件分配一个数据存储目录,支持如下规则:
1. Round robin,多个存储目录间轮询
2. 剩余存储空间最多的优先
5:生成Fileid
选定存储目录之后,storage会为文件生一个Fileid,由:
storage server ip
文件创建时间
文件大小
文件crc32
一个随机数
拼接而成,然后将这个二进制串进行base64编码,转换为可打印的字符串。
6:选择两级目录
当选定存储目录之后,storage会为文件分配一个fileid,每个存储目录下有两级256*256的子目录,storage会按文件fileid进行两次hash(猜测),路由到其中一个子目录,然后将文件以fileid为文件名存储到该子目录下。
一个目录存储100百万文件,单个子目录平均100百万/(256*256) = 15.2个文件
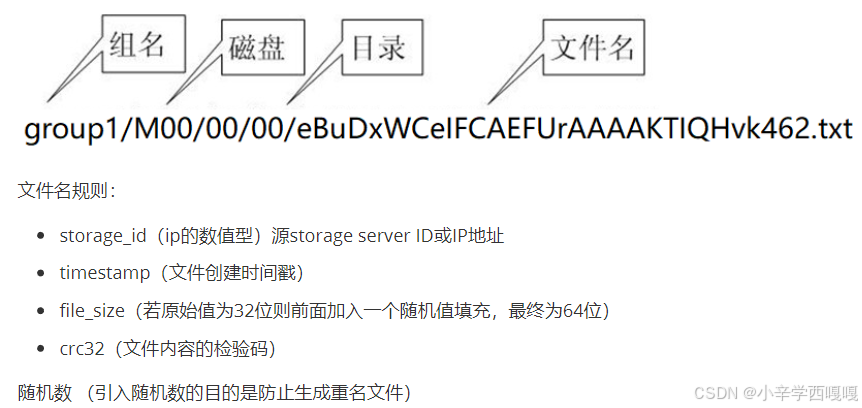
7:生成文件名
当文件存储到某个子目录后,即认为该文件存储成功,接下来会为该文件生成一个文件名,文件名由:
group、存储目录、两级子目录、fileid、文件后缀名(由客户端指定,主要用于区分文件类型)拼接而成。
二:文件的秒传
先讲一下大体的流程,我们要上传文件,我们在客户端的时候,先通过HTTP将这个文件的md5值先发送给服务端,服务端这里进入到md5的api,服务端通过这个md5,开始从数据库文件中查找这个md5值,如果这个值能在数据库中找到,那么代表我们数据库中含有这个文件,那么我们就不需要客户端传入文件了,我们直接更新总文件的数量以及这个用户所拥有的文件列表即可。这样我们的秒传功能就做好了。
//MD5的妙传处理:原理就是文件如果一致,那么他们的MD5就是相同的,我们只需要从info表中查看这个Md5是否存在即可。
//首先还是先解析json,然后token,进入到秒传的具体步骤。当然要传入我们用户的名字,我们当前文件的md5。
//首先就是拿到mysql的连接,然后通过连接进行查询info表的信息,查看这个md5是否已经存在了,如果存在,那么我们拿取他的数量,如果不存在那么就无法妙传。
//我们查看所有文件的引用计数之后,也要看当前用户是否拥有这个文件了,我们通过查询用户文件表,如果这个用户已经拥有这个文件,那么我们直接返回。
//如果没有拥有,那么我们就更新总info表的信息+1,代表我们要拥有一个文件。然后再更新用户文件表,插入我们这个用户的文件信息,代表我们这个用户也拥有了。
//记住,如果我们用户文件表插入失败,那么总信息表要退回来。
int ApiMd5(string &url, string &post_data, string &resp_json) {

    // 解析json
    string user;
    string md5;
    string token;
    string filename;
    int ret = 0;

    if(decodeMd5Json(post_data, user, token, md5, filename) != 0) {
        LogError("decodeMd5Json() err");
        //封装code =  Md5Failed
        encodeMd5Json(Md5Failed, resp_json);
        return 0;
    }
    //校验token
    ret = VerifyToken(user, token); // util_cgi.h
    if (ret == 0) {
        //秒传业务的处理
        // in: user  md5 filename,  out:resp_json
        handleDealMd5(user.c_str(), md5.c_str(), filename.c_str(), resp_json);
        return 0;
    } else {
        // 校验失败
        encodeMd5Json(Md5TokenFaild, resp_json);
        return 0;
    }
}
上面的代码都是最基本的流程,下面我们讲解处理md5:我们先获取数据库的连接,通过sql命令查找这个md5,如果查找到,代表这个文件我们总列表中存在,那么接下来要查找我们这个用户是否已经存在了,通过拼接查找用户的SQL命令,并执行,如果在用户中也存在了,那么无需上传,直接返回。如果不存在,那么就需要我们进行一系列的操作了。
首先就是我们要更新总表,因为多了一个用户拥有这个文件了,那么需要我们把这个文件数量加一。然后就是将这个文件的一些信息插入到用户表中,当然其中的一些细节,当我们用户插入失败,那么我们要把前面更新总表的数量再更新回来。
void handleDealMd5(const char *user, const char *md5, const char *filename,string &str_json)
{
    //去file_info查询md5是否存在
    //" select count from file_info where md5 = '%s'", md5
    //msyql操作的问题, mysql连接池
    int ret = 0;
    char sql_cmd[SQL_MAX_LEN] = {0};
    CDBManager *db_manager = CDBManager::getInstance();
    CDBConn *db_conn = db_manager->GetDBConn("tuchuang_master");
    AUTO_REL_DBCONN(db_manager, db_conn);

    // 1.先查询file_info表里有没有该文件的存储信息
    //  sql 语句,获取此md5值文件的文件计数器 count
    sprintf(sql_cmd, "select count from file_info where md5 = '%s'", md5);
    //count是对应md5对应文件被引用的次数
    LogInfo("执行: {}", sql_cmd);
    int file_ref_count = 0;     //文件引用计数,将查询到的数量存放到file_ref_count
    ret = GetResultOneCount(db_conn, sql_cmd, file_ref_count);
    if(ret == 0) {  //查询有结果,有行纪录 md5存在
        //2. 查看此用户是否已经有此文件,如果存在说明此文件已上传,无需再上传
        sprintf(sql_cmd, "select * from user_file_list where user = '%s' and md5 = '%s' and file_name = '%s'", user, md5, filename);
        LogInfo("执行: {}", sql_cmd);
        //返回值: 1: 表示已经存储了,有这个文件记录
        ret = CheckwhetherHaveRecord(db_conn, sql_cmd); // 检测个人是否有记录
        if(ret == 1) {
            LogWarn("user: {}->  filename: {}, md5: {}已存在", user, filename, md5);
            encodeMd5Json(Md5FileExit, str_json);
        } else if(ret == 0) { //重点处理这个逻辑
            // 更新file_info count
            sprintf(sql_cmd, "update file_info set count = %d where md5 = '%s'",
                file_ref_count + 1, md5);
            LogInfo("执行: {}", sql_cmd);
            if (!db_conn->ExecutePassQuery(sql_cmd)) {
                LogError("{} 操作失败", sql_cmd);
                encodeMd5Json(Md5Failed, str_json);
                return;
            }
            // 添加用户文件列表记录
            //当前时间戳
            struct timeval tv;
            struct tm *ptm;
            char time_str[128];

            //使用函数gettimeofday()函数来得到时间。它的精度可以达到微妙
            gettimeofday(&tv, NULL);
            ptm = localtime(&tv.tv_sec); //把从1970-1-1零点零分到当前时间系统所偏移的秒数时间转换为本地时间
            // strftime()
            // 函数根据区域设置格式化本地时间/日期,函数的功能将时间格式化,或者说格式化一个时间字符串
            strftime(time_str, sizeof(time_str), "%Y-%m-%d %H:%M:%S", ptm);

            //user file list , insert
            sprintf(sql_cmd,   "insert into user_file_list(user, md5, create_time, file_name, "
                "shared_status, pv) values ('%s', '%s', '%s', '%s', %d, %d)",
                user, md5, time_str, filename, 0, 0);
             LogInfo("执行: {}", sql_cmd);
            if (!db_conn->ExecuteCreate(sql_cmd)) {
                LogError("{} 操作失败", sql_cmd);
                // 恢复引用计数
                sprintf(sql_cmd, "update file_info set count = %d where md5 = '%s'", file_ref_count, md5);
                LogInfo("执行: {}", sql_cmd);
                if (!db_conn->ExecutePassQuery(sql_cmd)) {
                    LogError("{} 操作失败", sql_cmd);
                }
                encodeMd5Json(Md5Failed, str_json);
            }
            encodeMd5Json(Md5Ok, str_json);
        } else {
            LogInfo("CheckwhetherHaveRecord失败: {}", ret);
            encodeMd5Json(Md5Failed, str_json);
        }
    } else {
         LogInfo("秒传失败");
         encodeMd5Json(Md5Failed, str_json);
    }
}
三:文件的普通上传
当我们文件秒传不成功,代表我们需要进行普通上传。上传文件的总体逻辑:
1. 先通过nginx-upload-module模块上传文件到临时目录
2. nginx-upload-module模块上传完文件后通知/api/upload后端处理程序:
3. 后端处理程序ApiUpload函数解析文件信息,然后将临时文件上传到fastdfs
4. 更新数据库记录:file_info, user_file_list
首先我们就写了一大堆的变量,这些变量都是用来存储我们解析的参数。由于需要解析的代码很长而且还很一致,所以中间省略了很多。到后面我们已经解析出这个文件的具体位置以及后缀了,我们可以通过调用FastDFS的upload命令了。(可以看另一段代码了)
//上传函数,首先这个函数的前提是通过http将文件上传到nginx后,nginx中含有这个文件之后,我们通过客户端发送来的数据,解析出文件的各种参数
//其中包括 文件名, 文件类型, 文件大小, 文件的md5值, 文件的存储路径, 存储的host_name等,我们需要通过这些信息将nginx中的文件存储到fastDFS中,
//然后再存储到数据库中。下面的一大段都是解析我们所需要的参数。解析完之后,需要存储到fastdfs去。

//解析传过来的参数,将本地文件上传到fastdfs中,然后将本地文件进行删除,通过上传返回来的fileid,我们通过info来查找这个文件所在IP位置等, \
然后再将这些信息拼接出一个完整的url,将这个url存放到数据库中的info表中和具体的用户表中。这样我们就可以通过这个url地址,去下载这个文件了。
int ApiUpload(string &post_data, string &resp_json) {
    LogInfo("post_data:\n{}", post_data);
    char suffix[SUFFIX_LEN] = {0};
    char fileid[TEMP_BUF_MAX_LEN] = {0}; //文件上传到fastDFS后的文件id
    char fdfs_file_url[FILE_URL_LEN] = {0}; //文件所存放storage的host_name
    int ret = 0;
    char boundary[TEMP_BUF_MAX_LEN] = {0}; //分界线信息
    char file_name[128] = {0};
    char file_content_type[128] = {0};
    char file_path[128] = {0};
    char new_file_path[128] = {0};
    char file_md5[128] = {0};
    char file_size[32] = {0};
    long long_file_size = 0;
    char user[32] = {0};
    char *begin = (char *)post_data.c_str();
    char *p1, *p2;

    // 获取数据库连接
    CDBManager *db_manager = CDBManager::getInstance();
    CDBConn *db_conn = db_manager->GetDBConn("tuchuang_master"); // 连接池可以配置多个 分库
    AUTO_REL_DBCONN(db_manager, db_conn);

    // 1. 解析boundary
    // Content-Type: multipart/form-data;
    // boundary=----WebKitFormBoundaryjWE3qXXORSg2hZiB 找到起始位置
    p1 = strstr(begin, "\r\n"); // 作用是返回字符串中首次出现子串的地址
    if (p1 == NULL) {
        LogError("wrong no boundary!");
        // ret = -1;
        goto END;
    }
    //拷贝分界线
    strncpy(boundary, begin, p1 - begin); // 缓存分界线, 比如:WebKitFormBoundary88asdgewtgewx
    boundary[p1 - begin] = '\0'; //字符串结束符
    LogInfo("boundary: {}", boundary); //打印出来

    // 查找文件名file_name 匹配字符串的算法
    begin = p1 + 2;  // 2->\r\n
    p2 = strstr(begin, "name=\"file_name\""); //找到file_name字段
    if (!p2) {
        LogError("wrong no file_name!");
        // ret = -1;
        goto END;
    }
    p2 = strstr(begin, "\r\n"); // 找到file_name下一行
    p2 += 4;                    //下一行起始
    begin = p2;                 //
    p2 = strstr(begin, "\r\n");
    strncpy(file_name, begin, p2 - begin);
    LogInfo("file_name: {}", file_name);

     .......

    // 获取文件名后缀
    GetFileSuffix(file_name, suffix); //  20230720-2.txt -> txt  mp4, jpg, png
    strcat(new_file_path, file_path); // /root/tmp/1/0045118901
    strcat(new_file_path, ".");  // /root/tmp/1/0045118901.
    strcat(new_file_path, suffix); // /root/tmp/1/0045118901.txt
    // 重命名 修改文件名  fastdfs 他需要带后缀的文件
    ret = rename(file_path, new_file_path); /// /root/tmp/1/0045118901 ->  /root/tmp/1/0045118901.txt
    if (ret < 0) {
        LogError("rename {} to {} failed", file_path, new_file_path);
        // ret = -1;
        goto END;
    }
    //===============> 将该文件存入fastDFS中,并得到文件的file_id <============
    LogInfo("uploadFileToFastDfs, file_name:{}, file_path:{}, new_file_path:{}", file_name,file_path, new_file_path);
    if (uploadFileToFastDfs(new_file_path, fileid) < 0) {
        LogError("uploadFileToFastDfs failed, unlink: {}", new_file_path);
        ret = unlink(new_file_path);        //我们上传失败,所以这个文件可以删除了。
        if (ret != 0) {
            LogError("unlink: {} failed", new_file_path); // 删除失败则需要有个监控重新清除过期的临时文件,比如过期两天的都删除
        }
        // ret = -1;
        goto END;
    }
    //================> 删除本地临时存放的上传文件 <===============
    LogInfo("unlink: {}", new_file_path);
    ret = unlink(new_file_path);
    if (ret != 0) {
        LogWarn("unlink: {} failed", new_file_path); // 删除失败则需要有个监控重新清除过期的临时文件,比如过期两天的都删除
    }
    //================> 得到文件所存放storage的host_name <=================
    // 拼接出完整的http地址
    LogInfo("getFullurlByFileid, fileid: {}", fileid);
    if (getFullurlByFileid(fileid, fdfs_file_url) < 0) {
        LogError("getFullurlByFileid failed ");
        // ret = -1;
        goto END;
    }
    //===============> 将该文件的FastDFS相关信息存入mysql中 <======
    // 把文件写入file_info
    if (storeFileinfo(db_conn, user, file_name, file_md5,
                      long_file_size, fileid, fdfs_file_url) < 0) {
        LogError("storeFileinfo failed ");
        // ret = -1;
        // 严谨而言,这里需要删除 已经上传的文件
        goto END;
    }

    encodCodeJson(0, resp_json);
    return 0;
END:
    encodCodeJson(1, resp_json);
    return 0;
}
这段代码就是upload的具体操作,其中重要的是我们怎么获得这个命令后的返回值:fileid。
//将文件上传到分布式文件系统中,我们上传的这个file_path,是我们已经整理好了的最终路径(这个文件本身所在的路径),我们把这个上传上去。
//因为我们已经通过http将文件上传到nginx的本地目录了,本地已经有这个文件了,我们要把这个文件上传到fastdfs中。
//我们使用上传命令的时候,我们发现它上传之后会返回一个fileid,我们怎么让服务器读取到输出到控制台的fileid呢?
//我们可以创建个子进程,让子进程去执行fdfs_upload_file命令,再来个管道,让他把信息输出到管道中去。当然父子进程都要关闭对应的读写端,
//子进程执行并且写入,父进程等待读取。
int uploadFileToFastDfs(char *file_path, char *fileid) {
    int ret = 0;

    pid_t pid;
    int fd[2];

    //无名管道的创建
    if (pipe(fd) < 0) // fd[0] → r; fd[1] → w  获取上传后返回的信息 fileid
    {
        LogError("pipe error");
        ret = -1;
        goto END;
    }

    //创建进程
    pid = fork(); //
    if (pid < 0)  //进程创建失败
    {
        LogError("fork error");
        ret = -1;
        goto END;
    }

    if (pid == 0) { //子进程
        //关闭读端
        close(fd[0]);
        //将标准输出 重定向 写管道
        dup2(fd[1],  STDOUT_FILENO); // 往标准输出写的东西都会重定向到fd所指向的文件,
                             // 当fileid产生时输出到管道fd[1]
        // fdfs_upload_file /etc/fdfs/client.conf 123.txt
        // printf("fdfs_upload_file %s %s %s\n", fdfs_cli_conf_path, filename,
        // file_path);
        //通过execlp执行fdfs_upload_file
        //如果函数调用成功,进程自己的执行代码就会变成加载程序的代码,execlp()后边的代码也就不会执行了.
        execlp("fdfs_upload_file", "fdfs_upload_file",
               s_dfs_path_client.c_str(), file_path, NULL); //
        // 执行正常不会跑下面的代码
        //执行失败
        LogError("execlp fdfs_upload_file error");

        close(fd[1]);
    } else { //父进程
        //关闭写端
        close(fd[1]);

        //从管道中去读数据
        read(fd[0], fileid, TEMP_BUF_MAX_LEN); // 等待管道写入然后读取

        LogInfo("fileid1: {}", fileid);
        //去掉一个字符串两边的空白字符
        TrimSpace(fileid);

        if (strlen(fileid) == 0) {
            LogError("upload failed");
            ret = -1;
            goto END;
        }
        LogInfo("fileid2: {}", fileid);

        wait(NULL); //等待子进程结束,回收其资源
        close(fd[0]);
    }

END:
    return ret;
}
我们还要这个文件所在存储服务的全部信息,为了以后的下载。
//我们在上传文件到分布式文件系统之后,我们要把这个文件的完整url地址存储到数据库中,通过fastdfs的一些命令。
//我们通过这个命令,以及文件的fildid,得到这个文件存储的全部信息,也就是这个文件所在的ip地址,以及文件所在的组名,组名就是group1。
//我们把完整的url放到数据库中,我们就可以通过这个url地址,去下载这个文件。
int getFullurlByFileid(char *fileid, char *fdfs_file_url) {
    int ret = 0;

    char *p = NULL;
    char *q = NULL;
    char *k = NULL;

    char fdfs_file_stat_buf[TEMP_BUF_MAX_LEN] = {0};
    char fdfs_file_host_name[HOST_NAME_LEN] = {0}; // storage所在服务器ip地址

    pid_t pid;
    int fd[2];

    //无名管道的创建
    if (pipe(fd) < 0) {
        LogError("pipe error");
        ret = -1;
        goto END;
    }

    //创建进程
    pid = fork();
    if (pid < 0) //进程创建失败
    {
        LogError("fork error");
        ret = -1;
        goto END;
    }

    if (pid == 0) //子进程
    {
        //关闭读端
        close(fd[0]);

        //将标准输出 重定向 写管道
        dup2(fd[1], STDOUT_FILENO); // dup2(fd[1], 1);

        execlp("fdfs_file_info", "fdfs_file_info", s_dfs_path_client.c_str(),
               fileid, NULL);

        //执行失败
        LogError("execlp fdfs_file_info error");

        close(fd[1]);
    } else //父进程
    {
        //关闭写端
        close(fd[1]);

        //从管道中去读数据
        read(fd[0], fdfs_file_stat_buf, TEMP_BUF_MAX_LEN);

        wait(NULL); //等待子进程结束,回收其资源
        close(fd[0]);
        // LogInfo("fdfs_file_stat_buf: {}", fdfs_file_stat_buf);
        //拼接上传文件的完整url地址--->http://host_name/group1/M00/00/00/D12313123232312.png
        p = strstr(fdfs_file_stat_buf, "source ip address: ");

        q = p + strlen("source ip address: ");
        k = strstr(q, "\n");

        strncpy(fdfs_file_host_name, q, k - q);
        fdfs_file_host_name[k - q] =
            '\0'; // 这里这个获取回来只是局域网的ip地址,在讲fastdfs原理的时候再继续讲这个问题

        LogInfo("host_name:{}, fdfs_file_host_name: {}", s_storage_web_server_ip, fdfs_file_host_name);

        // storage_web_server服务器的端口
        strcat(fdfs_file_url, "http://");
        // strcat(fdfs_file_url, s_storage_web_server_ip.c_str());
         strcat(fdfs_file_url, fdfs_file_host_name);
        // strcat(fdfs_file_url, ":");
        // strcat(fdfs_file_url, s_storage_web_server_port.c_str());
        strcat(fdfs_file_url, "/");
        strcat(fdfs_file_url, fileid);

        LogInfo("fdfs_file_url:{}", fdfs_file_url);
    }

END:

    return ret;
}
我们在最后,也就是差一个把数据库的信息给更新了,将文件的信息插入到总文件表,以及插入到用户的文件表中。这样我们全部的工作就完成了。
//这个函数就是将文件信息通过连接数据库插入到info表中。一个表info表,一个是用户的文件列表。插入这俩。
int storeFileinfo(CDBConn *db_conn, char *user,
                  char *filename, char *md5, long size, char *fileid,
                  const char *fdfs_file_url) {
    int ret = 0;
    time_t now;
    char create_time[TIME_STRING_LEN];
    char suffix[SUFFIX_LEN];
    char sql_cmd[SQL_MAX_LEN] = {0};

    //得到文件后缀字符串 如果非法文件后缀,返回"null"
    GetFileSuffix(filename, suffix); // mp4, jpg, png

    // sql 语句
    /*
       -- =============================================== 文件信息表
       -- md5 文件md5
       -- file_id 文件id
       -- url 文件url
       -- size 文件大小, 以字节为单位
       -- type 文件类型: png, zip, mp4……
       -- count 文件引用计数, 默认为1, 每增加一个用户拥有此文件,此计数器+1
       */
    sprintf(sql_cmd,
            "insert into file_info (md5, file_id, url, size, type, count) "
            "values ('%s', '%s', '%s', '%ld', '%s', %d)",
            md5, fileid, fdfs_file_url, size, suffix, 1);
     LogInfo("执行: {}", sql_cmd);
    if (!db_conn->ExecuteCreate(sql_cmd)) //执行sql语句
    {
        LogError("{} 操作失败", sql_cmd);
        ret = -1;
        goto END;
    }

    //获取当前时间
    now = time(NULL);
    strftime(create_time, TIME_STRING_LEN - 1, "%Y-%m-%d %H:%M:%S", localtime(&now));

    /*
       -- =============================================== 用户文件列表
       -- user 文件所属用户
       -- md5 文件md5
       -- create_time 文件创建时间
       -- file_name 文件名字
       -- shared_status 共享状态, 0为没有共享, 1为共享
       -- pv 文件下载量,默认值为0,下载一次加1
       */
    // sql语句
    sprintf(sql_cmd,
            "insert into user_file_list(user, md5, create_time, file_name, "
            "shared_status, pv) values ('%s', '%s', '%s', '%s', %d, %d)",
            user, md5, create_time, filename, 0, 0);
    LogInfo("执行: {}", sql_cmd);
    if (!db_conn->ExecuteCreate(sql_cmd)) {
        LogError("{} 操作失败", sql_cmd);
        ret = -1;
        goto END;
    }

END:
    return ret;
}
腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 24
 0
- 0


 已为社区贡献3条内容

所有评论(0)