解码大数据:数据挖掘知识点一网打尽【下】
一、关联挖掘
基本概念
K-项集(K-Itemset):K-项集就是项集中的项的个数为K。
事务数据库D(dataset D):是若干项集的集合,包含多条事务。
关联规则(Association Rule):关联规则是一个蕴含式,类似P→Q,要求前件P和后件Q交集为空
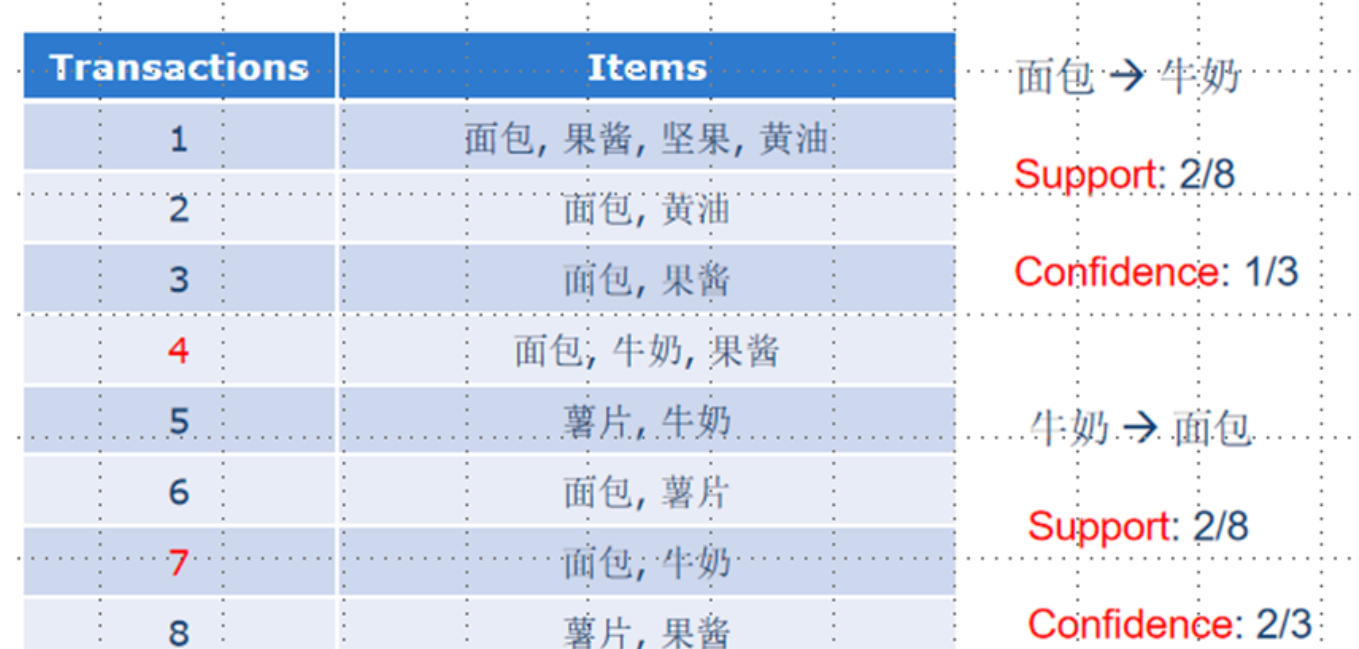
关联规则的支持度(support):支持度用于衡量一个项集在事务数据库中的出现频率。它反映了包含该项集的事务在所有事务中的比例。规则 A →B 具有支持度 S,表示 D 中事务包含的百分比,等于概率,也叫相对支持度
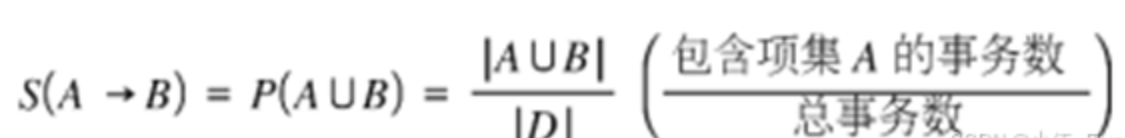
关联规则的置信度(confidence):置信度用于衡量在包含项集 A 的事务中,同时包含项集 B 的比例。它表示了规则的强度,常用于评估规则的可靠性。规则 A→B 在事务数据库中有置信度 C,表示包含项集 A 的同时也包含项集 B,即条件概率
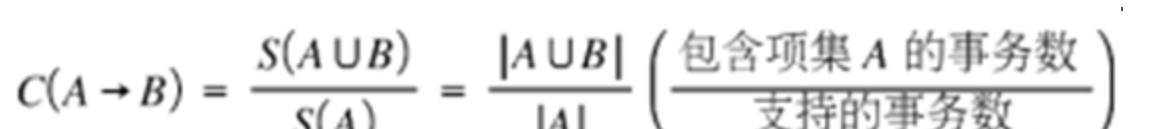
为了在事务数据库中找出有用的关联规则,需要由用户确定两个阈值,最小支持度阈值和最小置信度阈值。
如果项集的支持度大于或等于用户给定的最小支持度阈值,就称该项集是频繁项集(或大项集)
如果关联规则X→Y的置信度大于或等于用户给定的最小置信度阈值且同时支持度大于或等于用户给定的最小支持度阈值,就称该规则为强规则
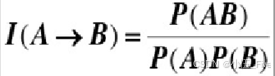
若I(A->B)=1 即P(AB)=P(A)P(B),说明项集A和项集B是相互独立的。
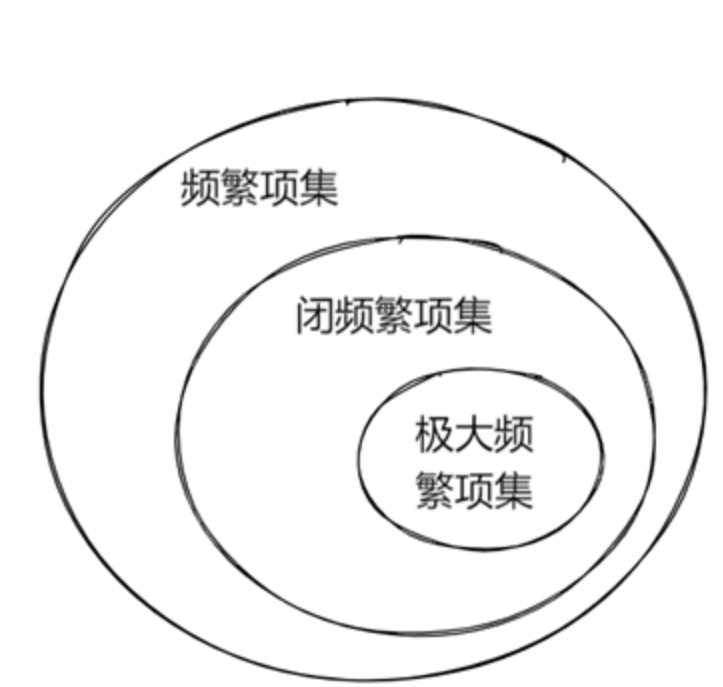
{牛奶,面包,可乐} 是频繁的,则 {牛奶,可乐} 是频繁的。
关联规则挖掘
Step 2: 使用频繁项集产生关联规则.对每一个频繁项 f 产生 f 的所有非空子集.对 f 的每一个非空子集s若support (f) / support (s) > Φ,P( (f-s) U s) / P(S),即C( s→ (f-s)) > Φ则输出强规则s → (f-s)
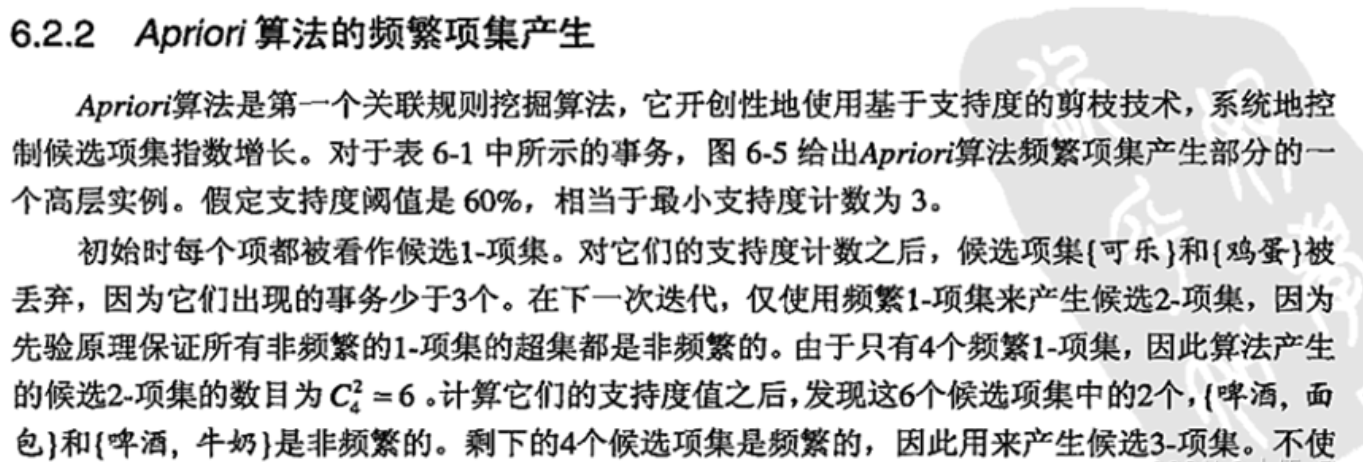
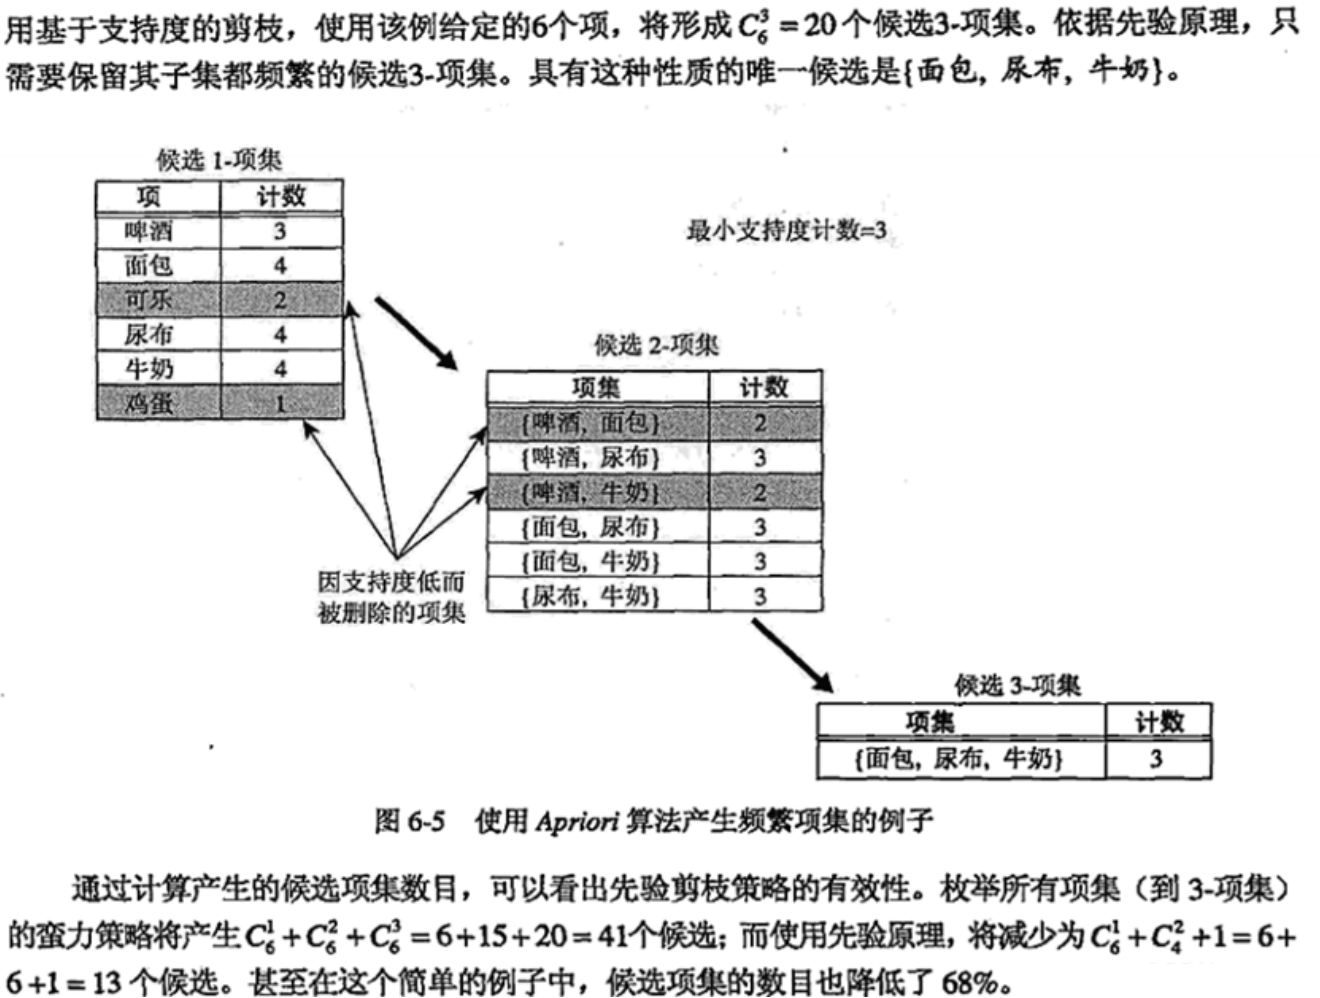
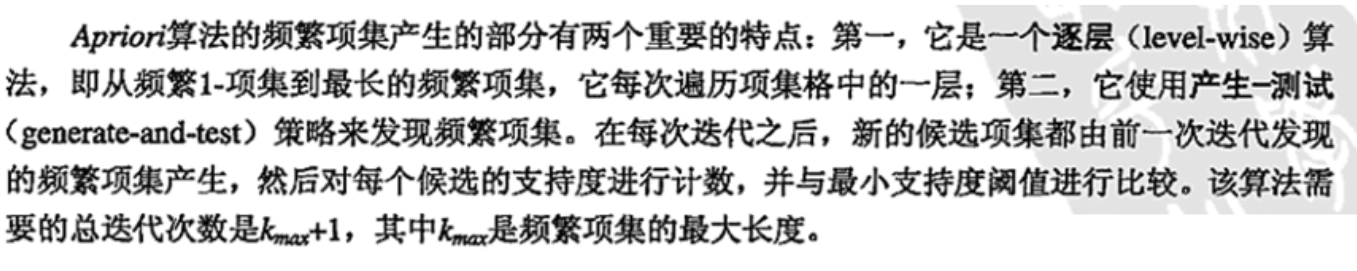
其中,候选项集的产生包含以下两种方法,都是完备的,但第一种会重复产生候选项集,而第二种可以很好的避免重复产生
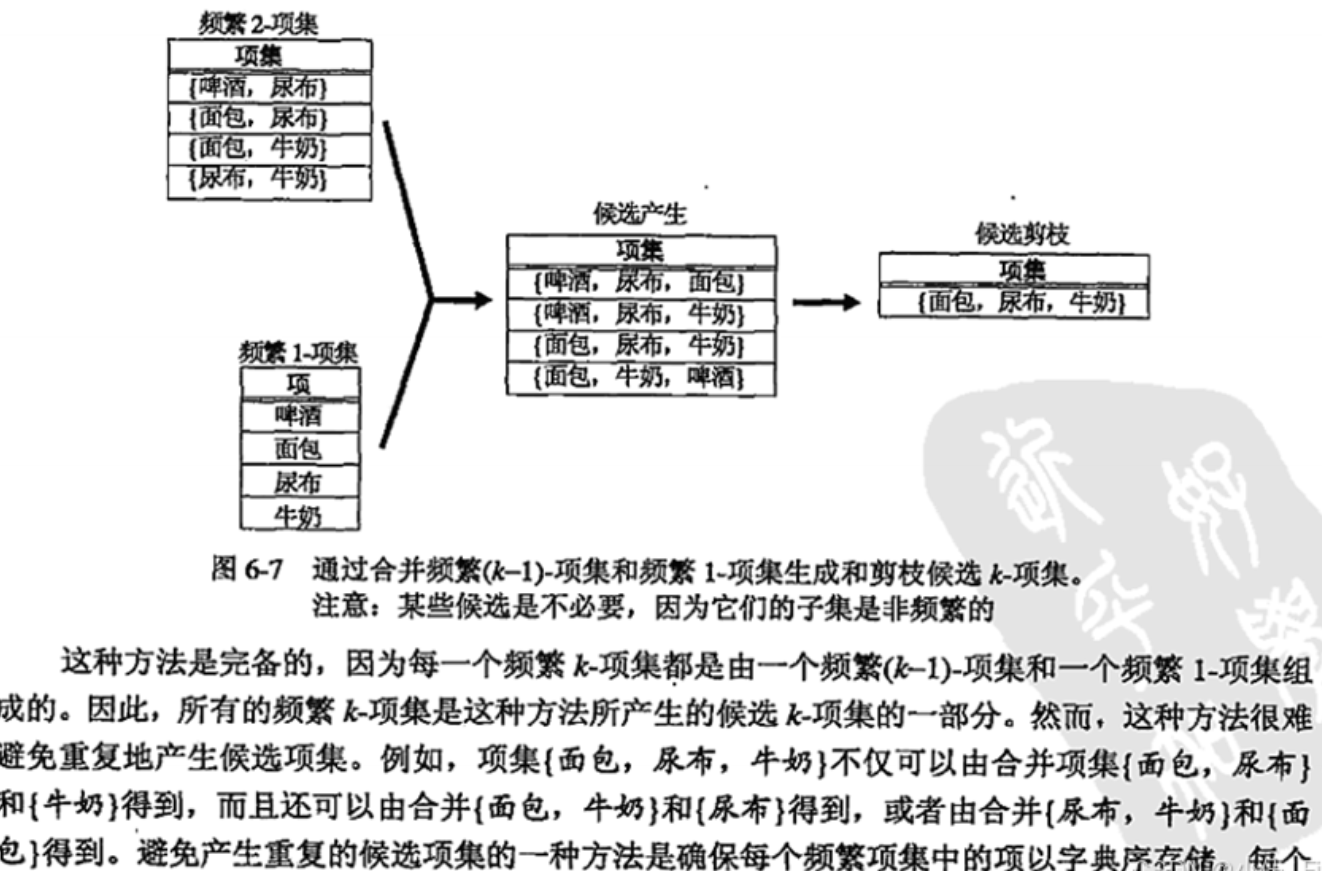
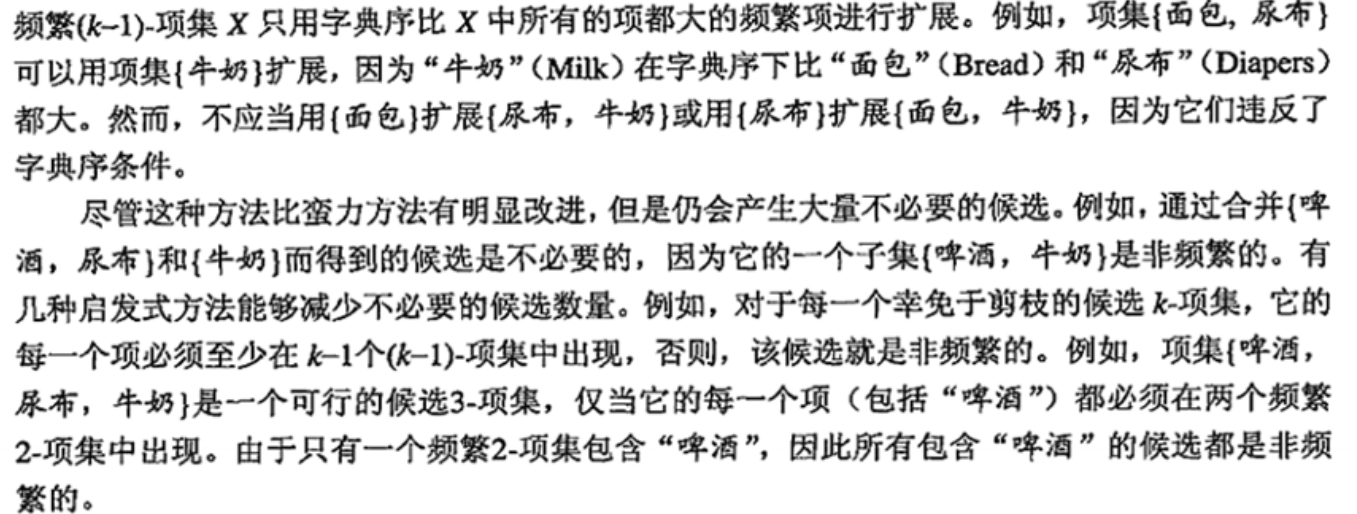
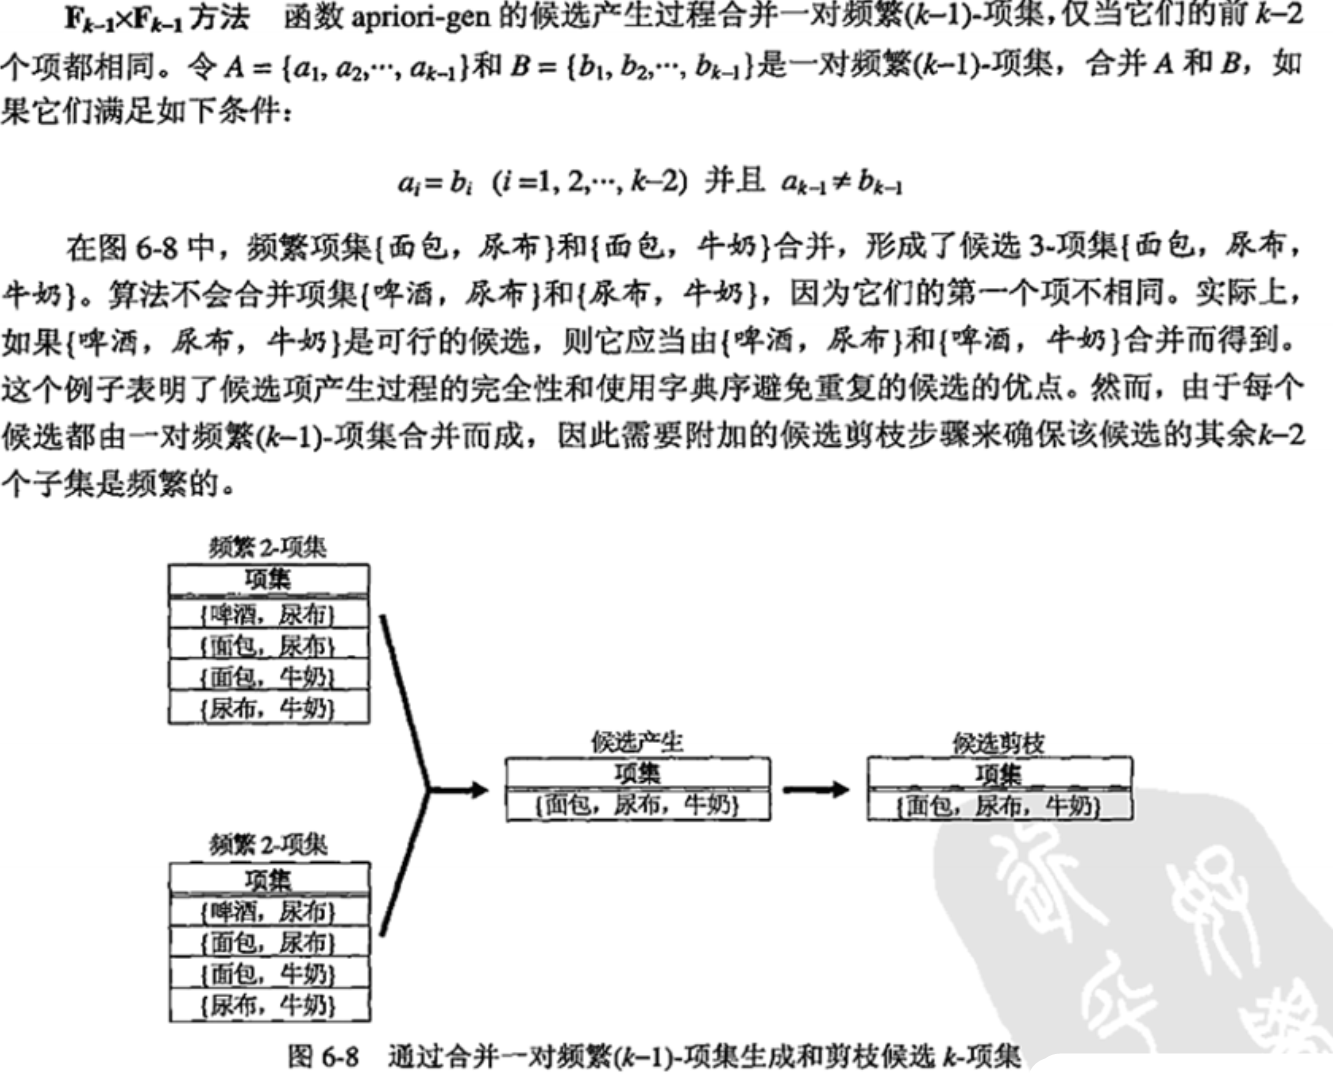

对每一个频繁项 f 产生 f 的所有非空子集.对 f 的每一个非空子集s
support (f) / support (s) = P( (f-s) U s) / P(S) = C( s→ (f-s))
这样的规则必然已经满足支持度阈值,因为它们是由频繁项集产生的
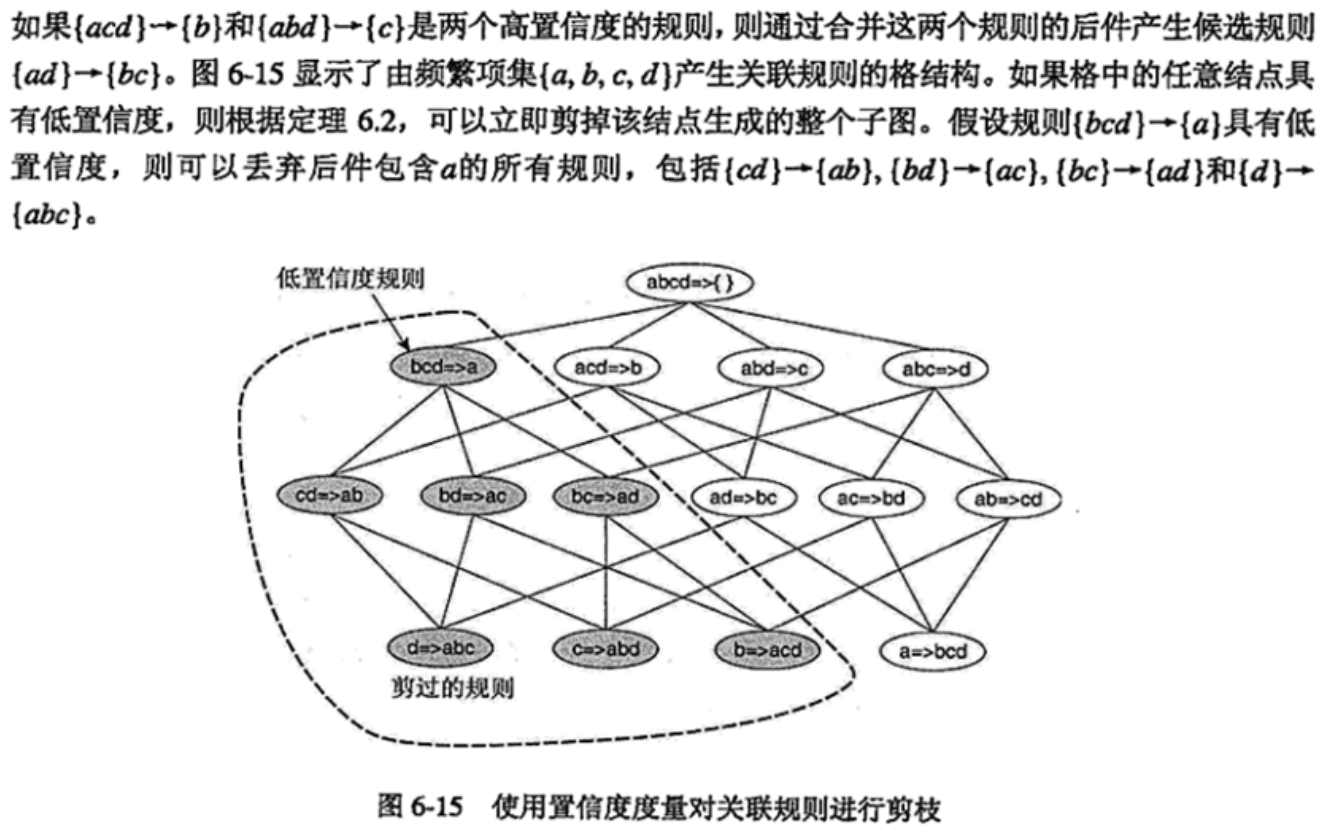
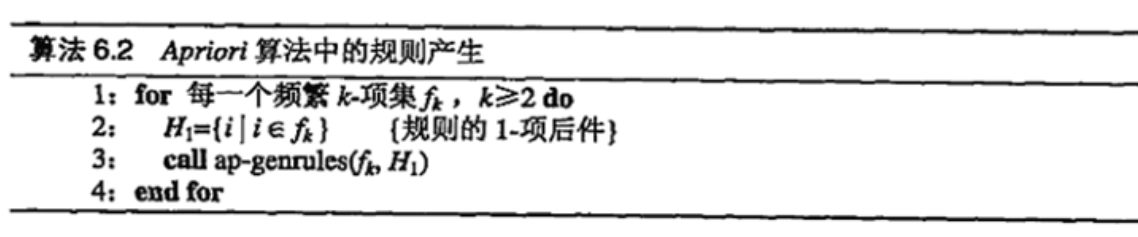
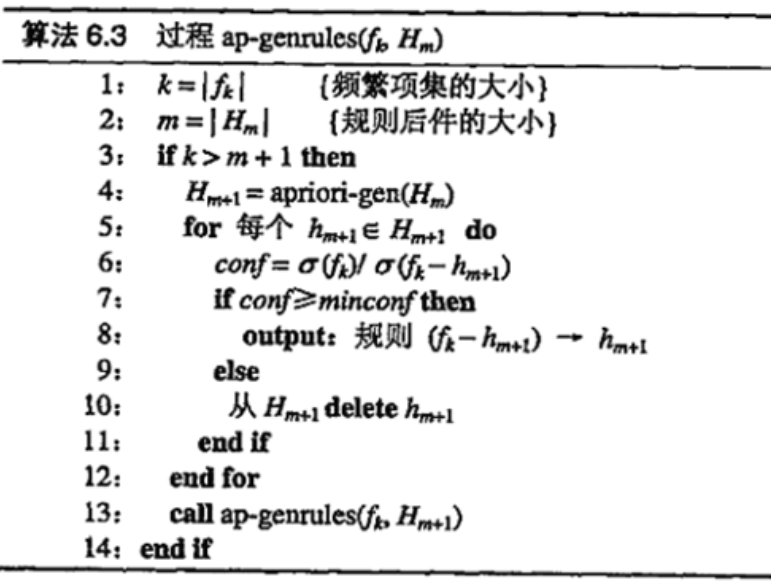
算法6.3过程与频繁项集产生过程类似,但不用扫描数据集来计算候选规则的置信度,而是使用在频繁项集产生时计算的支持度计数来确定每个规则的置信度
FP - Growth(频繁模式增长算法)
1.第一次扫描事务数据库,得到频繁1项集,并按支持度降序排序。
3.第二次扫描数据库,剔除掉原始数据中非频繁1项集,并将原始数据按支持度降序排序。
4.构造FP树:读入排序后的数据集,插入FP树,插入时按照排序后的顺序,插入FP树中,排序靠前的节点是祖先节点,而靠后的是子孙节点。如果有共用的祖先,则对应的公用祖先节点计数加1。插入后,如果有新节点出现,则项头表对应的节点会通过节点链表链接上新节点。直到所有的数据都插入到FP树后,FP树的建立完成。
5.从FP树中挖掘频繁项集:从项头表的底部项依次从下向上找到项头表项所有包含该项的前缀路径,即其条件模式基(CPB,conditional pattern base), 从条件模式基递归挖掘得到项头表项的频繁项集。递归调用树结构构造FP子树时,删除小于最小支持度的项。如果条件模式基(FP子树)最终呈现单一路径的树结构,则直接列举所有组合;非单一路径的则继续调用树结构,直到形成单一路径即可
相比Apriori算法需要多次扫描数据库,FPGrowth只需要对数据库扫描2次。
关联规则挖掘常见误区
即使一条规则的置信度很高,也不一定意味着它是合理的。例如,在一个事务库中,如果Tape和DVD的支持度分别为6000和7500,同时两者一起出现的次数为4000,那么Tape到DVD的支持度为40%,置信度为66%。尽管置信度很高,但实际上购买DVD的概率(75%)大于在购买了Tape的情况下购买DVD的条件概率,因此这个规则并不合理。
在一个包含多种商品的事务中,即使某些商品组合的支持度低于预设的阈值,也并不意味着这些商品之间没有关联。例如,如果Battery的支持度为25%,低于30%的阈值,它可能仍然与其他商品有关联,只是这种关联没有被挖掘出来。
有效的推荐(Myth No. 3 Effective Recommendation)
这一部分内容在文件中没有详细描述,但通常指的是在推荐系统中,仅仅依赖于关联规则挖掘可能不足以提供有效的推荐。可能需要考虑其他因素,如用户偏好、上下文信息等。
关联不等于因果(Myth No. 4 Association ≠ Causality)
即使两个事件X和Y之间存在关联(即条件概率P(Y|X)很高),这并不意味着X是导致Y的原因。关联规则挖掘揭示的是变量之间的关联性,而不是因果关系。
二、分类与预测
基本概念
数据集(Data set)--数据的集合,每一条数据称之为样本。
训练集(Training set)--数据集中用来训练模型的部分。
测试集(Test set)--用来测试、评估模型泛化能力的部分。
交叉验证集(Cross-validation set)--用来调整模型具体参数(调参)的数据。
一般地,训练集占总样本的50%,测试集和交叉验证集各占25%
有监督学习(supervised learning):学习器通过对大量有标记的训练数据进行学习,从而建立模型用于预测未见示例的标记。
无监督学习(unsupervised learning):无标记的训练样本,仅根据测试样本的特征空间分布情况进行标记。
半监督学习:有少量训练样本,学习机以从训练样本获得的知识为基础,结合测试样本的分布情况逐步修正已有知识,并判断测试样本的类别
决策树方法
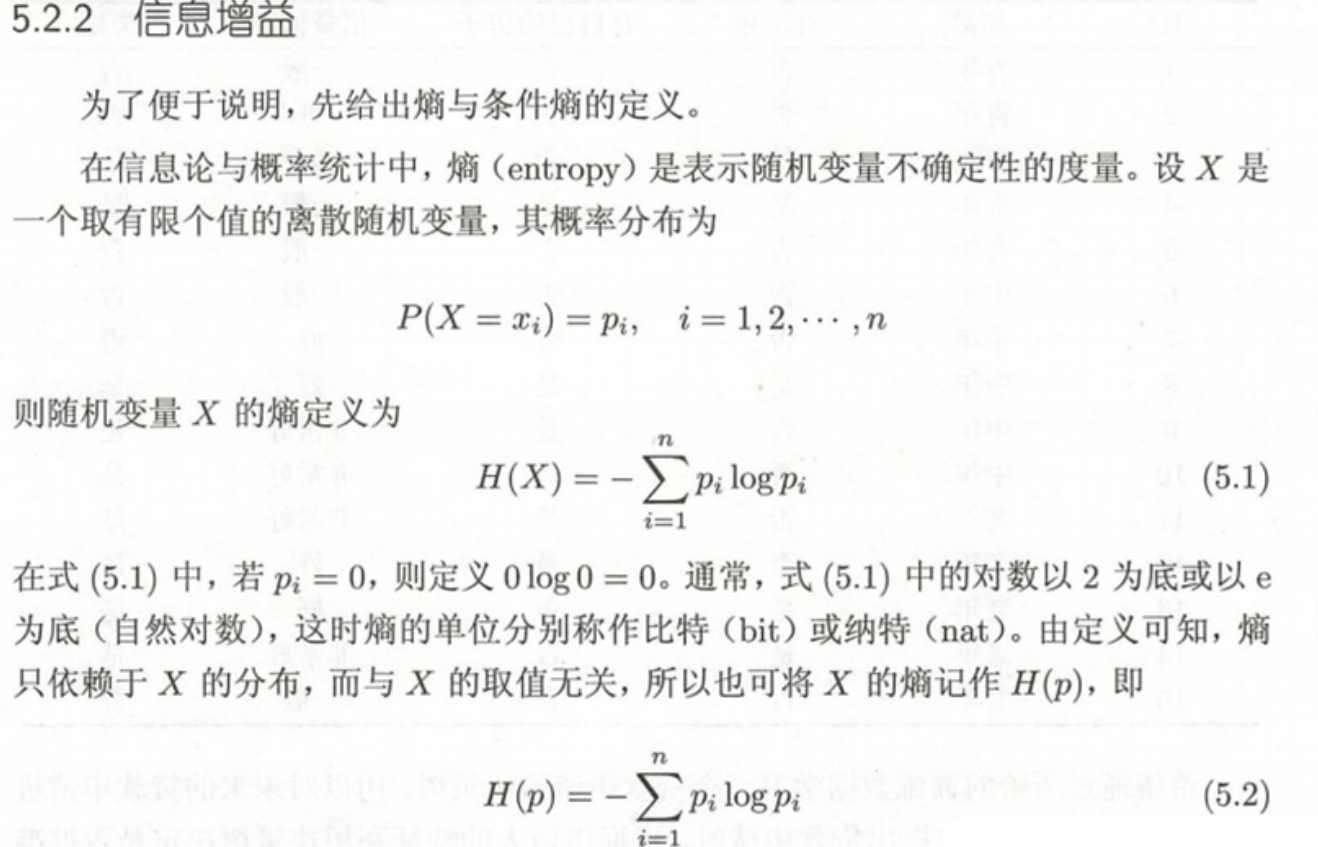
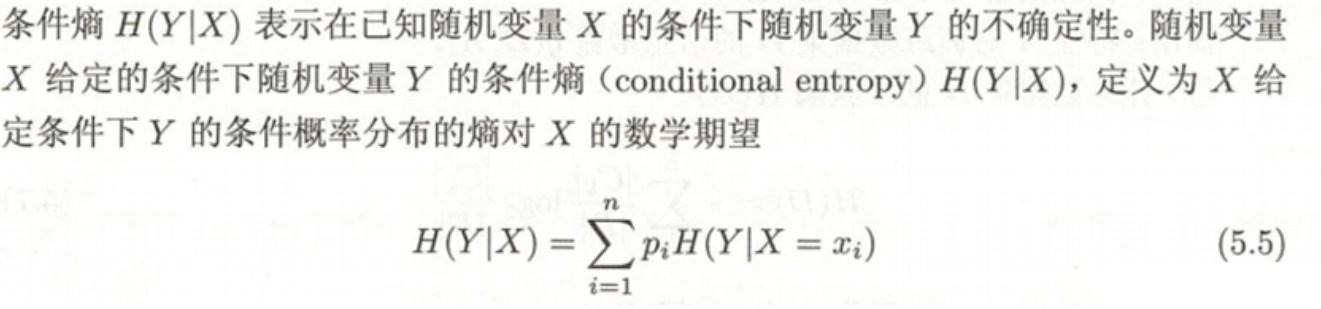
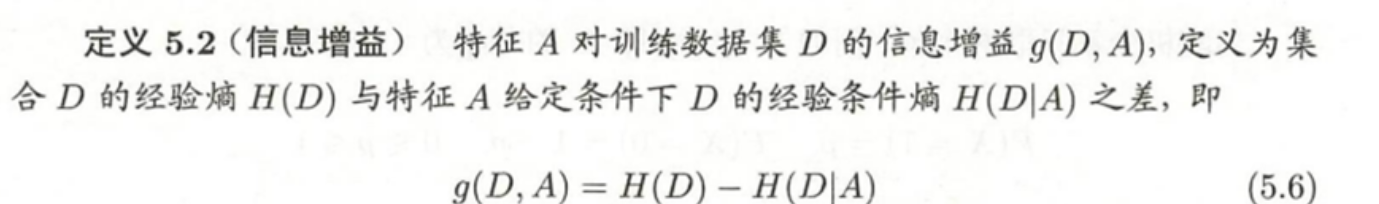
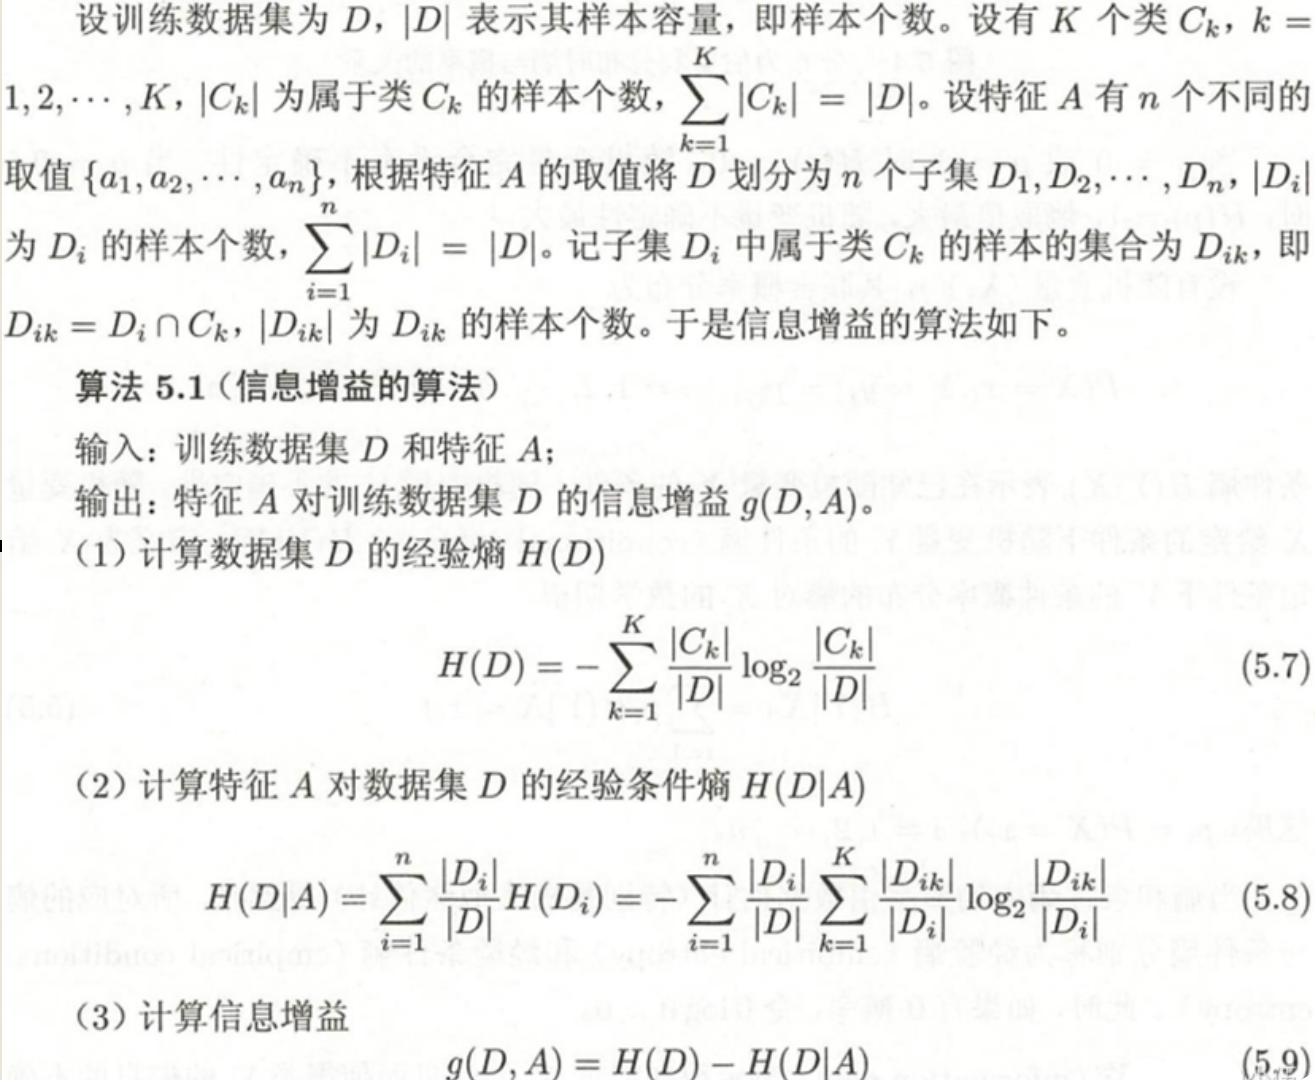
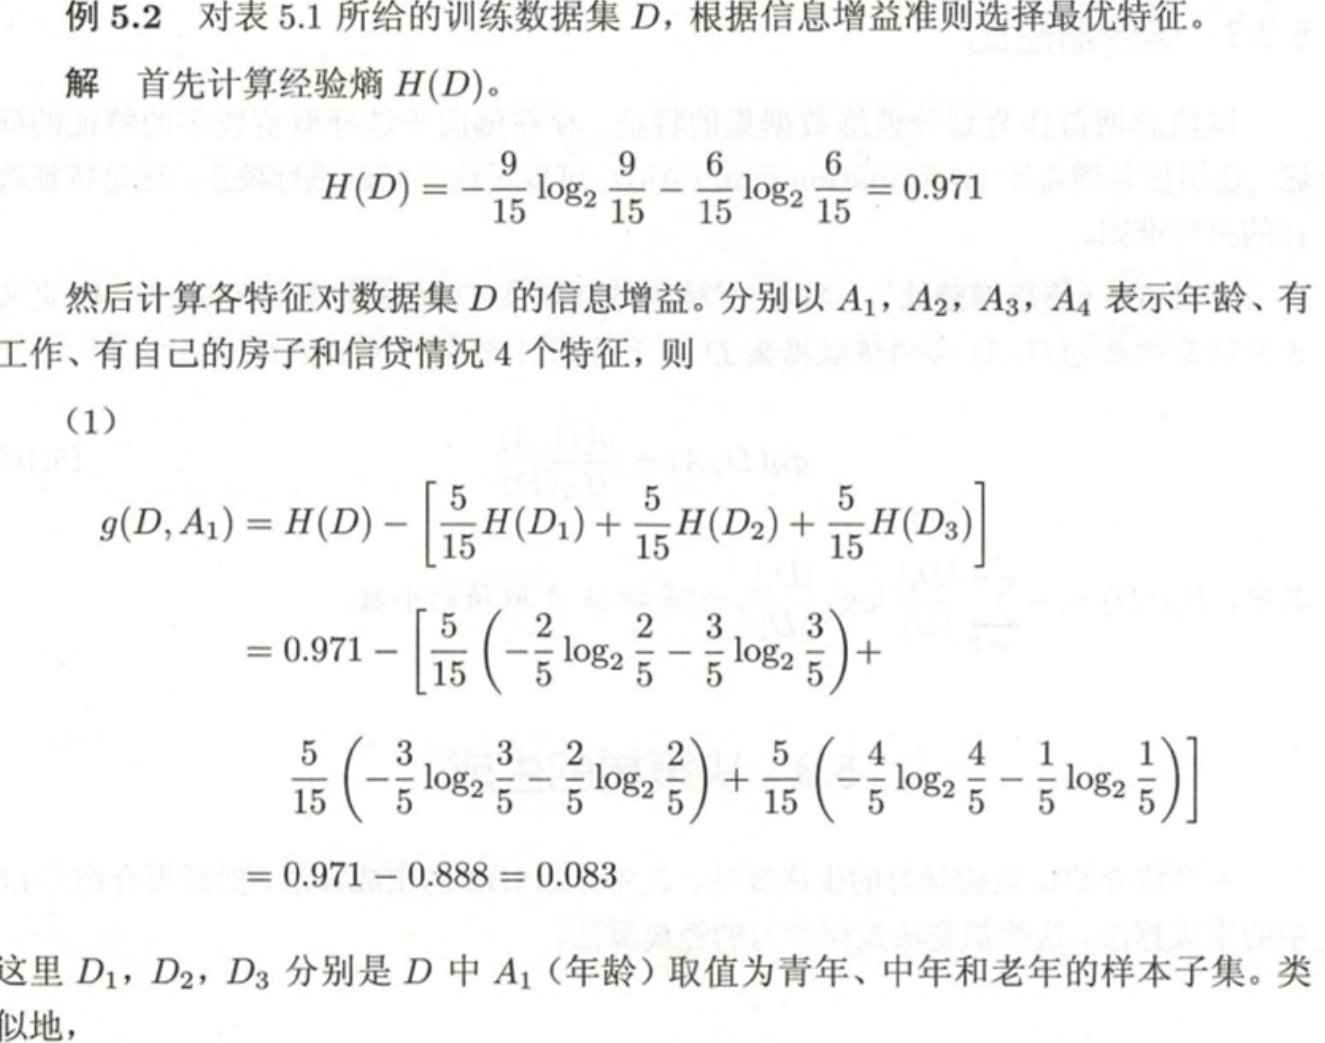
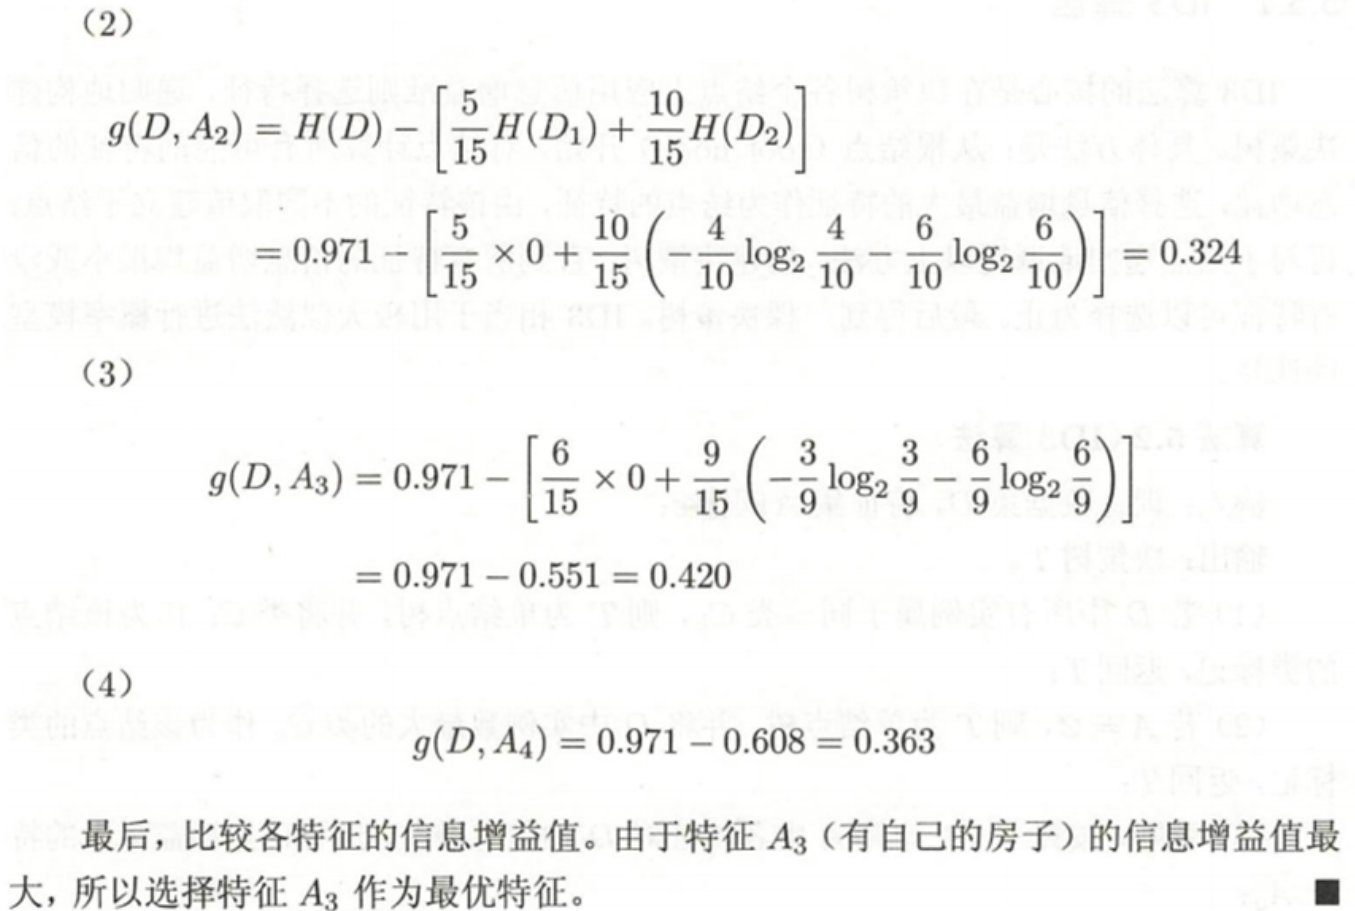
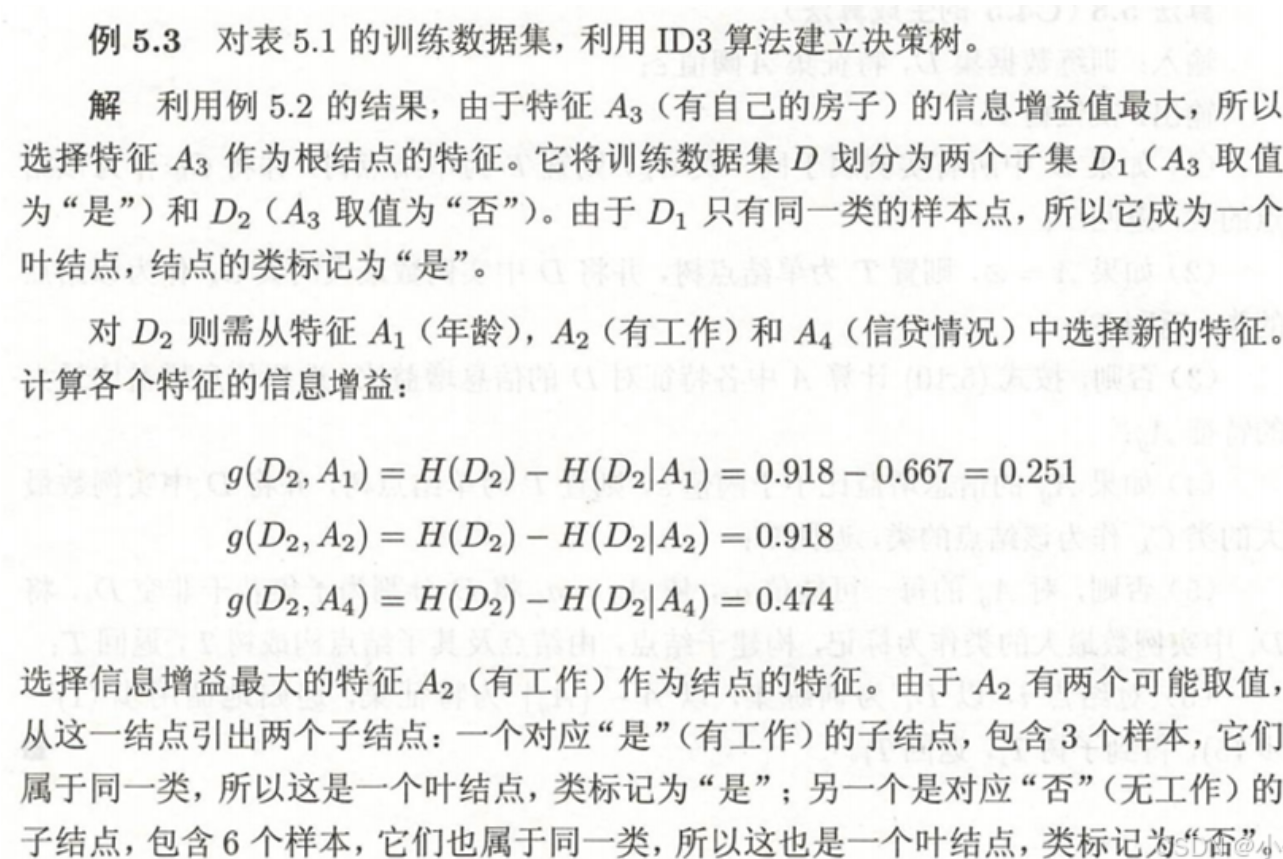

采用信息增益比来选择特征,可以消除选择取值数量不同的影响,生成的步骤与ID3算法一致
CART算法
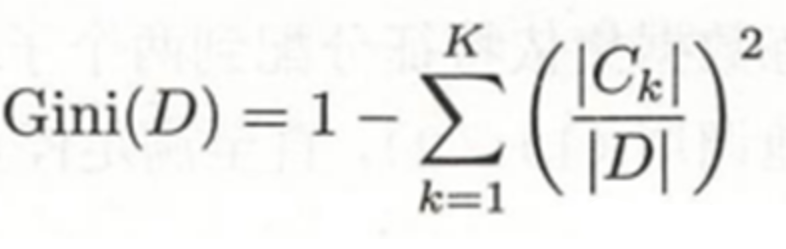
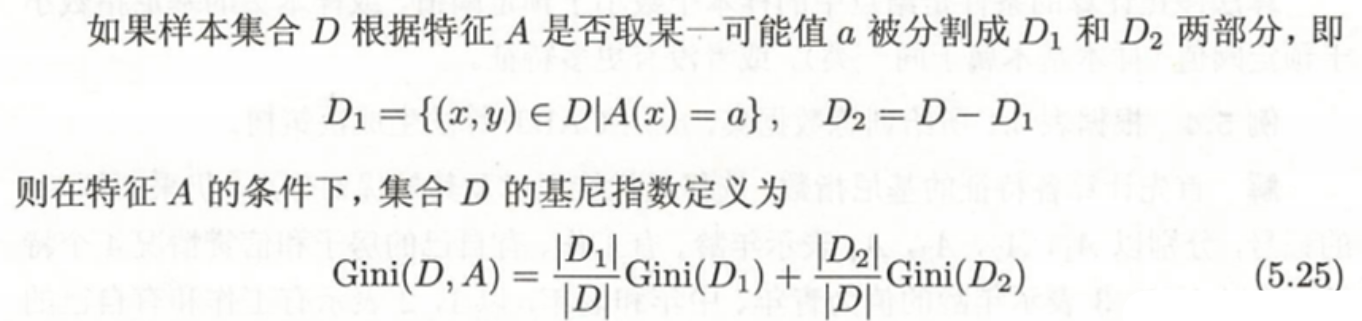 生成步骤类似ID3,但选择特征的标准从信息增益更大变为选择基尼系数更小的
当CART是分类树时,采用GINI值作为节点分裂的依据;当CART是回归树时,采用样本的最小方差作为节点分裂的依据
ID3和C4.5在每个结点上可以产生多个分支,而CART每个结点只会产生两个分支
C4.5通过引入信息增益比,弥补了ID3在特征取值比较多时,由于过拟合造成泛化能力变弱的缺陷
ID3只能处理离散型变量,而C4.5和CART可以处理连续型变量
ID3和C4.5只能用于分类任务,而CART可以用于分类和回归任务
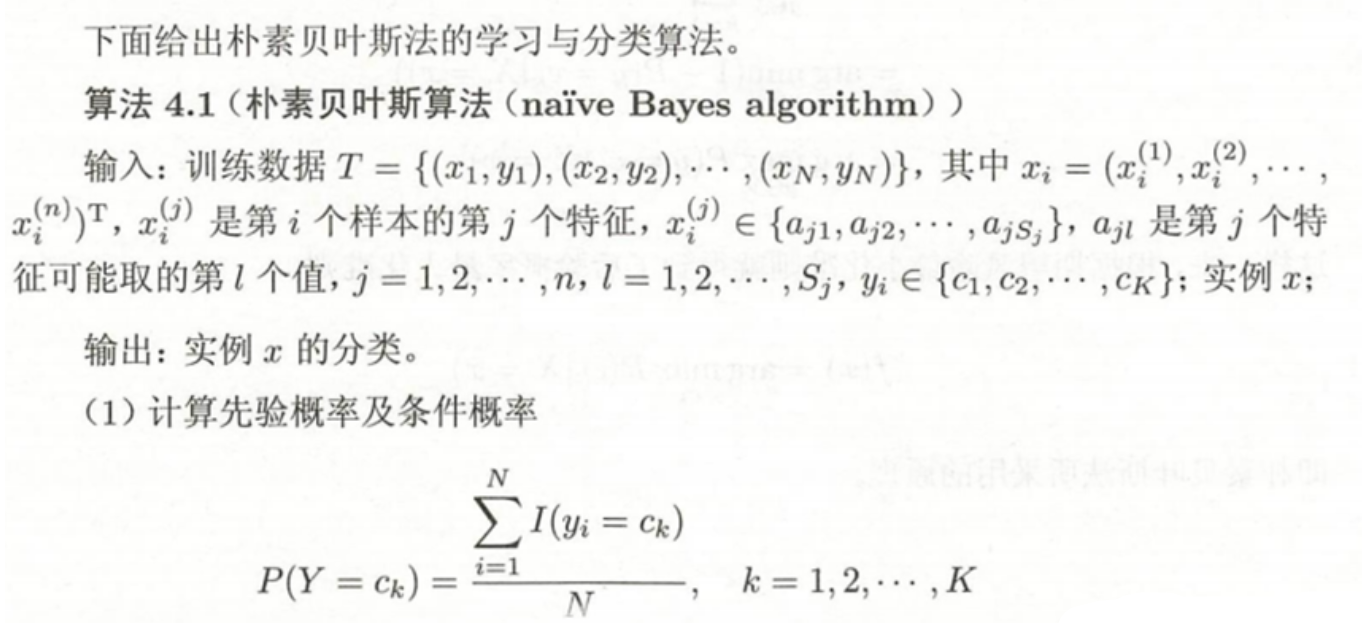
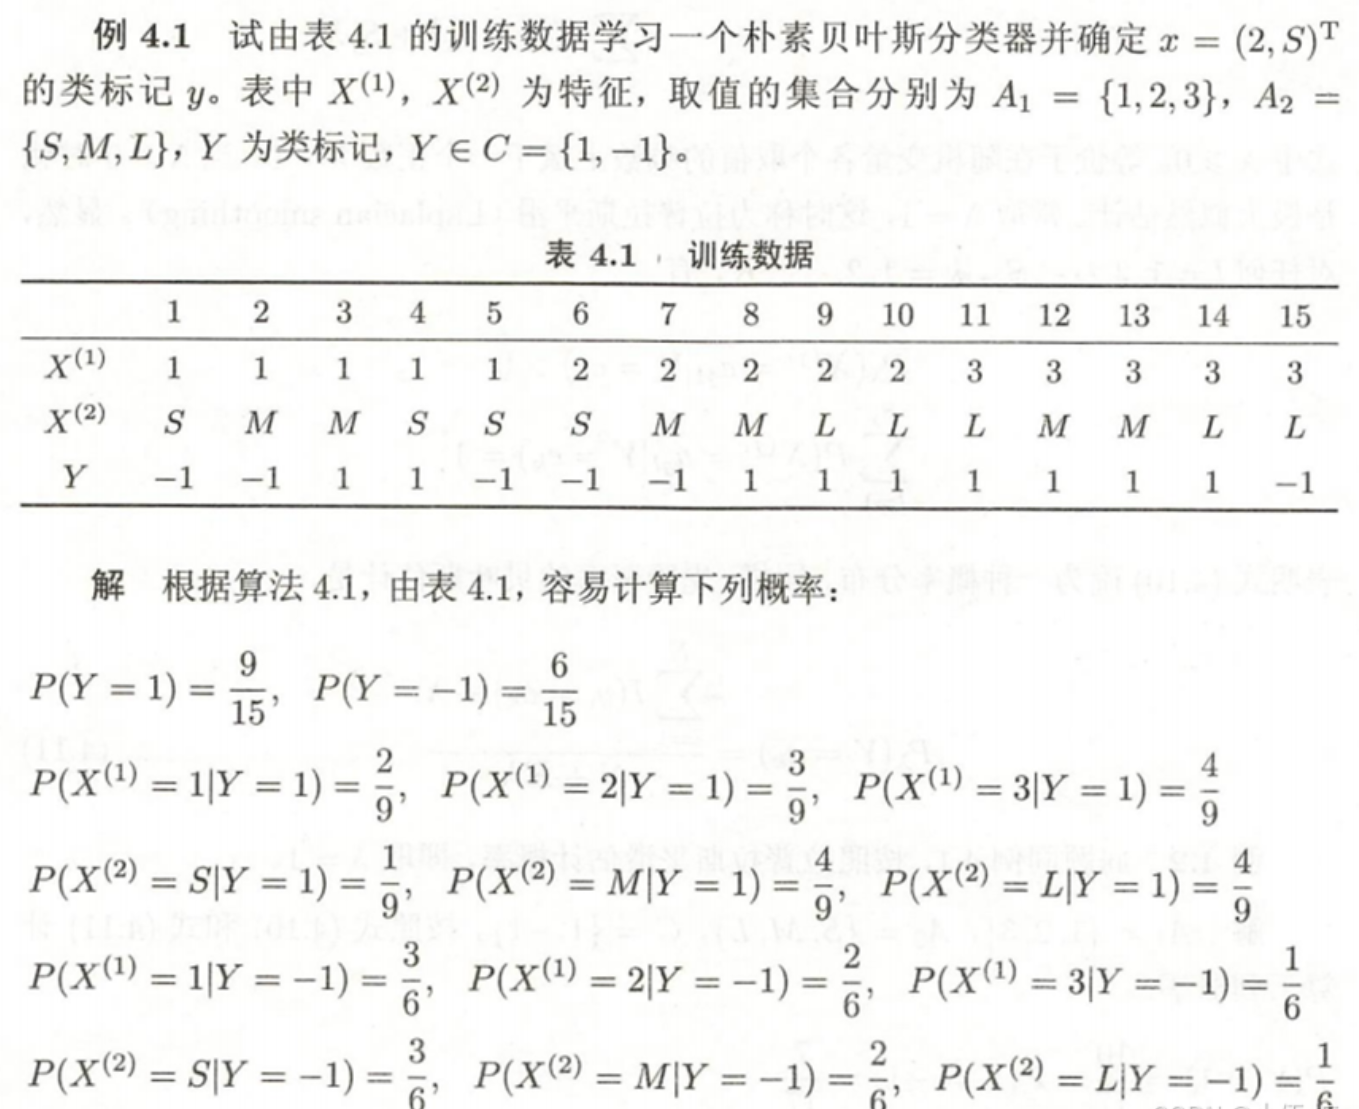
Naive Bayes算法
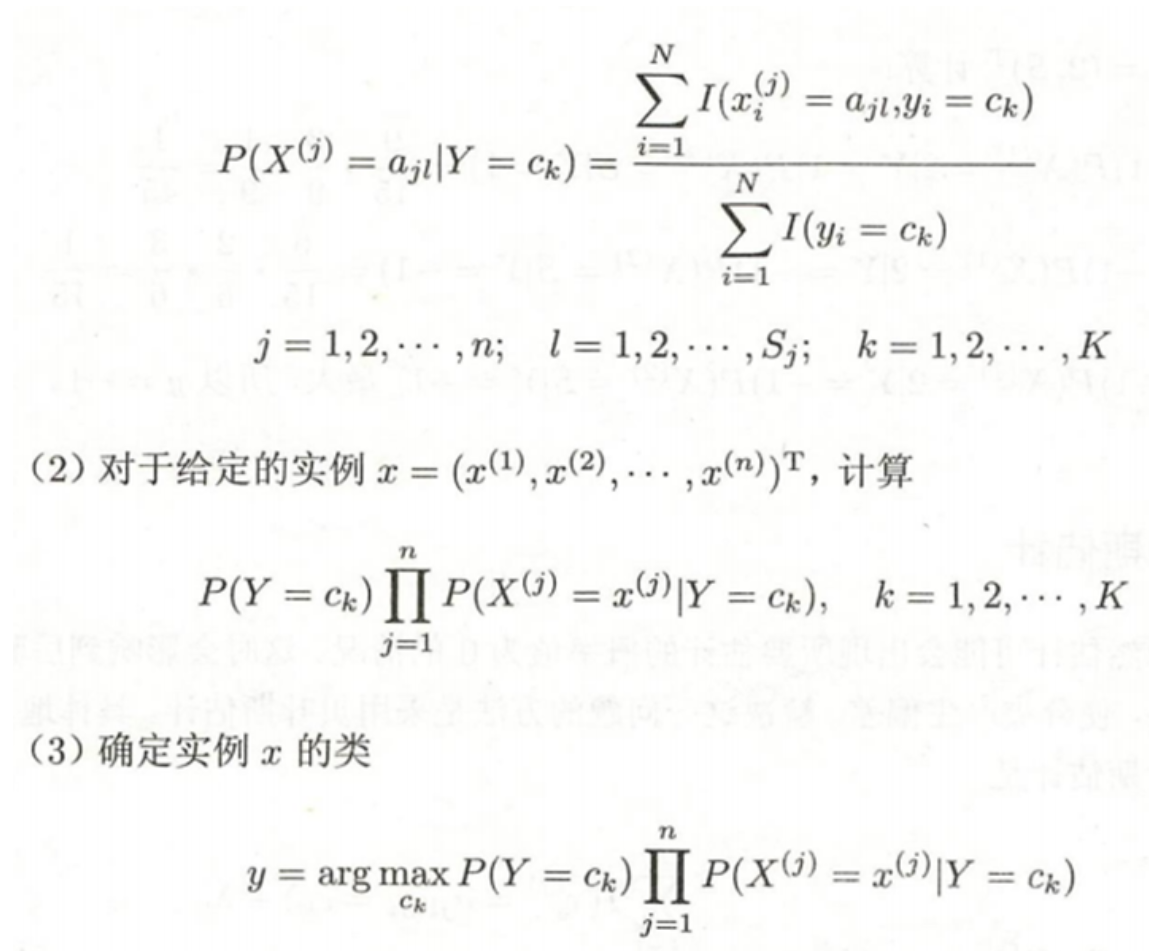
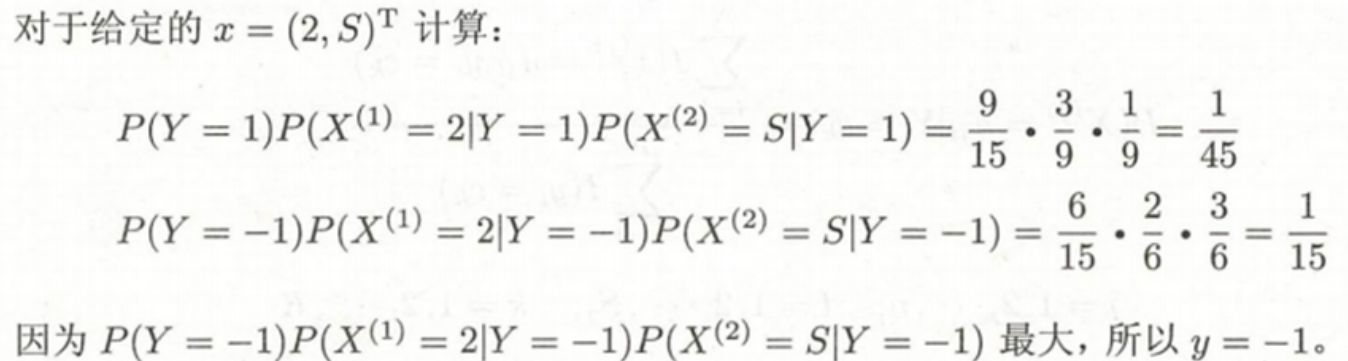
KNN算法
根据距离函数计算待分类样本X和每个训练样本的距离(作为相似度),选择与待分类样本距离最小的K个样本作为X的K个最邻近,最后以X的K个最邻近中的大多数所属的类别作为X的类别。
KNN算法的时间复杂度和存储空间会随着训练集规模和特征维数的增大而快速增加

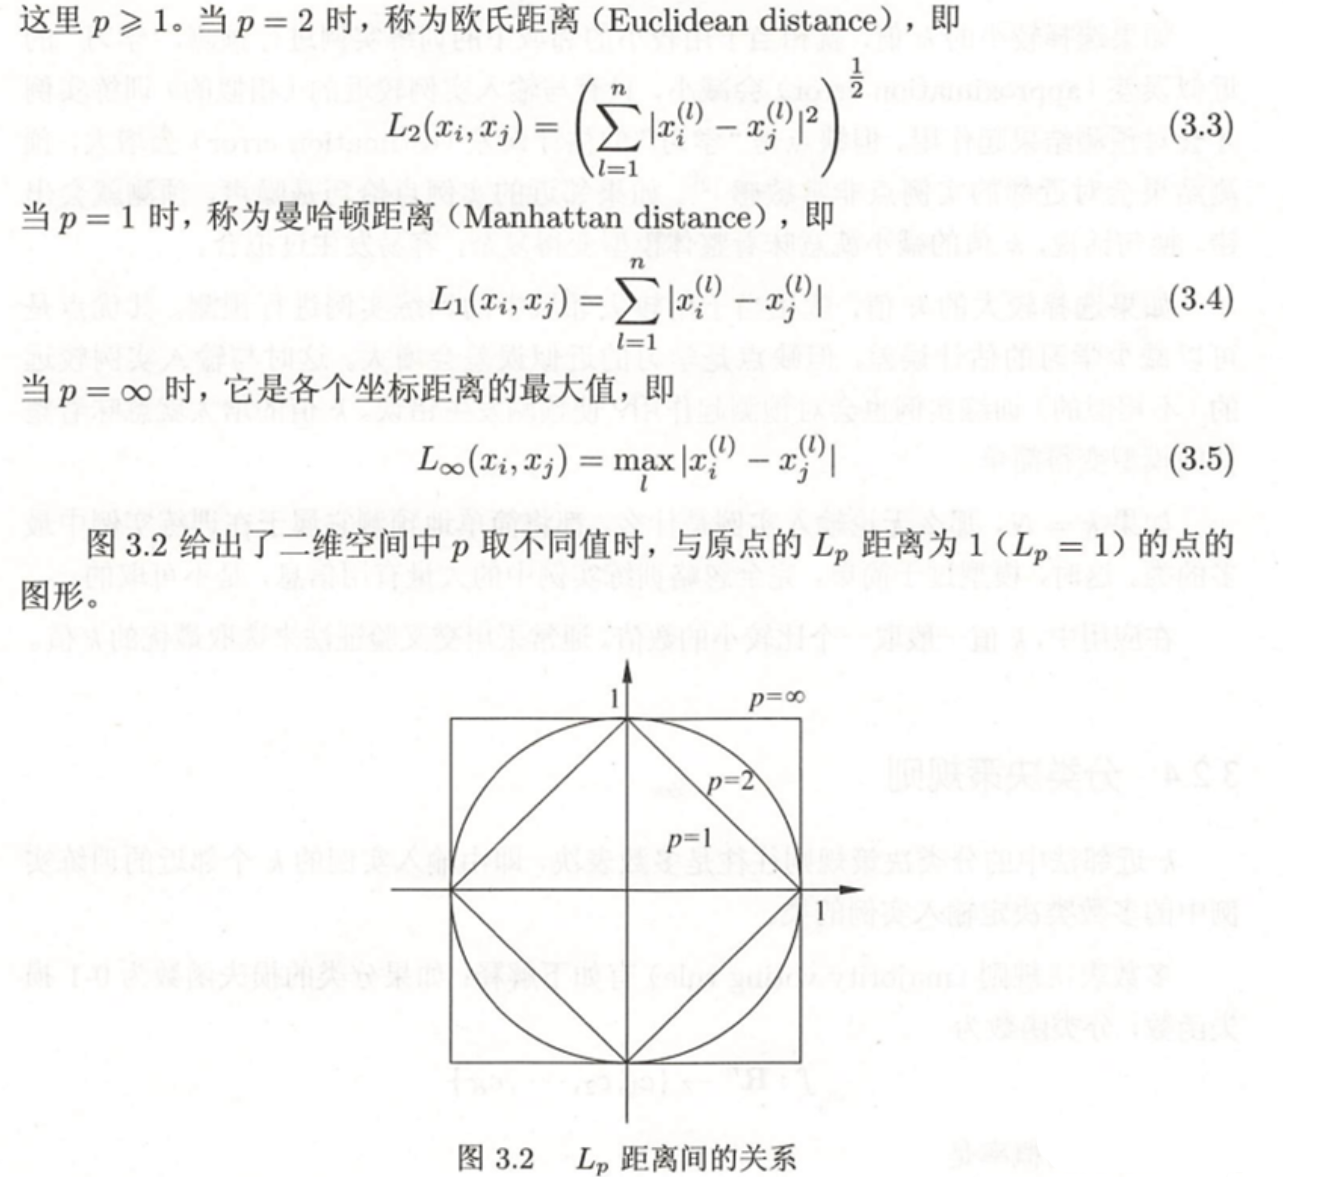
KNN中的分类决策规则往往是多数表决,即由输入实例的k个邻近的训练实例中的多数类决定输入实例的类
#iris数据集的KNN算法实现

from sklearn import datasets

from sklearn.model_selection import train_test_split

from sklearn.neighbors import KNeighborsClassifier

import matplotlib.pyplot as plt


iris = datasets.load iris()

iris_X= iris.data

iris_y= iris.target


X_train, X_test, y_train,y_test = train_test_split(iris_X, iris_y, test_size=0.15)

knn = KNeighborsClassifier()

knn.fit(X_train,y_train)

print(knn.predict(X_test))    #训练后预测结果

print(y_test)    #真实的结果

plt.plot(X_test,y_test)

plt.show()
算法性能评价指标体系
为了简化和统一考虑分类问题,我们假设分类目标只有两类,正例(positive)和负例(negtive)。则分类器的分类结果可能有四种情况,分别是:
(1)True Positives(TP):预测为正样本,实际也为正样本的特征数;
(2)False Positives(FP):预测为正样本,实际为负样本的特征数(错预测为正样本了,所以叫False);
(3)True Negatives(TN):预测为负样本,实际也为负样本的特征数;
(4)False Negatives(FN):预测为负样本,实际为正样本的特征数(错预测为负样本了,所以叫False)
混淆矩阵:是分析分类器识别不同类元组的一种有用工具。它是一种特定的矩阵用来呈现算法性能的可视化效果,通常是监督学习。其每一列代表预测值,每一行代表的是实际的类别。这个名字来源于它可以非常容易的表明多个类别是否有混淆(也就是一个class被预测成另一个class)。混淆矩阵的结构为:
正确率是我们最常见的评价指标,分类器对整个样本的判定能力,即将正的判定为正,负的判定为负;
accuracy = (TP+TN)/(P+N)
即被分对的样本数除以所有的样本数,通常来说,正确率越高,分类器越好。
error rate = (FP+FN)/(P+N)
对某一个实例来说,分对与分错是互斥事件,所以
accuracy = 1 - error rate
c) 灵敏度(sensitive)
表示的是所有正例中被分对的比例,衡量了分类器对正例的识别能力。
sensitive = TP/P
d) 特效度(specificity)
表示的是所有负例中被分对的比例,衡量了分类器对负例的识别能力。
specificity = TN/N
e) 精度(precision)
精度是较精确性的度量,表示被分为正例的实例中实际为正例的比例。
precison = TP/(TP+FP)
f) 召回率(recall)
recall = TP/(TP+FN)=TP/P=sensitive
可以看到召回率与灵敏度是一样的。
Precision和Recall的调和平均值,更接近于P, R两个数较小的那个;
F1 = 2P*R/(P+R)
其中:P为精确率,R为召回率
分类器性能的表示方法类似于信息检索系统的评价方法,可以采用ROC(Receiver Operating Characteristic)曲线、AUC(Area Under ROC Curve, ROC曲线下的面积)、混淆矩阵等。
在ROC中使用的两个指标为真正率(TPR)和假正率(FPR),ROC曲线的横坐标为假正率,纵坐标为真正率。所以一个好的分类模型应该尽可能靠近左上角,而一个随机猜测模型应位于连接(0,0)和(1,1)这两个点的主对角线上。
AUC是处于ROC曲线下方那部分区域的面积。通常AUC的值为0.5到1.0,较大的AUC值代表较好的性能。随机猜测模型的AUC=0.5。
混淆矩阵:假设有m个类,则混淆矩阵是一个m×m的矩阵,显然,最好的分类结果对应的混淆矩阵是对角线以外的值都是0。
随机划分数据集,将原始样本数据随机分为两组:训练集和测试集(也叫验证集),通常按照3:1的比例划分,其中3/4的数据集作为训练集用于模型的建立,1/4数据集作为测试集用于测试所建立模型的性能,把测试结果作为此Hold-Out Method下分类器的性能指标。
交叉验证 (Cross-Validation,CV) 是用来验证分类器的性能一种统计分析方法,基本思想是把在某种意义下将原始数据划分为训练集和测试集(也叫验证集), 每个数据记录既有作为训练集,又有作为测试集。
交叉验证的基本过程是:首先用训练集对分类器进行训练得到分类器模型,利用测试集来测试训练得到的分类器模型(model),以此来做为评价分类器的性能指标。常见交叉验证的方法如下:
Ÿ 将数据集划分成K份,每次是其中的k-1份作为训练集建立模型,剩余的1份作为测试集检测模型性能,共执行K次性能测试, 平均K次测试结果或者使用其它结合方式,最终得到一个单一估测值作为最终模型的性能。常用的是10折交叉检验,工程中一般还需要进行多次10折交叉验证求均值。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 20
 0
- 0


 已为社区贡献7条内容

所有评论(0)