大数据集群架构hadoop集群、Hbase集群、zookeeper、kafka、spark、flink、doris、dataease(一)
hadoop集群部署
部署环境
192.168.81.128 centos7.9 master-1
192.168.81.129 centos7.9 slave-1
192.168.81.130 centos7.9 slave-2
systemctl stop firewalld && systemctl disable firewalld && setenforce 0 关闭防火墙
vim /etc/selinux/config
SELINUX=disabled selinux开机不自启
分别修改主机名
hostnamectl set-hostname master-1
hostnamectl set-hostname slave-1
hostnamectl set-hostname slave-2
jdk1.8
首先部署jdk1.8版本,大于1.8可能会出现很多bug所有机器都装
wget -c https://download.java.net/openjdk/jdk8u44/ri/openjdk-8u44-linux-x64.tar.gz
tar xf openjdk-8u44-linux-x64.tar.gz -C /data
mv /data/java-se-8u44-ri/ /data/java
echo '
JAVA_HOME=/data/java
PATH=$JAVA_HOME/bin:$PATH
export JAVA_HOME PATH
' >> /etc/profile
source /etc/profile
java -version
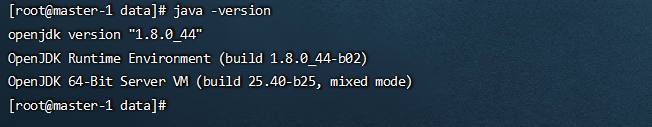
集群之间需要免密登录,避免每次启动都输入从节点密码。
三台节点都做
vim /etc/hosts 配置hosts文件
192.168.81.128 master-1
192.168.81.129 slave-1
192.168.81.130 slave-2
三台节点都做
ssh-keygen -t rsa 生成秘钥
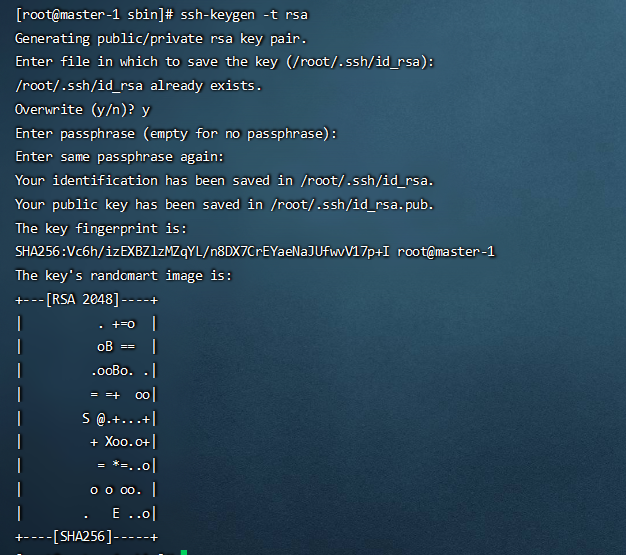
Master操作
ssh-copy-id -i 192.168.81.129
ssh-copy-id -i 192.168.81.130
Slave-1操作
ssh-copy-id -i 192.168.81.128
ssh-copy-id -i 192.168.81.130
Slave-2操作
ssh-copy-id -i 192.168.81.128
ssh-copy-id -i 192.168.81.129
Master-1节点操作
下载hadoop
wget -c https://dlcdn.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6.tar.gz
tar xf hadoop-3.3.6.tar.gz -C /data/ && mv /data/hadoop-3.3.6/ /data/hadoop
配置环境变量
vim /etc/profile
export HADOOP_HOME=/data/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
source /etc/profile
修改配置文件,在master-1操作
vim /data/hadoop/etc/hadoop/hadoop-env.sh
在文件最下面添加
export JAVA_HOME=/data/java
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
export YARN_PROXYSERVER_USER=root
vim /data/hadoop/etc/hadoop/yarn-env.sh
export JAVA_HOME=/data/java
export HADOOP_CONF_DIR=/data/hadoop/etc/hadoop #Hadoop 配置文件目录
vim /data/hadoop/etc/hadoop/core-site.xml
<!-- 设置默认文件系统Hadoop支持file、HDFS、GFS、ALI|Amazon云等文件系统-->
<property>
<name>fs.defaultFS</name>
<value>hdfs://master-1:9000</value>
</property>
<!-- Hadoop的临时目录路径。Hadoop会将一些临时文件保存在这个路径下-->
<property>
<name>hadoop.tmp.dir</name>
<value>/data/hadoop/tmp</value>
</property>
vim /data/hadoop/etc/hadoop/hdfs-site.xml
<!--设置SNN进程运行机器位置信息-->
<property>
<name>dfs.namenode.secondary.http-address</name>
<value>slave-1:9868</value>
</property>
<!-- 指定 NameNode 的持久化存储位置,保证在系统重启后可以恢复 HDFS 的元数据。-->
<property>
<name>dfs.namenode.name.dir</name>
<value>file:///data/hadoop/tmp/hdfs/name</value>
</property>
<!-- DataNode 存储文件数据的目录,确保 DataNode 能够正确保存和读取数据块。-->
<property>
<name>dfs.datanode.data.dir</name>
<value>file:///data/hadoop/tmp/hdfs/data</value>
</property>
创建存储目录
mkdir /data/hadoop/tmp/hdfs/name -p && mkdir /data/hadoop/tmp/hdfs/data -p
vim /data/hadoop/etc/hadoop/mapred-site.xml
<!--设置MR程序默认运行模式: yarn集群模式 local本地模式-->
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<!--指定了 MapReduce 作业历史服务的地址。可以查看 MapReduce 作业的历史信息 -->
<property>
<name>mapreduce.jobhistory.address</name>
<value>master-1:10020</value>
</property>
<!--JobHistory Web 的地址可以通过浏览器查看作业历史信息的图形化界面-->
<property>
<name>mapreduce.jobhistory.webapp.address</name>
<value>master:19888</value>
</property>
<!--指向 Hadoop 安装目录 确保 ApplicationMaster 能够找到并正确使用 Hadoop 的配置文件和资源-->
<property>
<name>yarn.app.mapreduce.am.env</name>
<value>HADOOP_MAPRED_HOME=/usr/local/hadoop</value>
</property>
<!--确保 Mapper 进程能够正确地找到 Hadoop 的安装目录,以便加载相关的 Hadoop 配置和资源-->
<property>
<name>mapreduce.map.env</name>
<value>HADOOP_MAPRED_HOME=$HADOOP_HOME</value>
</property>
<!--确保 Reducer 进程能够正确地找到 Hadoop 的安装目录,以便加载相关的 Hadoop 配置和资源-->
<property>
<name>mapreduce.reduce.env</name>
<value>HADOOP_MAPRED_HOME=$HADOOP_HOME</value>
</property>
vim /data/hadoop/etc/hadoop/yarn-site.xml
<!-- 启用 MapReduce 的 shuffle 服务 -->
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<!-- 指定ResourceManager的地址-->
<property>
<name>yarn.resourcemanager.hostname</name>
<value>master-1</value>
</property>
<!--指定Yarn调度器FairScheduler 会根据每个作业和应用的资源需求动态调整资源的分配-->
<property>
<name>yarn.resourcemanager.scheduler.class</name> <value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.FairScheduler</value>
</property>
vim /data/hadoop/etc/hadoop/workers
#集群所有从节点地址一主两从就不需要加主节点
slave-1
slave-2
配置好所有文件之后把配置好的目录发送到另外两台节点
scp -r /data/hadoop/ slave-1:/data/
scp -r /data/hadoop/ slave-2:/data/
scp -r /data/java/ slave-1:/data/
scp -r /data/java/ slave-2:/data/
scp /etc/profile slave-1:/etc/profile
scp /etc/profile slave-2:/etc/profile
发送完成后在主节点格式化hdfs 格式化操作会清空 HDFS 的元数据存储目录
hdfs namenode -format
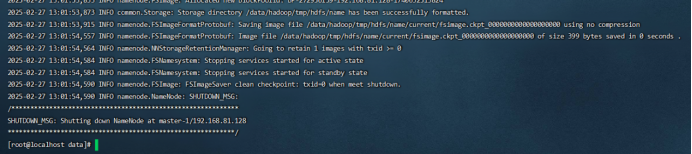
start-all.sh 启动hadoop集群
Master节点启动报错,这是本机没有免密
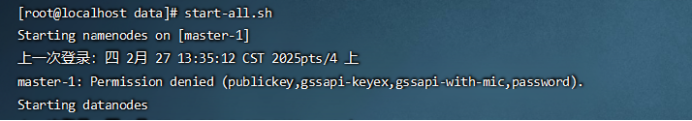
cat /root/.ssh/id_rsa.pub >> /root/.ssh/authorized_keys
生成完免密文件在重新启动就行了start-all.sh

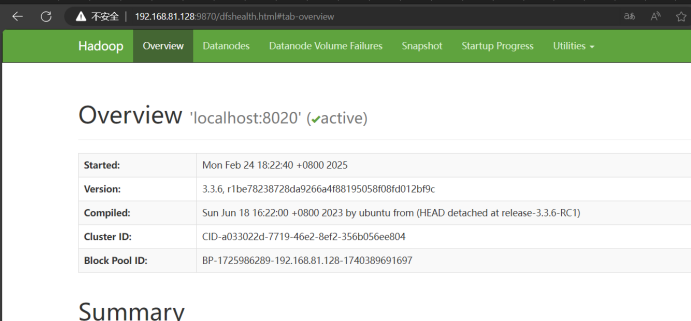
启动后web访问
Hdfs http://192.168.81.128:9870/
Yarn 访问 http://192.168.81.128:8088/

hadoop集群到这就部署完成了。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 8
 0
- 0


 已为社区贡献12条内容

所有评论(0)