大数据集群架构hadoop集群、Hbase集群、zookeeper、kafka、spark、flink、doris、dataease(五)
spark集群部署
spark下载地址
wget -c https://dlcdn.apache.org/spark/spark-3.5.4/spark-3.5.4-bin-hadoop3-scala2.13.tgz
tar -xf spark-3.5.4-bin-hadoop3-scala2.13.tgz -C /data/
mv /data/spark-3.5.4-bin-hadoop3-scala2.13/ /data/spark
vim /etc/profile 配置环境变量
export SPARK_HOME=/data/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
source /etc/profile
cd /data/spark/conf
cp spark-defaults.conf.template spark-defaults.conf
cp spark-env.sh.template spark-env.sh
cp log4j2.properties.template log4j.properties
vim spark-env.sh 添加参数
export JAVA_HOME=/data/java
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export SPARK_MASTER_HOST=192.168.81.128
export SPARK_MASTER_PORT=7077
vim spark-defaults.conf
spark.master spark://192.168.81.128:7077
spark.serializer org.apache.spark.serializer.KryoSerializer
spark.driver.memory 1g
vim slaves
192.168.81.128
192.168.81.129
192.168.81.130
配置完成后发送到其他节点
scp -r /data/spark/ slave-1:/data/
scp -r /data/spark/ slave-2:/data/
scp /etc/profile slave-1:/etc/profile
scp /etc/profile slave-2:/etc/profile
因为启动命令跟hadoop冲突,我们用绝对路径进行启动
/data/spark/sbin/start-all.sh 启动命令

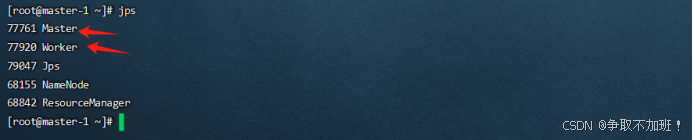
启动后jps查看进程
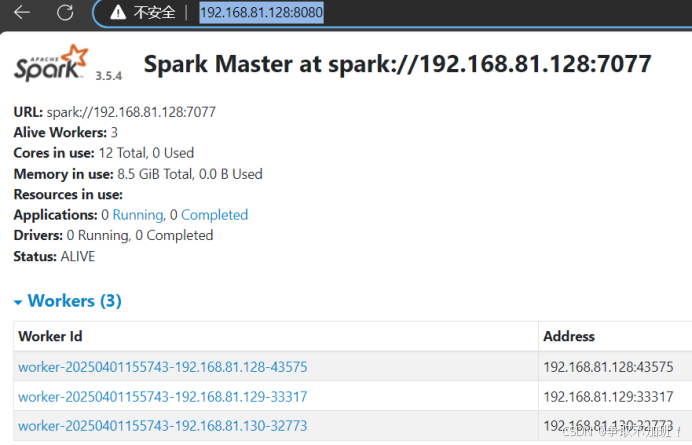
 Web访问192.168.81.128:7077 后面访问就要用8080端口了。
/data/spark/sbin/stop-all.sh 停止命令
部署完成后可以使用spark提供的jar进行测试位置在/data/spark/examples
spark-submit --class org.apache.spark.examples.SparkPi --master spark://192.168.81.128:7077 /data/spark/examples/jars/spark-examples_2.13-3.5.4.jar
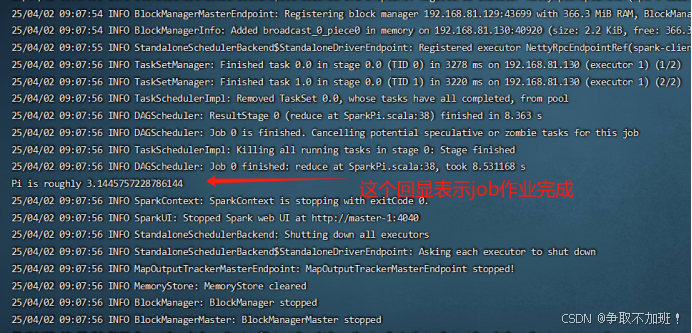
部署完成。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 6
 0
- 0


 已为社区贡献12条内容

所有评论(0)