ubantu18.04配置hadoop集群及测试完整教程(二)
·
说明:本文图片较多,耐心等待加载。(建议用电脑)
注意所有打开的文件都要记得保存。
第六步:配置集群/分布式环境(继续上回的操作)
我们继续在Master主机终端依次输入下面代码
cd /usr/local
sudo rm -r ./hadoop/tmp     # 删除 Hadoop 临时文件
sudo rm -r ./hadoop/logs/*   # 删除日志文件
tar -zcf ~/hadoop.master.tar.gz ./hadoop   # 先压缩再复制
cd ~
scp ./hadoop.master.tar.gz Slave1:/home/hadoop
注意第四行代码需要等待一会儿。
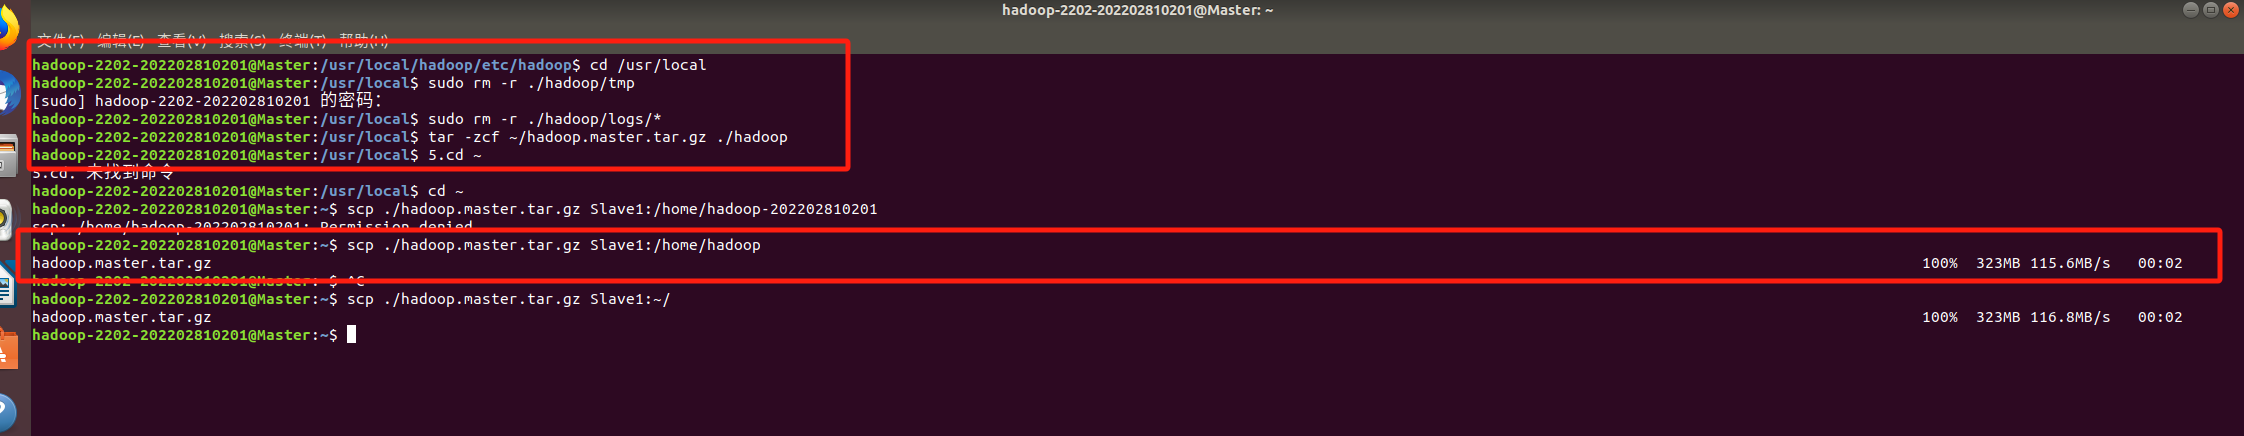
出现以上界面极为成功。
然后来到从机Slave1终端输入
-
sudo rm -r /usr/local/hadoop    # 删掉旧的(如果存在)
sudo tar -zxf ~/hadoop.master.tar.gz -C /usr/local
sudo chown -R hadoop-2202-202202810201 /usr/local/hadoop
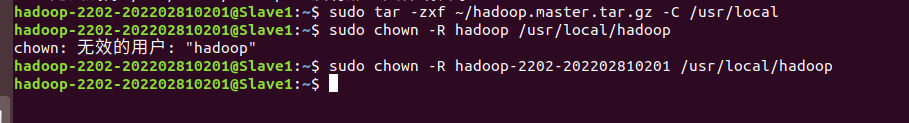
注意上面是自己的用户名,记得修改。
第七步:启动Hadoop集群
再Master主机终端输入
1.先格式化
hdfs namenode -format
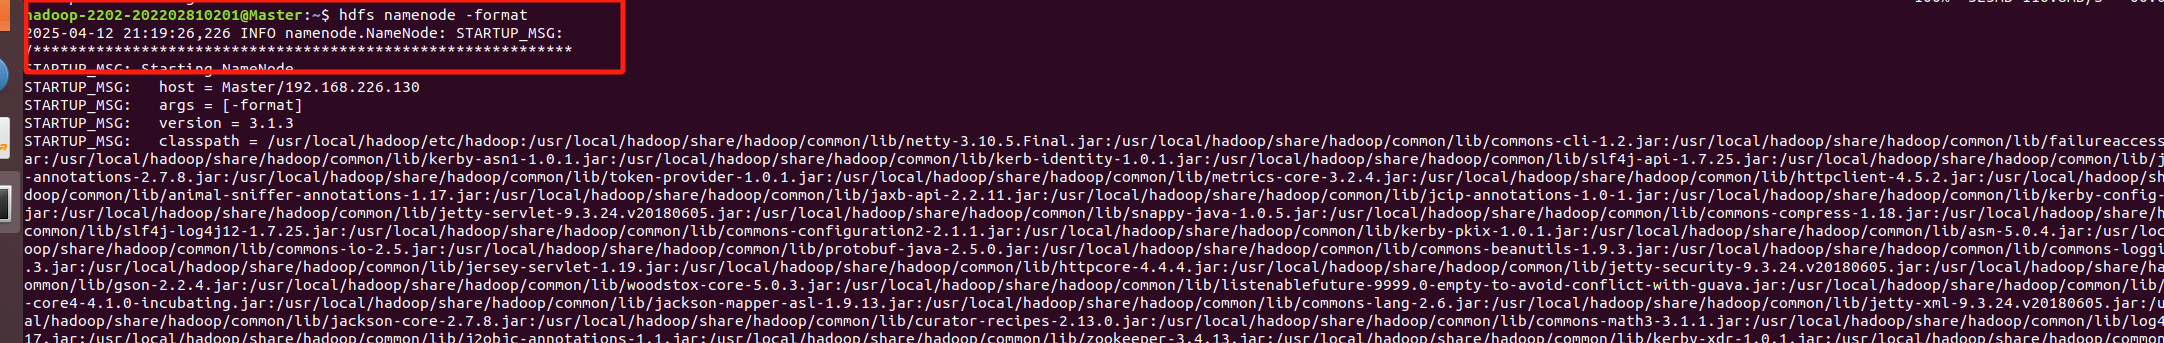
2.启动
start-dfs.sh
start-yarn.sh
mr-jobhistory-daemon.sh start historyserver
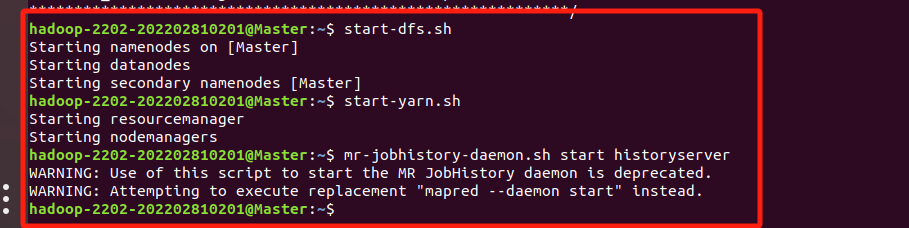
3.查看是否成功启动
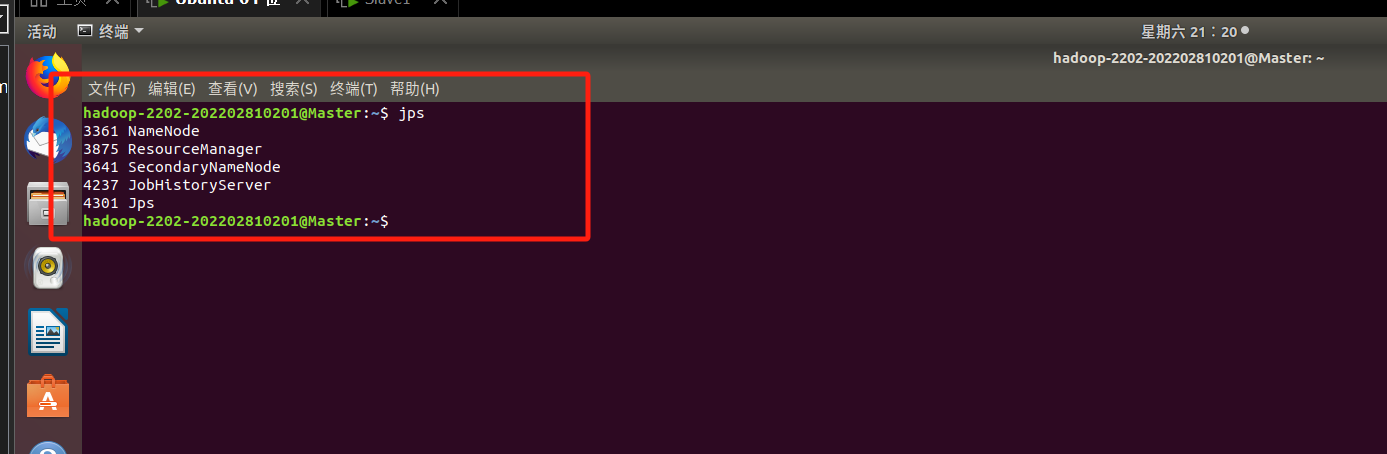
再终端输入jps,出现如下界面成功
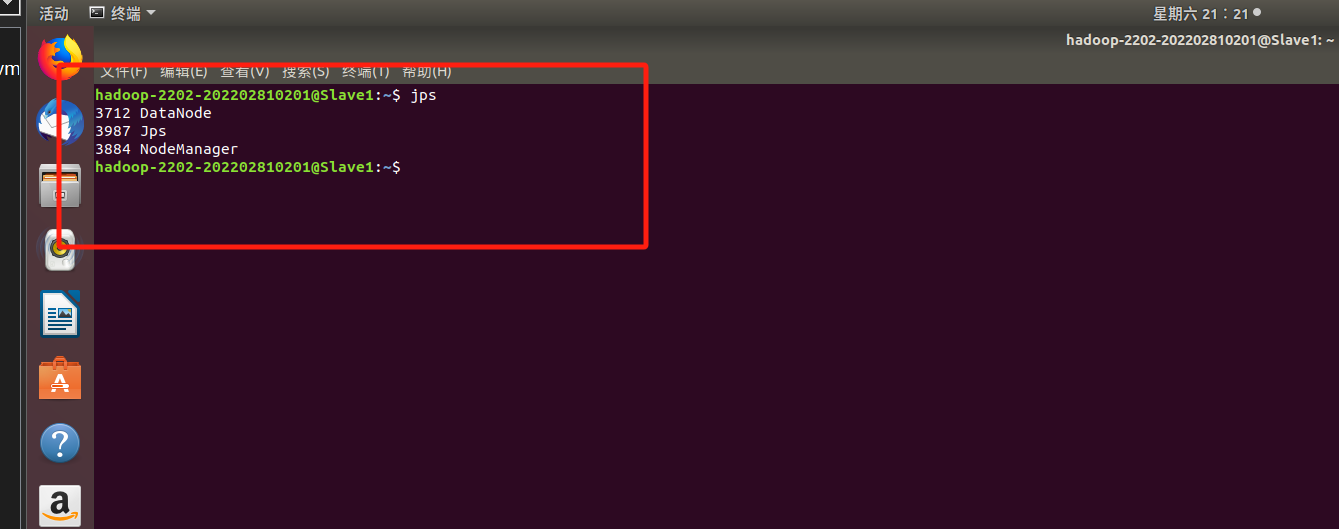
再去Slave1终端输入jps,出现如下界面成功
4.查看数据节点是否正常启动
再Master主机终端输入,出现如下界面成功
hdfs dfsadmin -report

第八步: 执行分布式实例
以下操作都在Master输入
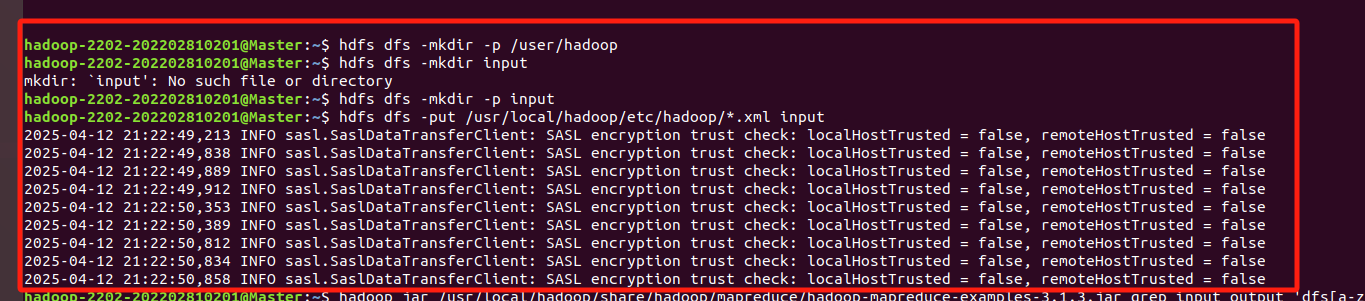
1.要使用 HDFS,首先创建HDFS上的用户目录
hdfs dfs -mkdir -p /user/hadoop
hdfs dfs -mkdir input
hdfs dfs -put /usr/local/hadoop/etc/hadoop/*.xml input
如果这里没有出错跳到第二步,以下是报错提醒
mkdir:‘input': No such file or directory
解决方法:
hdfs dfs -mkdir -p input
hdfs dfs -put /usr/local/hadoop/etc/hadoop/*.xml input
2.继续运行以下代码
hadoop jar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar grep input output 'dfs[a-z.]+'
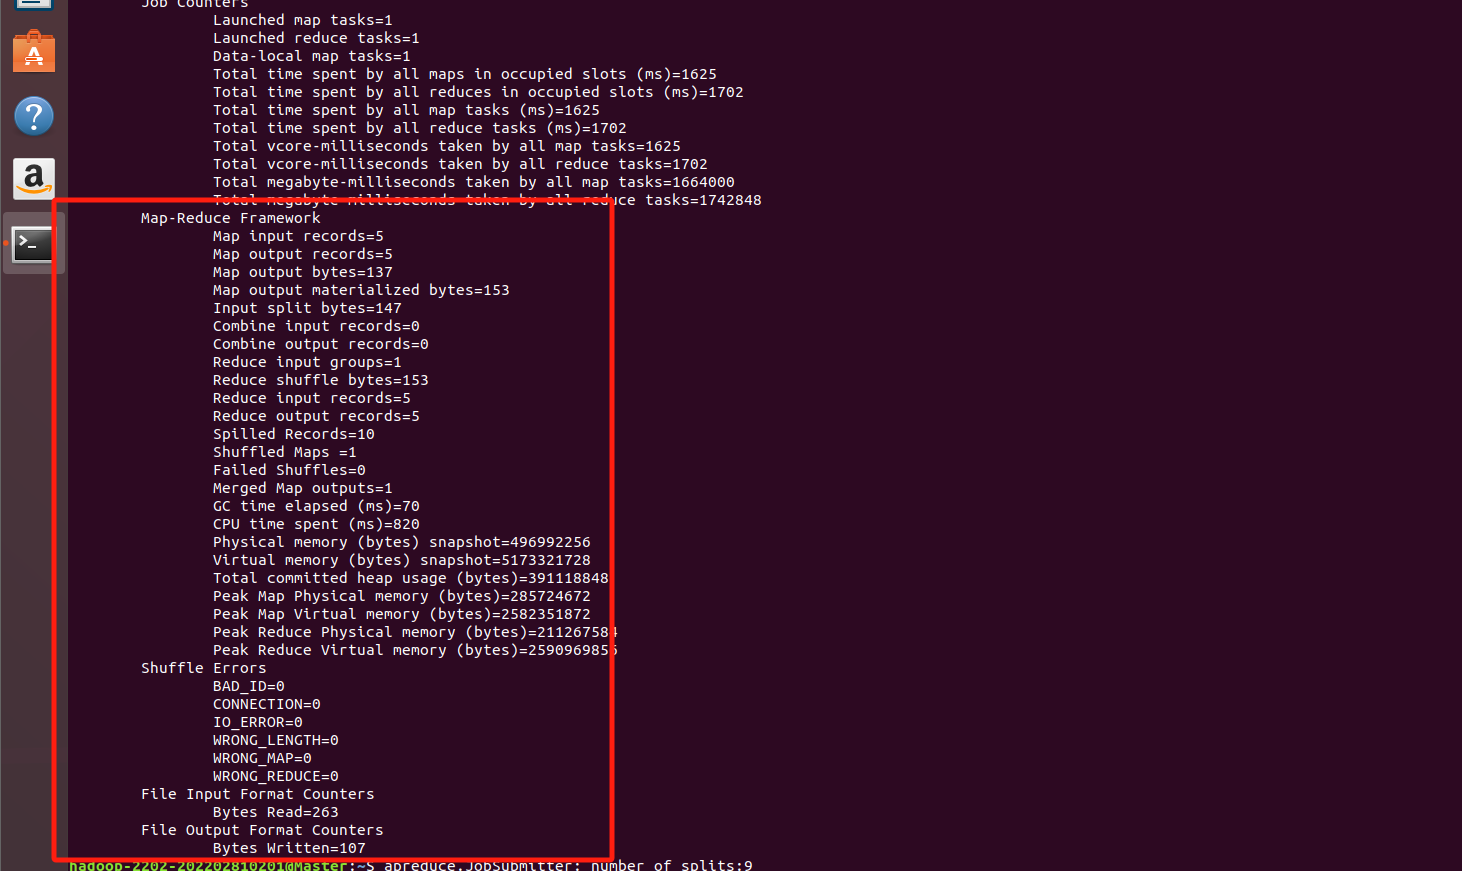
继续输入 我们在来到目录:cd /usr/local/hadoop
cd /usr/local/hadoop
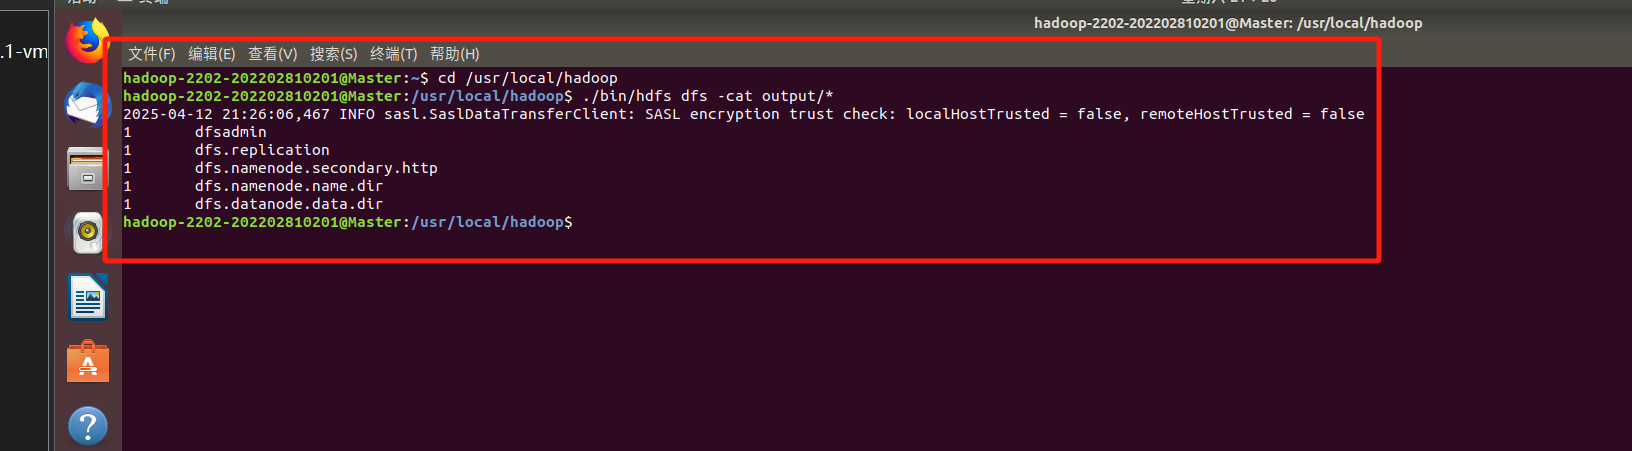
在输入以下命令,查看输出结果。出现我的界面成功。
./bin/hdfs dfs -cat output/*
得到的输出没有问题,就说明成功了!!!
结语:整体的操作步我都给大家写出来,并且截图了,大家只需要无脑粘贴就好了,具体的讲解可以看我的资料里的文档解释更加详细,这个实验就结束了。
上面内容制作不易,喜欢的点个赞和收藏支持一下吧!!
后期会持续更新更多大数据内容,如果想共同学习,就点点关注把(

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 14
 0
- 0


 已为社区贡献2条内容

所有评论(0)