MMPretrain的使用以及训练自己的数据集
在官方下载mmpretrain的压缩包
网址:GitHub - open-mmlab/mmpretrain: OpenMMLab Pre-training Toolbox and Benchmark
点击Code下载zip压缩包

安装 MMPretrain
MMPretrain 是一个基于 PyTorch 的深度学习框架,专注于图像分类任务。要使用 MMPretrain,首先需要安装它。可以通过以下命令安装:
pip install openmim
mim install mmengine
mim install mmcv
mim install mmpretrain
在配置文件中选择自己需要的模型,这里使用的是resnet18_8xb32_in1k.py为基础来定义自己的模型配置文件
文件路径:mmpretrain-main\mmpretrain-main\configs\resnet\resnet18_8xb32_in1k.py
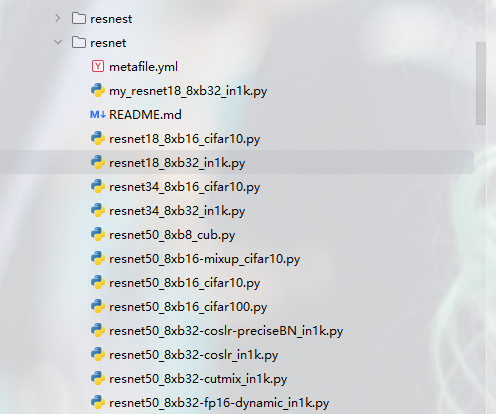
复制resnet18_8xb32_in1k.py文件的路径,打开train.py(位于mmpretrain-main\mmpretrain-main\tools\train.py)输入参数即配置文件的路径来生成一个额外的resnet18_8xb32_in1k.py(位于)文件。
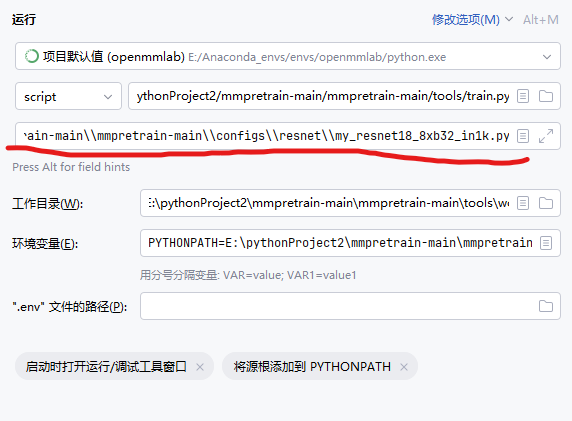
这里我定义为:my_resnet18_8xb32_in1k.py(需要放入和resnet18_8xb32_in1k.py相同的路径中),我将通过生成的my_resnet18_8xb32_in1k.py来进行修改,来进行对于102类花朵的分类。
在my_resnet18_8xb32_in1k.py中将原本的1000类改为102类
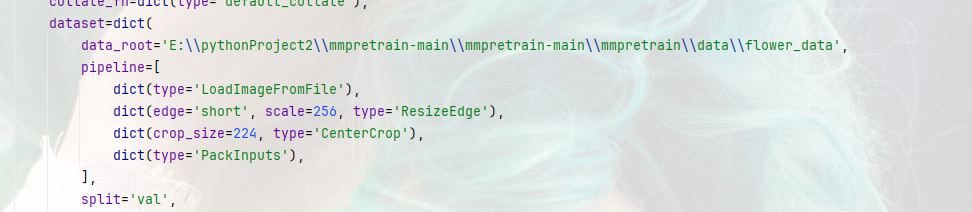
在data_root中输入自己数据集的路径,特备注意名字是否拼写错误
根据datasets中处理imagenet数据集的py文件(位于mmpretrain-main\mmpretrain\datasets\imagenet.py)来改写自己的模型加载代码并放入到和imagenet相同的路径下。
这里我根据imagenet加载文件写了一个myimagenet文件,来进行加载自己的数据集。

需要注意的是from .categories import myFLOWERS102_CATEGORIES,在categories.py中可以定义自己如何加载。
myFLOWERS102_CATEGORIES = tuple(str(i) for i in range(102))最后再次返回自己的my_resnet18_8xb32_in1k.py文件中,在开头添加上自己写的加载数据集路径代码
custom_imports = dict(
 # 路径是自己根据imagenet.py来改写的myimagenet.py
    imports=['mmpretrain.datasets.myimagenet'],
    allow_failed_imports=False
)
训练模型
将自己定义的my_resnet18_8x32_in1k.py路径写入train.py的配置参数中即可对自己定义的模型进行训练。
效果展示:

根据resnet18_8xb32_in1k.py来改写自己的my_resnet18_8x32_in1k.py
代码展示:
custom_imports = dict(
    imports=['mmpretrain.datasets.myimagenet'],  # 路径是你刚才放的那个文件
    allow_failed_imports=False
)

auto_scale_lr = dict(base_batch_size=256)
data_preprocessor = dict(
    mean=[
        123.675,
        116.28,
        103.53,
    ],
    num_classes=102,
    std=[
        58.395,
        57.12,
        57.375,
    ],
    to_rgb=True)
dataset_type = 'Flowers102Dataset'
default_hooks = dict(
    checkpoint=dict(interval=1, type='CheckpointHook'),
    logger=dict(interval=100, type='LoggerHook'),
    param_scheduler=dict(type='ParamSchedulerHook'),
    sampler_seed=dict(type='DistSamplerSeedHook'),
    timer=dict(type='IterTimerHook'),
    visualization=dict(enable=False, type='VisualizationHook'))
default_scope = 'mmpretrain'
env_cfg = dict(
    cudnn_benchmark=False,
    dist_cfg=dict(backend='nccl'),
    mp_cfg=dict(mp_start_method='fork', opencv_num_threads=0))
launcher = 'none'
load_from = None
log_level = 'INFO'
model = dict(
    backbone=dict(
        depth=18,
        num_stages=4,
        out_indices=(3, ),
        style='pytorch',
        type='ResNet'),
    head=dict(
        in_channels=512,
        loss=dict(loss_weight=1.0, type='CrossEntropyLoss'),
        num_classes=102,
        topk=(
            1,
            5,
        ),
        type='LinearClsHead'),
    neck=dict(type='GlobalAveragePooling'),
    type='ImageClassifier')
optim_wrapper = dict(
    optimizer=dict(lr=0.1, momentum=0.9, type='SGD', weight_decay=0.0001))
param_scheduler = dict(
    by_epoch=True, gamma=0.1, milestones=[
        30,
        60,
        90,
    ], type='MultiStepLR')
randomness = dict(deterministic=False, seed=None)
resume = False
test_cfg = dict()
test_dataloader = dict(
    batch_size=32,
    collate_fn=dict(type='default_collate'),
    dataset=dict(
        data_root='E:\\pythonProject2\\mmpretrain-main\\mmpretrain-main\\mmpretrain\\data\\flower_data',
        pipeline=[
            dict(type='LoadImageFromFile'),
            dict(edge='short', scale=256, type='ResizeEdge'),
            dict(crop_size=224, type='CenterCrop'),
            dict(type='PackInputs'),
        ],
        split='val',
        type='Flowers102Dataset'),
    num_workers=5,
    persistent_workers=True,
    pin_memory=True,
    sampler=dict(shuffle=False, type='DefaultSampler'))
test_evaluator = dict(
    topk=(
        1,
        5,
    ), type='Accuracy')
test_pipeline = [
    dict(type='LoadImageFromFile'),
    dict(edge='short', scale=256, type='ResizeEdge'),
    dict(crop_size=224, type='CenterCrop'),
    dict(type='PackInputs'),
]
train_cfg = dict(by_epoch=True, max_epochs=100, val_interval=1)
train_dataloader = dict(
    batch_size=32,
    collate_fn=dict(type='default_collate'),
    dataset=dict(
        data_root='E:\\pythonProject2\\mmpretrain-main\\mmpretrain-main\\mmpretrain\data\\flower_data',
        pipeline=[
            dict(type='LoadImageFromFile'),
            dict(scale=224, type='RandomResizedCrop'),
            dict(direction='horizontal', prob=0.5, type='RandomFlip'),
            dict(type='PackInputs'),
        ],
        split='train',
        type='Flowers102Dataset'),
    num_workers=5,
    persistent_workers=True,
    pin_memory=True,
    sampler=dict(shuffle=True, type='DefaultSampler'))
train_pipeline = [
    dict(type='LoadImageFromFile'),
    dict(scale=224, type='RandomResizedCrop'),
    dict(direction='horizontal', prob=0.5, type='RandomFlip'),
    dict(type='PackInputs'),
]
val_cfg = dict()
val_dataloader = dict(
    batch_size=32,
    collate_fn=dict(type='default_collate'),
    dataset=dict(
        data_root='E:\\pythonProject2\\mmpretrain-main\\mmpretrain-main\\mmpretrain\\data\\flower_data',
        pipeline=[
            dict(type='LoadImageFromFile'),
            dict(edge='short', scale=256, type='ResizeEdge'),
            dict(crop_size=224, type='CenterCrop'),
            dict(type='PackInputs'),
        ],
        split='val',
        type='Flowers102Dataset'),
    num_workers=5,
    persistent_workers=True,
    pin_memory=True,
    sampler=dict(shuffle=False, type='DefaultSampler'))
val_evaluator = dict(
    topk=(
        1,
        5,
    ), type='Accuracy')
vis_backends = [
    dict(type='LocalVisBackend'),
]
visualizer = dict(
    type='Visualizer', vis_backends=[
        dict(type='LocalVisBackend'),
    ])
work_dir = './work_dirs/resnet18_8xb32_flowers102'
总结
MMPretrain 提供了丰富的预训练模型和灵活的配置选项,能够满足大多数图像分类任务的需求。通过合理的配置和训练策略,可以快速构建和训练高性能的图像分类模型tebeizhuyite'bei'zhu'yi,

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 56
 0
- 0


 已为社区贡献1条内容

所有评论(0)