[模型训练]PyTorch CNN实例训练
·
一、项目概述
本文基于 PyTorch 实现一个轻量级卷积神经网络(CNN),完成青苹果与红苹果的二分类任务。通过构建AppleNet模型,演示从数据预处理到模型训练、评估的完整流程,适合深度学习入门者参考。
训练效果如下:
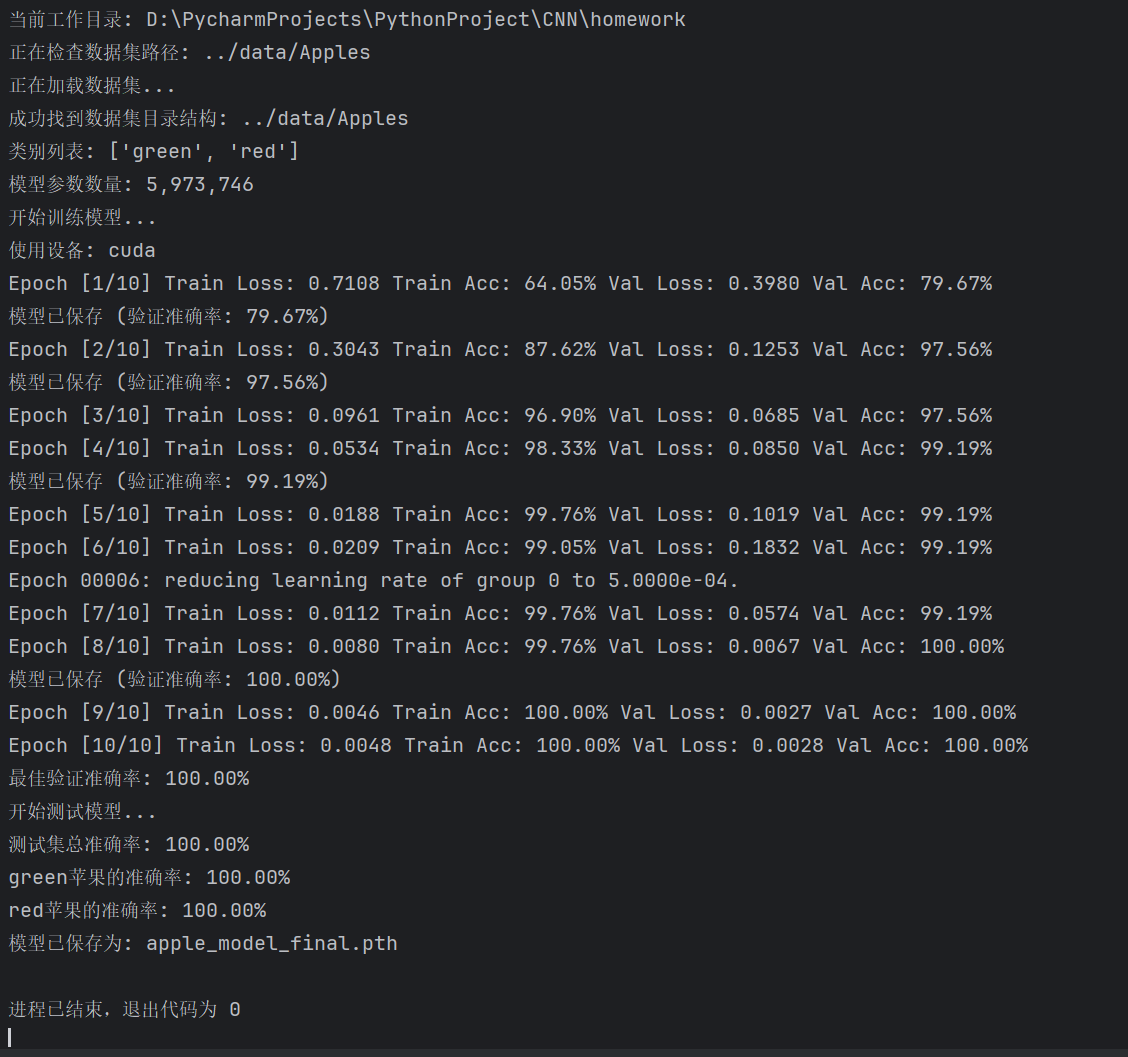
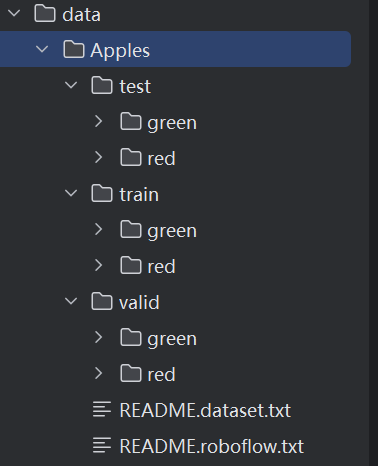
数据集目录:
二、技术框架
核心框架:PyTorch 1.10+
数据处理:torchvision、PIL
硬件支持:CPU/GPU(自动适配)
三、模型设计(AppleNet)
采用两层卷积 + 两层全连接的轻量化结构,平衡性能与计算量:
设计说明:
卷积层通过 3×3 卷积核提取特征,配合 2×2 最大池化降维
全连接层将特征映射到 2 个类别,Dropout 层抑制过拟合
输入图像尺寸为 224×224,经两次卷积池化后特征图尺寸为 54×54
class AppleNet(nn.Module):
    def __init__(self):
        super(AppleNet, self).__init__()
        # 卷积层:提取图像特征
        self.c1 = nn.Conv2d(3, 8, 3, 1)
        self.pool1 = nn.MaxPool2d(2, 2)
        self.c2 = nn.Conv2d(8, 16, 3, 1)
        self.pool2 = nn.MaxPool2d(2, 2)

        # 全连接层:分类决策
        self.l3 = nn.Linear(16 * 54 * 54, 128)
        self.dropout = nn.Dropout(0.5)
        self.l4 = nn.Linear(128, 2)

    def forward(self, x):
        x = F.relu(self.c1(x))
        x = self.pool1(x)
        x = F.relu(self.c2(x))
        x = self.pool2(x)
        x = x.view(-1, 16 * 54 * 54)
        x = F.relu(self.l3(x))
        x = self.dropout(x)
        return self.l4(x)
四、数据处理
采用ImageFolder加载按类别分文件夹存储的数据集,通过数据增强提升模型泛化能力:
def build_data(data_dir, batch_size=8):
    transform = transforms.Compose([
        transforms.Resize((224, 224)),
        transforms.RandomHorizontalFlip(),
        transforms.RandomRotation(10),
        transforms.ToTensor(),
        transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
    ])

    train_dataset = datasets.ImageFolder(os.path.join(data_dir, 'train'), transform=transform)
    val_dataset = datasets.ImageFolder(os.path.join(data_dir, 'valid'), transform=transform)
    test_dataset = datasets.ImageFolder(os.path.join(data_dir, 'test'), transform=transform)

    return (
        DataLoader(train_dataset, batch_size, shuffle=True, num_workers=2, pin_memory=True),
        DataLoader(val_dataset, batch_size, shuffle=False, num_workers=2, pin_memory=True),
        DataLoader(test_dataset, batch_size, shuffle=False, num_workers=2, pin_memory=True),
        train_dataset.classes
    )
五、模型训练与评估
5.1 训练函数
def train(model, train_loader, val_loader, epochs=10, lr=0.001):
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model.to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)
    scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer, 'min', patience=2, factor=0.5)
    best_val_acc = 0.0

    for epoch in range(epochs):
        # 训练阶段
        model.train()
        train_loss, train_correct, train_total = 0.0, 0, 0
        for inputs, targets in train_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            optimizer.zero_grad()
            outputs = model(inputs)
            loss = criterion(outputs, targets)
            loss.backward()
            optimizer.step()

            train_loss += loss.item()
            _, predicted = outputs.max(1)
            train_total += targets.size(0)
            train_correct += predicted.eq(targets).sum().item()
            del inputs, targets, outputs, loss
            torch.cuda.empty_cache()

        # 验证阶段
        model.eval()
        val_loss, val_correct, val_total = 0.0, 0, 0
        with torch.no_grad():
            for inputs, targets in val_loader:
                inputs, targets = inputs.to(device), targets.to(device)
                outputs = model(inputs)
                loss = criterion(outputs, targets)
                val_loss += loss.item()
                _, predicted = outputs.max(1)
                val_total += targets.size(0)
                val_correct += predicted.eq(targets).sum().item()
                del inputs, targets, outputs, loss
                torch.cuda.empty_cache()

        # 打印指标并保存最佳模型
        train_acc = 100.0 * train_correct / train_total
        val_acc = 100.0 * val_correct / val_total
        print(f'Epoch [{epoch+1}/{epochs}] Train Loss: {train_loss/len(train_loader):.4f} '
              f'Train Acc: {train_acc:.2f}% Val Loss: {val_loss/len(val_loader):.4f} '
              f'Val Acc: {val_acc:.2f}%')

        scheduler.step(val_loss)
        if val_acc > best_val_acc:
            best_val_acc = val_acc
            torch.save(model.state_dict(), 'apple_model_best.pth')

    print(f'最佳验证准确率: {best_val_acc:.2f}%')
    return model
5.2 测试函数
def test(model, test_loader):
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model.to(device).eval()
    test_correct, test_total = 0, 0
    class_correct, class_total = [0, 0], [0, 0]

    with torch.no_grad():
        for inputs, targets in test_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            outputs = model(inputs)
            _, predicted = outputs.max(1)

            test_total += targets.size(0)
            test_correct += predicted.eq(targets).sum().item()

            c = (predicted == targets).squeeze()
            for i in range(len(targets)):
                label = targets[i]
                class_correct[label] += c[i].item()
                class_total[label] += 1

    test_acc = 100.0 * test_correct / test_total
    print(f'测试集总准确率: {test_acc:.2f}%')
    for i, cls in enumerate(['green', 'red']):
        print(f'{cls}苹果准确率: {100.0 * class_correct[i]/class_total[i]:.2f}%')
六、运行入口
if __name__ == '__main__':
    data_dir = '../data/Apples'
    train_loader, val_loader, test_loader, classes = build_data(data_dir)
    print(f'类别列表: {classes}')

    model = AppleNet()
    print(f"模型参数数量: {sum(p.numel() for p in model.parameters()):,}")

    model = train(model, train_loader, val_loader, epochs=10)
    test(model, test_loader)
    torch.save(model.state_dict(), 'apple_model_final.pth')
七、完整源码
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch import optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
import os
from PIL import Image

# 设置GPU内存分配策略
torch.cuda.empty_cache()
os.environ["PYTORCH_CUDA_ALLOC_CONF"] = "max_split_size_mb:128"


class AppleNet(nn.Module):
    def __init__(self):
        super(AppleNet, self).__init__()
        self.c1 = nn.Conv2d(3, 8, 3, 1, bias=True)
        self.pool1 = nn.MaxPool2d(2, 2)
        self.c2 = nn.Conv2d(8, 16, 3, 1, bias=True)
        self.pool2 = nn.MaxPool2d(2, 2)
        self.l3 = nn.Linear(16 * 54 * 54, 128)
        self.dropout = nn.Dropout(0.5)
        self.l4 = nn.Linear(128, 2)

    def forward(self, x):
        x = F.relu(self.c1(x))
        x = self.pool1(x)
        x = F.relu(self.c2(x))
        x = self.pool2(x)
        x = x.view(-1, 16 * 54 * 54)
        x = F.relu(self.l3(x))
        x = self.dropout(x)
        return self.l4(x)


def build_data(data_dir, batch_size=8):
    if not os.path.exists(data_dir):
        raise FileNotFoundError(f"数据集目录不存在: {data_dir}")
    for subdir in ['train', 'valid', 'test']:
        if not os.path.exists(os.path.join(data_dir, subdir)):
            raise FileNotFoundError(f"数据子目录不存在: {os.path.join(data_dir, subdir)}")

    transform = transforms.Compose([
        transforms.Resize((224, 224)),
        transforms.RandomHorizontalFlip(),
        transforms.RandomRotation(10),
        transforms.ToTensor(),
        transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
    ])

    train_dataset = datasets.ImageFolder(os.path.join(data_dir, 'train'), transform=transform)
    val_dataset = datasets.ImageFolder(os.path.join(data_dir, 'valid'), transform=transform)
    test_dataset = datasets.ImageFolder(os.path.join(data_dir, 'test'), transform=transform)

    return (
        DataLoader(train_dataset, batch_size, shuffle=True, num_workers=2, pin_memory=True),
        DataLoader(val_dataset, batch_size, shuffle=False, num_workers=2, pin_memory=True),
        DataLoader(test_dataset, batch_size, shuffle=False, num_workers=2, pin_memory=True),
        train_dataset.classes
    )


def train(model, train_loader, val_loader, epochs=10, lr=0.001):
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    print(f"使用设备: {device}")
    model.to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)
    scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer, 'min', patience=2, factor=0.5, verbose=True)
    best_val_acc = 0.0

    for epoch in range(epochs):
        model.train()
        train_loss, train_correct, train_total = 0.0, 0, 0
        for inputs, targets in train_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            optimizer.zero_grad()
            outputs = model(inputs)
            loss = criterion(outputs, targets)
            loss.backward()
            optimizer.step()

            train_loss += loss.item()
            _, predicted = outputs.max(1)
            train_total += targets.size(0)
            train_correct += predicted.eq(targets).sum().item()
            del inputs, targets, outputs, loss
            torch.cuda.empty_cache()

        model.eval()
        val_loss, val_correct, val_total = 0.0, 0, 0
        with torch.no_grad():
            for inputs, targets in val_loader:
                inputs, targets = inputs.to(device), targets.to(device)
                outputs = model(inputs)
                loss = criterion(outputs, targets)
                val_loss += loss.item()
                _, predicted = outputs.max(1)
                val_total += targets.size(0)
                val_correct += predicted.eq(targets).sum().item()
                del inputs, targets, outputs, loss
                torch.cuda.empty_cache()

        train_acc = 100.0 * train_correct / train_total
        val_acc = 100.0 * val_correct / val_total
        print(f'Epoch [{epoch+1}/{epochs}] Train Loss: {train_loss/len(train_loader):.4f} '
              f'Train Acc: {train_acc:.2f}% Val Loss: {val_loss/len(val_loader):.4f} '
              f'Val Acc: {val_acc:.2f}%')

        scheduler.step(val_loss)
        if val_acc > best_val_acc:
            best_val_acc = val_acc
            torch.save(model.state_dict(), 'apple_model_best.pth')
            print(f'模型已保存 (验证准确率: {val_acc:.2f}%)')

    print(f'最佳验证准确率: {best_val_acc:.2f}%')
    return model


def test(model, test_loader):
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model.to(device).eval()
    test_correct, test_total = 0, 0
    class_correct, class_total = [0, 0], [0, 0]

    with torch.no_grad():
        for inputs, targets in test_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            outputs = model(inputs)
            _, predicted = outputs.max(1)

            test_total += targets.size(0)
            test_correct += predicted.eq(targets).sum().item()

            c = (predicted == targets).squeeze()
            for i in range(len(targets)):
                label = targets[i]
                class_correct[label] += c[i].item()
                class_total[label] += 1
            del inputs, targets, outputs, predicted
            torch.cuda.empty_cache()

    test_acc = 100.0 * test_correct / test_total
    print(f'测试集总准确率: {test_acc:.2f}%')
    classes = ['green', 'red']
    for i in range(2):
        if class_total[i] > 0:
            print(f'{classes[i]}苹果准确率: {100.0 * class_correct[i]/class_total[i]:.2f}%')
        else:
            print(f'{classes[i]}苹果准确率: N/A')


if __name__ == '__main__':
    print(f"当前工作目录: {os.getcwd()}")
    data_dir = '../data/Apples'
    if not os.path.exists(data_dir):
        print(f"错误: 数据集路径不存在 - {data_dir}")
        exit(1)

    try:
        print("正在加载数据集...")
        train_loader, val_loader, test_loader, classes = build_data(data_dir)
        print(f'类别列表: {classes}')
    except Exception as e:
        print(f"加载数据时出错: {e}")
        exit(1)

    model = AppleNet()
    total_params = sum(p.numel() for p in model.parameters())
    print(f"模型参数数量: {total_params:,}")

    print('开始训练模型...')
    model = train(model, train_loader, val_loader, epochs=10)

    print('开始测试模型...')
    test(model, test_loader)

    torch.save(model.state_dict(), 'apple_model_final.pth')
    print('模型已保存为: apple_model_final.pth')

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)