全连接神经网络
全连接神经网络
整体结构
分为输入层,隐藏层,输出层
隐藏层层数视任务而定:可以是1层,也可以是很多层
输出层可以有一个输出也可以是 多个输出
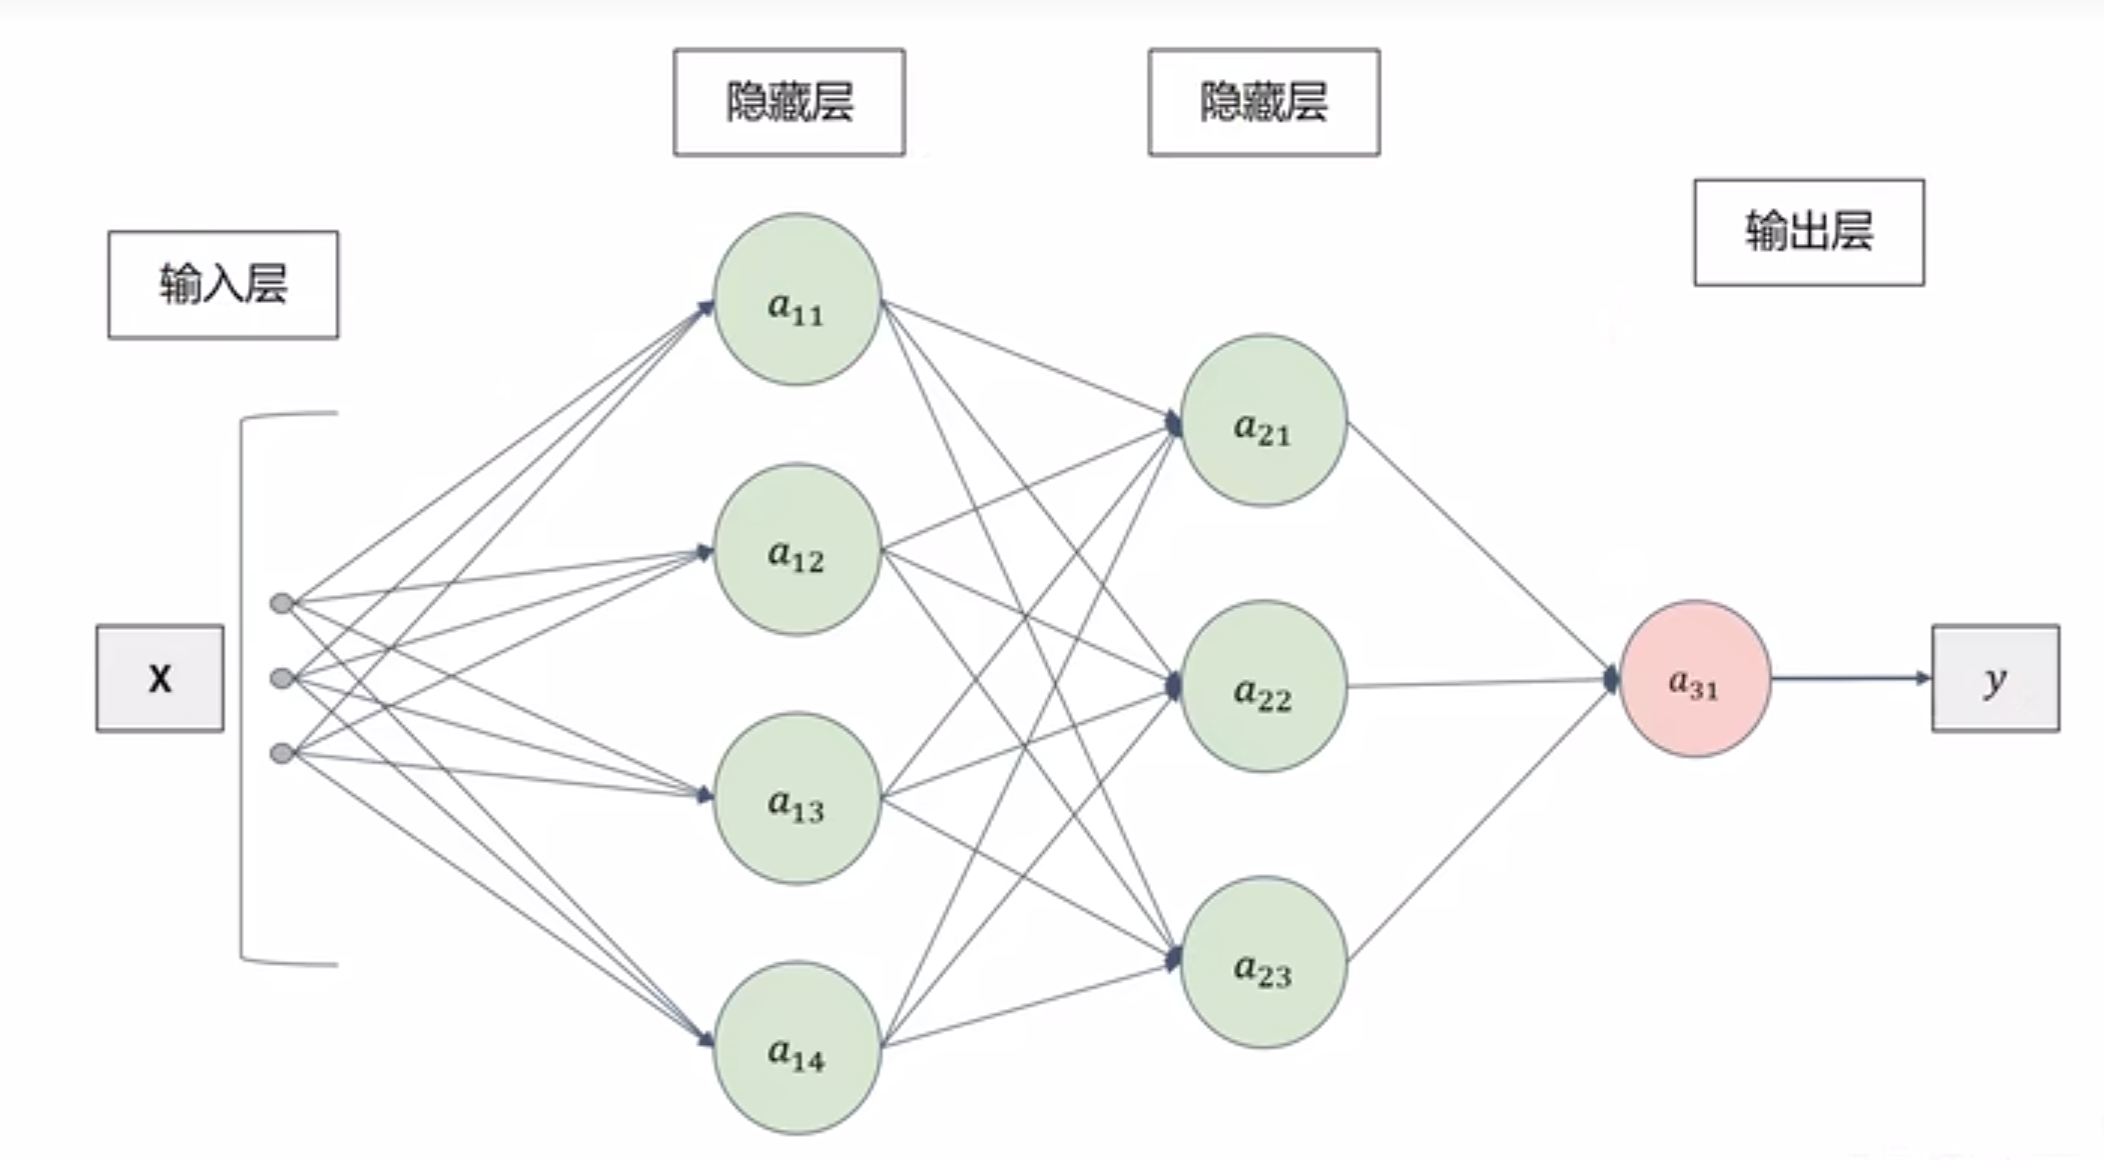
单元结构
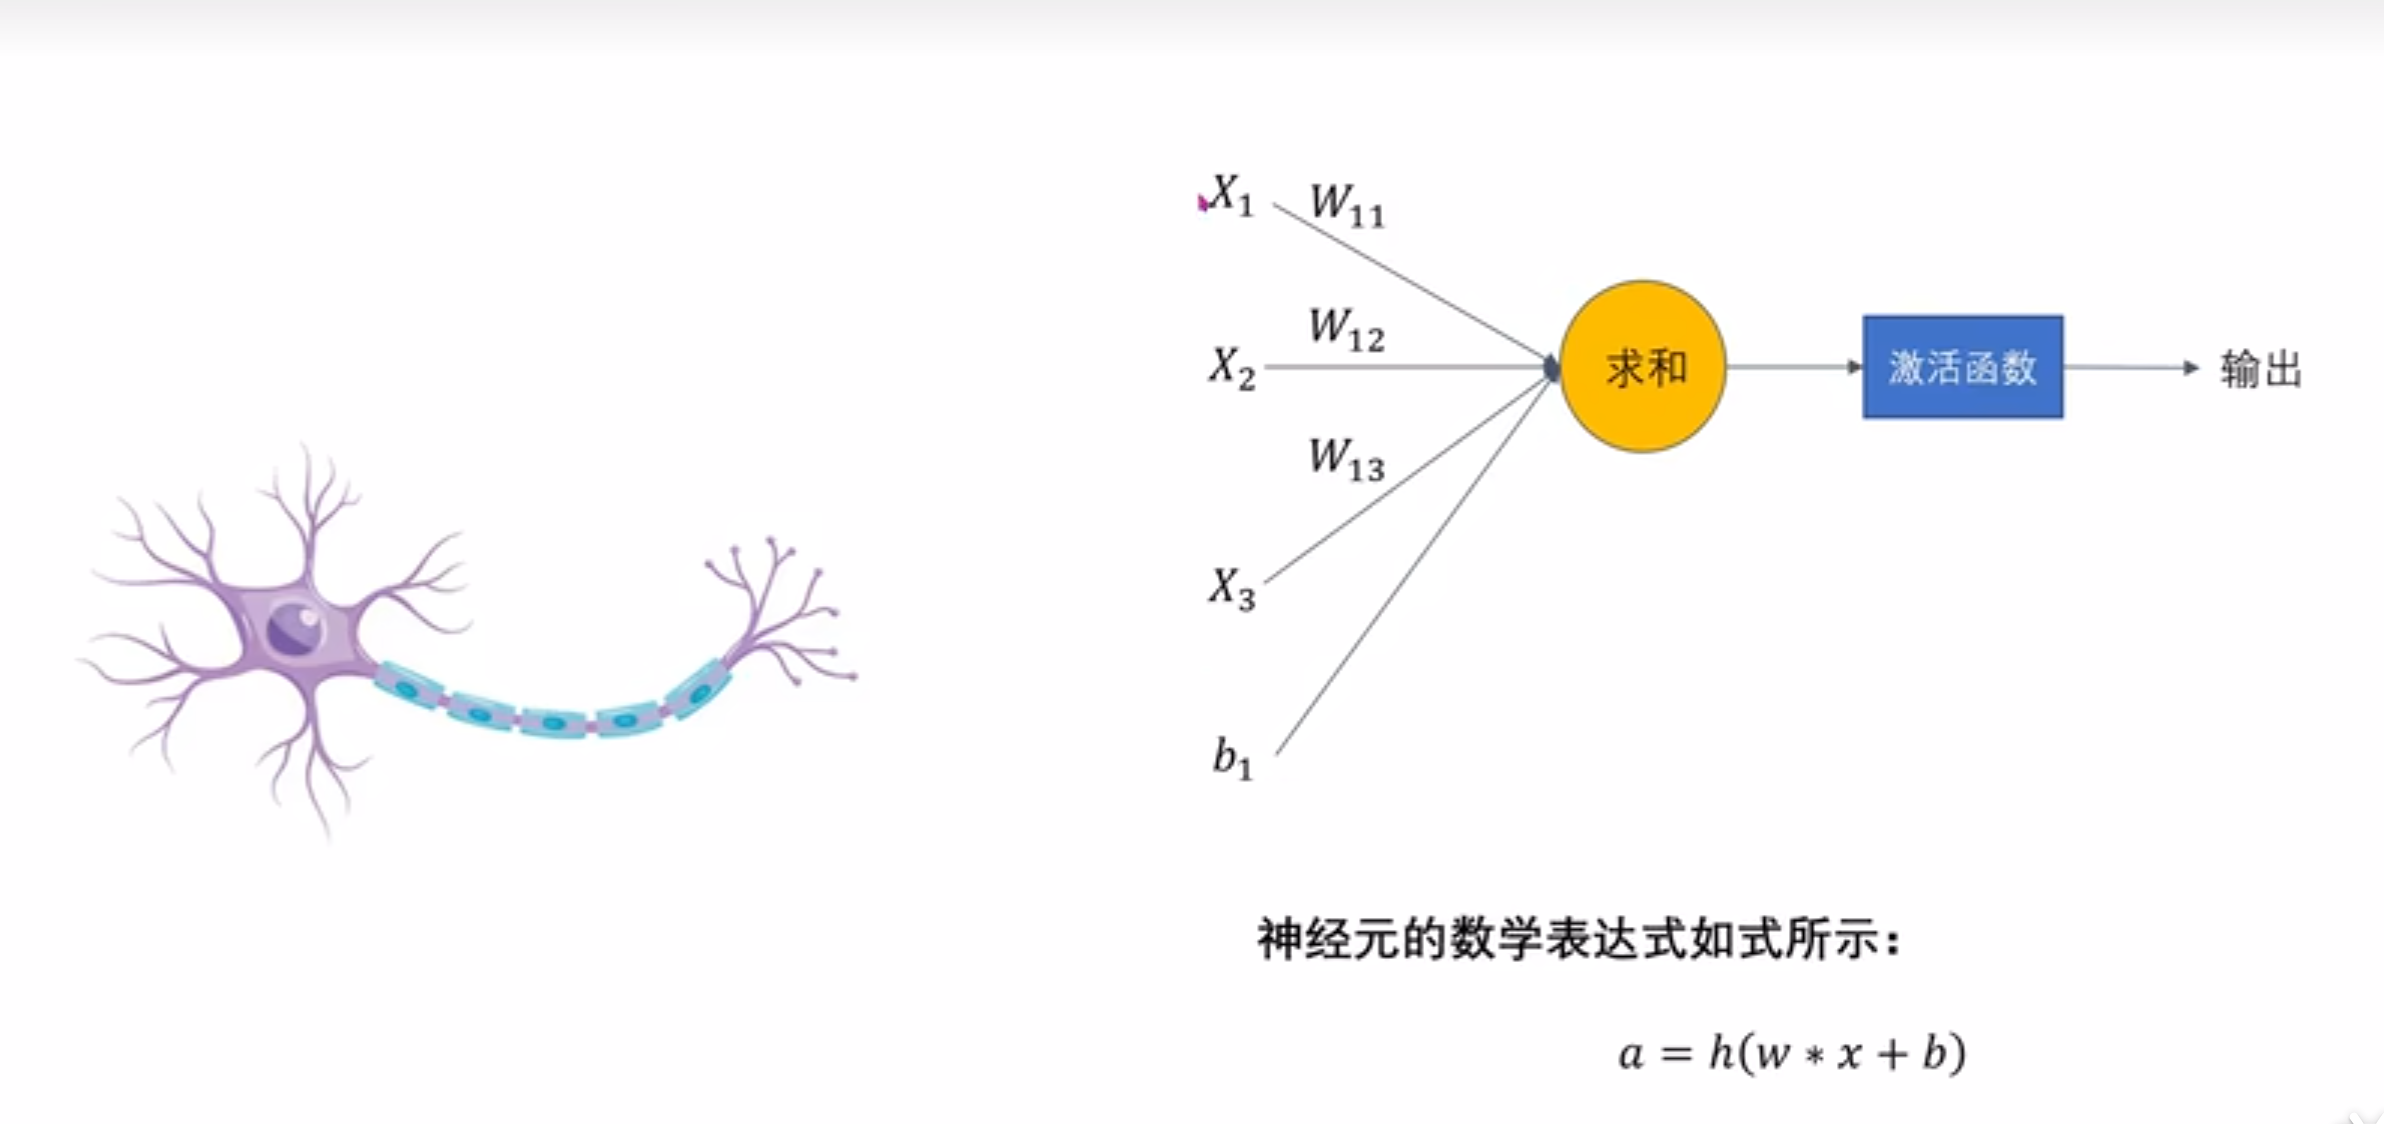
数学表达式:
a=h(wTX+b)=h(w1x1+⋯+wnxn+b)h()就是激活函数,是一个非线性函数wTX+b就是前面的线性回归
a = h(w^TX+b)=h(w_1x_1+\dots+w_nx_n+b) \\
h()就是激活函数,是一个非线性函数 \\
w^TX+b就是前面的线性回归
a=h(wTX+b)=h(w1x1+⋯+wnxn+b)h()就是激活函数,是一个非线性函数wTX+b就是前面的线性回归
思考:全连接神经网络的单元结构就是
如果不经过激活函数,那就是线性回归
a=wTX+b
a = w^TX+b
a=wTX+b
如果激活函数是sigmoid函数
a=σ(wTX+b)
a = \sigma(w^TX+b)
a=σ(wTX+b)
那就变成逻辑回归了
激活函数
作用
引入了激活函数,网络才具有学习更加复杂关系能力的原因,由前面的思考得到,如果去掉了激活函数,那么单元结构就会变成一个线性回归模型,这样网络学习能力就会受限
为什么激活函数不是线性函数?
以一个小例子:数学表达式为a=h(x)=cx,单元结构如下
X->a11->a21->a31->y
有两个隐藏层
a11=cxa21=ca11=c2xa31=ca21=c3x
a_{11}=cx \\
a_{21} = ca_{11}=c^2x \\
a_{31}=ca_{21}=c^3x
a11=cxa21=ca11=c2xa31=ca21=c3x
我们发现,最终结果还是一个线性的,我们可以直接把单元结构改成
X->a31->y
数学表达式为
a=h(x)=kx=c3x
a=h(x)=kx=c^3x
a=h(x)=kx=c3x
那么两个隐藏层就被抵消掉了;隐藏层的作用是为了执行更复杂的计算任务,但使用线性函数作为激活函数,不仅浪费了计算资源还没起什么作用,等价于没有隐藏层的单元结构
分类
sigmoid函数
y=11+e−zy′=y(1−y) y = \frac{1}{1+e^{-z}} \\ y' = y(1-y) y=1+e−z1y′=y(1−y)
绘制图像:
import numpy as np
import matplotlib.pyplot as plt

x_list = []
sig_list = []
d_sig_list = []


def sigmoid(x):
        return 1 / (1 + np.exp(-x))


def sigmoid_de(x):
        sig = sigmoid(x)
        return sig*(1 - sig)


for x in np.arange(-10, 11, 0.1):
        x_list.append(x)
        sigm = sigmoid(x)
        desig = sigmoid_de(x)
        sig_list.append(sigm)
        d_sig_list.append(desig)

plt.plot(x_list, sig_list,label="sigmoid")
plt.plot(x_list, d_sig_list,label="sigmoid'")
plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.grid(True)
plt.show()
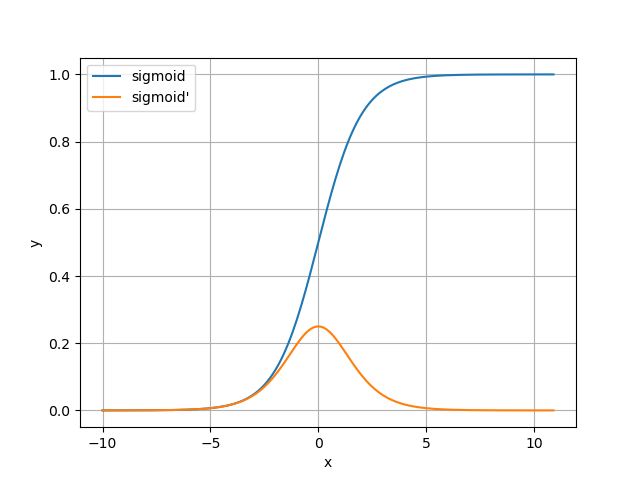
分析:
sigmoid导数图像两侧都趋近于0,就导致偏离对称轴一定距离后,梯度值会变得很小,这就会导致梯度下降时参数更新的慢
优点:
1.简单,非常适用与分类任务
缺点:
1.反向传播训练时有梯度消失的问题
(什么是反向传播?使用链式法则将损失函数对参数的梯度逐层回传,用于更新参数和偏置 TODO:链式法则,反向传播)
比如这样
w=w−α∂J∂wsigmoid导数的最大值是0.25,我们假设梯度就是0.25对于很多隐藏层的网络结构,反向传播时就会这样w=w−α(0.25∗0.25∗⋯∗0.25)梯度就变得很小很小,也就是梯度消失问题
w = w - \alpha\frac{\partial J}{\partial w} \\
sigmoid导数的最大值是0.25,我们假设梯度就是0.25 \\
对于很多隐藏层的网络结构,反向传播时就会这样 \\
w = w-\alpha(0.25*0.25*\dots*0.25) \\
梯度就变得很小很小,也就是梯度消失问题
w=w−α∂w∂Jsigmoid导数的最大值是0.25,我们假设梯度就是0.25对于很多隐藏层的网络结构,反向传播时就会这样w=w−α(0.25∗0.25∗⋯∗0.25)梯度就变得很小很小,也就是梯度消失问题
2.输出值区间为(0,1),关于原点不对称,会使参数更新的比较慢
(所以我们希望的激活函数是关于原点对称的,即奇函数f(-x) = -f(x))
3.梯度更新在不同方向走的太远(导数图像对称轴两侧),使优化难度增大,训练耗时
Tanh函数
双曲正切激活函数
y=ez−e−zez+e−zy′=1−y2
y = \frac{e^z-e^{-z}}{e^z+e^{-z}} \\
y' = 1-y^2
y=ez+e−zez−e−zy′=1−y2
import numpy as np
import matplotlib.pyplot as plt

w = 0.5
b = 0.1

x_list = []
y_list = []
de_y_list = []


def get_z(x, w, b):
        return w * x + b


def tanh(x, w, b):
        z = get_z(x, w, b)
        frac1 = np.exp(z) - np.exp(-z)
        frac2 = np.exp(z) + np.exp(-z)
        return frac1 / frac2


def de_tanh(y):
        return 1 - y ** 2


for x in np.arange(-10.0, 10.1, 0.1):
        x_list.append(x)
        y = tanh(x, w, b)
        y_list.append(y)
        de_y = de_tanh(y)
        de_y_list.append(de_y)

plt.plot(x_list,y_list,label="tanh")
plt.plot(x_list,de_y_list,label="de_tanh")

plt.legend()
plt.grid(True)
plt.show()
图像:
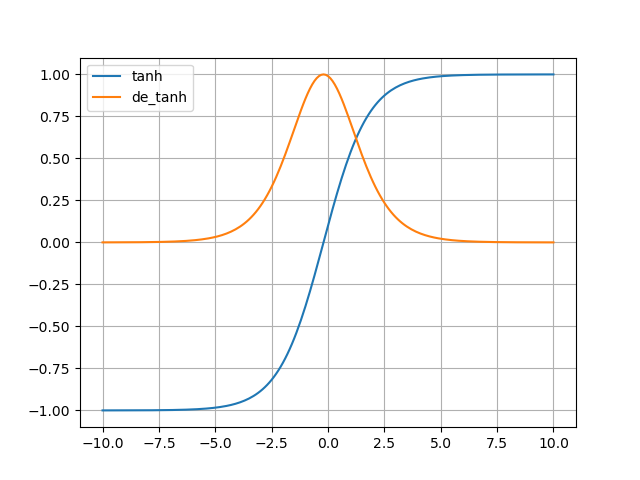
分析:原函数关于原点对称了,原函数取值(-1,1);导数图像与sigmoid的导数类似,x趋近±∞时导数趋于0
优点:
1.解决了sigmoid不关于原点对称的问题,参数更新得更快
2.导数(梯度)最大值为1,因此训练的速度高于sigmoid
缺点:
1.仍存在梯度消失的问题
(尽管梯度最大值发生变化,但图像的形状仍于sigmoid类似)
2.还是和sigmoid很类似
ReLU函数
y={z,ifz>00,ifz≤0y′={1,ifz>00,ifz≤0 y=\begin{cases} z,& if& z >0 \\ 0,&if&z\leq0 \end{cases}\\ y'=\begin{cases} 1,&if&z>0\\ 0,&if&z\leq0 \end{cases} y={z,0,ififz>0z≤0y′={1,0,ififz>0z≤0
图像
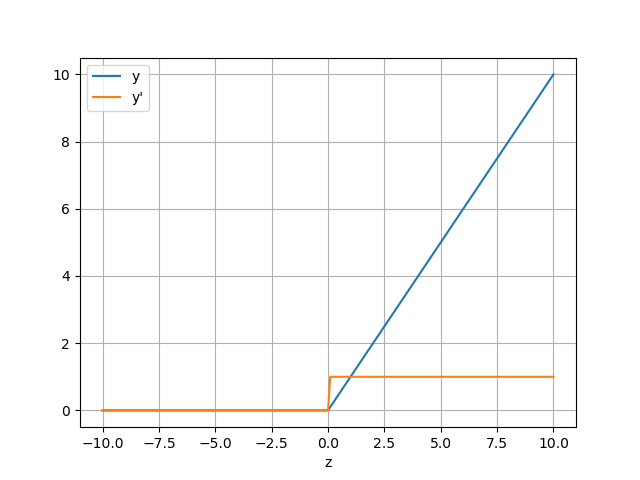
优点:
1.解决了梯度消失的问题
2.没有指数运算,计算更为简单
缺点:
1.训练时可能出现神经元死亡的情况
(当z<0时,y=0,J(w)=1/mX^T(h(z)-y),那么J对w的梯度就是0了,此时参数更新就失效了)
2.y不关于零点对称,参数更新的比较慢
Leaky ReLU函数
y={z,ifz>0az,ifz≤0y′={1,ifz>0a,ifz≤0其中0<α≪1(通常设为0.01) y=\begin{cases} z,& if& z >0 \\ az,&if&z\leq0 \end{cases}\\ y'=\begin{cases} 1,&if&z>0\\ a,&if&z\leq0 \\ \end{cases} 其中 0<α≪1(通常设为 0.01)\\ y={z,az,ififz>0z≤0y′={1,a,ififz>0z≤0其中0<α≪1(通常设为0.01)
图像
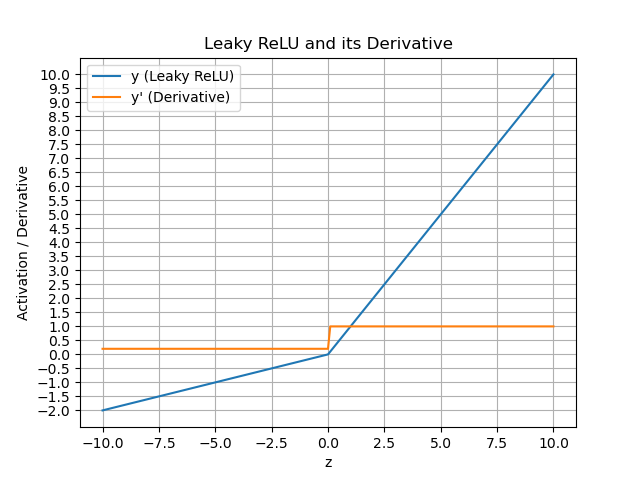
绘图代码注意事项,使用子图对象设置y轴刻度
# 获得子图对象
fig, ax = plt.subplots()
ax.plot(z_list, y_list, label="y (Leaky ReLU)")
ax.plot(z_list, de_y_list, label="y' (Derivative)")

# 设置 y 轴刻度间隔为 0.5
ax.yaxis.set_ticks(np.arange(-2, 10.1, 0.5))

ax.set_xlabel("z")
ax.set_ylabel("Activation / Derivative")
ax.set_title("Leaky ReLU and its Derivative")
ax.legend()
ax.grid(True)
plt.show()
优点:
1.解决了ReLU神经元死亡问题
(输出值以及导数都不会变为0)
缺点:
1.无法为正负输入值提供一致的关系预测(不同区间函数不同)
- 对于正输入,神经元“活跃”,直接将输入传递下去;
- 对于负输入,神经元“较弱地活跃”,只传递一小部分信号(乘以 α);
SoftMax激活函数
用于多分类问题的输出层的激活函数
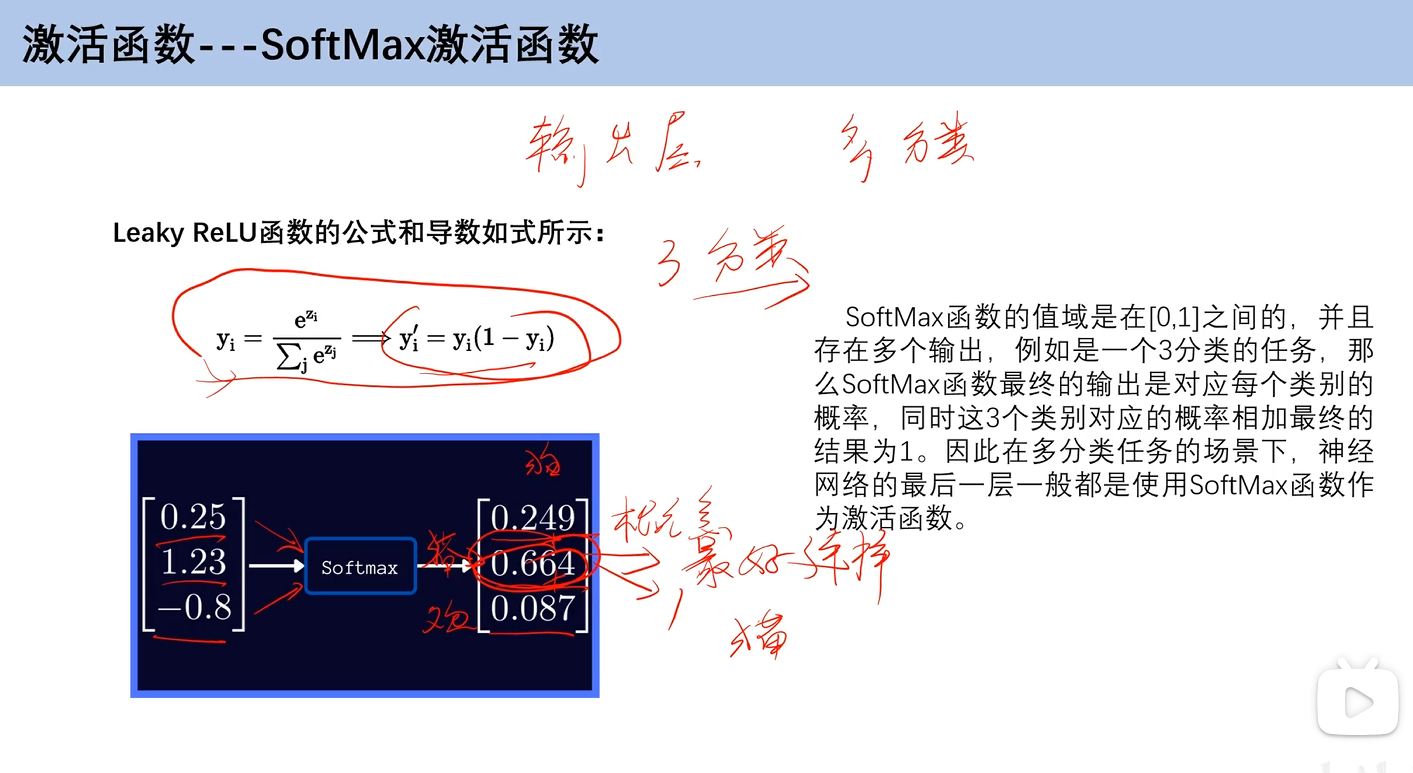
给定一个输入向量z=[z1,z2,…,zn]SoftMax(zi)=ezi∑j=1nezj
给定一个输入向量z=[z_1,z_2,\dots,z_n] \\
SoftMax(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{n}e^{z_j}}
给定一个输入向量z=[z1,z2,…,zn]SoftMax(zi)=∑j=1nezjezi
前向传播
对于线性回归和逻辑回归来说,前向传播就是计算得到回归结果的过程
对于神经网络
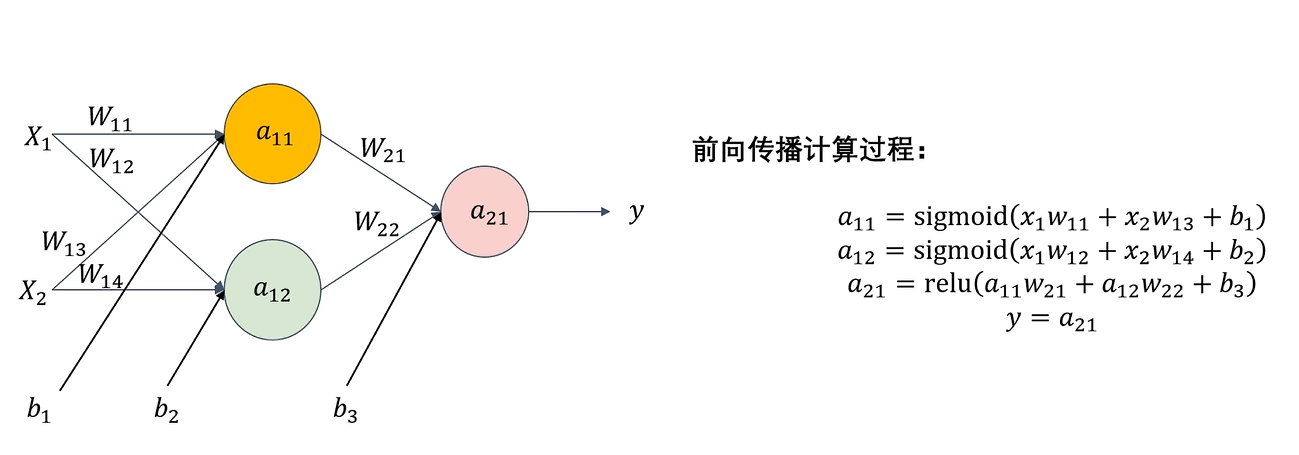
前向传播是指从输入层开始,依次经过隐藏层,最终到达输出层,逐层计算神经元输出值的过程,前向传播其实就是模型进行推理的过程
在这个过程中
- 神经元会对输入进行带权求和加上偏置(wa+b)
- 使用激活函数进行非线性变换
神经网络训练的步骤就分为:前向传播->计算误差->计算梯度->反向传播进行梯度更新
计算过程
eg:
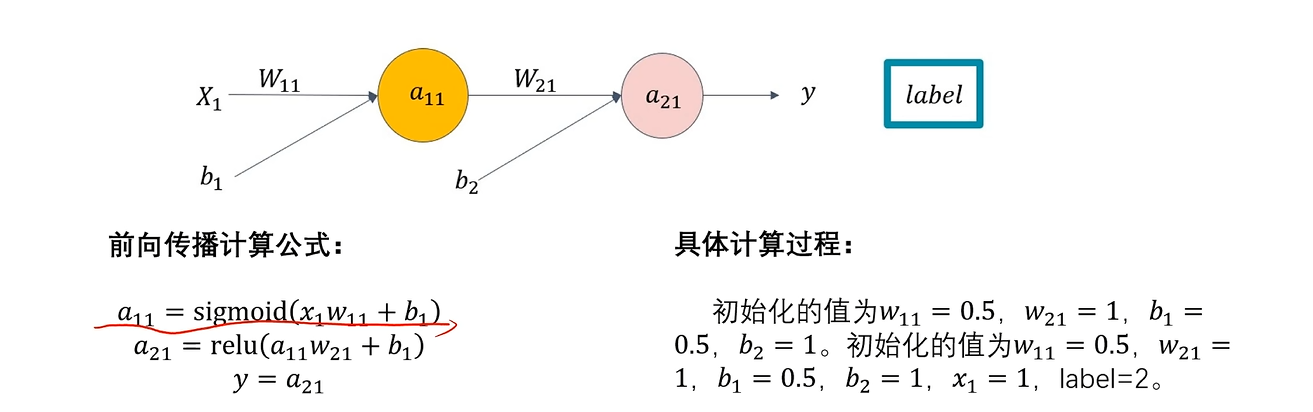
import numpy as np

# 权重
W = np.array([0.5, 1])
# 偏置
B = np.array([0.5, 1])
# 初始输入
x1 = 1
# 对应的标签
label = 1

# 带权求和
def init_z(x, w, b):
        return w * x + b

# 隐藏层激活函数sigmoid
def sigmoid(a):
        return 1 / (1 + np.exp(-a))

# 输出层激活函数ReLU
def ReLU(a):
        if (a > 0):
                return a
        else:
                return 0


if __name__ == '__main__':
        a = x1
        w = W.copy()
        b = B.copy()
        for i in range(len(W)):
                z = init_z(a, w[i], b[i])
                if i < len(W) - 1:
                        a = sigmoid(z)
                elif i == len(W) - 1:
                        a = ReLU(z)
        output = a
        print(output)
损失函数
回顾:
线性回归模型中:均方误差损失函数:
J(w)=12m∑i=1m(wxi−yi)2
J(w) = \frac{1}{2m}\sum_{i=1}^{m}(wx_i-y_i)^2
J(w)=2m1i=1∑m(wxi−yi)2
逻辑回归中:交叉熵损失函数:
J(w)=−1m∑i=1m(yilog(σ(wTxi+b))+(1−yi)log(1−σ(wTxi+b)))
J(w)= -\frac{1}{m}\sum_{i=1}^m(y_ilog(\sigma(w^Tx_i+b))+(1-y_i)log(1-\sigma(w^Tx_i+b)))
J(w)=−m1i=1∑m(yilog(σ(wTxi+b))+(1−yi)log(1−σ(wTxi+b)))
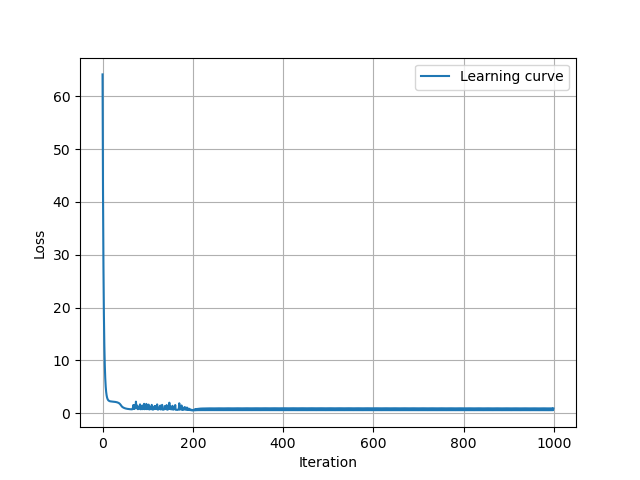
还是和前面一样要看学习曲线(Loss与迭代次数的关系图像),希望图像是平缓下降到一个比较小的稳定值,而不是扭来扭去或者上升
链式法则
因为神经网络模型中可能存在着多层的隐藏层,当我们需要反向传播求梯度时,就涉及到对复合函数的求导,此时需要使用链式法则
单变量
y=f(u)u=g(v)v=h(x)dydx=dydududvdvdx y=f(u) \\ u = g(v) \\ v = h(x) \\ \frac{dy}{dx}=\frac{dy}{du}\frac{du}{dv}\frac{dv}{dx} y=f(u)u=g(v)v=h(x)dxdy=dudydvdudxdv
多变量
z=f(u,v)u=g(y)v=h(y)y=j(x) z = f(u,v)\\ u = g(y)\\ v = h(y) \\ y = j(x) z=f(u,v)u=g(y)v=h(y)y=j(x)
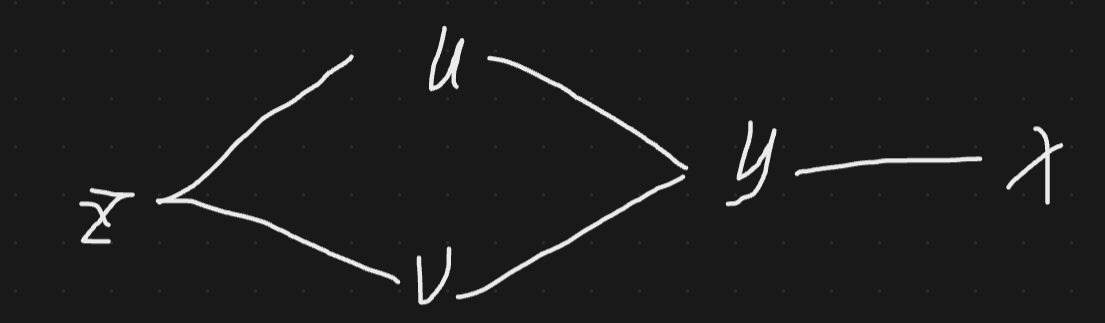
∂z∂x=∂z∂u∂u∂y∂y∂x+∂z∂v∂v∂y∂y∂x
\frac{\partial z}{\partial x} = \frac{\partial z}{\partial u}\frac{\partial u}{\partial y}\frac{\partial y}{\partial x}+\frac{\partial z}{\partial v}\frac{\partial v}{\partial y}\frac{\partial y}{\partial x}
∂x∂z=∂u∂z∂y∂u∂x∂y+∂v∂z∂y∂v∂x∂y
反向传播
还是前面的例子,隐藏层激活函数为sigmoid,输出层激活函数为ReLU
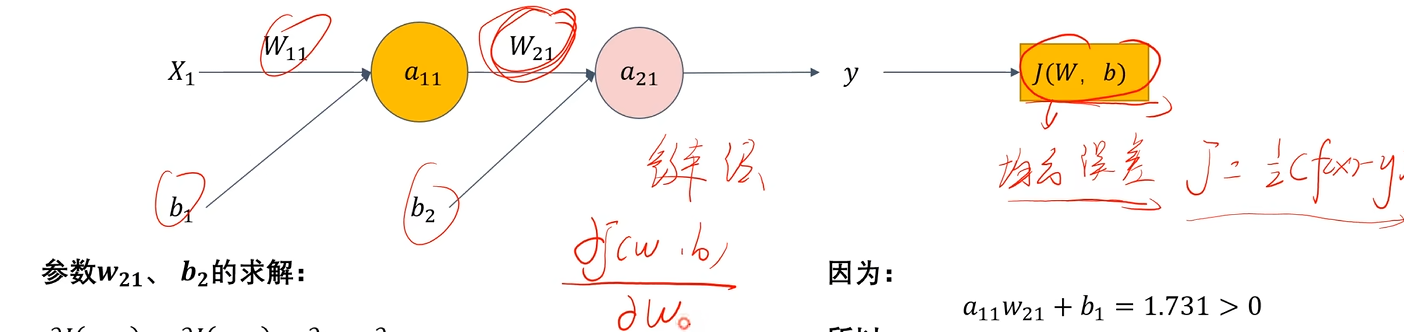
求J对w_21的梯度
∂J(w21,b)∂w21=∂J∂y∂y∂a21∂a21∂w21=∂12(y−label)2∂y∂a21∂a21∂ReLU(w21a11+b2)∂w21=(y−label)∂ReLU(w21a11+b2)∂w21a11+b2∂w21a11+b2∂w21=(y−label)×a11×∂ReLU(w21a11+b2)∂w21a11+b2
\frac{\partial J(w_{21},b)}{\partial w_{21}} = \frac{\partial J}{\partial y}\frac{\partial y}{\partial a_{21}}\frac{\partial a_{21}}{\partial w_{21}} = \frac{\partial \frac{1}{2}(y-label)^2}{\partial y}\frac{\partial a_{21}}{\partial a_{21}}\frac{\partial ReLU(w_{21}a_{11}+b_2)}{\partial w_{21}}=(y-label)\frac{\partial ReLU(w_{21}a_{11}+b_2)}{\partial w_{21}a_{11}+b_2}\frac{\partial w_{21}a_{11}+b_2}{\partial w_{21}} = (y-label)\times a_{11}\times \frac{\partial ReLU(w_{21}a_{11}+b_2)}{\partial w_{21}a_{11}+b_2}
∂w21∂J(w21,b)=∂y∂J∂a21∂y∂w21∂a21=∂y∂21(y−label)2∂a21∂a21∂w21∂ReLU(w21a11+b2)=(y−label)∂w21a11+b2∂ReLU(w21a11+b2)∂w21∂w21a11+b2=(y−label)×a11×∂w21a11+b2∂ReLU(w21a11+b2)
求J对b_2的梯度
∂J(w21,b2)∂b2=∂J(w21,b2)∂y∂y∂a21∂a21∂b2=∂12(y−label)2∂y∂y∂a21∂ReLU(w21a11+b2)∂w21a11+b2∂w21a11+b2∂b2
\frac{\partial J(w_{21},b_2)}{\partial b_2} = \frac{\partial J(w_{21},b_2)}{\partial y}\frac{\partial y}{\partial a_{21}}\frac{\partial a_{21}}{\partial b_2} = \frac{\partial \frac{1}{2}(y-label)^2}{\partial y}\frac{\partial y}{\partial a_{21}}\frac{\partial ReLU(w_{21}a_{11}+b_2)}{\partial w_{21}a_{11}+b_2}\frac{\partial w_{21}a_{11}+b_2}{\partial b_2}
∂b2∂J(w21,b2)=∂y∂J(w21,b2)∂a21∂y∂b2∂a21=∂y∂21(y−label)2∂a21∂y∂w21a11+b2∂ReLU(w21a11+b2)∂b2∂w21a11+b2
求J对w_11的梯度
∂J(w11,b)∂w11=∂J∂y∂y∂a21∂a21∂a11∂a11∂w11=(y−label)×1×∂ReLU(w21a11+b2)∂w21a11+b2×∂w21a11+b2∂a11×∂σ(w11x1+b1)∂w11x1+b1×∂w11x1+b1∂w11
\frac{\partial J(w_{11},b)}{\partial w_{11}} = \frac{\partial J}{\partial y}\frac{\partial y}{\partial a_{21}}\frac{\partial a_{21}}{\partial a_{11}}\frac{\partial a_{11}}{\partial w_{11}} = (y-label)\times1\times\frac{\partial ReLU(w_{21}a_{11}+b_2)}{\partial w_{21}a_{11}+b_2}\times\frac{\partial w_{21}a_{11}+b_2}{\partial a_{11}}\times\frac{\partial \sigma(w_{11}x_1+b_1)}{\partial w_{11}x_1+b_1}\times\frac{\partial w_{11}x_1+b_1}{\partial w_{11}}
∂w11∂J(w11,b)=∂y∂J∂a21∂y∂a11∂a21∂w11∂a11=(y−label)×1×∂w21a11+b2∂ReLU(w21a11+b2)×∂a11∂w21a11+b2×∂w11x1+b1∂σ(w11x1+b1)×∂w11∂w11x1+b1
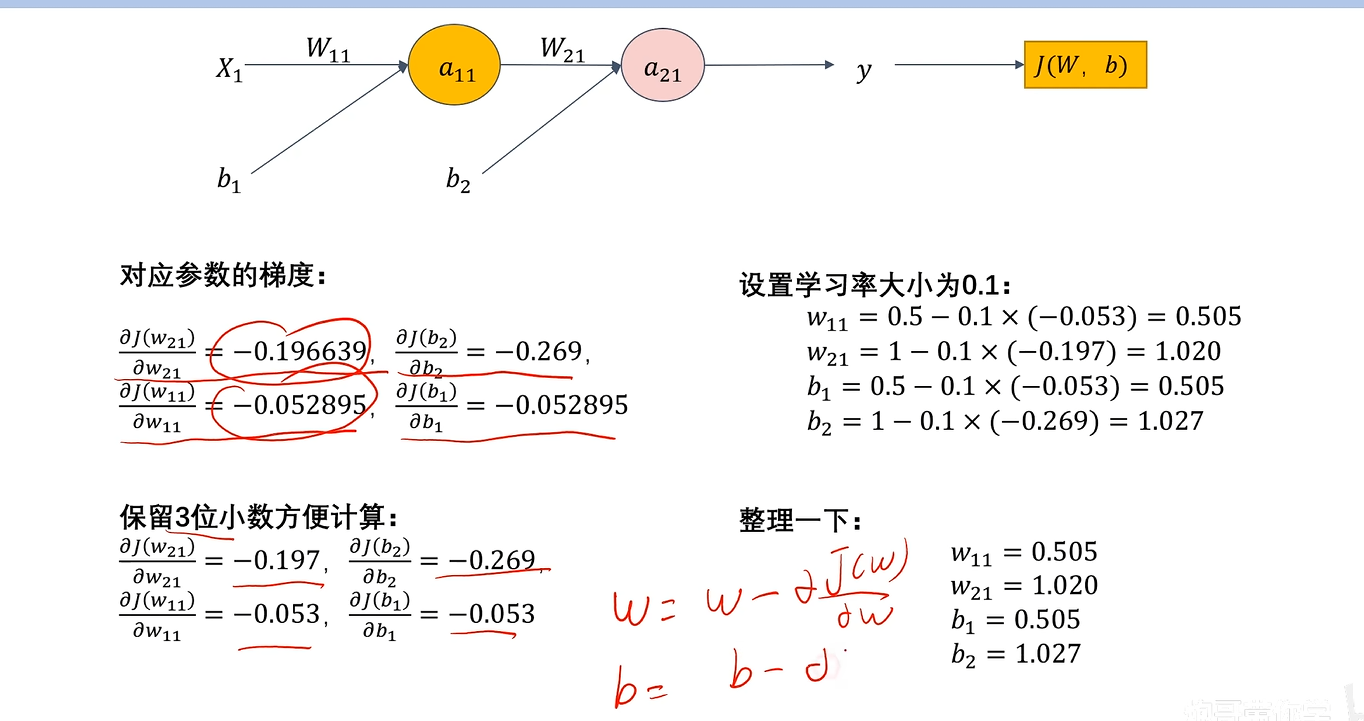
经典的梯度更新
wj=wj=α∂J∂wbj=bj=α∂J∂b
w_j = w_j = \alpha\frac{\partial J}{\partial w} \\
b_j = b_j = \alpha\frac{\partial J}{\partial b}
wj=wj=α∂w∂Jbj=bj=α∂b∂J
代码实现
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(0)
# 3组2特征输入
X = np.array([
        [1, 2],
        [2, 3],
        [4, 6],
])
# 标签
Y = np.array([
        [10],
        [11],
        [15]
])

# 输入层大小
input_size = X.shape[1]
# 神经元个数
hidden_size = 2
# 输出层大小
output_size = Y.shape[1]

# 输入层到隐藏层的权重矩阵,input_size*hidden_size是为了让输入的每个特征都与隐藏层中每个神经元有权重连接
W1 = np.random.randn(input_size, hidden_size)
# 隐藏层到输出层的权重矩阵,hidden_size*output_size是为了让隐藏层中每个神经元都与输出层的输出有权重连接
W2 = np.random.randn(hidden_size, output_size)
# W1*X.shape=(X.shape[0],hidden_size),B1.shape=(1,hidden_size)有利于广播对齐
B1 = np.zeros((1, hidden_size))
# 输出的格式是Y.shape,B2.shape=(1,output_size)有利于广播对齐以及运算
B2 = np.zeros((1, output_size))

learning_rate = 0.1
nums_epochs = 1000
test_epochs = 1000

error_list = []


def ReLU(x):
        # 将所有负值变为 0,正值保持不变
        return np.maximum(0, x)


def ReLU_de(x):
        # (x > 0):将列表转换为布尔列表;如果列表中元素大于0,该位置就是True;.astype(float) True->1.0 False—>0.0
        return (x > 0).astype(float)


def sigmoid(x):
        return 1 / (1 + np.exp(-x))


def sigmoid_de(x):
        y = sigmoid(x)
        return y * (1 - y)


def mse(Y_pred, Y):
        m = len(Y_pred)
        return np.sum((Y_pred - Y) ** 2) / (2 * m)


m = X.shape[0]
for i in range(nums_epochs):
        # 前向传播
        z = np.dot(X, W1) + B1
        a1 = sigmoid(z)
        # print(a1.shape)
        z2 = np.dot(a1, W2) + B2
        a2 = ReLU(z2)
        # print(a2.shape)
        # 反向传播
        # mse
        MSE = mse(a2, Y)
        error_list.append(MSE)

        # J对Y的偏导
        pJpY = (a2 - Y) / m
        # Y对a2的偏导
        pYpa2 = 1
        # a2对w2a1+b2的偏导
        dR = ReLU_de(z2)
        # w2a1+b2对w2的偏导
        pa2pw2 = a1

        # a1.shape=(3,2) (a2-Y).shape = dR.shape=(3,1),而dw2的shape要和W2相同,即(2,1)

        delta2 = pJpY * pYpa2 * dR
        dw2 = np.dot(pa2pw2.T, delta2)

        # a2对a1的偏导
        pa2pa1 = W2
        # a1对w1X+b1的偏导
        dS = sigmoid_de(z)
        # delta*X
        # (3,1) (2,1) (3,2) (3,2)
        delta1 = np.dot(delta2, W2.T) * dS
        dw1 = np.dot(X.T, delta1)

        W1 -= learning_rate * dw1
        W2 -= learning_rate * dw2

plt.plot(error_list, label="Learning curve")
plt.xlabel("Iteration")
plt.ylabel("Loss")
plt.legend()
plt.grid(True)
plt.show()

z1_test = np.dot(X, W1) + B1
a1_test = sigmoid(z1_test)
z2_test = np.dot(a1_test, W2) + B2
a2_test = ReLU(z2_test)
print("预测结果\n", a2_test)
print("实际结果\n", Y)
学习曲线
输出结果
预测结果
 [[ 9.22571926]
 [11.27514153]
 [13.36276318]]
实际结果
 [[10]
 [11]
 [15]]

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)