强化学习PPO学习笔记
水平一般,基本靠抄别人ppt,主要目的是梳理一下思路,没法保证正确性
主要参考
零基础学习强化学习算法:ppo
【大白话03】一文理清强化学习RL基本原理 | 原理图解+公式推导
总览
先来一张总览图(这图忘了从哪复制来的了)
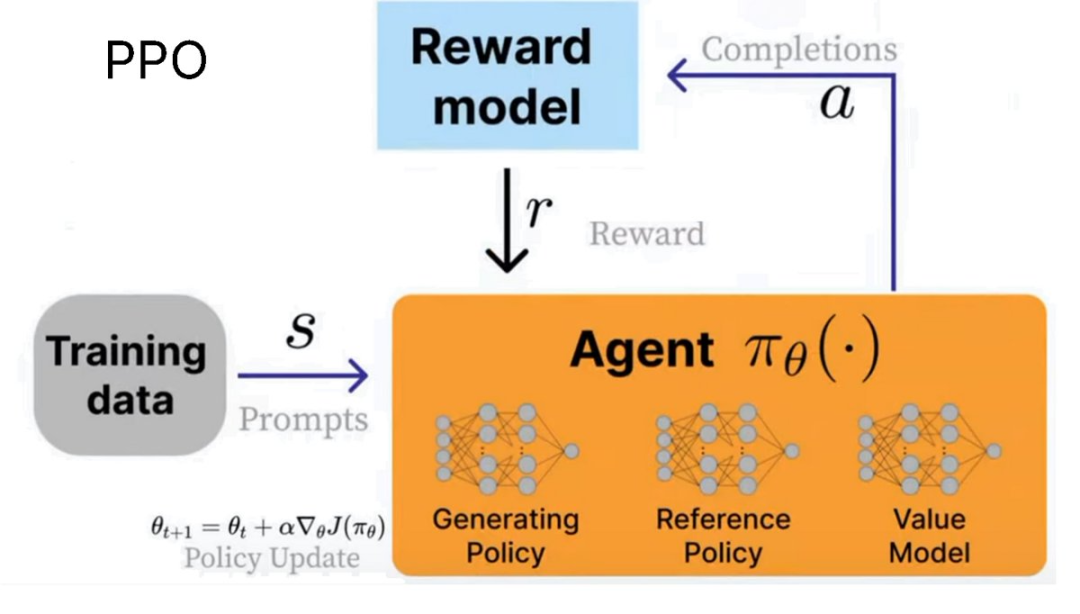
在ppo流程中主要有四个模型,分别是策略模型(我们自己要训练的模型),参考模型(只用于参考,不更新),状态价值模型(用于对状态价值进行预测,至于什么是状态价值下面说)以及奖励模型
奖励期望
策略模型生成策略的过程就是根据当前的状态选择一个行为到达一个新的状态,获取奖励分数的过程
比如某个机器人的目的是到达正前方100米的终点,其现在可能选择向前走10米,也可能选择向后走10米。两个选择都是行为,距离终点100米是状态。假设奖励设置为离终点距离变小时给1,否则给-1,那机器人选择向前走10米就可以获得1的奖励分数,同时状态更新为距离终点90米。
机器人在到终点这个过程中可能存在多种选择方案,每个方案由一系列的状态和行为组成。这个方案就叫做轨迹。选择各个轨迹的可能性各不相同,轨迹的奖励即为轨迹中一系列的行为带来的奖励分数总和。
我们的目的是最大化奖励的期望
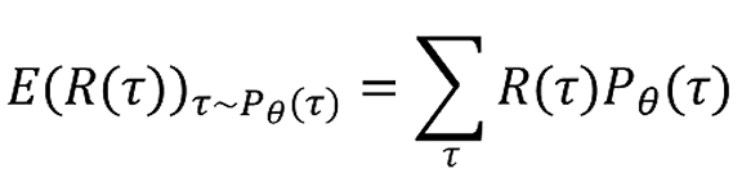
其中
τ
\tau
τ代表轨迹,
θ
\theta
θ代表策略模型参数,R代表奖励
对这个损失求梯度可得
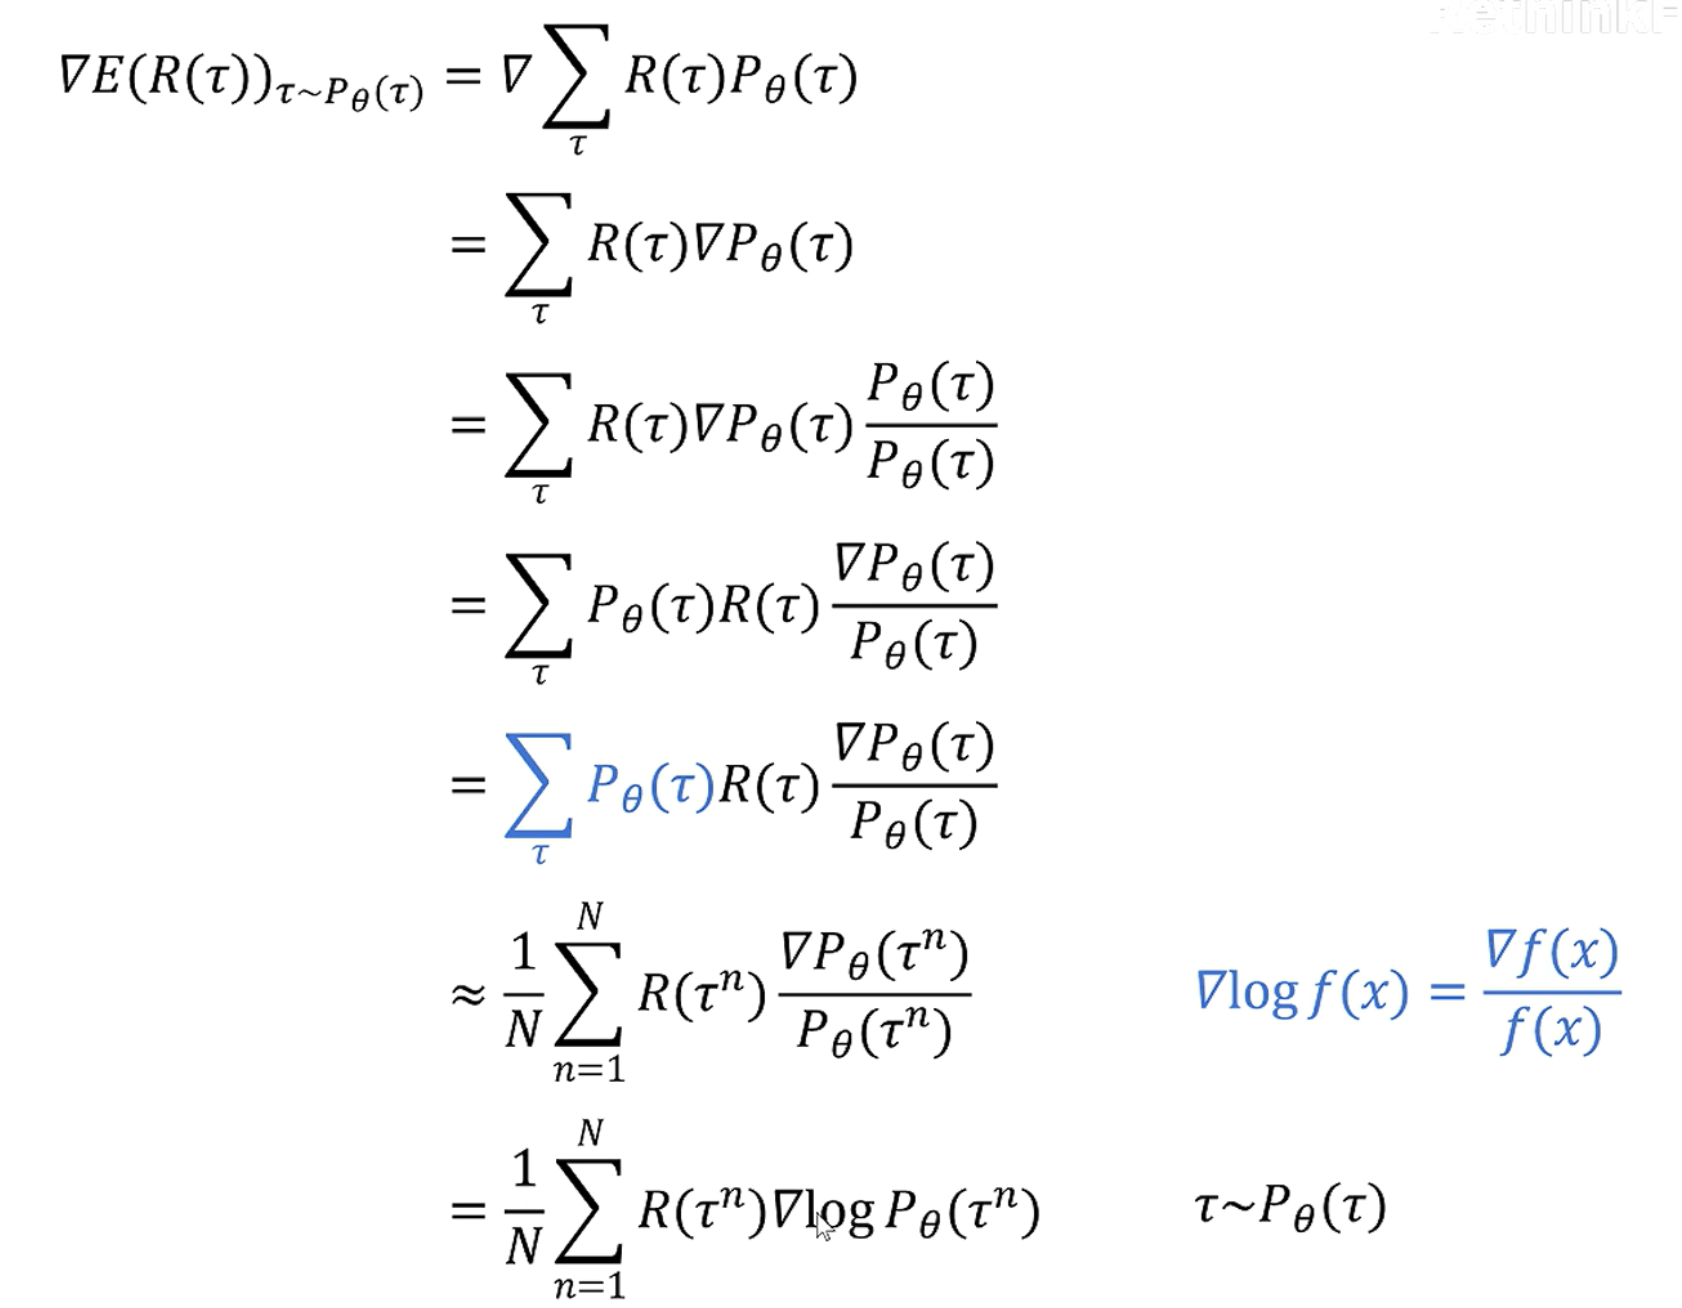
中间通过变换将P提出来,将梯度的计算转换成求期望的形式,最后变成多次采样求均值的形式
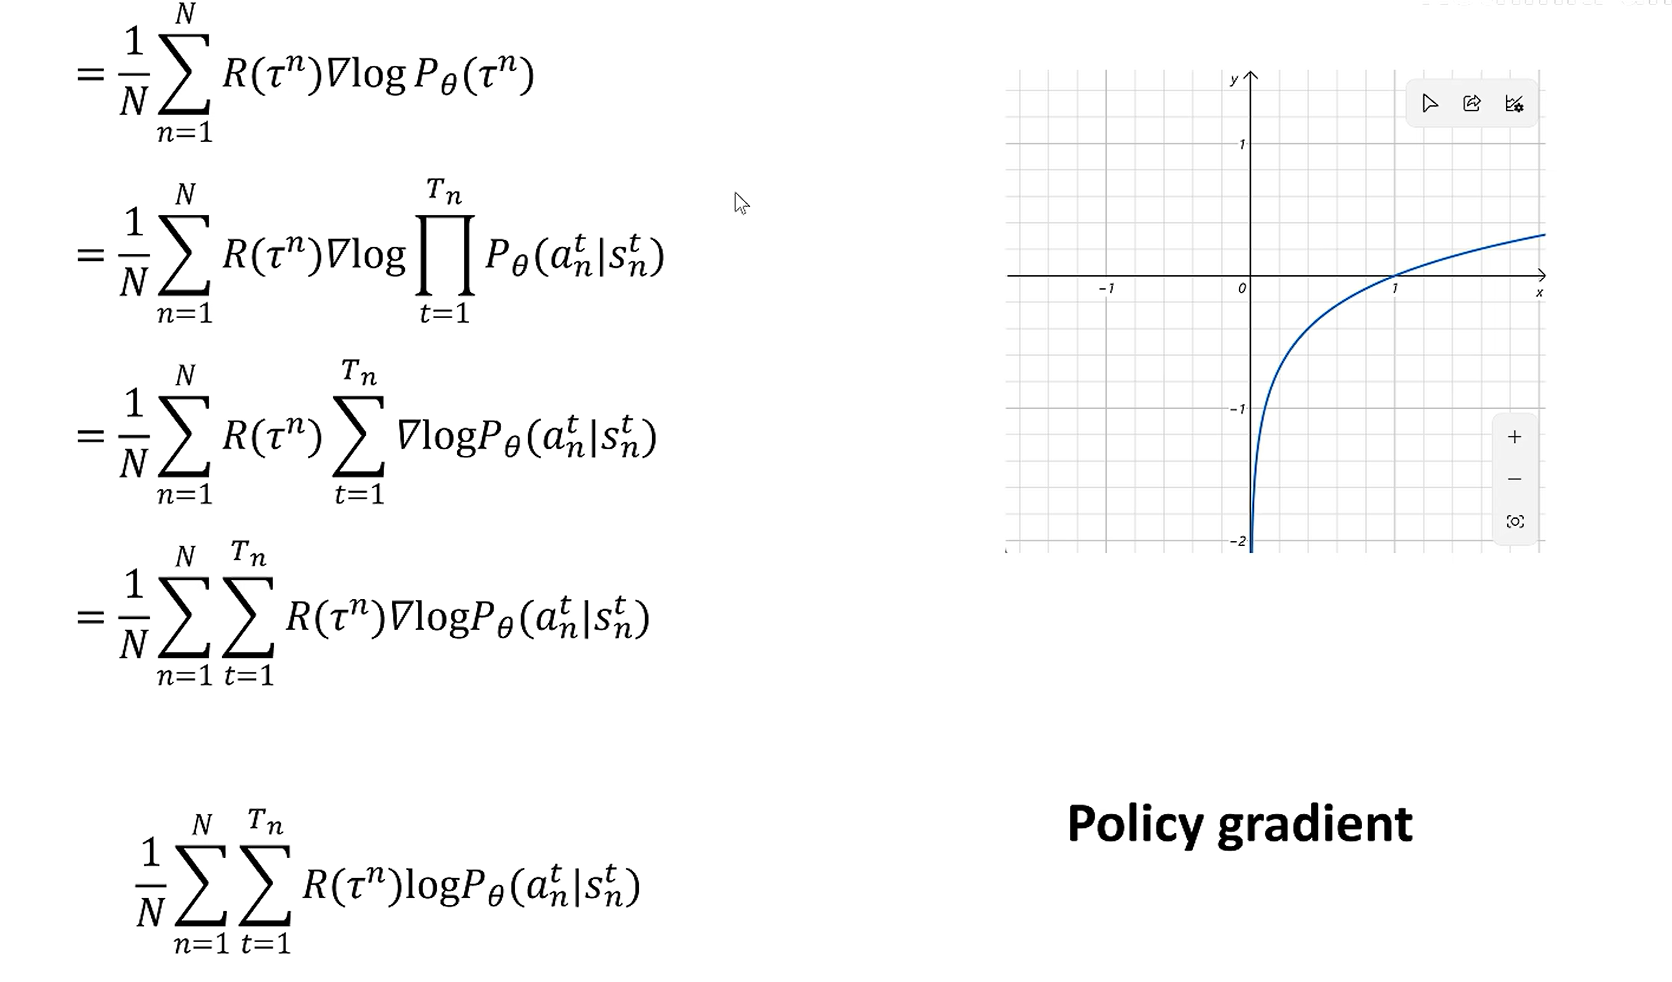
下一个状态由当前动作和当前状态决定,则
τ
\tau
τ的概率可以表示为一系列状态和动作概率的连乘。log里的连乘等于log外的累加,最后可以得到最下方这个双累加的表示形式
其代表,当r大于零,增大选择该策略的概率,当r小于零,降低选择该策略的概率
这样做的问题是大部分时间都用于进行 τ \tau τ的采样了,小部分时间用于更新 θ \theta θ以优化策略。
还有一个问题是实际过程中,某一步的概率是否增大和减小应该看其之后的奖励,而且其对后续动作的影响应该越来越小。现在这样 R ( τ n ) R({\tau}^{n}) R(τn)代表整个轨迹的奖励和,不会随着行为的选择而变化
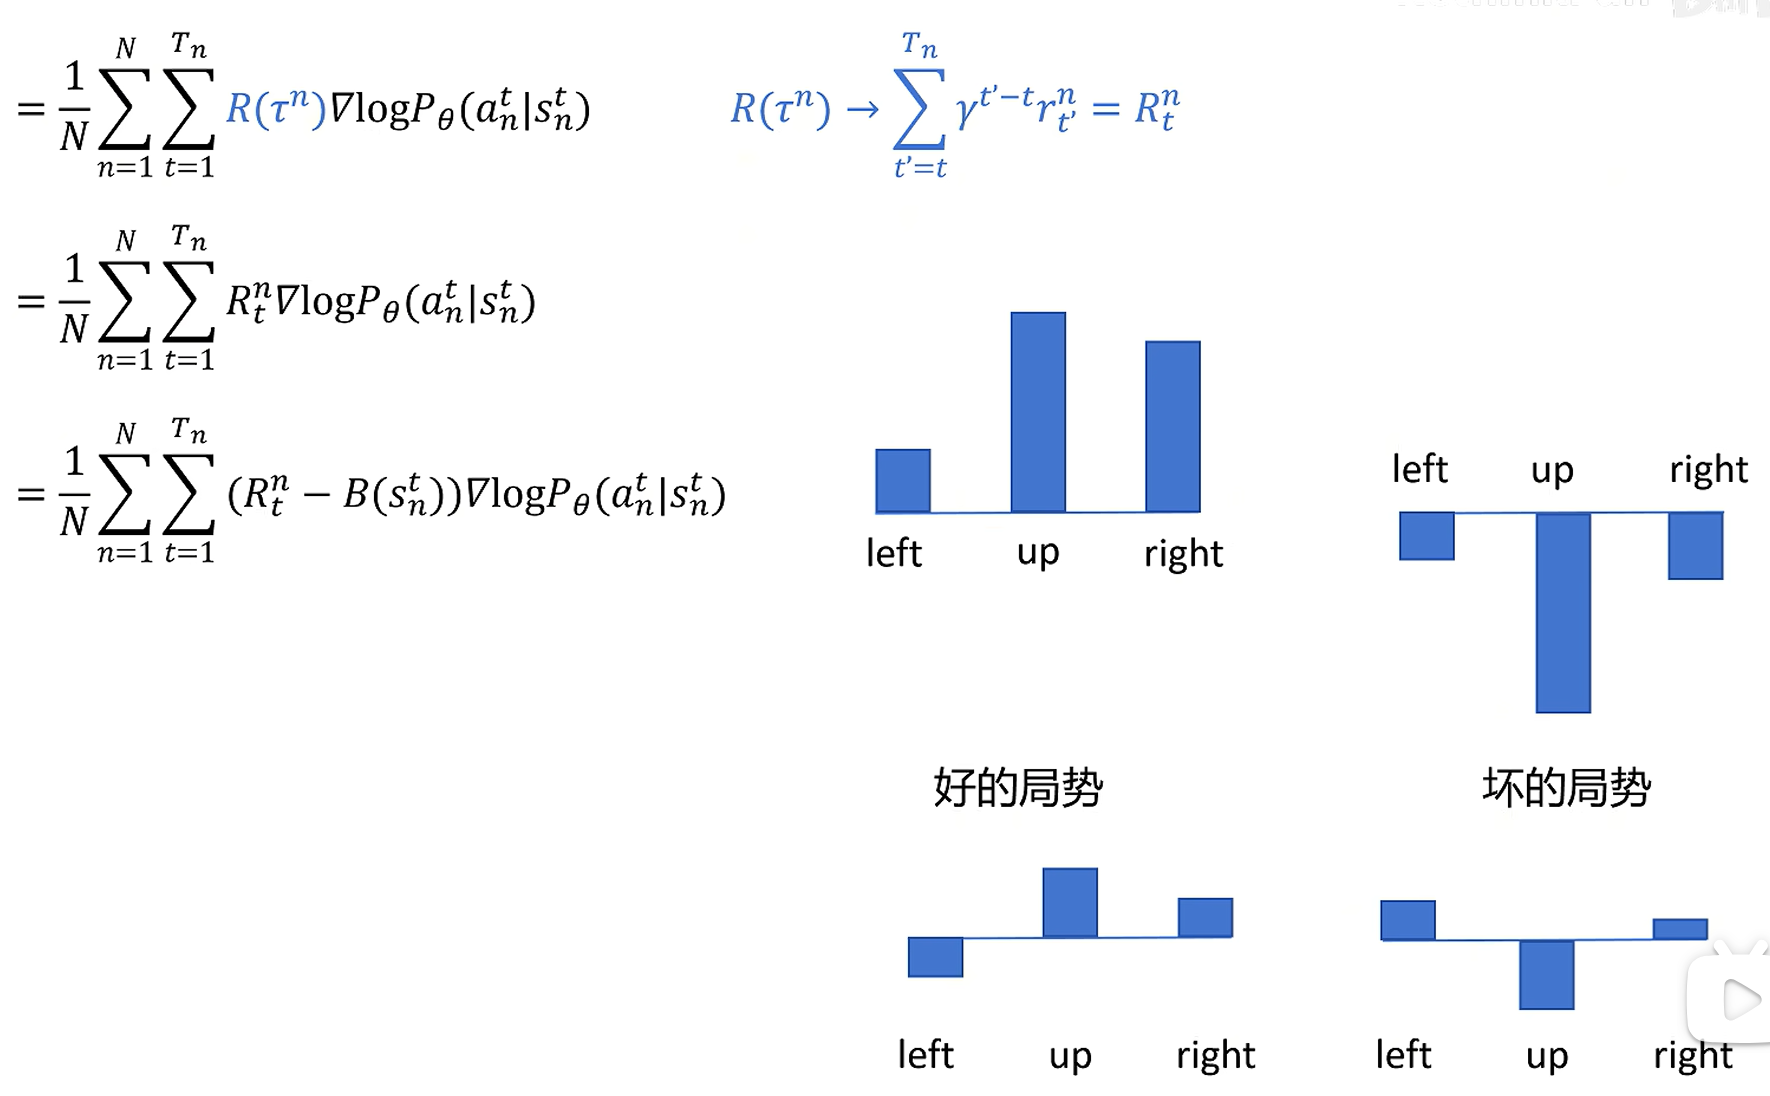
为解决这个问题,首先对奖励函数进行修改,现在奖励函数的值是根据当前的状态实时变化的,而不是在一条轨迹中从头到尾都是同一个值
其次为奖励函数添加了衰减因子,使每个动作对当前奖励的影响最大,越往后影响越小
最后添加了一个状态基线对奖励函数进行调节,使得相对差状态下的概率需要降低,相对好状态下的概率需要上升,而不是完全由奖励函数的正负来判断
行为价值、状态价值与GAE
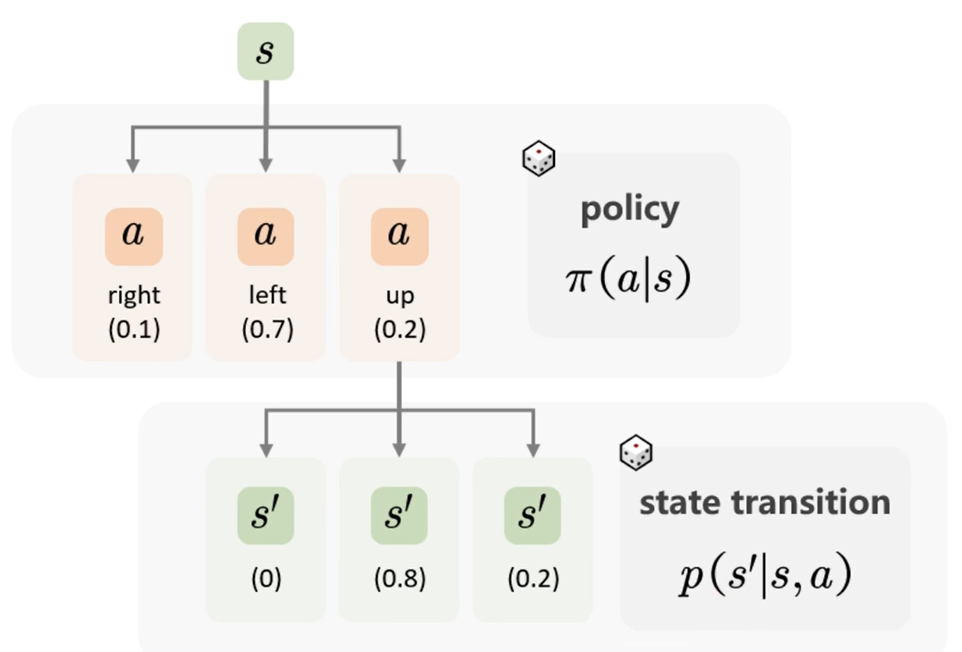
每个状态可能采取不同的行为,这些行为又可能会导向不同的状态。这其中会获得不同的奖励分数
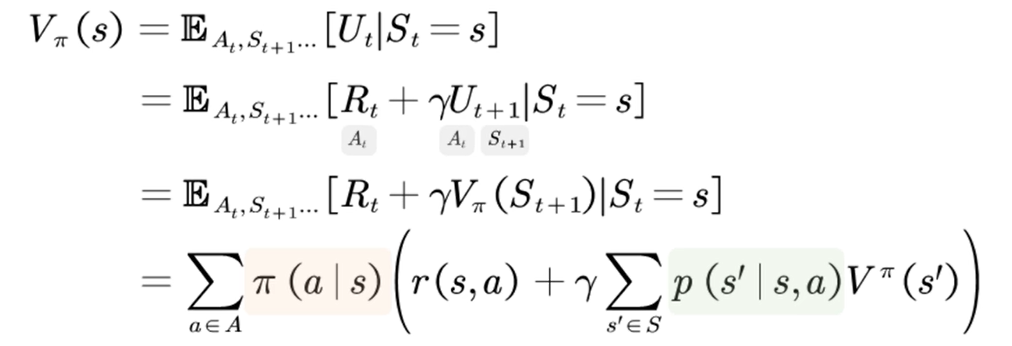
因此引入了这样的式子来衡量一个状态的价值
简单来说状态价值就是
选择某个行为的奖励加上
该行为引向的未来状态的价值期望乘衰减因子
的期望
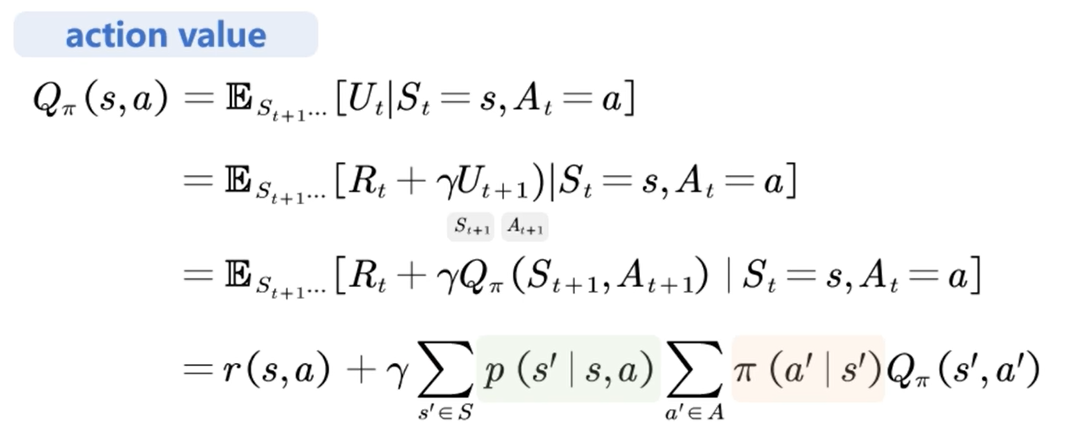
还引入了行为价值,可以看出,行为价值实际上就是当前奖励加上下一步状态价值的期望乘一个衰减因子,也就是说
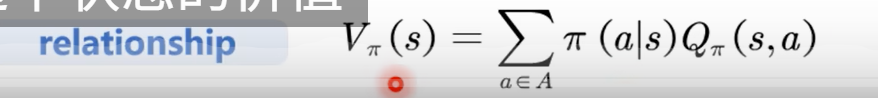
状态价值就是当前可能选择的行为价值的期望
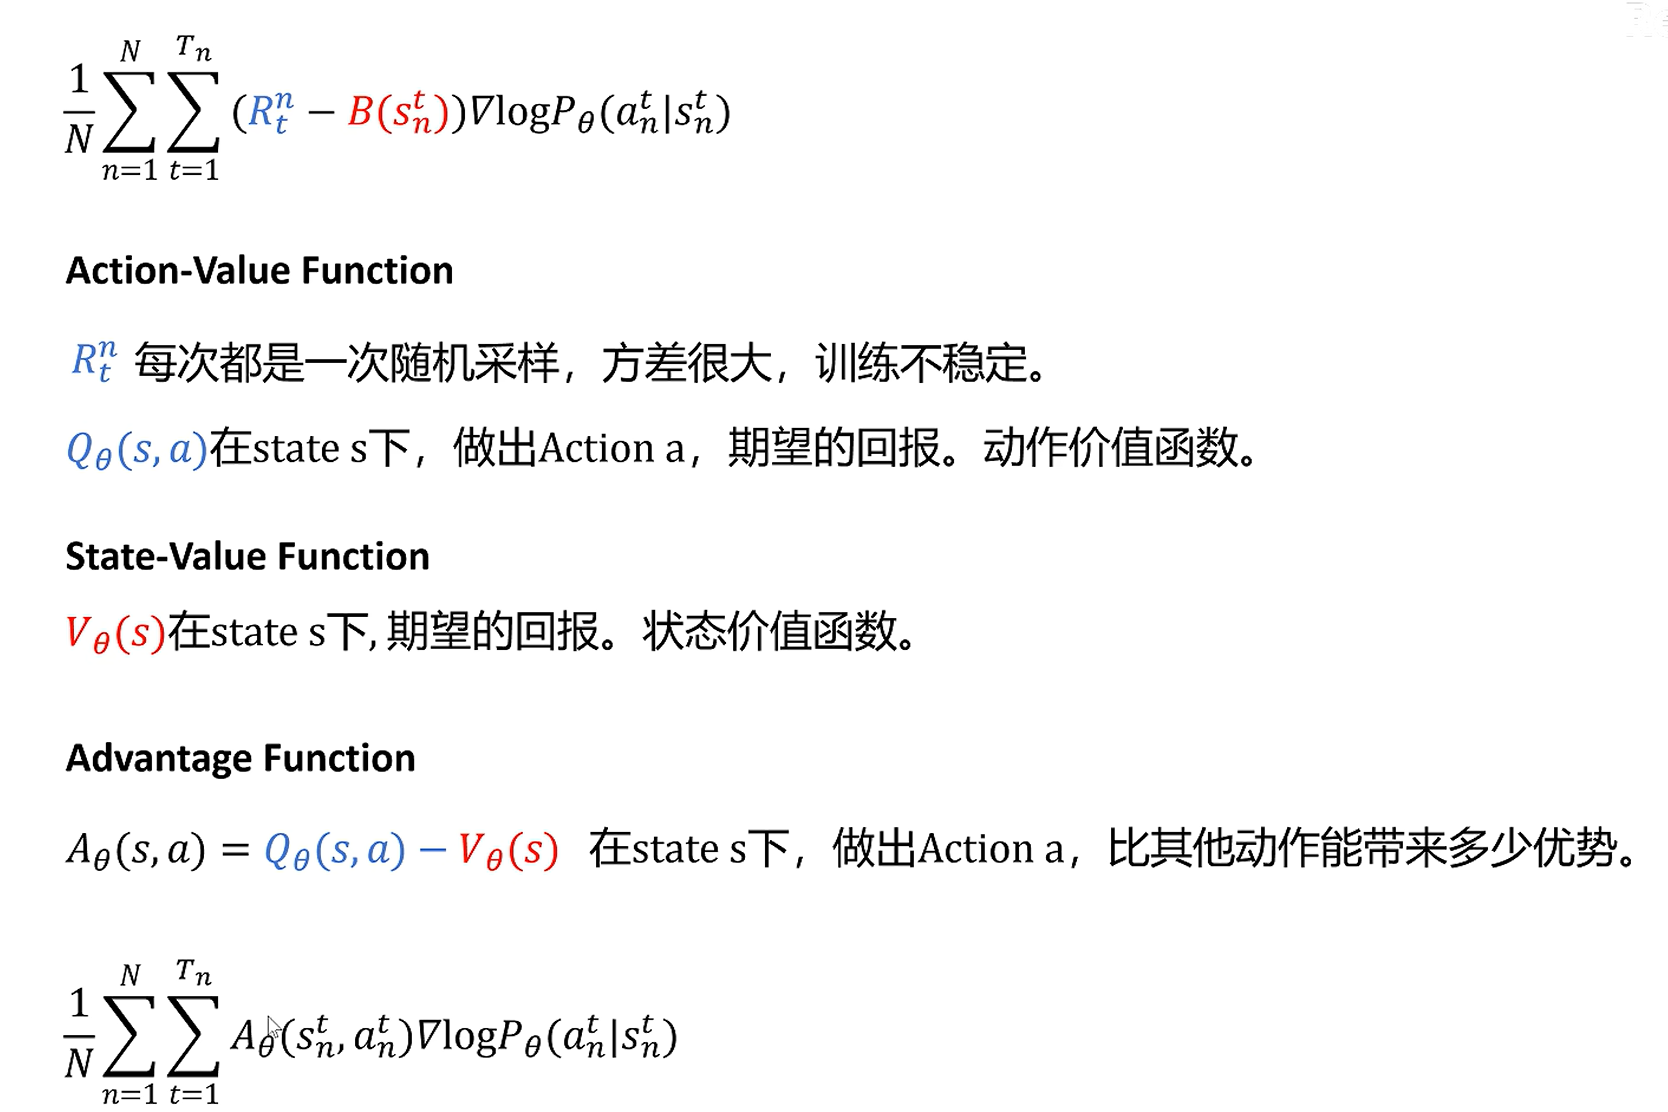
回到之前的回报期望上,原来的问题是采样Rt存在方差大的问题,因此选择引入了期望来稳定训练的效果,并引入了优势函数的概念。Rt减去基线的思路本身也蕴含着相比其他动作能带来多少优势的思想,所以两个方法的思路是一致的
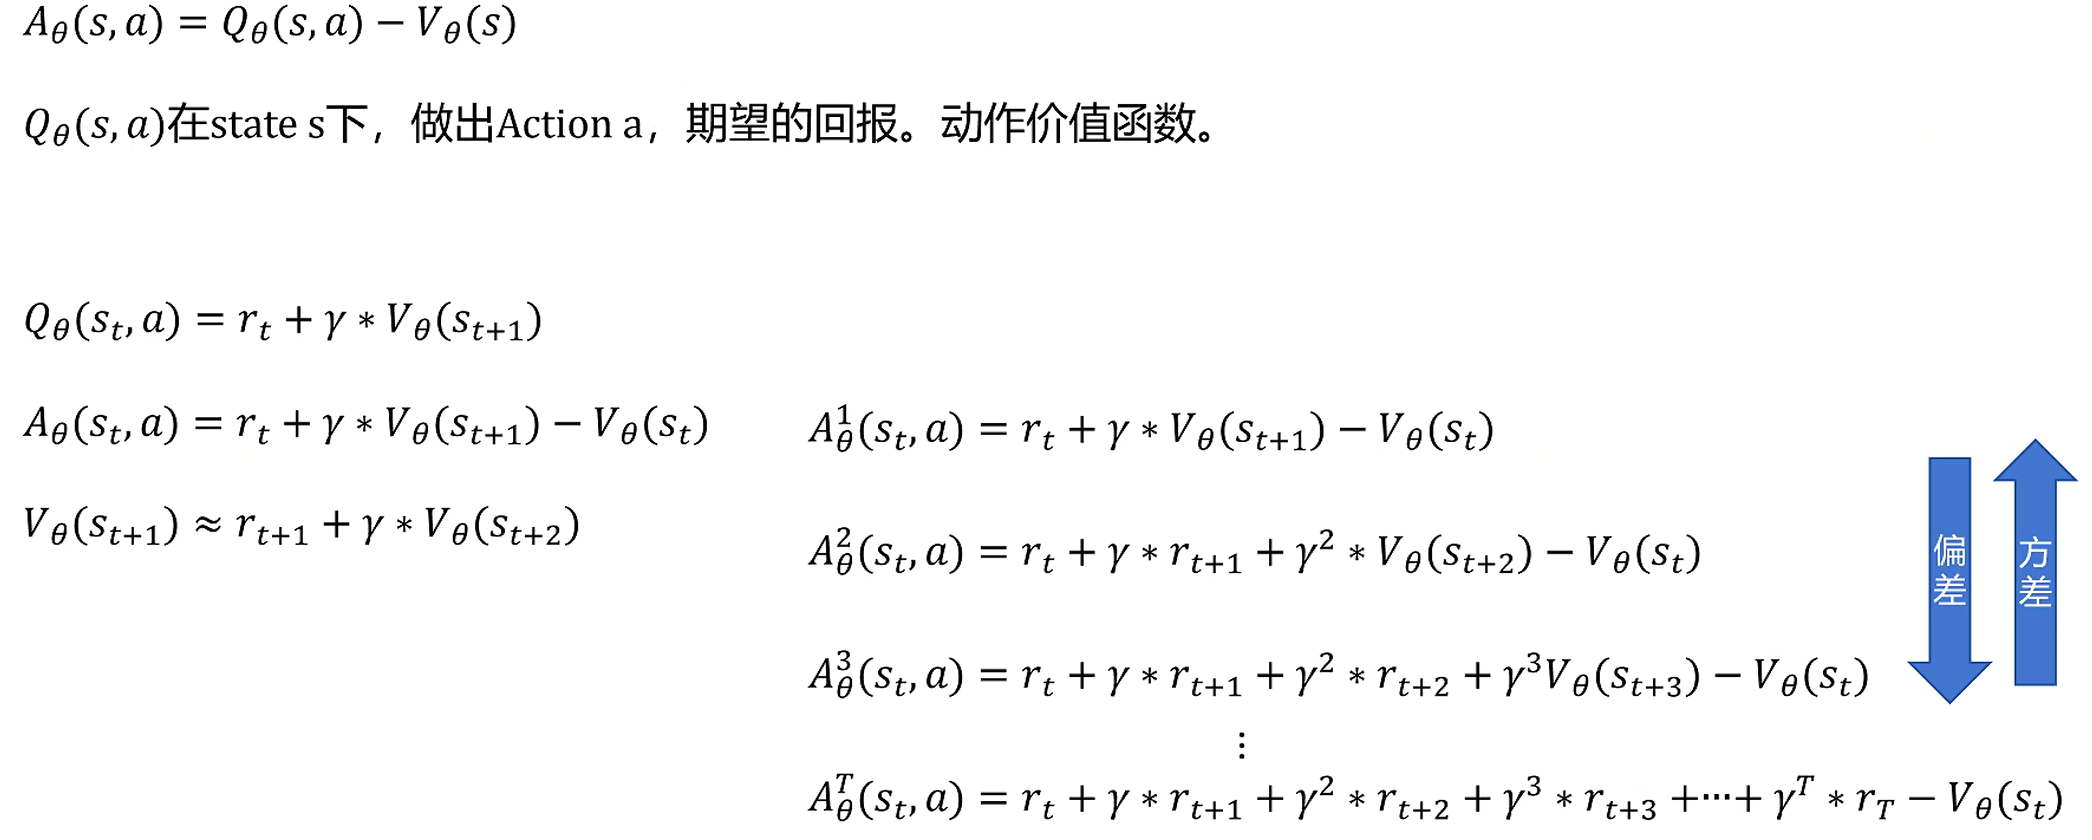
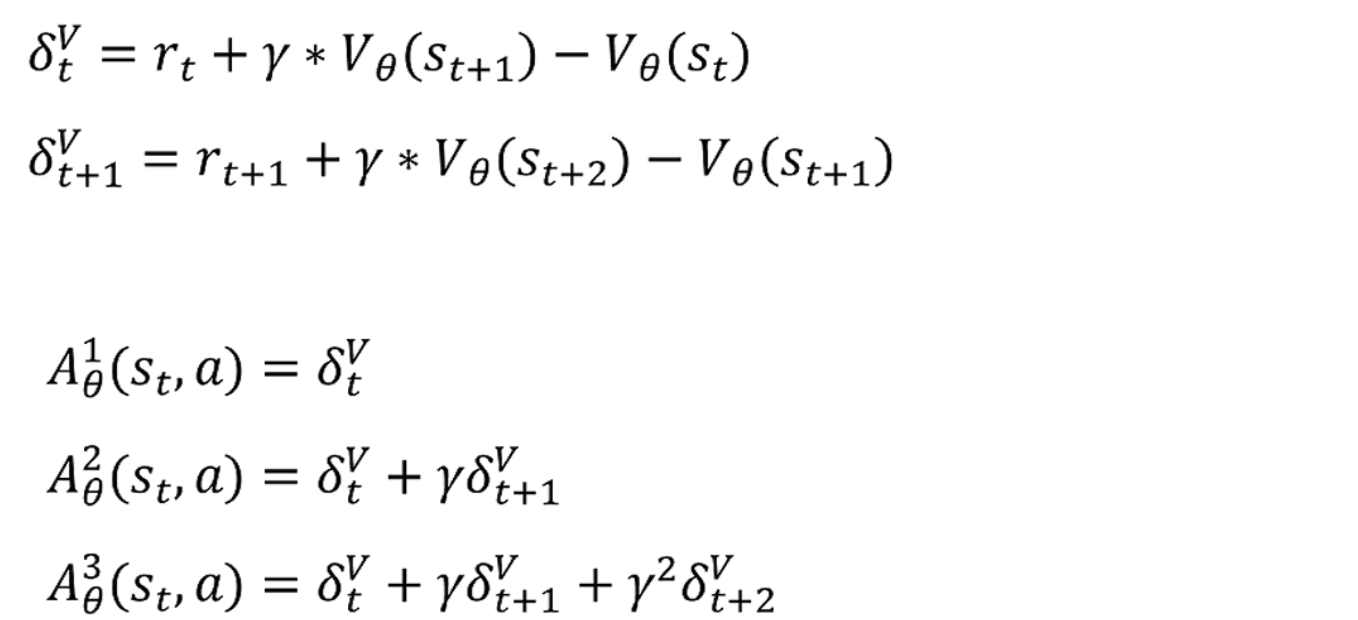
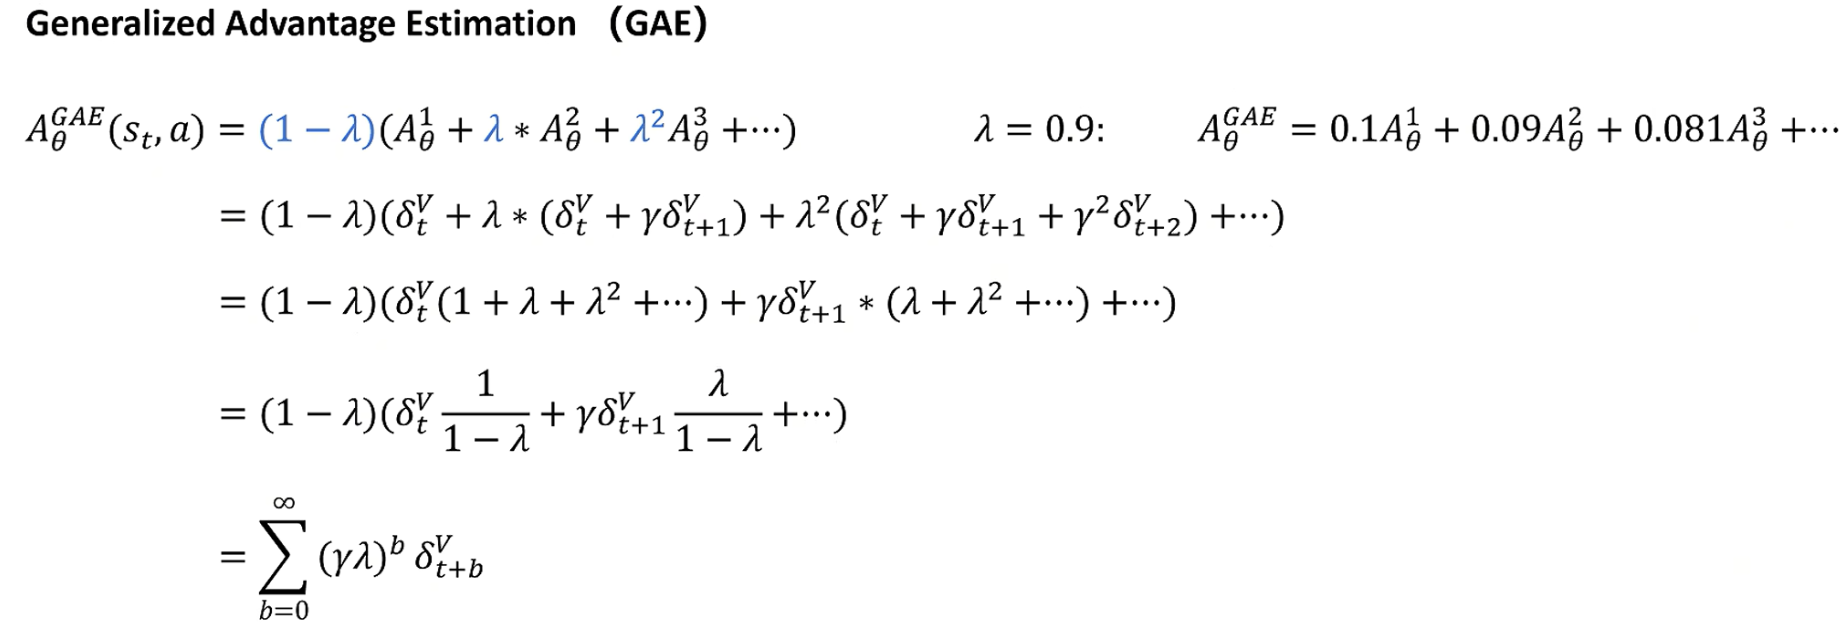
GAE的推导过程如上,其思路是优势函数采样的越详细,则偏差越小,但方差越大。反之偏差越大,方差越小。为了平衡偏差与方差,GAE选择对所有的采样步下的优势函数进行加权求和,中间利用 δ \delta δ项对公式进行化简
PPO
原来的方法叫on policy,问题在于采集数据的策略和训练的策略是同一个,这样导致每次训练完策略后之前的采样就要丢弃,每次都要重新采集数据
off policy:参考其他策略的结果进行训练,更新的策略和采样的策略不是一回事(比如杀鸡儆猴)
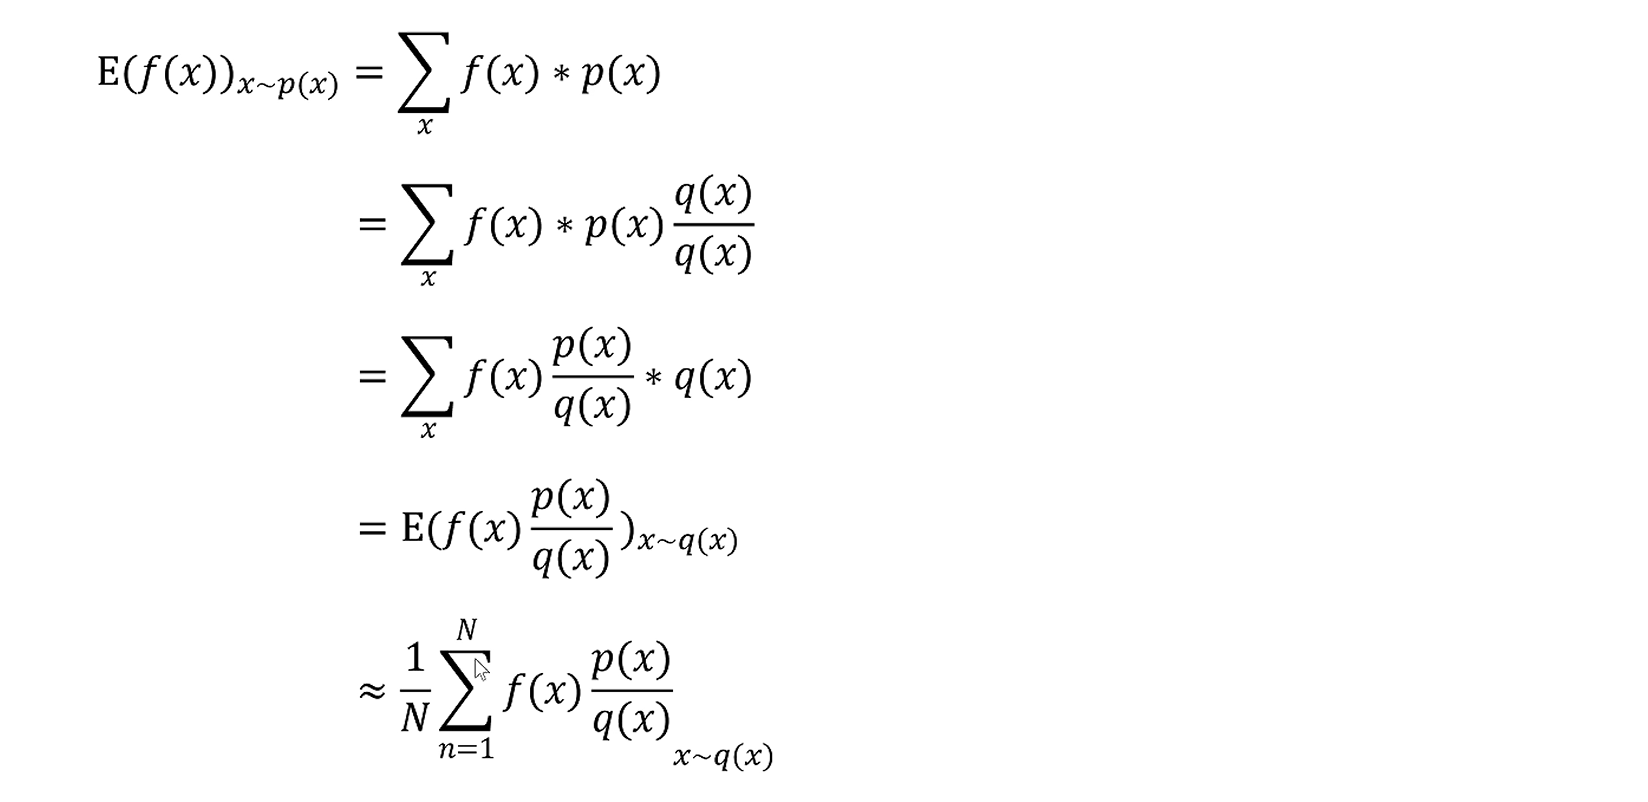
重要性采样的概念如上,简单来讲就是已知q分布,想在q分布上预测f在p分布上的期望,就需要乘一个重要性因子p/q
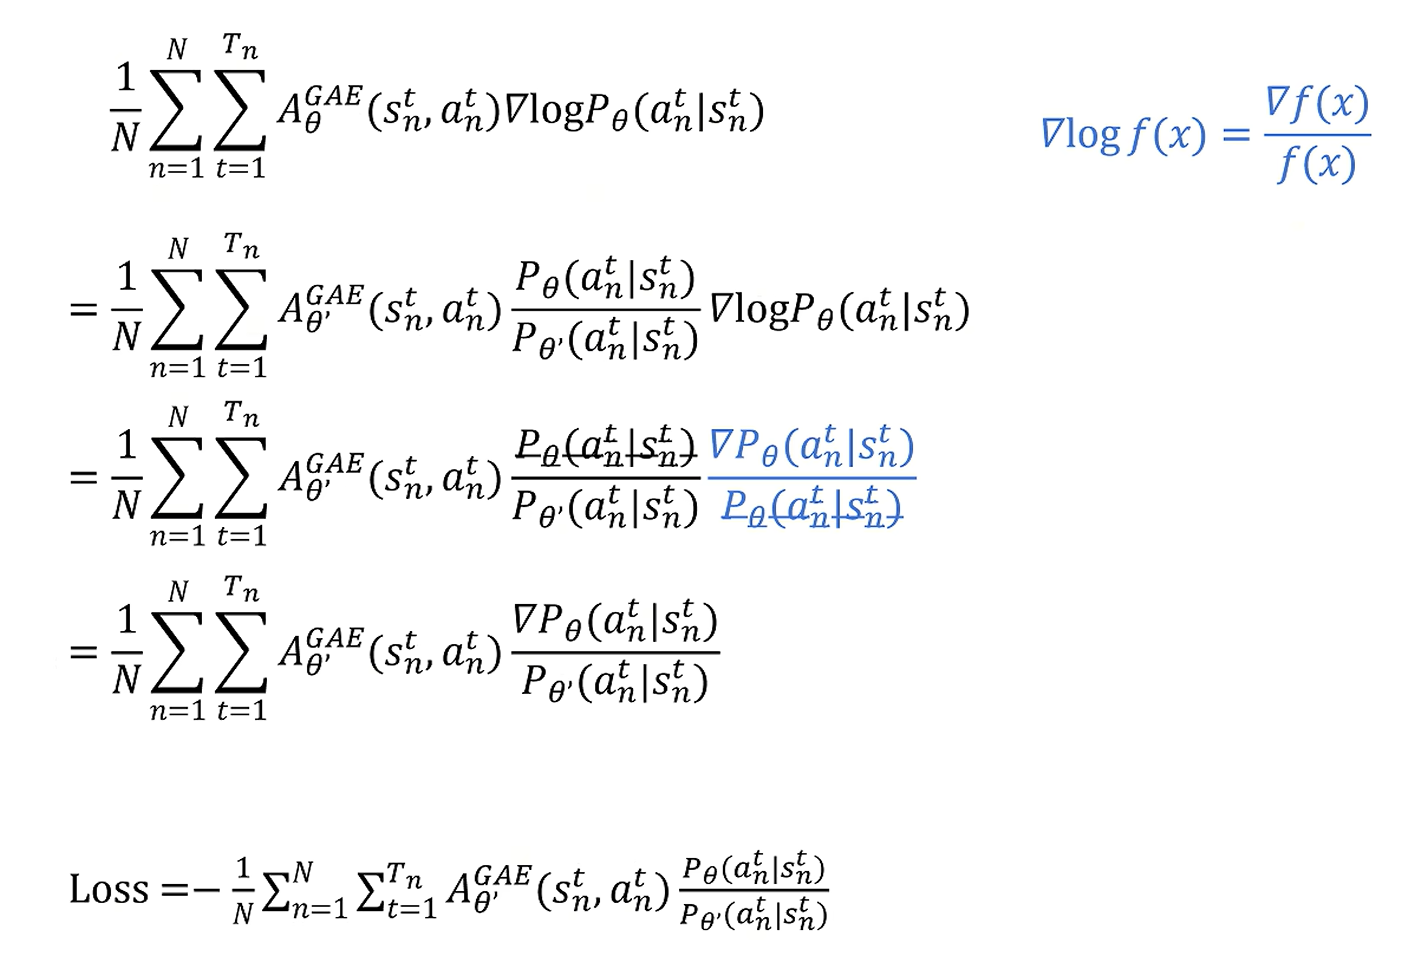
在ppo中,利用重要性因子,可以实现借助参考模型分布预测策略模型的分布
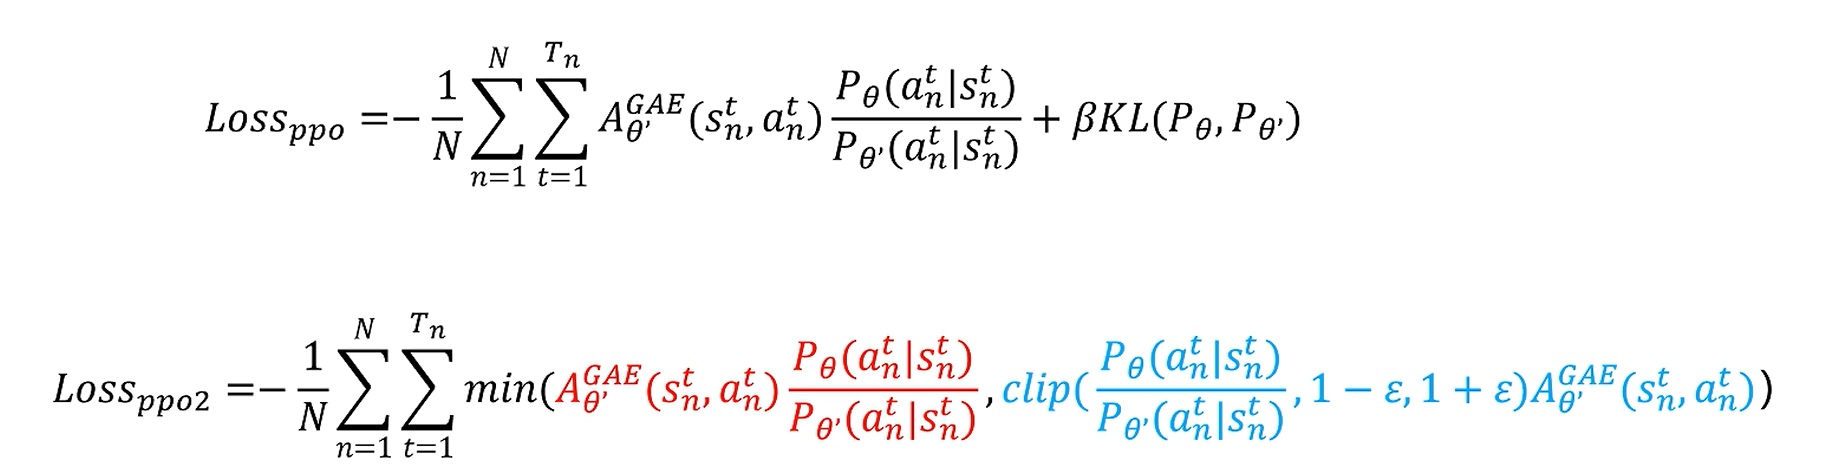
限制是两个分布的差距不能太大,因此要对两个分布的差距进行限制,一种靠kl散度来约束两个分布,另一种直接进行截断
奖励模型训练
在进行策略模型的训练前,要先训练出一个奖励模型对行为的奖励进行打分
奖励模型的数据由一个输入和两个响应组成,由人类对响应进行偏好选择,选出符合人类偏好的响应和被拒绝的响应
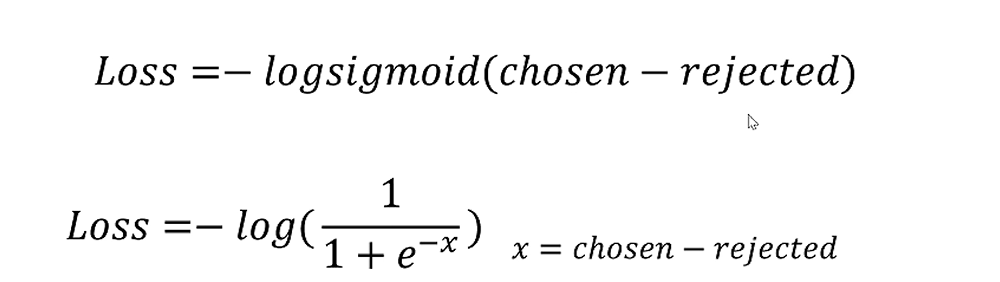
奖励模型会对两个数据进行打分,随后根据两个得分的差值来计算梯度
策略模型和状态价值模型训练
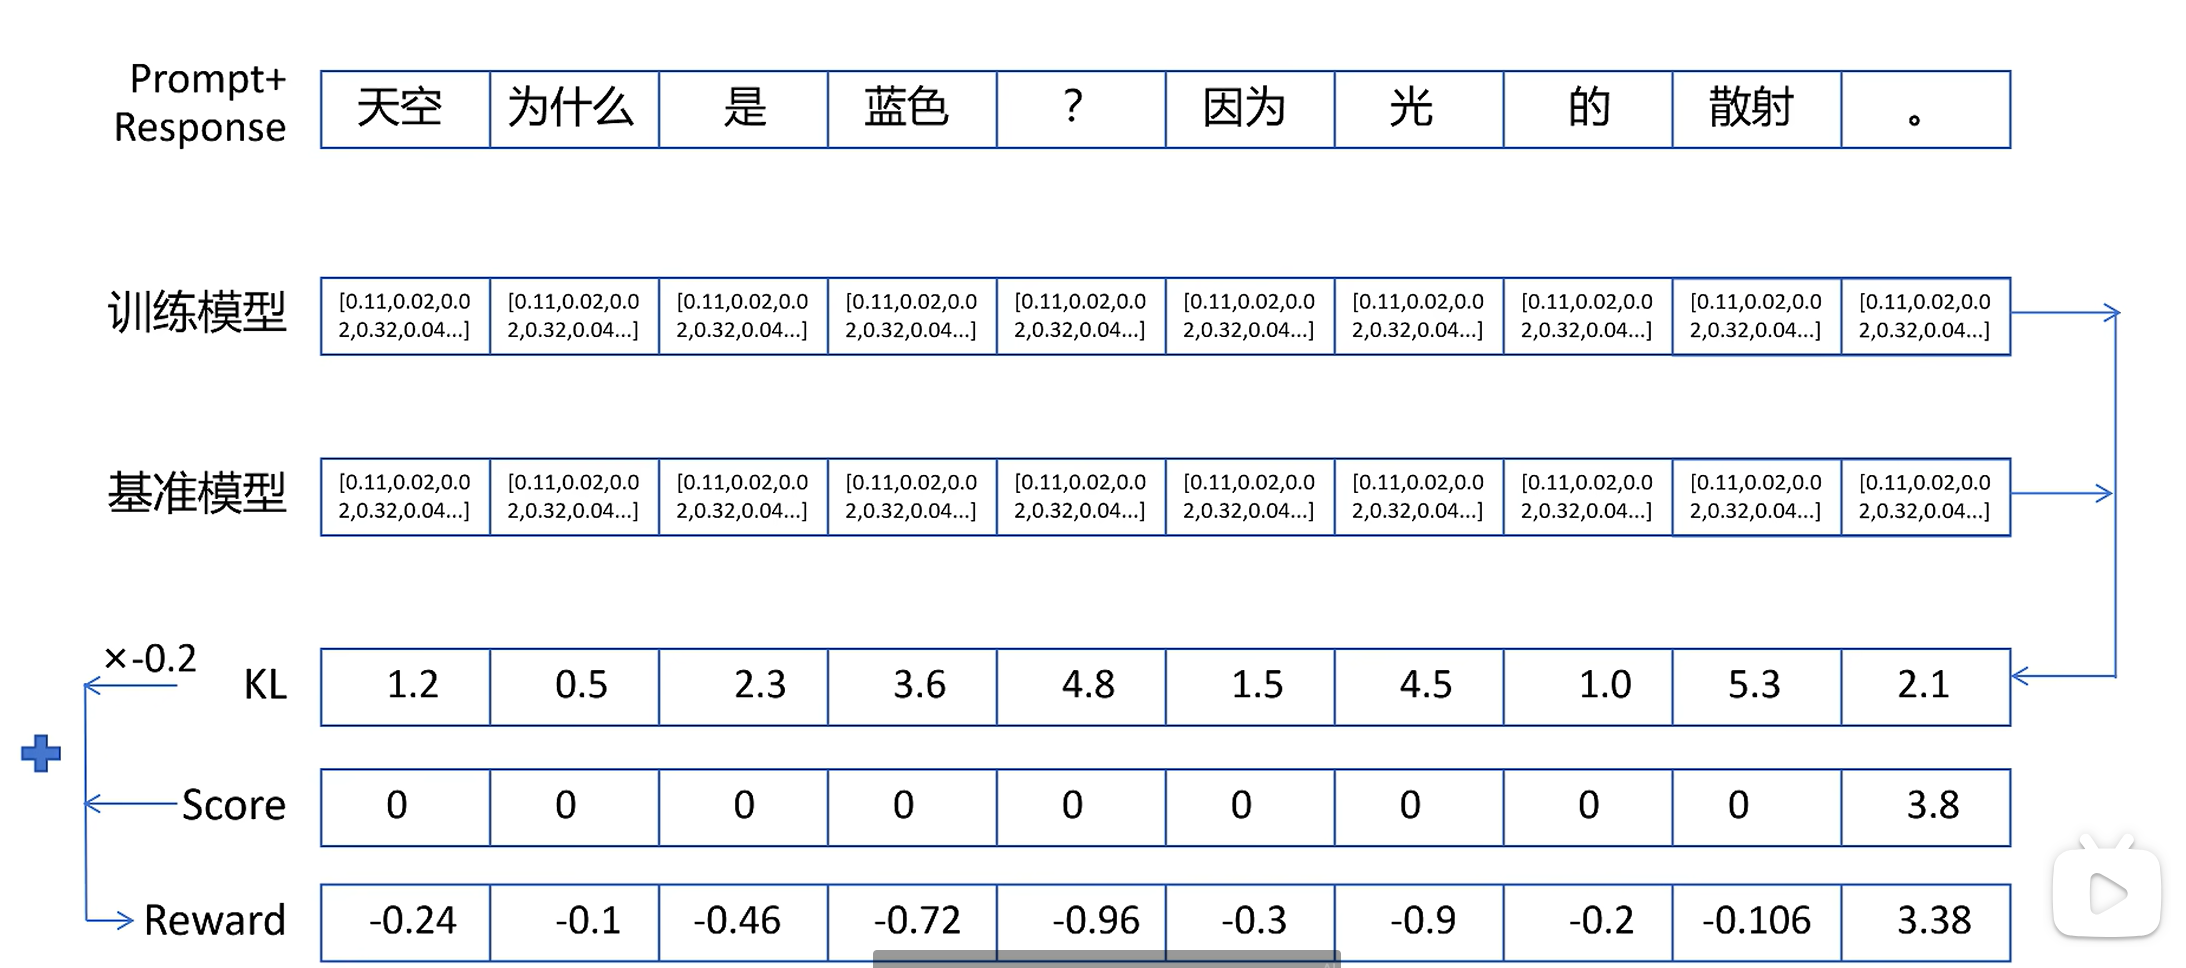
在进行训练前,会先进行一次采样,以获取状态价值、奖励等数据
随后可以计算出GAE
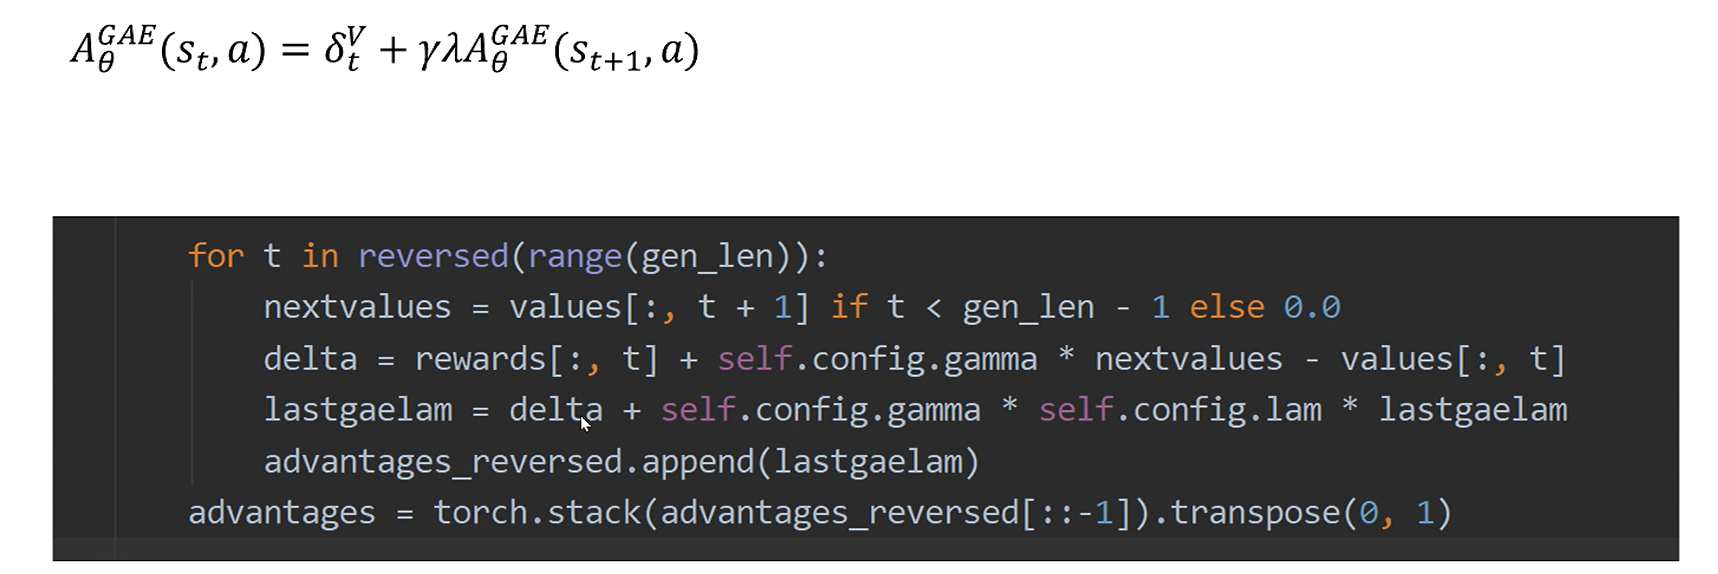
参考模型是不动的,奖励模型已经训练好了,剩下的就是策略模型和状态价值模型了
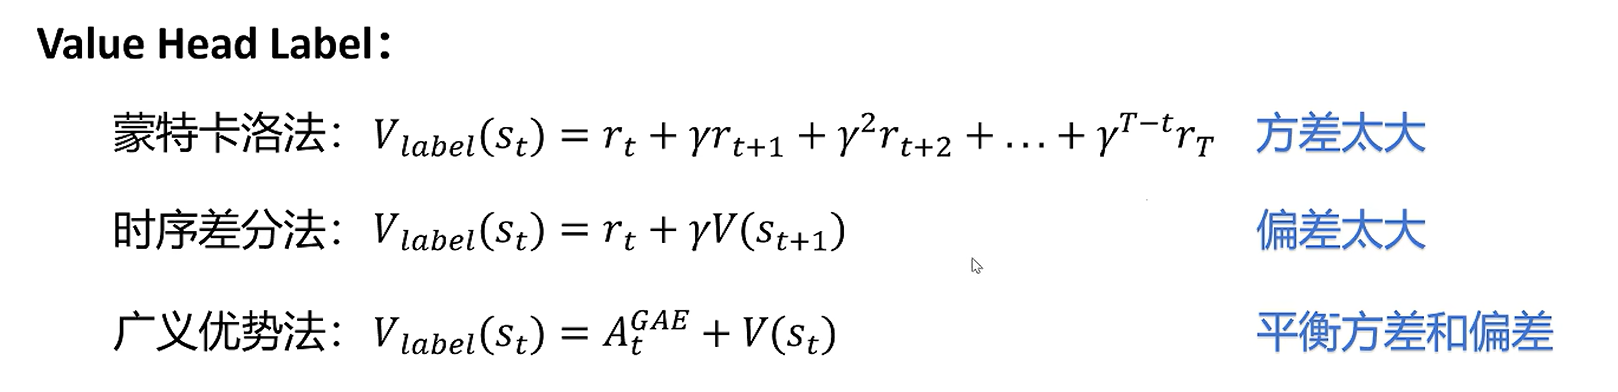
状态价值模型的标签用A_GAE+V表示,这里在前面表示行为价值的意思。按我的理解,状态价值模型本身预测的是状态价值,同时也是随机变量行为价值的期望。因此可以拿实际采样的行为价值和预测出来的行为价值期望做损失,以让模型更好的拟合行为价值的期望(状态价值)。
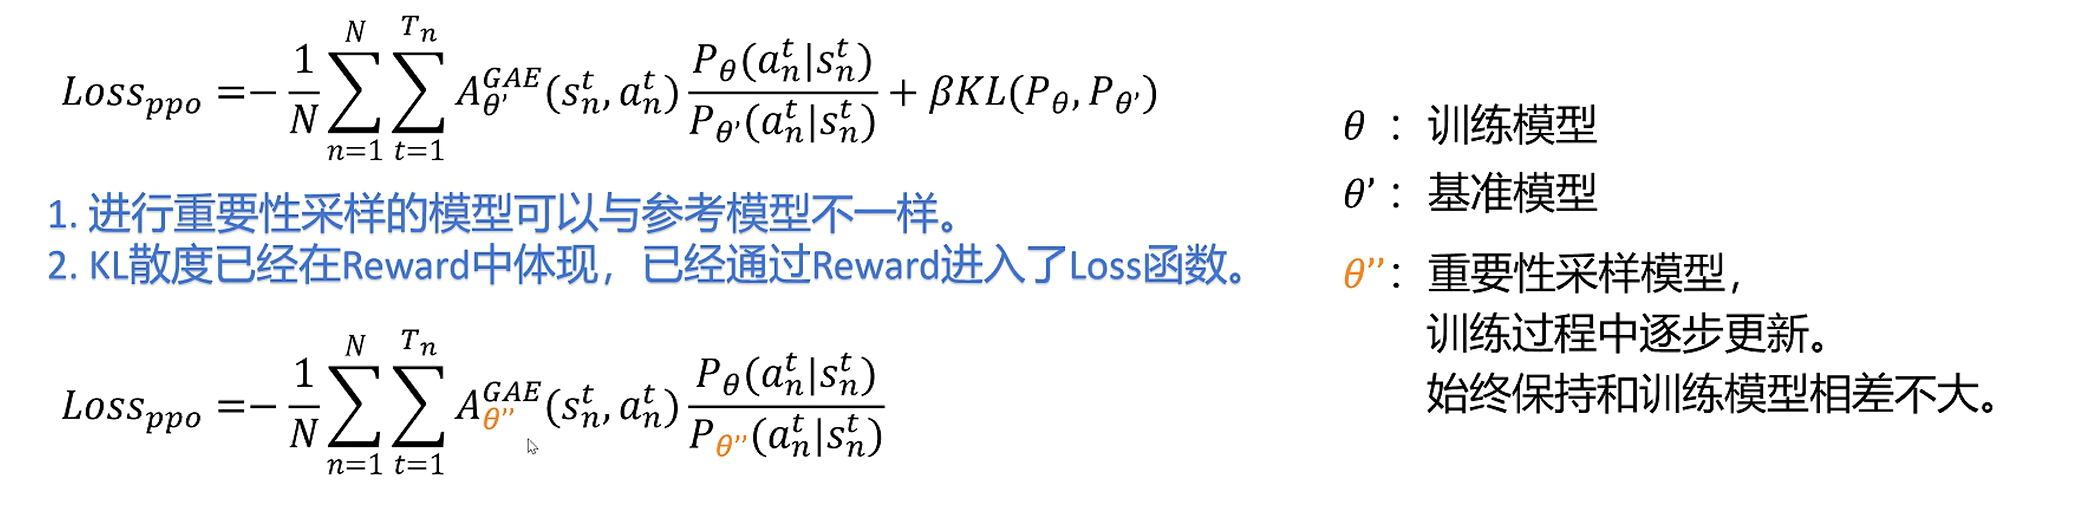
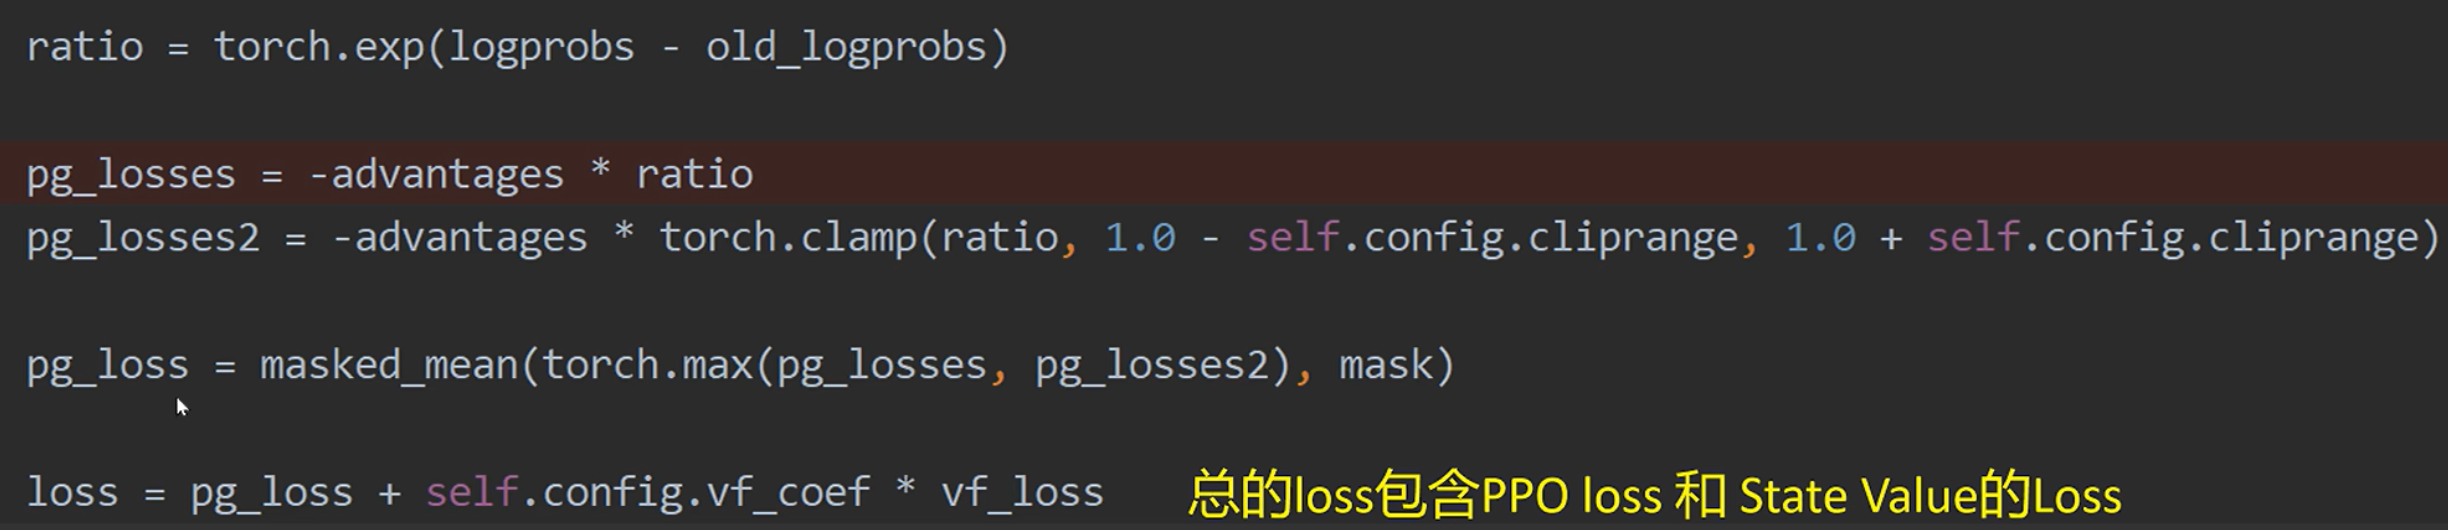
ppo损失的实现,kl散度的部分融合到了奖励部分,所以没有在这里体现出来

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 21
 0
- 0


 已为社区贡献2条内容

所有评论(0)