Redis:内存中的关系型数据库
Redis(Remote Dictionary Server)是一个开源的内存数据库,使用C语言编写,可基于内存亦可持久化,提供多种语言的API。它以其高性能、丰富的数据类型以及简单的单线程模型等特点而广受欢迎。Redis提供了一个高性能的键值(key-value)存储系统,能够支持每秒数十万次的读写操作,因此特别适用于处理高并发请求和需要快速响应的场景,如缓存、会话管理、排行榜等。它支持多种数据结构,包括字符串、列表、哈希表、集合、有序集合等,为开发者提供了灵活的数据操作能力,可以适应各种不同的应用场景
使用Redis来缓存一些经常被用到、或者需要耗费大量资源的内容,通过这些内容放到redis里面,程序可以快速读取这些内容,比如: 一个网站,如果某个页面经常会被访问到,或者创建页面时消耗的资源比较多,需要多次访问数据库、生成时间比较长等,可以使用redis将这个页面缓存起来,减轻网站负担,降低网站的延迟,比如说网站首页等。其实本质就是为了防止频繁的IO读写,将磁盘的数据读到内存中,这样就可以大大提高用户的访问速度。
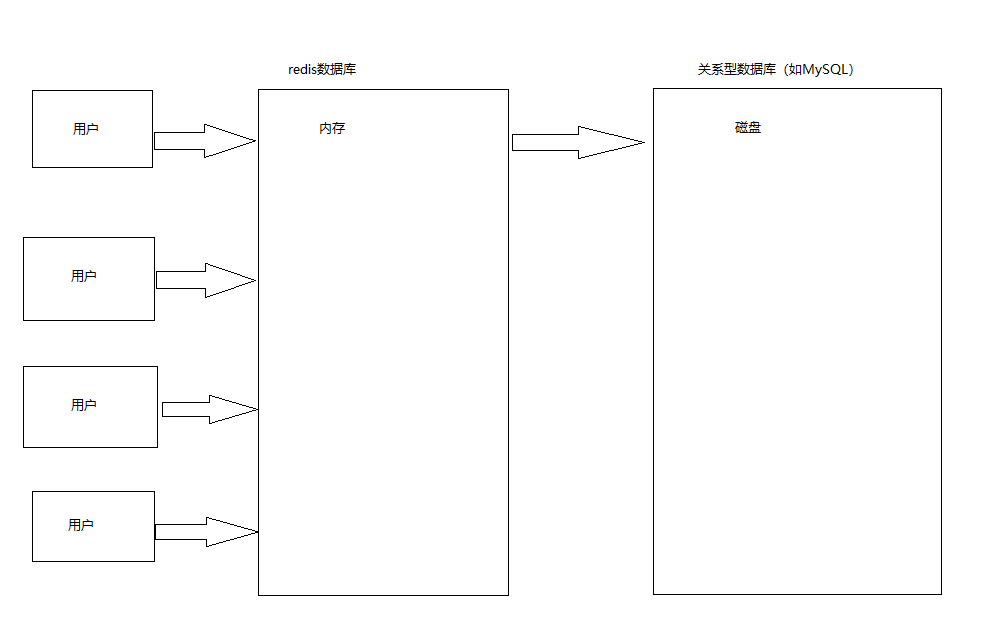
Redis和之前的MySQL差异很大,除了存储数据的位置不同,其底层的数据结构也截然不同:MySQL用的是B+树,Redis使用的是一种key/value结构的数据存储系统,为了便于对数据进行进行管理,提供了多种数据类型。Redis基于指定类型存储我们项目中产生的数据,例如用户的登录信息,购物车信息等等;Redis中基础数据结构包含字符串、散列,列表,集合,有序集合,工作中具体使用哪种类型要结合具体场景。
字符串(String)类型是最基本、最常用的数据类型,其简单的 key-value 模式拥有极其广泛的应用场景。它的简单恰恰是其强大和灵活性的来源。当需要缓存数据、进行原子计数、实现简单的分布式锁或存储任何简单的键值对数据时,String 类型通常是首选。
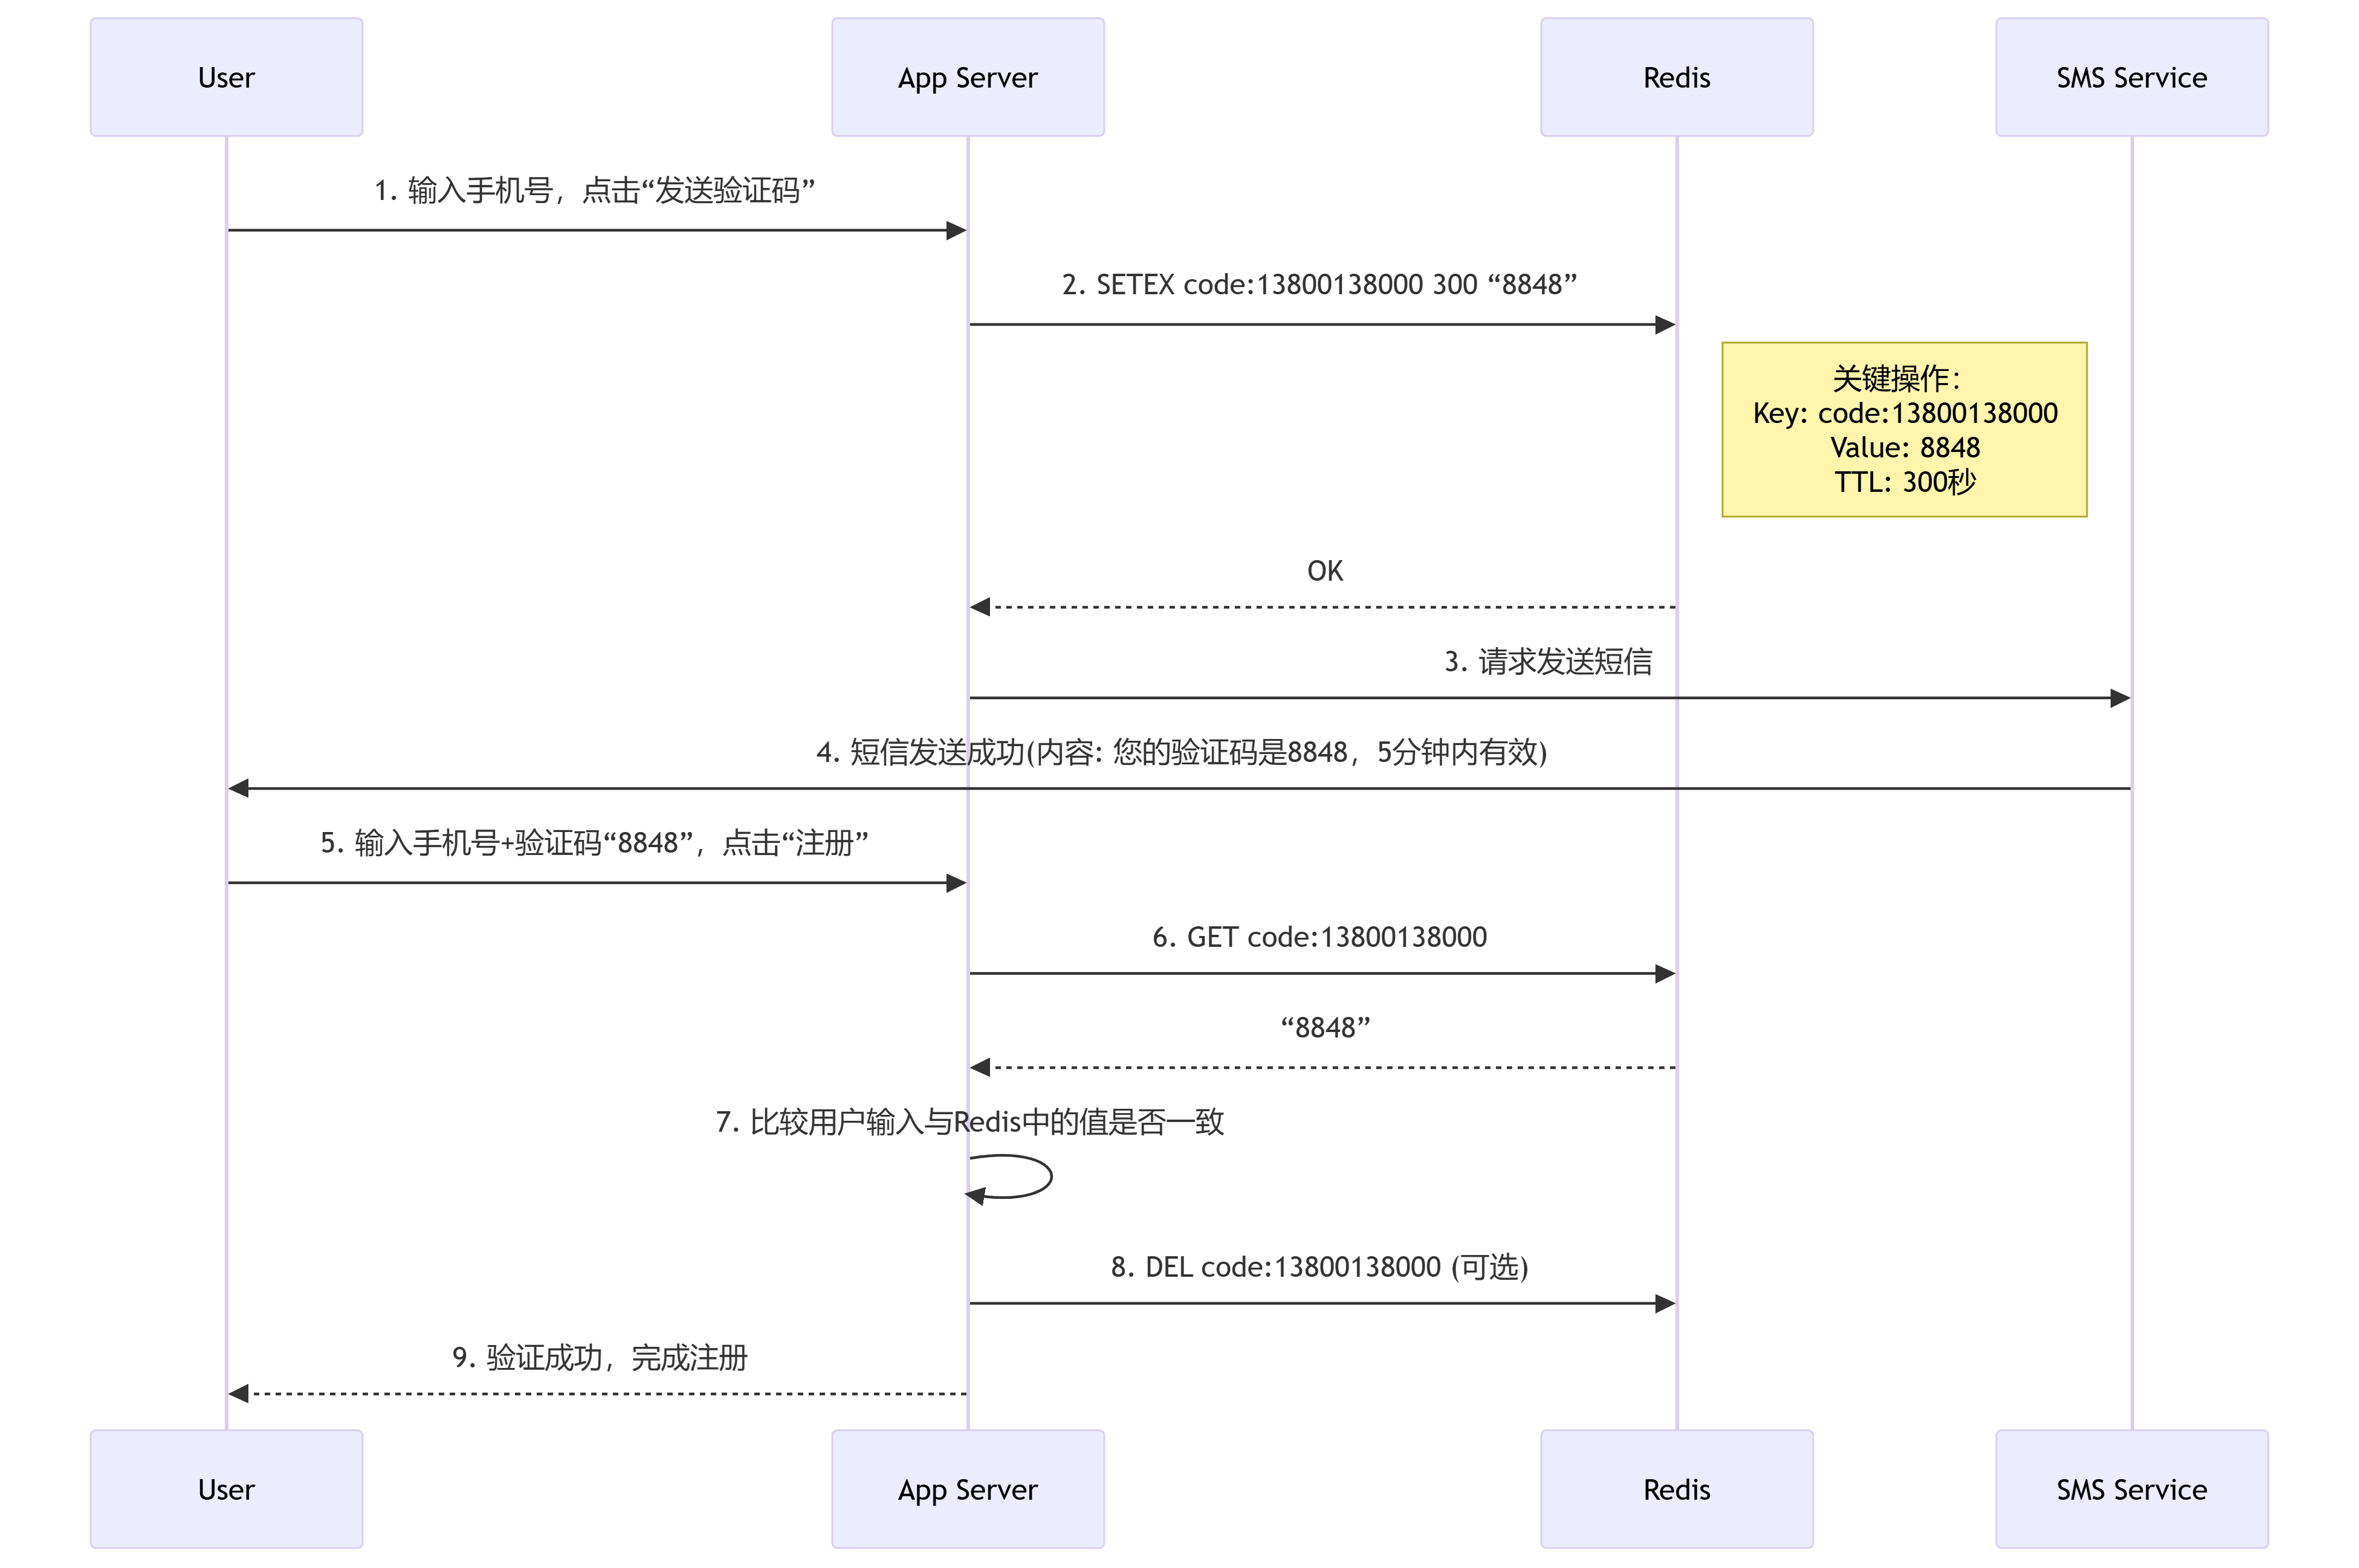
验证码也是Redis中string类的一个应用场景:在Redis收到需要发送验证码的请求时,Redis会将手机号设置为key,验证码设置为value,并加上一个ttl表示该验证码的有效时间,一旦超过这个时间验证码将会无效。接着由第三方平台发送信息到手机上,用户输入验证码,最后进行比较。这种简单的数据类型用string即可,但对于更复杂的结构化数据,再考虑使用 Hash、List、Set 等更专门的数据类型。
那如果是value有多个信息呢?假设需要存储有多个字段的用户对象,难道还将用户对象序列化为 JSON 字符串存储吗?其实更好的做法是直接使用Hash来存储,Hash散列的存储结构是一个 Redis 的 Hash 结构本身是一个键(key),这个键对应着一个内部的 field-value 映射表。适合存储多个字段的对象,并且可以单独读取、更新或删除某个字段,而无需操作整个对象,这非常节省网络带宽和内存。它不仅可以将相关的数据组织在一起,数据模型更清晰,还可以原子性地操作单个字段,而不影响其他字段,性能极高。
Redis 的 Hash 是存储结构化对象(如用户资料、商品信息、配置等)的首选数据结构。它在灵活性(可单独操作字段)、性能和内存效率之间取得了极佳的平衡。当你的数据模型是一个“对象”并且你需要频繁地访问或修改该对象的某些部分时,就应该毫不犹豫地选择 Hash。
List是一个双向链表的数据结构,通过它可以实现一个简单的、可靠的队列模型。这个队列模型基于经典的生产者-消费者模式:生产者 (Producer):负责创建消息并将其放入队列。在 Redis 中,使用 LPUSH命令将消息从列表左侧插入。消费者 (Consumer):负责从队列中获取消息并进行处理。在 Redis 中,使用 BRPOP命令从列表右侧阻塞地取出消息。队列:Redis 中的一个 List 数据结构,作为消息的缓冲区,连接生产者和消费者。这种设计(左进右出)形成了一个 FIFO(先进先出) 队列,最早进入的消息会被最先取出来处理,当然也可以是右进左出,只要能保证是一边进另一边出都没问题。
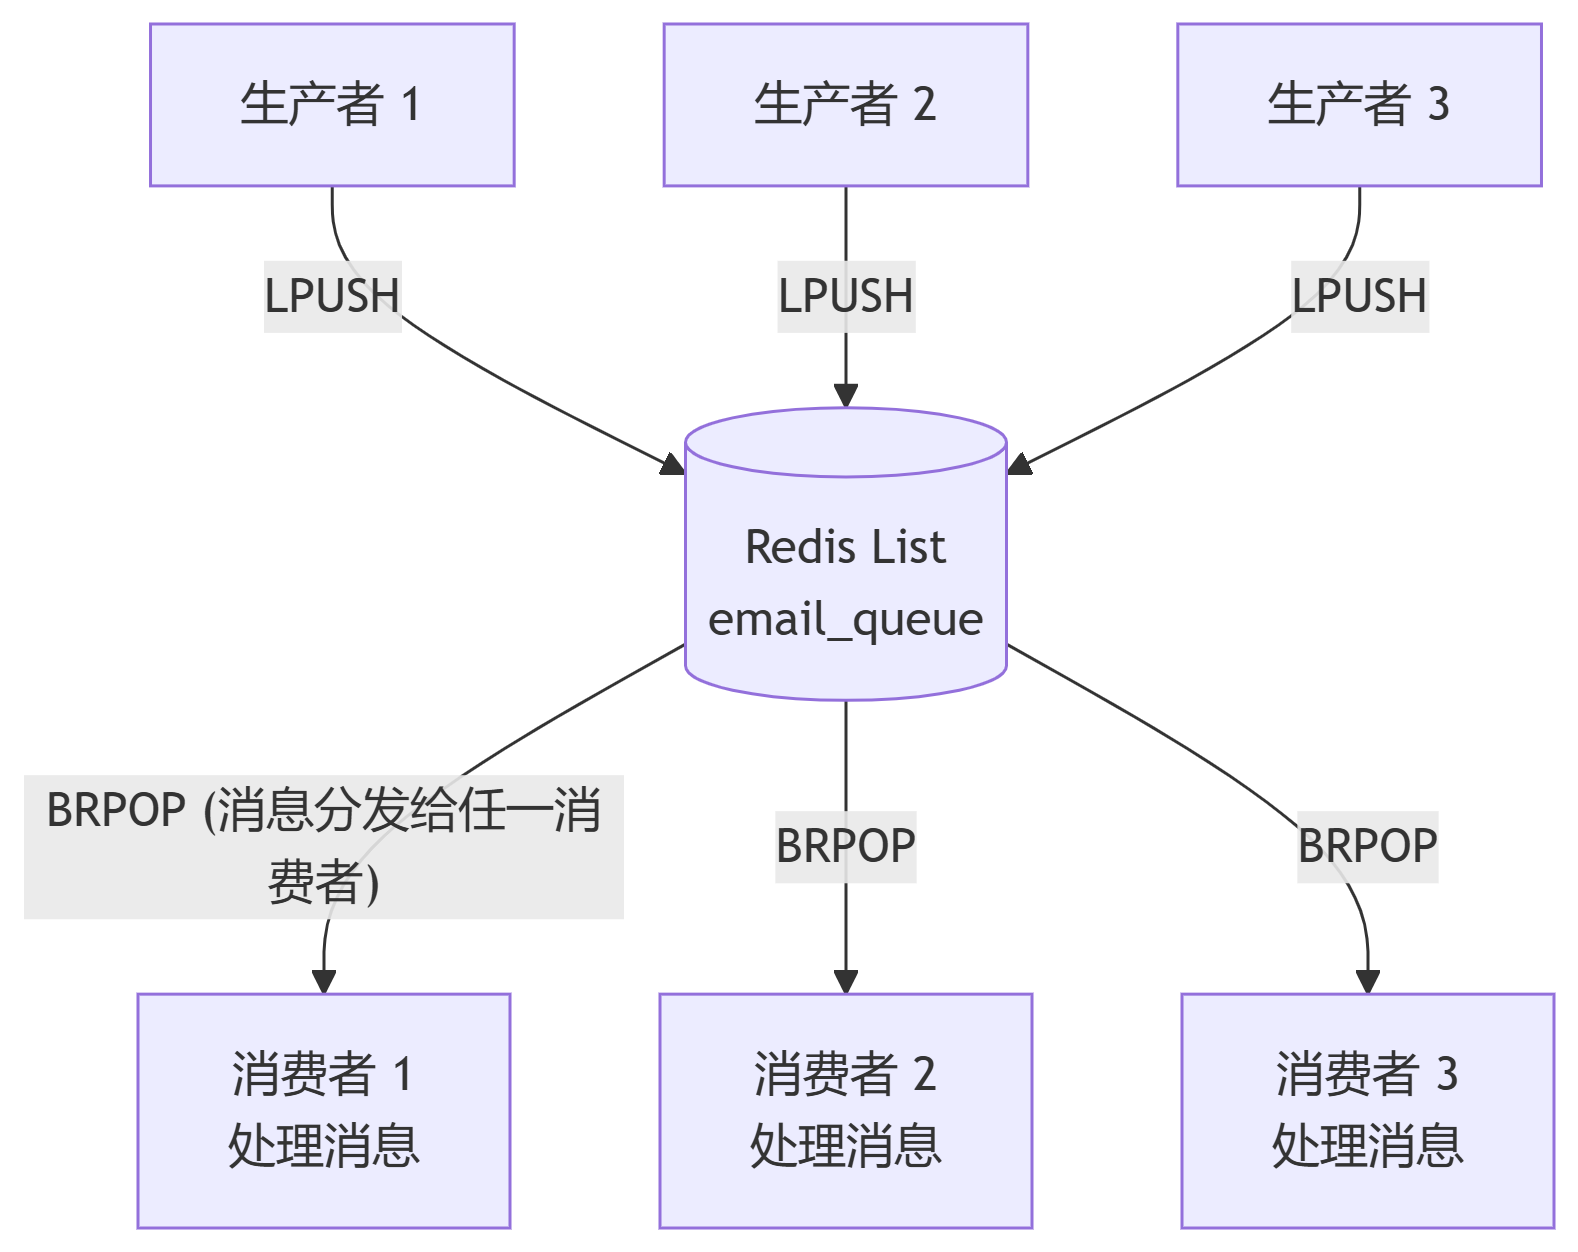
多个生产者不断使用 LPUSH 将任务放入同一个 Redis List。多个消费者(可以是分布在多台机器上的进程)同时使用 BRPOP 监听这个 List。Redis 会确保每个消息只会被其中一个 BRPOP 消费者获取并移除,从而天然地实现了负载均衡,即多个消费者并行工作,共同处理队列中的积压任务。消费者处理完任务后,再次调用 BRPOP 等待下一个任务。
虽然 LPUSH + BRPOP 在技术上可以实现一个简单的消息队列,并且在过去被广泛使用,但在现代企业级项目中,它确实已经很少被选为核心业务的消息中间件了。这背后的原因主要是业务对可靠性和功能性的要求越来越高。Redis List 作为队列的缺陷在这些要求面前被放大了。另一方面,现在已经有了更专业的做消息中间件的框架RabbitMQ。它专门为消息队列场景设计,弥补了 List 的所有缺陷:支持消费者组、支持消息确认、支持消息回溯。
Redis的Set类似Java中的HashSet,是string类型的无序集合。集合成员是唯一的,这就意味着集合中不能出现重复的数据。
当你需要处理以下需求时,应优先考虑使用 Redis Set:需要存储一个不重复的数据列表;需要快速判断某个元素是否存在于一个巨大的集合中(SISMEMBER 是关键);需要对多个集合进行聚合操作(求交集、并集、差集)。
注意事项:SMEMBERS 命令在集合很大时会返回所有元素,可能导致服务器阻塞。可以考虑使用 SSCAN 命令进行迭代式遍历。总而言之,Redis Set 凭借其无序唯一的特性和强大的集合运算能力,在实现社交功能、标签系统、唯一计数和随机化等场景中是不可或缺的利器。
Redis 的 Sorted Set(有序集合)Zset 是一种非常强大的数据结构,它结合了 Set(集合)的唯一性特点和列表的排序功能。Sorted Set 允许您存储一系列成员(member),每个成员都关联了一个分数(score),这个分数决定了成员在集合中的顺序。Sorted Set 的成员是唯一的,但是分数可以重复。经常应用于热门文章的排行,用户积分系统等。也叫Zset
Redis 作为一个内存数据库,所有数据默认都存储在内存中,这使得它速度极快。但内存是易失的,断电后数据就会消失。持久化机制就是为了解决这个问题而存在的,它通过创建磁盘上的副本,在需要时(如重启后)可以将数据重新加载到内存中,恢复之前的状态。这时候就需要进行数据持久化,它指的是将存储在内存中的数据(如 Redis 的数据)保存到可永久存储的磁盘上,以防止因进程退出、服务器宕机、断电等意外情况导致数据丢失。
Redis 提供了两种主要的持久化方式:RDB 和 AOF。它们可以单独使用,也可以同时开启(推荐方式)。
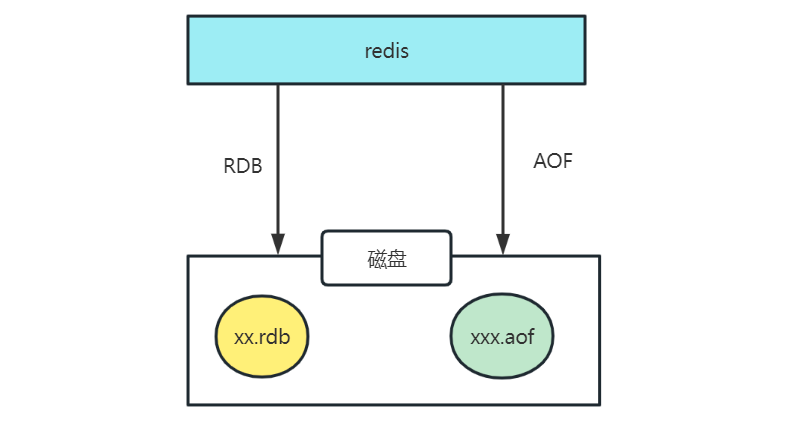
RDB核心思想:在指定的时间间隔内,将内存中整个数据库的快照(Snapshot) 完整地保存到一个二进制文件中(默认文件名为 dump.rdb)。
当满足配置条件时(如“900秒内至少有1个键被更改”),Redis 会 fork 一个子进程。子进程负责将内存中的数据序列化并写入到一个临时的 RDB 文件中。当子进程完成写文件后,会用新的 RDB 文件替换旧的 RDB 文件。fork 子进程进行持久化,主进程继续处理命令,最大化 Redis 的性能。RDB 文件是一个紧凑的二进制压缩文件,非常适合灾难恢复和备份。可以轻松地将一个时间点的 RDB 文件复制到远程数据中心。相比于 AOF,用 RDB 文件恢复大数据集的速度要快得多。但是也可能丢失更多数据:如果 Redis 意外宕机,可能会丢失最后一次创建快照之后的数据(根据配置,可能是几分钟的数据)。
# 这里表示每隔60s,如果有超过10000个key发生了变更,那么就进行一次全量备份,
save 60 10000
save 300 10
save 900 1
AOF是记录服务器执行的每一个写操作命令(如 SET, HSET, SADD),并以追加的方式将这些命令写入一个日志文件中。当服务器重启时,通过重新执行AOF文件中的所有命令来重建原始数据集。每执行一个写命令,Redis 会将其以 Redis 协议格式追加到 AOF 缓冲区的末尾,然后根据配置的同步策略,将缓冲区的内容写入到 AOF 文件的磁盘上。随着时间推移,AOF 文件会越来越大。Redis 提供了 BGREWRITEAOF 命令,会 fork 一个子进程来创建一个新的 AOF 文件,这个文件包含重建当前数据集所需的最小命令集合(例如,对一个键的多次操作会被合并为一条最终命令)。数据更安全,耐久性更高;根据不同的同步策略,最多只会丢失一秒的数据,甚至完全不会丢失。AOF 文件是纯文本格式,记录了所有操作命令,便于理解和分析,可读性强。但是文件通常更大,AOF 文件体积通常大于同数据集的 RDB 文件;且在数据集很大时,重新执行所有命令来恢复数据的过程可能比 RDB 慢;虽然对性能影响很小,但 AOF 的写入频率通常比 RDB 的快照机制更高。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)