数据挖掘实战 —— 图像分类与蛋白质表达预测
本文原创,若引用,请注明
前言
两个实战案例说明:
- Assignment 1:图像分类任务 —— 基于 28×28 灰度图的二分类。
- Assignment 2:蛋白质表达预测 —— 使用组织切片图像预测蛋白质水平。
通过这两个案例,可以系统学习针对图像的分类和预测,包括 数据预处理 → 特征工程 → 模型训练 → 可视化 → 结果分析 的完整流程。
Part 1:Assignment 1 —— 图像分类
1.1 数据介绍
- 输入:28×28 灰度图(展开为 784 维向量)。
- 标签:+1 或 -1。
训练集:X_train, Y_train;测试集:X_test。
训练集中包含2386,614个单独的-1类和1类样本。测试集中包含3,000个无标签样本。分布显示出显著的不平衡,其中负类在数据集中占据主导地位。
这可能导致机器学习解决方案中出现潜在问题,包括模型预测存在偏见以及模式表征不足。由于数据不平衡,模型可能过度拟合多数类(-1),无论实际类别如何都更频繁地预测该类。
这可能导致模型评估中出现潜在问题,因为在不平衡数据集上,准确率等标准指标可能具有误导性。例如,一个将所有样本预测为’-1’的模型仍能达到约79.5%的准确率(3000个样本中正确预测2386个)。
为解决上述问题,在机器学习进展中应考虑以下方法:重采样、类权重分配以及算法选择(如随机森林或XGBoost等集成方法)。此外,在评估方法上也需要考虑:使用平衡指标(如F1分数、AUC-ROC或PRC-AUC)评估模型对两类的表现,并通过混淆矩阵观察模型区分正负类的有效性。
1.2 数据探索
如图1所示,正类(1)由手袋或靴子等具有清晰轮廓的独特图案代表。而负类(-1)包含衬衫、裤子、连衣裙及休闲鞋等多种物体,其图案呈现多样性。
def visualize_func(X, title, seed = 10):
 np.random.seed(seed) # Set the random seed
 random_samples = np.random.choice(X.shape[0], 12, replace = None)

 # Plot the samples
 for i, j in enumerate(random_samples):
 plt.subplot(2, 6, i + 1)
 plt.matshow(X[j].reshape(28, 28), cmap = 'gray', fignum = False) # Fignum = False, prevents the creation of a new figure.
 plt.axis('off')
 plt.suptitle(title, fontsize = 10, y = 0.9)
 plt.show()
运行结果截图:
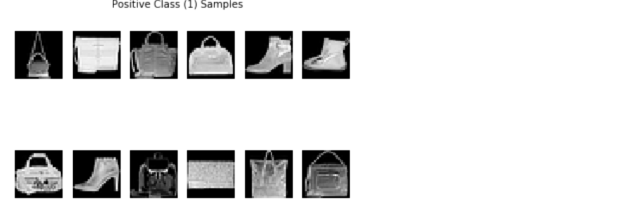
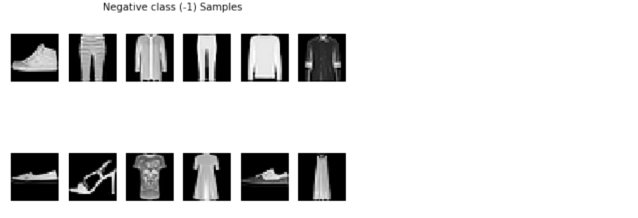
图1:训练集正类、负类数据
如图2所示,测试集的噪声比训练集更多。此外,图像更模糊且边缘不清晰。同时,图像亮度不均匀,部分区域过暗或过亮。这些挑战可能阻碍模型有效提取特征的能力,增加误分类风险,从而降低准确率。
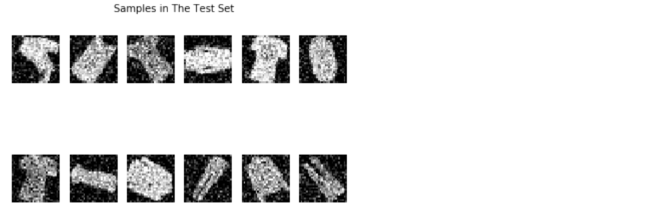
图2:测试集数据示例
1.3 评估指标的选择
针对不同数据集,选择合适的评估指标也非常重要。对于此任务,采用AUC-PR作为主要指标并辅以F1分数作为参考最为理想,因为这是二元分类问题且数据集失衡且无固定阈值。AUC-PR能有效评估失衡数据集,因其更精确地反映模型区分类别的能力。此外,它还能评估模型在不同决策阈值下的整体表现。而F1分数则适用于在确定特定阈值时直接比较不同模型。更具体的分析:
- 训练集存在数据失衡现象:多数类(-1)包含2386个样本,数量近乎少数类(1)的四倍(仅614个样本)。因此,若仅依赖准确率评估模型性能,可能导致高估——大量真实阴性(TN)样本即使真实阳性(TP)极少,仍可能产生高准确率。
- 同样地,AUC-ROC在不平衡数据集上也可能产生误导性结果。该指标衡量正负类别的可分离性,却未能反映预测精确度。在本数据集中,负类(TN)的绝对优势意味着即使假阳性(FP)数量庞大,假阳性率(FPR)仍可能保持较低,从而导致AUC值被过度高估。这可能掩盖预测精度的缺陷。
- 相比之下,AUC-PR通过展示假阳性增加时精度急剧下降的特性解决了此问题。它有助于聚焦于最大化真实阳性同时最小化假阳性,使其更适用于此二分类任务。
- 至于F1分数,它是在特定阈值下计算得出的,同时兼顾了精确率和召回率。由于尚未确定固定阈值,F1分数更适合作为辅助指标与AUC-PR并用。
- MCC(马修斯相关系数)不建议作为主要指标,因其数值解释不够直观,但由于考虑了混淆矩阵的所有值,该系数适用于不平衡数据集。
- 最后,MSE(均方误差)通常用于回归项目,用于评估预测值与真实值之间的差异。然而,该指标较少关注分类性能,既未能充分反映分类错误的严重程度,也未考虑数据不平衡问题。

图3:关于各评估指标的描述
2.1 模型一:kNN
2.1.1 定义并计算指标(5折分层交叉验证,k=5)
该分类器在所有指标(df_results)上表现优异,其AUC-ROC(0.9748)、AUC-PR(0.9623)及F1分数(0.9156)均处于高水平。这表明模型能有效区分类别,同时保持高精度与高召回率。

图4:KNN结果(k=5)
2.1.2 绘制ROC和PR曲线并观察

图5:ROC和PR曲线(KNN,k=5)
ROC曲线非常接近左上角,表明分类器在区分正类和负类方面表现优异。此外,曲线起始段陡峭,意味着即使在极低假阳性率(FPR)下也能实现高真阳性率(TPR)。这正是本问题中ROC曲线最关键的部分(低FPR区域),因为数据集存在正样本稀缺的不平衡问题。低假阳性率既能确保多数负样本被正确分类,又能最大限度减少误判。PR曲线在几乎所有召回率水平(高于0.8)下均表现出高精度,表明分类器能以极少假阳性识别正样本。当召回率趋近1时,曲线略有下降,因为分类器为捕获所有真阳性开始预测更多假阳性。
2.2 模型二:SVM & 随机森林
2.2.1 定义并计算指标

图6:SVM和RF结果
在数据预处理过程中,采用最小-最大方法进行缩放以防止数据泄漏,并通过网格搜索进行超参数调优、交叉验证以比较多种评估指标,并通过可视化进行观察,最终训练出最佳分类器(支持向量机,参数:{‘svc__C’: 100, ‘svc__gamma’: ‘scale’, ‘svc__kernel’: ‘rbf’})。该模型获得平均AUC-ROC值0.991998(标准差:0.002552)及平均AUC-PR值0.979028(标准差:0.008535)。
- SVM:为线性、RBF及多项式核设置C、gamma、degree和coef0的不同值,存储于param_grid用于调优。
- RF:设置n_estimators、max_depth和min samples split的不同组合,存储于param_grid_rf用于调优。
使用MinMaxScaler()而非StandardScaler()的原因:对于图像数据,其值未必遵循正态分布。使用StandardScaler()可能引入负值或放大某些噪声,导致模型更难捕捉原始数据特征。相比之下,MinMaxScaler()仅将数据缩放至固定区间([0,1]),既保留原始分布形态又避免产生负值。
图6展示了不同核函数支持向量机(SVM)与随机森林模型在准确率、平衡准确率、AUC-ROC及AUC-PR指标上的均值与标准差。对比发现,SVM(核函数=径向基函数)在大多数指标上表现略优,尤其在准确率、平衡准确率和AUC-ROC方面。
2.2.2 绘制ROC和PR曲线并观察


图7:ROC和PR曲线(SVM和RF)
如图7所示,SVM_RBF、SVM_Poly和RF分类器均展现出强劲的分类性能,其ROC曲线均趋近左上角。其中SVM_RBF模型以0.9919的AUC-ROC值位居首位。相比之下,SVM_Linear模型表现明显逊色。在PR曲线中,SVM_RBF与RF模型在多数召回率值下仍保持高位稳定表现。而SVM_Poly表现略逊。此外,随机森林在AUC-PR指标上略胜一筹,表明其在精度与召回率权衡方面处理更佳。然而观察高召回率区域(PR曲线右上角)可见,SVM_RBF的精确度下降更为平缓,表明其在高召回率下具有更佳稳定性。这意味着当任务需要高召回率(如医疗诊断欺诈检测)同时保持稳定精确度时,SVM_RBF可能是更优选择。
1.6 PCA 降维
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_train)

plt.scatter(X_pca[:,0], X_pca[:,1], c=Y_train, cmap="bwr", alpha=0.7)
plt.title("PCA Projection (2D)")
plt.show()
运行结果截图:


1.7 最优流水线
最终选择:
PCA → 标准化 → RBF-SVM

Part 2:Assignment 2 —— 蛋白质表达预测
2.1 数据介绍
- 数据:4 个组织切片(A1, B1, C1, D1)。
- 每个 spot 对应一张 RGB 图像和 38 个蛋白质表达值。
- 任务:预测 CD11b 蛋白水平。
2.2 图像处理
from skimage import color, io
import matplotlib.pyplot as plt

img = io.imread("sample.png")
hed = color.rgb2hed(img)
H = hed[:,:,0]

plt.imshow(H, cmap="gray")
plt.title("H Channel")
plt.show()
运行结果截图:HED 转换后的 H 通道图像。

2.3 量化不同蛋白质的表达水平之间的关联性
如下所示,不同蛋白质的表达水平之间存在相关性。我们可利用皮尔逊相关系数将38种蛋白质的表达水平相关关系绘制成热图,揭示相关性较高的关联(例如大于0.8)。进一步的定量分析涉及在80%、60%、40%和20%的阈值下分层统计成对相关性。分析表明,随着蛋白质表达水平相关性的增强,对应的关联对数量呈递减趋势。然而仍有5对蛋白质相关性超过80%,其中DNA1与DNA3的皮尔逊相关系数高达0.999108,表明DNA1表达强度越高,DNA3的表达强度也越高。


2.4 特征提取 + 回归模型
- 特征:RGB/HED 通道均值 & 方差、PCA 主成分;
- 模型:OLS, Random Forest, SVR;
- 指标:RMSE, R², Pearson, Spearman。

2.5 第一次迭代:PCA

2.6 第二次迭代:提取更多特征(HED + RGB + GLCM + HOG + Canny)

2.7 深度模型:VGG16神经网络
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

class VGG16Regression(nn.Module):
    def __init__(self):
        super(VGG16Regression, self).__init__()

        # Load the pre-trained VGG16 model
        self.vgg = models.vgg16(weights=models.VGG16_Weights.IMAGENET1K_V1)

        # Freeze VGG16 convolutional layers to prevent overfitting
        for param in self.vgg.features.parameters():
            param.requires_grad = False

        # Remove the final classification layer of VGG16
        self.vgg.classifier = nn.Sequential(*list(self.vgg.classifier.children())[:-1])

        # Add a Flatten layer
        self.regressor = nn.Sequential(
            nn.Linear(4096, 256),
            nn.ReLU(),
            nn.Dropout(0.5),
            nn.Linear(256, 64),
            nn.ReLU(),
            nn.Dropout(0.3),
            nn.Linear(64, 1)  # Output a single regression value
        )

    def forward(self, x):
        x = self.vgg.features(x)  # Extract CNN features
        x = torch.flatten(x, start_dim=1)
        x = self.vgg.classifier(x)  # Pass through the original VGG16 fully connected layers
        x = self.regressor(x)  # Pass through the new regression layer
        return x

# Initialize the model
model = VGG16Regression().to(device)

model = CNNRegressor()
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# Use Smooth L1 Loss
criterion = nn.SmoothL1Loss()

# Reduce the initial learning rate (1e-4) to improve stability.
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4, weight_decay=5e-3)  # Add L2 regularization during training

# Implement early stopping strategy.
# If val_loss does not improve for 10 epochs, stop training to prevent overfitting in later stages.
early_stopping_patience = 10
scheduler = ReduceLROnPlateau(optimizer, mode='min', patience=early_stopping_patience, factor=0.1)
运行结果截图:训练 Loss 曲线。


预测结果显示 CNN 在 RMSE、相关性上均优于传统方法。
知识总结
-
Assignment 1:

-
Assignment 2:

-
相关sklearn:
Data preprocessing: https://scikit-learn.org/stable/modules/preprocessing.html (https://scikit-learn.org/stable/modules/preprocessing.html)

K-fold cross-validation: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.StratifiedKFold.html (https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.StratifiedKFold.html)

GridSearchCV: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html (https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html)

Pipeline: https://scikit-learn.org/stable/modules/generated/sklearn.pipeline.Pipeline.html#sklearn.pipeline.Pipeline (https://scikit-learn.org/stable/modules/generated/sklearn.pipeline.Pipeline.html#sklearn.pipeline.Pipeline)

TransformerMixin:https://scikit-learn.org/stable/modules/generated/sklearn.base.TransformerMixin.html (https://scikit-learn.org/stable/modules/generated/sklearn.base.TransformerMixin.html)

LinearDiscriminantAnalysis: https://scikit-learn.org/stable/modules/generated/sklearn.discriminant_analysis.LinearDiscriminantAnalysis.html
(https://scikit-learn.org/stable/modules/generated/sklearn.discriminant_analysis.LinearDiscriminantAnalysis.html)

VotingClassifier: https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.VotingClassifier.html#sklearn.ensemble.VotingClassifier (https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.VotingClassifier.html#sklearn.ensemble.VotingClassifier)
👉 如果你也在学习数据挖掘,希望这篇文章能帮到你。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)