循环神经网络(RNN)全面解析
文章目录
1. 问题定义:RNN要解决什么核心问题?
在我们日常生活中,序列数据无处不在——语言中的单词按顺序出现,音乐中的音符依时间排列,股票价格随时间波动。传统的前馈神经网络在处理这类数据时存在根本性缺陷:它们缺乏记忆功能,每次输入都被独立处理,无法捕捉序列中的时间依赖关系。
1.1 输入与输出形式
循环神经网络(RNN)专门为解决序列数据建模而生,其核心能力体现在处理不同类型的输入输出关系上:
输入:可以是任意长度的序列数据 x 1 , x 2 , x 3 , . . . , x T x_1, x_2, x_3, ..., x_T x1,x2,x3,...,xT,其中每个 x t x_t xt 代表时刻 t 的输入向量。
输出:根据任务需求,主要分为四种模式:
- 多对多(序列到序列):如机器翻译、词性标注,输出 y 1 , y 2 , y 3 , . . . , y T y_1, y_2, y_3, ..., y_T y1,y2,y3,...,yT
- 多对一:如情感分析、文本分类,输出单个结果 y y y
- 一对多:如图像描述生成,单个输入生成序列输出
- 一对一:传统神经网络模式
RNN的本质使命是让模型能够理解和处理这种带有顺序依赖关系的可变长度输入,并做出合理预测。
2. 核心思想:RNN的巧妙设计
2.1 记忆机制:循环连接
RNN最核心的创新在于其循环连接设计。与普通前馈神经网络相比,RNN在隐藏层中引入了循环,使得网络能够维护一个内部状态,这个状态作为"记忆",随着时间步不断更新。
用数学公式表示,RNN的核心状态更新规则为:
h t = tanh ( W x h x t + W h h h t − 1 + b h ) h_t = \tanh(W_{xh} x_t + W_{hh} h_{t-1} + b_h) ht=tanh(Wxhxt+Whhht−1+bh)
其中:
- h t h_t ht 是当前时刻的隐藏状态(记忆)
- x t x_t xt 是当前输入
- h t − 1 h_{t-1} ht−1 是上一时刻的隐藏状态
- W x h W_{xh} Wxh、 W h h W_{hh} Whh 是权重矩阵
- b h b_h bh 是偏置项
- tanh \tanh tanh 是激活函数
2.2 参数共享:高效处理变长序列
RNN的另一个精妙之处在于参数共享——所有时间步共享相同的权重矩阵 W x h W_{xh} Wxh、 W h h W_{hh} Whh 和 W h y W_{hy} Why。这意味着无论序列多长,模型都使用同一套"规则"处理每一步输入。
参数共享带来两大优势:
- 大幅减少参数量,提高训练效率
- 使模型能够泛化到不同长度的序列
简单来说,RNN的巧妙之处在于它用“循环结构传递有限记忆”和“参数共享处理变长序列”的方式,巧妙地模拟了序列数据中的时序依赖性。
3. 关键步骤:RNN工作流程详解
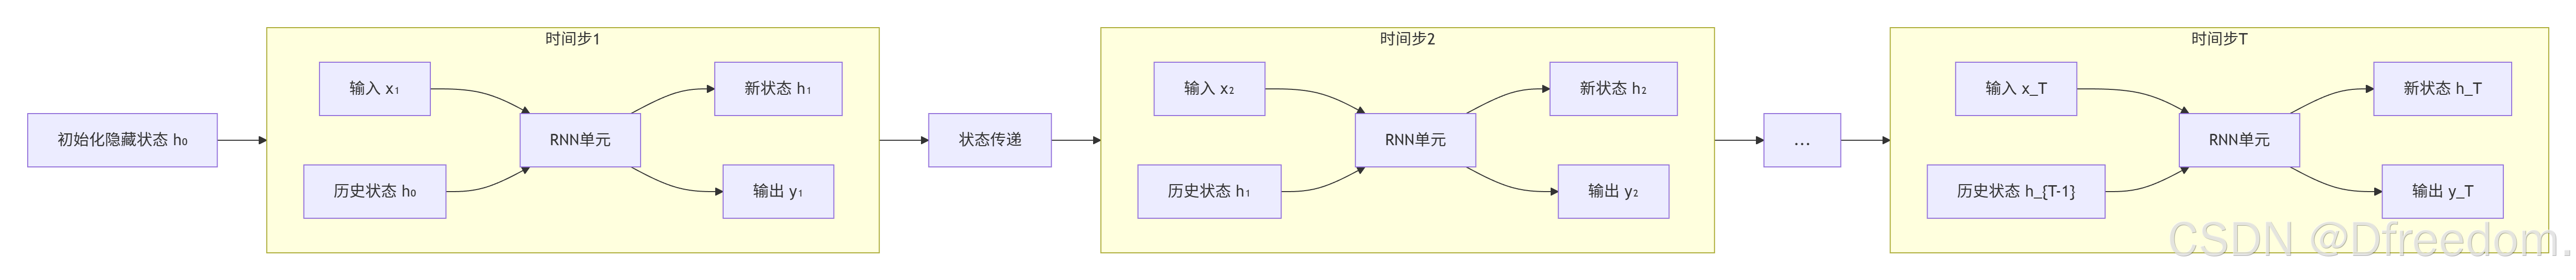
RNN的前向传播过程可以概括为三个关键步骤:
3.1 初始化
在序列开始时(t=0),将初始隐藏状态 h 0 h_0 h0 设置为全零向量,表示"空记忆"。
3.2 循环计算(核心过程)
对于序列中的每个时间步 t(从1到T)执行:
- 线性组合:将当前输入 x t x_t xt 与前一时刻状态 h t − 1 h_{t-1} ht−1 线性组合
- 非线性变换:通过激活函数计算新状态 h t = tanh ( W x h x t + W h h h t − 1 + b ) h_t = \tanh(W_{xh} x_t + W_{hh} h_{t-1} + b) ht=tanh(Wxhxt+Whhht−1+b)
- 状态传递:将 h t h_t ht 传递到下一时间步
3.3 生成输出
根据当前隐藏状态生成输出: y t = softmax ( W h y h t + b y ) y_t = \text{softmax}(W_{hy} h_t + b_y) yt=softmax(Whyht+by)
这个过程可以通过RNN的时间展开图来直观理解:
4. 举例说明
4.1 正弦波序列预测
4.1.1 任务说明
假设我们有一小段正弦波数据:[0.0, 0.84, 0.91, 0.14]。我们的任务是让RNN学会根据前一个数据点预测下一个数据点。这里,我们设定时间步长为3,即网络需要观察连续3个数据点,来预测第4个点。
下表清晰地展示了输入序列是如何被构造成样本的:
| 输入序列 (3个时间步) | 要预测的目标 (第4个时间步) |
|---|---|
| [0.0, 0.84, 0.91] | 0.14 |
| [0.84, 0.91, 0.14] | (下一个值) |
4.1.2 数据在循环层中的流动
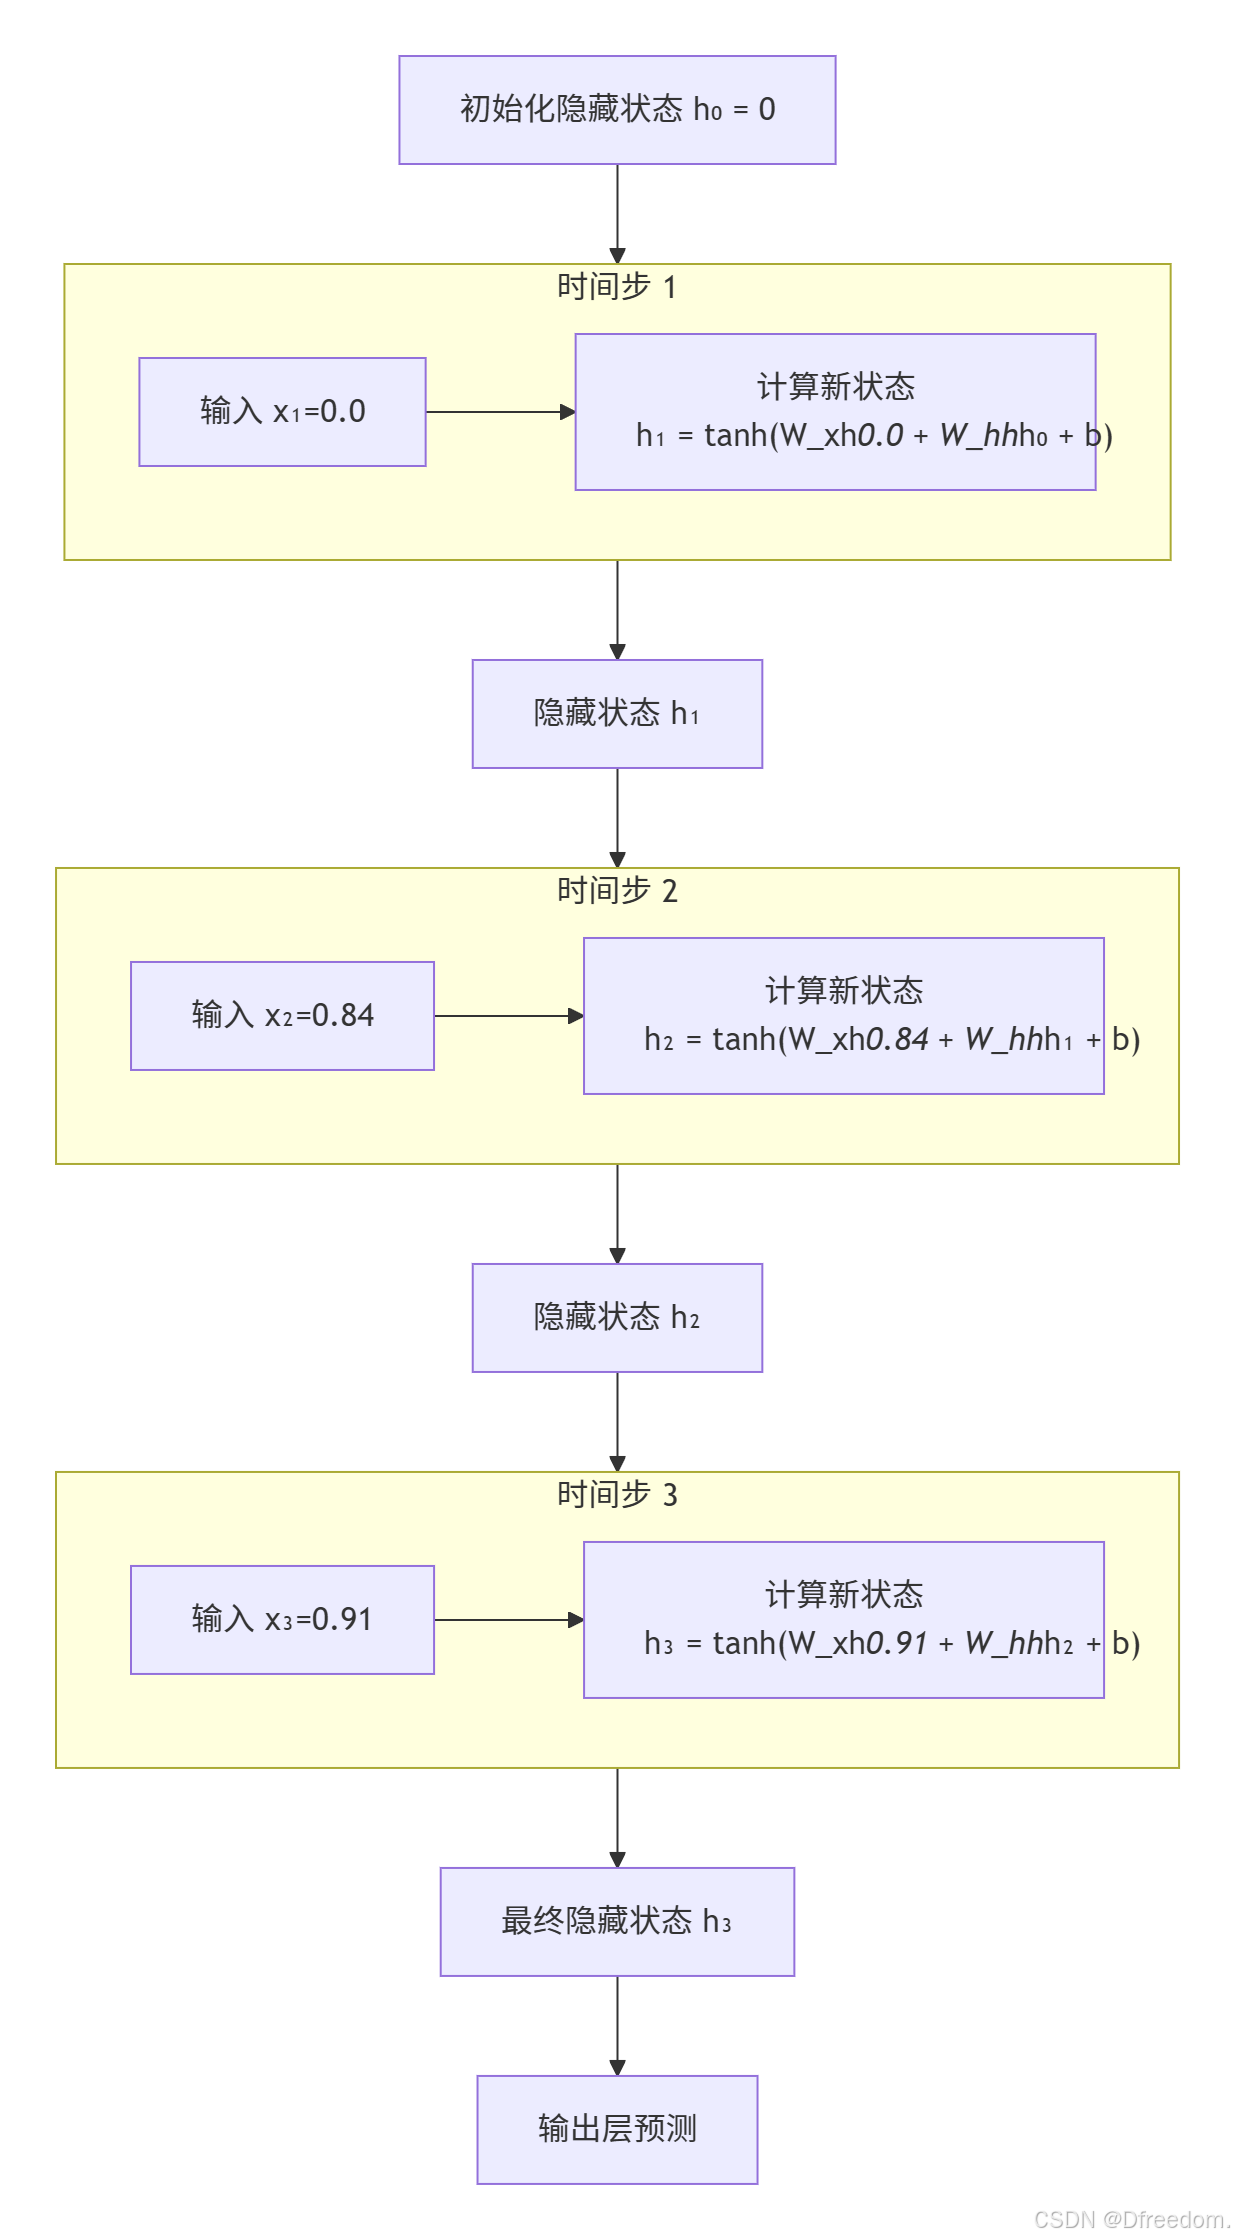
接下来,我们聚焦于循环层内部,看看第一个样本 [0.0, 0.84, 0.91] 是如何被处理的。下图模拟了隐藏状态在三个时间步中的计算与传递过程,其中 W_xh 是输入权重,W_hh 是循环权重,b 是偏置项,tanh 是激活函数。
-
时间步1 (t=1):
- 输入:第一个数值
x₁ = 0.0。 - 历史状态:初始隐藏状态
h₀(通常初始化为0,代表“空记忆”)。 - 计算新状态:结合当前输入
x₁和历史状态h₀,计算新的隐藏状态h₁。公式为:h₁ = tanh(W_xh * x₁ + W_hh * h₀ + b)。此时,h₁主要包含了第一个数据点0.0的信息。
- 输入:第一个数值
-
时间步2 (t=2):
- 输入:第二个数值
x₂ = 0.84。 - 历史状态:
h₁(包含了对x₁=0.0的记忆)。 - 计算新状态:
h₂ = tanh(W_xh * x₂ + W_hh * h₁ + b)。这时,h₂是当前输入0.84和过去记忆h₁共同作用的结果,它捕捉了序列从0.0到0.84的上升趋势。
- 输入:第二个数值
-
时间步3 (t=3):
- 输入:第三个数值
x₃ = 0.91。 - 历史状态:
h₂(包含了[0.0, 0.84]的序列信息)。 - 计算新状态:
h₃ = tanh(W_xh * x₃ + W_hh * h₂ + b)。此时的隐藏状态h₃是一个浓缩的“信息摘要”,它编码了从序列开始到当前时刻([0.0, 0.84, 0.91])的整个历史信息。
- 输入:第三个数值
4.1.3 得到预测结果
在最后一个时间步(t=3)完成后,我们得到了最终的隐藏状态 h₃。这个 h₃ 被送入输出层(通常是一个全连接层),以生成最终的预测值:
预测值 = W_hy * h₃ + b_y
这里,W_hy 是输出层的权重,b_y 是输出层的偏置。然后,将预测值与真实的目标值 0.14 进行比较,计算损失(如均方误差),并通过反向传播算法更新网络中的所有权重(W_xh, W_hh, W_hy 等),使下一次的预测更准。
4.2 文本生成实战演示
为了更好地理解RNN的工作原理,我们以字符级文本生成为例,展示RNN处理序列数据的完整过程。
4.2.1 任务设定
假设我们的训练数据包含以下简单文本:
"hello world"
我们的目标是训练一个RNN,使其能够学习英语单词的拼写模式,并生成类似的新文本。
4.2.2 数据准备
首先,我们需要将字符数字化:
- 构建词汇表:[‘h’, ‘e’, ‘l’, ‘o’, ’ ', ‘w’, ‘r’, ‘d’] (8个字符)
- 创建one-hot编码:
- h = [1,0,0,0,0,0,0,0]
- e = [0,1,0,0,0,0,0,0]
- l = [0,0,1,0,0,0,0,0]
- …以此类推
4.2.3 训练过程
我们使用序列"hello"作为输入,"ello "作为目标输出(预测下一个字符):
时间步1:
- 输入:
x₁ = "h"的one-hot向量 - 历史状态:
h₀ = [0,0,0,0](假设隐藏层大小为4) - 计算:
h₁ = tanh(W_xh × [1,0,0,0,0,0,0,0] + W_hh × [0,0,0,0] + b) - 输出:
y₁ = softmax(W_hy × h₁)→ 预测下一个字符概率分布 - 目标:实际下一个字符是"e",计算交叉熵损失
时间步2:
- 输入:
x₂ = "e" - 历史状态:
h₁(包含"h"的信息) - 计算:
h₂ = tanh(W_xh × [0,1,0,0,0,0,0,0] + W_hh × h₁ + b) - 输出:
y₂ = softmax(W_hy × h₂)→ 预测下一个字符 - 目标:实际下一个字符是"l"
时间步3-5:继续处理"l"、“l”、“o”
通过反向传播算法,RNN学习调整权重矩阵,使得预测概率分布越来越接近真实的下一个字符。
4.2.4 文本生成
训练完成后,我们可以用RNN生成新文本:
- 输入起始字符(如"h")
- 获取输出概率分布,按概率采样下一个字符
- 将采样字符作为下一时间步输入
- 重复直到生成所需长度
经过充分训练,RNN可能学会生成"hello world"、"hello would"等符合英语拼写模式的单词。
5、总结特点:优缺点与应用场景
5.1 RNN的优点
- 处理变长序列:能够灵活处理不同长度的输入,这是其核心优势。
- 参数共享:大幅减少模型参数量,提高效率,并有助于泛化到不同长度序列。
- 捕捉时序依赖:通过隐藏状态,能够建模序列中的上下文关系,这是前馈神经网络无法做到的。
- 记忆功能:理论上能够记住历史信息,用于影响当前决策。
5.2 RNN的缺点
- 梯度消失/爆炸问题:这是传统RNN的主要缺陷。在反向传播通过时间(BPTT)时,梯度需要在时间步上连乘,导致在长序列上,梯度可能变得极小(消失)或极大(爆炸),使得模型难以学习长期依赖关系。
- 有限长期记忆:即使理论上有记忆,但实际中,随着序列变长,早期信息会被后续信息逐渐覆盖或稀释,难以维持。
- 计算效率低:由于计算是顺序的(必须等t-1步算完才能算t步),无法像CNN那样充分利用硬件进行并行计算,训练速度较慢。
5.3 主要应用场景
RNN及其变体在需要序列建模的领域有着广泛应用:
- 自然语言处理:机器翻译、文本生成、情感分析、命名实体识别。
- 语音识别:将音频序列转换为文本。
- 时间序列预测:股票价格预测、天气预报。
- 图像描述生成:结合CNN,生成图像的文本描述。
5.4 发展与演进
为了克服基础RNN的缺陷,研究者提出了更强大的门控循环单元:
- LSTM(长短期记忆网络):通过引入“输入门”、“遗忘门”和“输出门”的精细控制机制,有选择地记住重要信息、忘记无关信息,显著提升了处理长期依赖的能力。
- GRU(门控循环单元):LSTM的简化版本,将输入门和遗忘门合并为“更新门”,并引入“重置门”,在保持性能的同时结构更简洁。
值得注意的是,近年来Transformer架构凭借其自注意力机制,在多项序列任务上超越了RNN家族,成为当前的主流选择。但RNN所体现的“状态”和“记忆”思想,依然是深度学习发展史上的重要里程碑,为理解序列建模奠定了坚实基础。
感谢阅读!如果本文对您有所帮助,请不要吝啬您的【点赞】、【收藏】和【评论】,这将是我持续创作优质内容的巨大动力。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 14
 0
- 0


 已为社区贡献26条内容

所有评论(0)