基于麻雀搜索优化算法优化XGBoost的多变量时间序列预测
基于麻雀搜索优化算法优化XGBoost(SSA-XGBoost)的多变量时间序列预测 SSA-XGBoost多变量时间序列 采用交叉验证抑制过拟合问题 优化参数为迭代次数、最大深度和学习率 matlab代码, 注:暂无Matlab版本要求 -- 推荐 2016B 版本及以上 注:采用 XGBoost 工具箱,仅支持 Windows 64位系统

在时间序列预测领域,多变量时间序列的预测一直是个具有挑战性的任务。今天咱们就来聊聊基于麻雀搜索优化算法优化XGBoost(SSA - XGBoost)的多变量时间序列预测方法,并且会用到交叉验证来抑制过拟合问题。
方法概述
XGBoost是一种强大的梯度提升算法,在很多机器学习任务中都有出色的表现。不过它的性能很大程度上依赖于参数的选择,像迭代次数、最大深度和学习率这些参数选得好不好,对预测结果影响可大了。而麻雀搜索算法(SSA)是一种新兴的智能优化算法,它能在搜索空间中寻找最优解。我们就用SSA来优化XGBoost的这些关键参数,从而提升多变量时间序列的预测精度。
代码实现
1. 数据准备
假设我们已经有了多变量时间序列数据,下面是简单的读取和处理代码:
% 读取数据
data = readtable('your_data.csv'); % 替换为你的数据文件名
% 提取特征和目标变量
features = table2array(data(:, 1:end - 1));
target = table2array(data(:, end));

% 划分训练集和测试集
train_ratio = 0.8;
train_size = floor(train_ratio * length(target));
train_features = features(1:train_size, :);
train_target = target(1:train_size);
test_features = features(train_size + 1:end, :);
test_target = target(train_size + 1:end);
这里我们把数据分成了训练集和测试集,比例是80%和20%。
2. 定义适应度函数
适应度函数用于评估每个参数组合的好坏,这里我们用交叉验证的均方误差(MSE)作为适应度值。
function fitness = ssa_xgboost_fitness(params, train_features, train_target)
    num_round = round(params(1)); % 迭代次数
    max_depth = round(params(2)); % 最大深度
    learning_rate = params(3);    % 学习率

    % 交叉验证
    cv = cvpartition(length(train_target), 'KFold', 5);
    mse_sum = 0;
    for i = 1:cv.NumTestSets
        train_idx = training(cv, i);
        test_idx = test(cv, i);

        % 创建XGBoost模型
        model = xgboost(train_features(train_idx, :), train_target(train_idx), ...
            'NumRound', num_round, 'MaxDepth', max_depth, 'LearningRate', learning_rate);

        % 预测
        predictions = predict(model, train_features(test_idx, :));

        % 计算均方误差
        mse = mean((predictions - train_target(test_idx)).^2);
        mse_sum = mse_sum + mse;
    end

    fitness = mse_sum / cv.NumTestSets;
end
这个函数里,我们使用了5折交叉验证,每次都训练一个XGBoost模型并计算均方误差,最后取平均值作为适应度值。这样可以有效抑制过拟合问题。
3. 麻雀搜索算法优化
下面是麻雀搜索算法的核心代码:
% 麻雀搜索算法参数
pop_size = 20; % 种群大小
max_iter = 50; % 最大迭代次数
dim = 3; % 优化参数的维度(迭代次数、最大深度、学习率)
lb = [10, 3, 0.01]; % 参数下界
ub = [100, 10, 0.3]; % 参数上界

% 初始化种群
pop = repmat(lb, pop_size, 1) + rand(pop_size, dim) .* (repmat(ub, pop_size, 1) - repmat(lb, pop_size, 1));
fitness = zeros(pop_size, 1);

% 计算初始适应度
for i = 1:pop_size
    fitness(i) = ssa_xgboost_fitness(pop(i, :), train_features, train_target);
end

% 迭代优化
for iter = 1:max_iter
    % 这里省略麻雀搜索算法的具体更新步骤,可参考相关文献实现
    % 更新种群和适应度
    for i = 1:pop_size
        fitness(i) = ssa_xgboost_fitness(pop(i, :), train_features, train_target);
    end
end

% 找到最优参数
[best_fitness, best_idx] = min(fitness);
best_params = pop(best_idx, :);
麻雀搜索算法会不断迭代更新种群,寻找最优的参数组合。这里我们简单省略了具体的更新步骤,你可以参考相关文献来实现。
4. 最终模型训练和预测
% 使用最优参数训练最终模型
num_round = round(best_params(1));
max_depth = round(best_params(2));
learning_rate = best_params(3);
final_model = xgboost(train_features, train_target, ...
    'NumRound', num_round, 'MaxDepth', max_depth, 'LearningRate', learning_rate);

% 预测测试集
test_predictions = predict(final_model, test_features);

% 计算测试集的均方误差
test_mse = mean((test_predictions - test_target).^2);
disp(['测试集均方误差: ', num2str(test_mse)]);
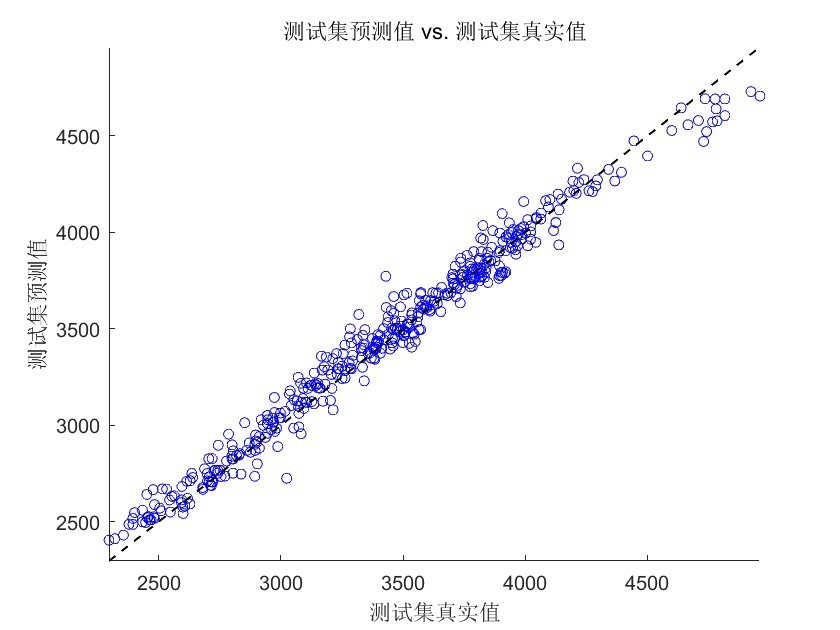
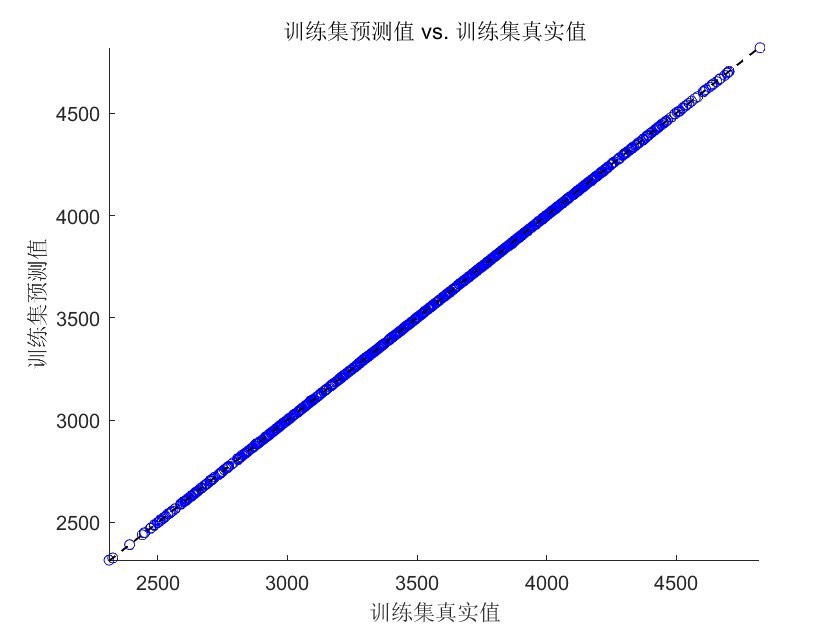
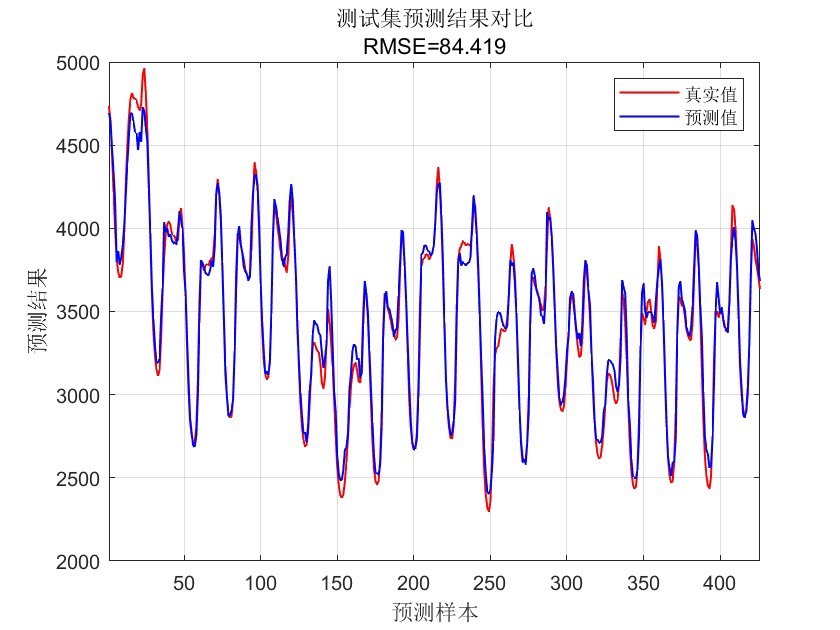
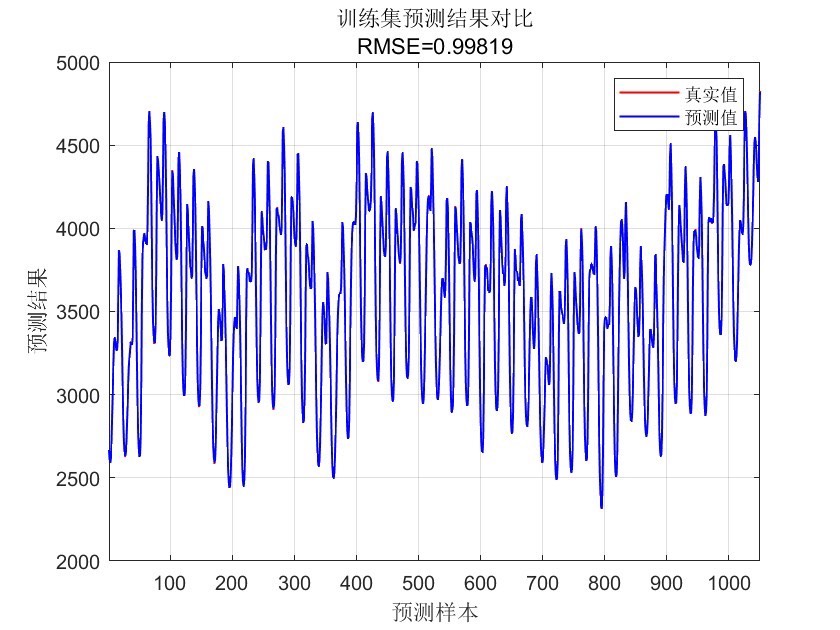
最后我们用找到的最优参数训练一个最终的XGBoost模型,并对测试集进行预测,计算均方误差来评估模型的性能。
注意事项
- 代码中使用了XGBoost工具箱,这个工具箱仅支持Windows 64位系统。
- 推荐使用Matlab 2016B版本及以上。
通过以上步骤,我们就完成了基于麻雀搜索优化算法优化XGBoost的多变量时间序列预测,并且使用交叉验证抑制了过拟合问题。你可以根据自己的数据和需求对代码进行调整和优化。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 34
 0
- 0


 已为社区贡献70条内容

所有评论(0)