了解ASR(自动语音识别)和模型Whisper
ASR是自动语音识别技术,现代端到端的主流ASR架构为:
音频 → [预处理 → 神经网络编码 → 解码] → 文本
↑ ↑
信号处理 深度学习Whisper 是由 OpenAI 于 2022 年发布的开源语音识别模型。它是一个基于 Transformer 架构的端到端模型,具有以下核心特点:多任务模型、多语言支持、多种格式、强鲁棒性和无需微调开箱即用。
一、ASR
音频输入与预处理一般通过ffmpeg与VAD配合完成
1、特征提取与编码
现在的ASR通常使用声学特征直接输入神经网络。
常见的声学特征有以下四种,但是现在一般直接使用神经网络自动学习特征,例如Conformer编码器就是神经网络组成的。
- MFCC(梅尔频率倒谱系数):13-40维
-
def compute_mfcc(log_mel_spectrum, n_mfcc=13): # 离散余弦变换(DCT) mfcc = dct(log_mel_spectrum, type=2, axis=1, norm='ortho') mfcc = mfcc[:, :n_mfcc] # 取前13个系数 return mfcc # shape: (帧数, 13) # MFCC包含: # 0阶:能量 # 1-2阶:谱斜率 # 3-13阶:谱包络细节 - 梅尔频谱(Mel-Spectrogram):80-128维
-
# 现代ASR(如Whisper)直接使用梅尔频谱图 def extract_mel_spectrogram(audio, sr=16000): mel_spec = librosa.feature.melspectrogram( y=audio, sr=sr, n_mels=80, # Whisper使用80维 n_fft=400, # 400个样本(25ms) hop_length=160, # 160个样本(10ms) fmin=0, fmax=8000 ) log_mel_spec = np.log(np.clip(mel_spec, a_min=1e-10)) return log_mel_spec.T # shape: (时间帧数, 80) - 滤波器组(Filter Bank):40-80维
-
def mel_filter_bank(magnitude_spectrum, sr=16000, n_mels=80): # 1. 创建梅尔尺度滤波器 mel_filters = librosa.filters.mel(sr=sr, n_fft=512, n_mels=n_mels) # 2. 应用滤波器组 mel_spectrum = np.dot(magnitude_spectrum, mel_filters.T) # 3. 取对数(人耳对声音强度的感知是对数的) log_mel_spectrum = np.log(mel_spectrum + 1e-10) return log_mel_spectrum # shape: (帧数, 80) # 梅尔频率:模拟人耳听觉特性 # 低频分辨率高,高频分辨率低 - 原始波形(Raw Waveform):端到端模型直接使用
- Conformer编码器:
输入: (T, 80) # T个时间帧,每帧80维梅尔特征
Conformer 编码器:
1. 子采样卷积层: (T, 80) → (T/4, 512)
2. 位置编码: 加入时序信息
3. N个Conformer Block:
- 前馈网络(Feed Forward)
- 多头自注意力(Multi-Head Self-Attention)
- 卷积模块(捕捉局部特征)
- 残差连接 + 层归一化
输出: (T/4, 512) # 高层声学表示
2、解码
解码器类型比较
|
CTC 连接时序分类 |
RNN-T 循环神经网络转换器 | Attention-based Seq2Seq | Transfoemer-based | |
|---|---|---|---|---|
| 特点 | 每个时间步独立预测 | 结合RNN和CTC | 编码器-解码器 + 注意力 | 纯注意力机制 |
| 优点 | 训练简单、推理快 | 流式友好,考虑上下文 | 效果好、适合长语音 | 并行计算、效果最好 |
| 缺点 | 假设输出独立,不考虑上下文 | 训练复杂,推理慢 | 非流式,需要看到完整语音 | 需要大量数据、计算资源多 |
CTC、解码过程详解
# CTC
class CTC_Decoder:
    def decode(self, encoder_output):
        # 1. 每个时间步独立预测
        # encoder_output shape: (T, 512)
        logits = self.output_layer(encoder_output)  # (T, vocab_size)

        # 2. 得到每个时间步的字符概率
        # 例如:T=100个时间步,每个步有5000个字符的概率

        # 3. 移除重复字符和空白符
        # 原始: - a a - - b b - c c → "a b c"
        # 空白符"-"表示静音或过渡

        # 4. 选择概率最高的序列
        return best_sequence
# Attention Seq2Seq
class AttentionDecoder:
    def decode(self, encoder_output):
        # 初始化
        hidden = init_hidden()
        output = ["<sos>"]  # 开始标记

        # 自回归生成
        for step in range(max_length):
            # 1. 当前输出词转向量
            embed = self.embedding(output[-1])

            # 2. 注意力机制
            # 计算注意力权重:哪些音频帧对当前词最重要
            attn_weights = softmax(
                self.attention(query=hidden,
                             key=encoder_output)
            )

            # 3. 上下文向量(加权和)
            context = sum(attn_weights[i] * encoder_output[i]
                         for i in range(T))

            # 4. 解码器RNN
            hidden = self.decoder_rnn(embed, hidden, context)

            # 5. 预测下一个词
            next_word_probs = softmax(
                self.output_projection(hidden)
            )

            # 6. 选择最可能的词
            next_word = argmax(next_word_probs)
            output.append(next_word)

            if next_word == "<eos>":  # 结束标记
                break

        return output[1:-1]  # 去掉开始/结束标记
# Transformer 解码器(如 Whisper)
class TransformerDecoder:
    def decode(self, encoder_output):
        # 1. 初始化:开始标记
        tokens = [self.sos_token]

        # 2. 自回归生成
        for i in range(max_length):
            # 嵌入层
            token_embeds = self.embedding(tokens)

            # 解码器自注意力(掩码,防止看到未来)
            dec_output = self.decoder_blocks(
                token_embeds,
                encoder_output
            )

            # 预测下一个词
            logits = self.output_layer(dec_output[:, -1, :])
            next_token = argmax(logits)

            tokens.append(next_token)

            if next_token == self.eos_token:
                break

        return tokens[1:-1]
3、后处理和格式化输出
好的后处理可以让ASR系统的实用价值提升30-50%,是工业级ASR系统中不可或缺的一环。
后处理包括的操作类型有:标点回复、数字标准化、实体标准化、语法修正、领域适配、流畅性改进等等。
def postprocess_asr_text(raw_text):
    # 1. 标点恢复
    text = add_punctuation(raw_text)
    # "你好我是语音助手" → "你好,我是语音助手。"

    # 2. 大小写恢复
    text = restore_capitalization(text)
    # "i live in beijing" → "I live in Beijing"

    # 3. 数字标准化
    text = normalize_numbers(text)
    # "一二三" → "123"
    # "two hundred" → "200"

    # 4. 口语化处理
    text = normalize_spoken_text(text)
    # "gonna" → "going to"
    # "um", "ah" → 删除

    # 5. 专有名词校正
    text = correct_proper_nouns(text)
    # "open ai" → "OpenAI"

    # 6. 空格规范化
    text = re.sub(r'\s+', ' ', text).strip()

    return text
文本的格式化输出文本有利于信息抽取等操作
def format_asr_output(text, segments, timestamps):
    output = {
        'text': text,  # 完整文本
        'segments': [
            {
                'id': i,
                'start': seg['start'],
                'end': seg['end'],
                'text': seg['text'],
                'confidence': seg['confidence']
            }
            for i, seg in enumerate(segments)
        ],
        'language': detected_language,
        'duration_ms': total_duration,
        'word_timestamps': [
            {
                'word': word,
                'start': start_ms,
                'end': end_ms
            }
            for word, start_ms, end_ms in timestamps
        ]
    }

    return output
二、Whisper
whisper虽然开箱即用,但是首次使用的时候需要下载模型,下载的时候可以选择不同大小的模型tiny、base、small、medium、large,他们的准确率与模型的大小成正比(越大准确率越高),速度与模型大小成反比(越大速度越慢)。
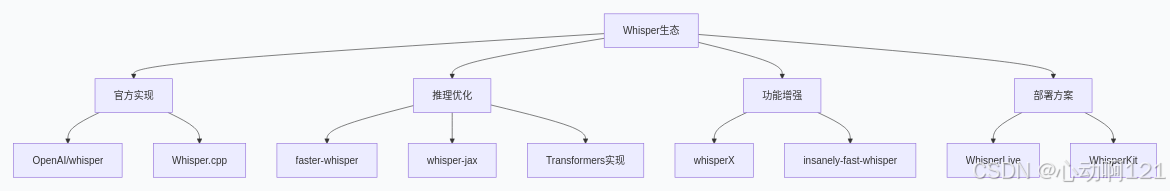
whisper生态系统:以OpenAI的Whisper模型为核心,由社区驱动的工具、框架、应用和服务组成的完整技术栈,如下图
| 生态工具 | 场景 | 理由 |
|---|---|---|
openai/whisper | 研究和实验 | 功能完整,调试方便 |
faster-whisper | 生产环境部署 | 平衡性能与功能 |
whisper.cpp或faster-whisper | 实时转写/直播 | 延迟低,资源占用少 |
whisperX | 需要说话人分离 | 集成diarization |
whisper-jax或faster-whisper | 云端大批量处理 | 吞吐量高 |
whisper.cpp | 移动端/嵌入式 | 内存小,无GPU依赖 |
whisperX | 需要词级时间戳 | 词对齐准确 |
针对whisper衍生出的工具包在调用transcribe()函数的时候会返回不同的结构内容。
1、官方实现——openai-whisper/whisper.cpp的返回结构
openai-whisper包返回的是以下格式:其中text是所有的文本,segments表示每一段的信息(包括文本、开始/结束时间、偏移量),words表示每个词/字的信息。
result = {
    "text": "完整文本,所有分段合并",  # 最常用的结果

    "segments": [  # 最重要的部分,包含详细分段信息
        {
            "id": 0,                    # 分段序号
            "seek": 0,                  # 在音频中的搜索位置(秒)
            "start": 0.0,               # 开始时间(秒)
            "end": 4.0,                 # 结束时间(秒)
            "text": "你好,",           # 该段落的文本

            # 🔬 解码质量指标(判断准确性)
            "avg_logprob": -0.2,        # 平均对数概率:-1(差)~ 0(完美)
            "no_speech_prob": 0.02,     # 无语音概率:0(是语音)~1(不是语音)
            "compression_ratio": 1.2,   # 压缩比:>2.4可能有问题
            "temperature": 0.0,         # 解码温度

            # 🔢 技术细节
            "tokens": [50364, 1234, ...],  # 该段的token序列

            # 🆕 large-v3新增(需要word_timestamps=True)
            "words": [  # 词级时间戳
                {
                    "word": "你",        # 单个词/字
                    "start": 0.0,        # 词开始时间
                    "end": 0.2,          # 词结束时间
                    "probability": 0.95   # 词置信度
                }
            ]
        }
    ],

    "language": "zh"  # 检测到的语言(ISO 639-1代码)
}
whisper.cpp返回 json 格式,以下是返回示例:transcription表示转录文本
{
  "transcription": [
    {
      "timestamps": {
        "from": "00:00:00,000",  # SRT格式时间戳
        "to": "00:00:04,000"
      },
      "offsets": {
        "from": 0,               # 字符偏移量(在全文中的位置)
        "to": 3
      },
      "text": "你好,",
      "tokens": [50364, 1234, ...]
    }
  ],
  "text": "完整文本",            # 可选,根据参数
  "language": "zh",
  "response_time": 2.3
}
2、推理优化——faster-whisper的返回结构
faster-whisper中使用transcribe()函数一般返回两个对象:生成器和信息对象,如下
# 返回两个对象:生成器和信息对象
segments, info = model.transcribe("audio.mp3")

# 📊 info对象(TranscriptionInfo)
print(info.__dict__)
# {
#     'language': 'zh',                   # 检测语言
#     'language_probability': 0.98,       # 语言检测置信度
#     'duration': 30.5,                   # 音频时长
#     'all_language_probs': {             # 所有语言概率
#         'zh': 0.98, 'en': 0.01, ...
#     },
#     'transcription_time': 2.3,          # 转录耗时(秒)
#     'initial_prompt': None              # 初始提示词
# }

# 🔄 segments生成器(迭代获取Segment对象)
for segment in segments:
    print(segment.__dict__)
    # {
    #     'start': 0.0,                   # 开始时间
    #     'end': 4.0,                     # 结束时间
    #     'text': '你好,',               # 文本
    #
    #     # 可选(word_timestamps=True时)
    #     'words': [
    #         Word(start=0.0, end=0.2, word='你', probability=0.95),
    #         Word(start=0.2, end=0.4, word='好', probability=0.92)
    #     ]
    # }
3、功能增强——whisperX的返回结构
result = {
    # 🎯 语音活动检测结果
    "segments": [  # 类似官方格式
        {
            "start": 0.0,
            "end": 4.0,
            "text": "你好,",

            # 🎤 词级对齐(比官方更准)
            "words": [
                {
                    "word": "你",
                    "start": 0.0,
                    "end": 0.2,
                    "score": 0.95,      # 对齐分数
                    "speaker": None     # 可扩展说话人分离
                }
            ]
        }
    ],

    # 📝 另一种词片段格式
    "word_segments": [
        {
            "word": "你",
            "start": 0.0,
            "end": 0.2,
            "score": 0.95
        }
    ],

    # 🗣️ 说话人分离结果(需要额外模型)
    "speaker_segments": [
        {
            "start": 0.0,
            "end": 10.0,
            "speaker": "SPEAKER_00",
            "text": "第一段话..."
        }
    ],

    "language": "zh"
}
| 工具包 | 返回类型 | 主要字段 | 额外特性 | 语言检测 |
|---|---|---|---|---|
| openai-whisper | dict | text, segments, language | 官方实现,功能完整 | 返回语言代码 |
| faster-whisper | tuple + Generator | (segments_generator, info) | 速度快,内存小 | 包含概率值 |
| whisper.cpp | JSON/文本 | 各种自定义格式 | 可嵌入式部署 | 需要参数指定 |
| whisper-jax | dict | text, chunks | GPU利用率高 | HF格式 |
| whisperX | dict | segments, word_segments | 词级对齐,说话人分离 | 同官方 |

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)