多模态数据处理的存储层要怎么设计?· SIGMOD‘26
SIGMOD’26 论文《ByteHouse: ByteDance’s Cloud-Native Data Warehouse for Real-Time Multimodal Data Analytics》中,字节团队介绍了实时多模态分析引擎 ByteHouse,本文将讲解 ByteHouse 存储层的设计思路。
前言
在 AI 时代,多模态数据处理有如下 3 种负载:
- OLAP。传统分析型 SQL 查询,侧重范围扫描,以顺序读 IO 为主。
- 多模检索。传统 SQL 无法查询图片、视频等多模态数据,须将它们转成向量,通过向量检索进行语义相关性查询。侧重点查,以随机读 IO 为主。
- 实时 ETL。提供高时效性,逐条写入。
面对不同的负载,传统的解决方案是组合多种引擎。
OLAP 采用 Spark、ClickHouse 等 OLAP 引擎;
多模检索采用 Milvus、pgvector 等向量数据库;
实时 ETL 采用 Kafka、Flink 等流式引擎;
然而,不同引擎的存储格式通常是不同的,该方案会带来数据同步问题。
另外,存算分离的云原生架构已经逐渐成为现代数据引擎的标配。相比于结构化数据,多模态数据的存储体积更大,基于低成本的对象存储构建存储层已经是主流。
然而,对象存储在 IO 带宽和时延上都存在较大的劣势,容易成为整个数据处理管道的瓶颈。
下面,我们看下实时多模态分析引擎 ByteHouse 的存储层是如何解决这两个问题 。
Parquet 的问题
在数据分析领域,Parquet 是最流行的开放数据格式。
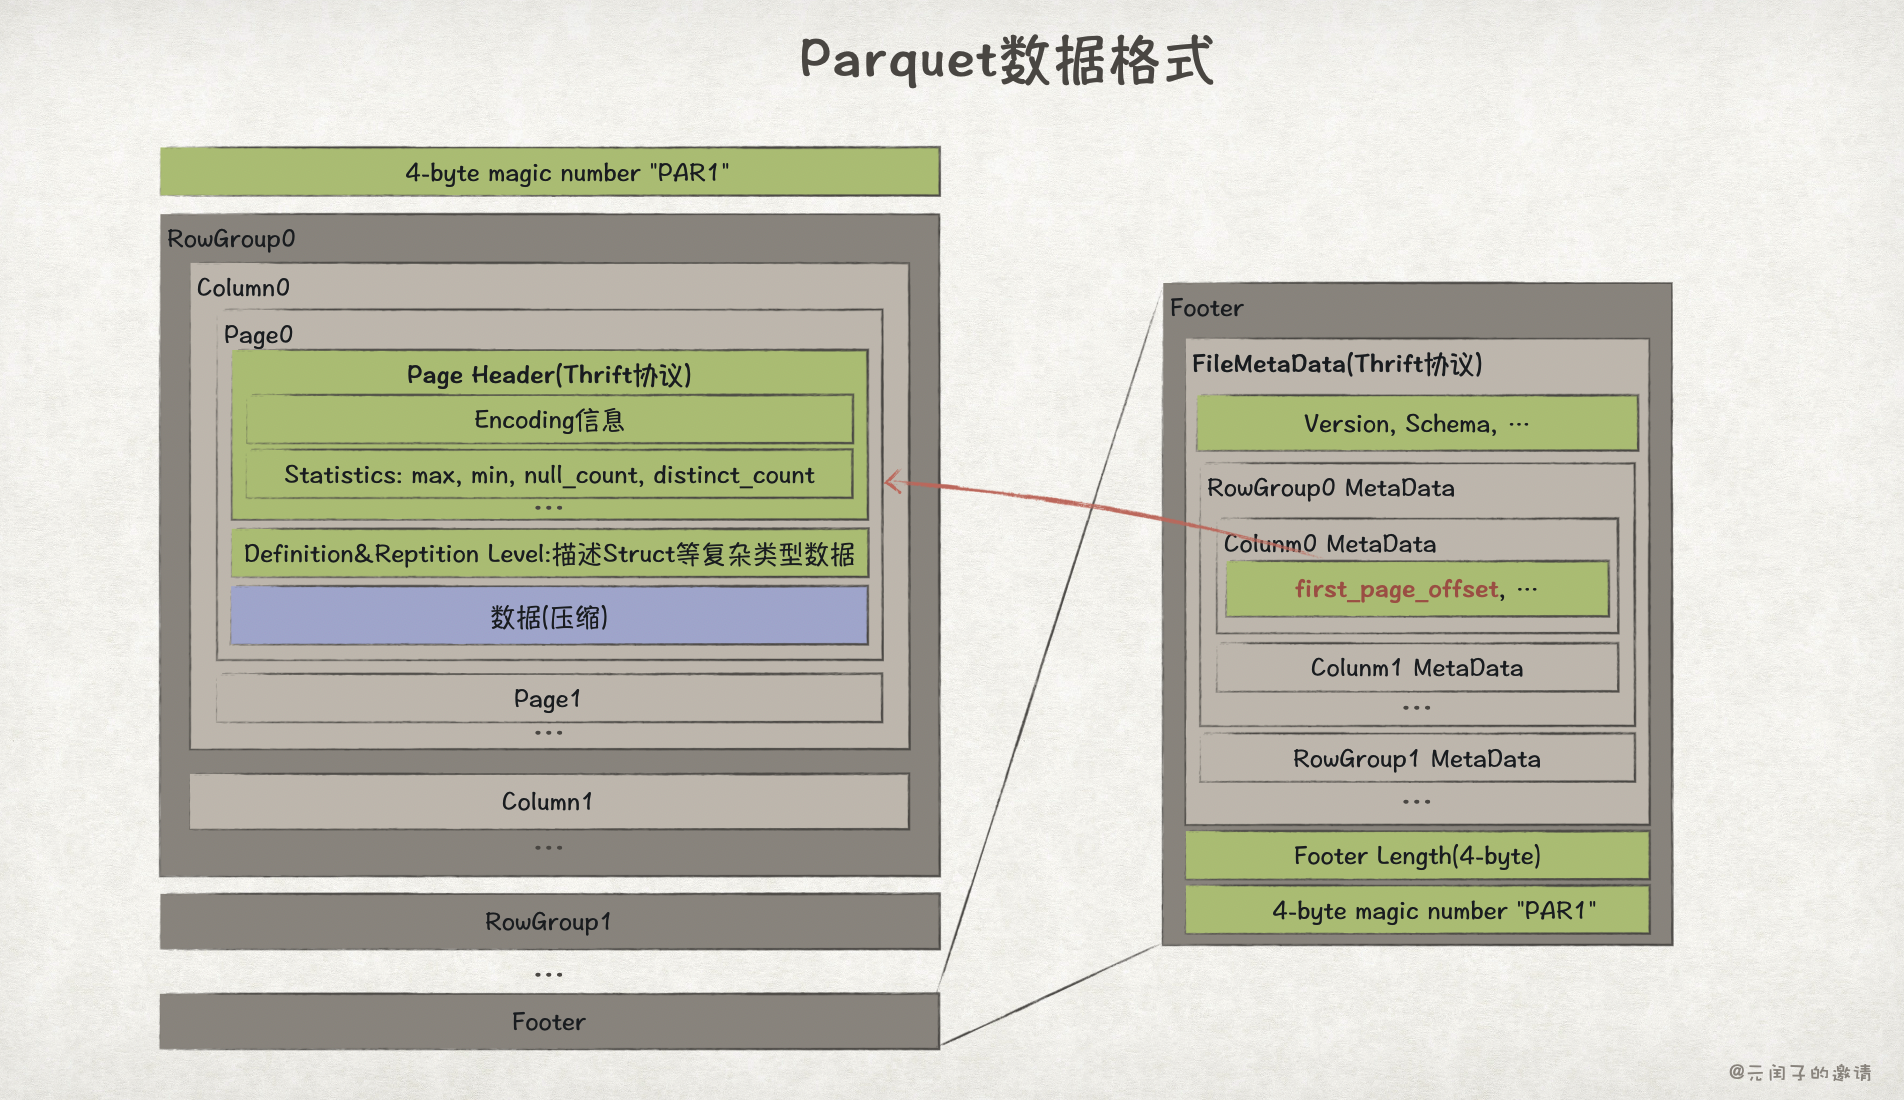
但 Parquet 是面向传统 OLAP 负载设计的,不擅长点查,无法高效支撑多模态检索。
首先,点查路径长,需要 1 + N 次 IO:
- 通过 Foot Length 找到 FileMetaData 的 offset,1 次 IO。
- 加载 FileMetaData 到内存,过滤掉不相关的 RowGroup,找到对应列的 first page offset 。
- 遍历 Page,通过 Page Header 的 max 和 min 信息定位到数据所在的 Page,N 次 IO,N 为 RowGroup 中 Page 的数量。
- 拉取 Page 到内存,解压得到 M 条数据。
- 遍历数据,找到所需的那条数据。
针对这个问题,Parquet 2.x 做了些优化,将 Page Header 中 max, min 等统计信息,集中存储到 Column Index 和 Offset Index 中:
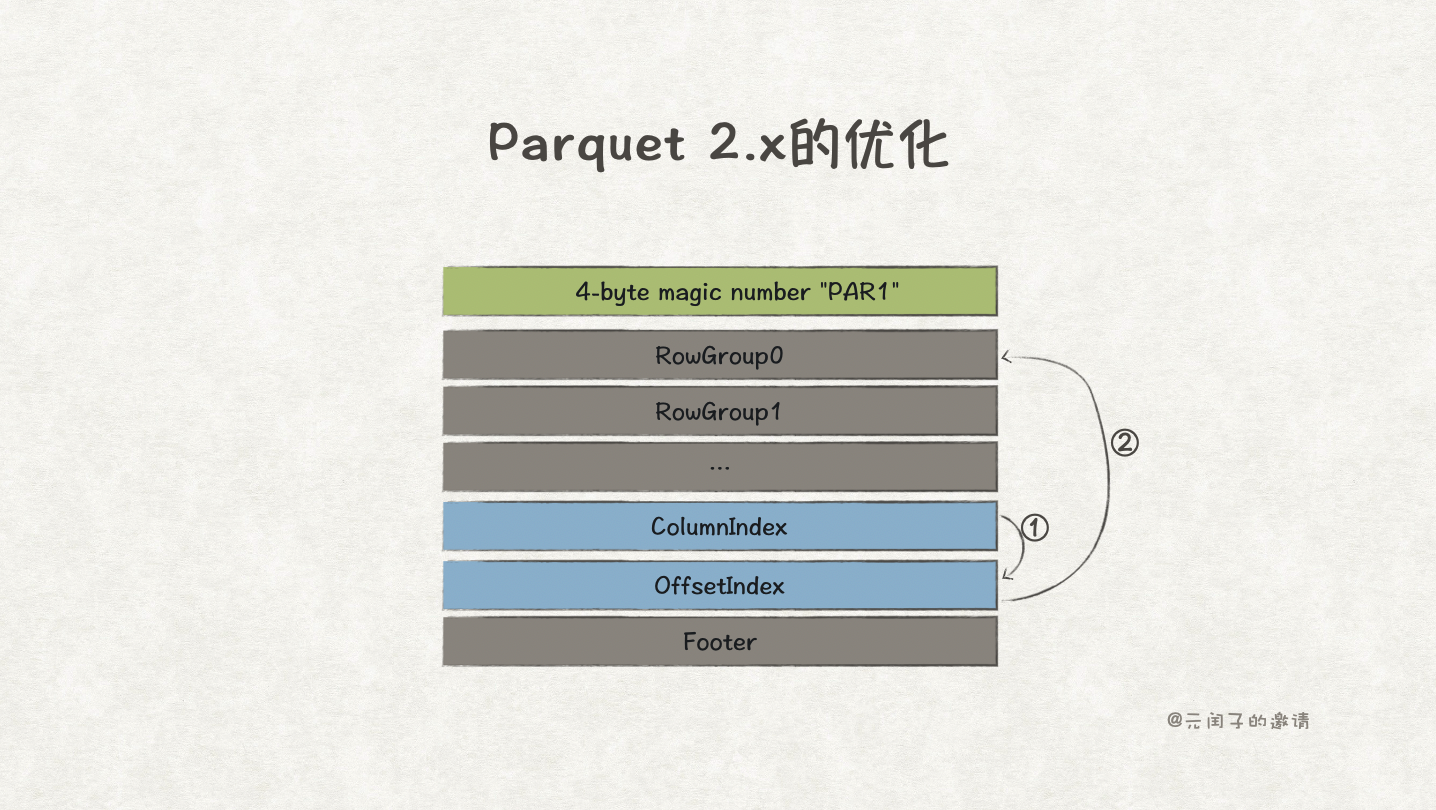
这样只需 1 + 2 次 IO 就能完成点查。
但只有 max、min 无法进行二分查找,遍历仍不可避免,点查路径还是很长。
常见的解决方案是,在 Parquet 文件之外使用辅助索引。但因为是不同的文件,代价是增加额外的 IO 次数。
向量不是 Parquet 的“一等公民”,采用嵌套数组的存储布局。同一列所有向量在物理上紧挨平铺,通过 offset 来索引。
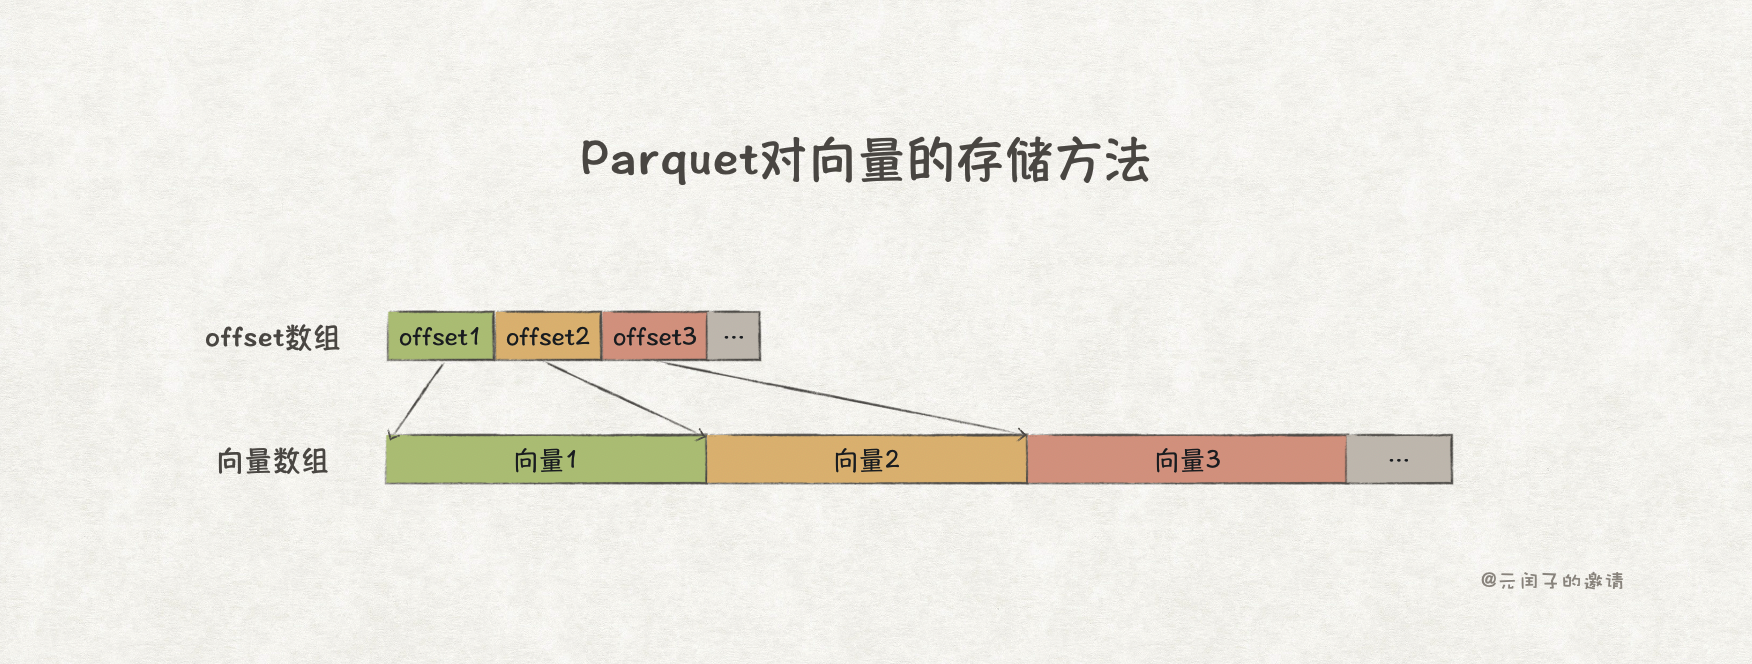
由于没有向量的元数据,比如向量范数,所以在检索时无法进行快速剪枝。对稀疏向量存储也没有优化。
总结来说就是,Parquet 不适合向量的存储。
另外,Parquet 没有版本管理,需要配合 Iceberg 等开放表格才能应对实时 ETL 的负载。
针对这些问题,ByteHouse 提出了一个新的数据格式,Sniffer。
Sniffer 数据格式
论文把 Sniffer 称为自描述的文件格式。
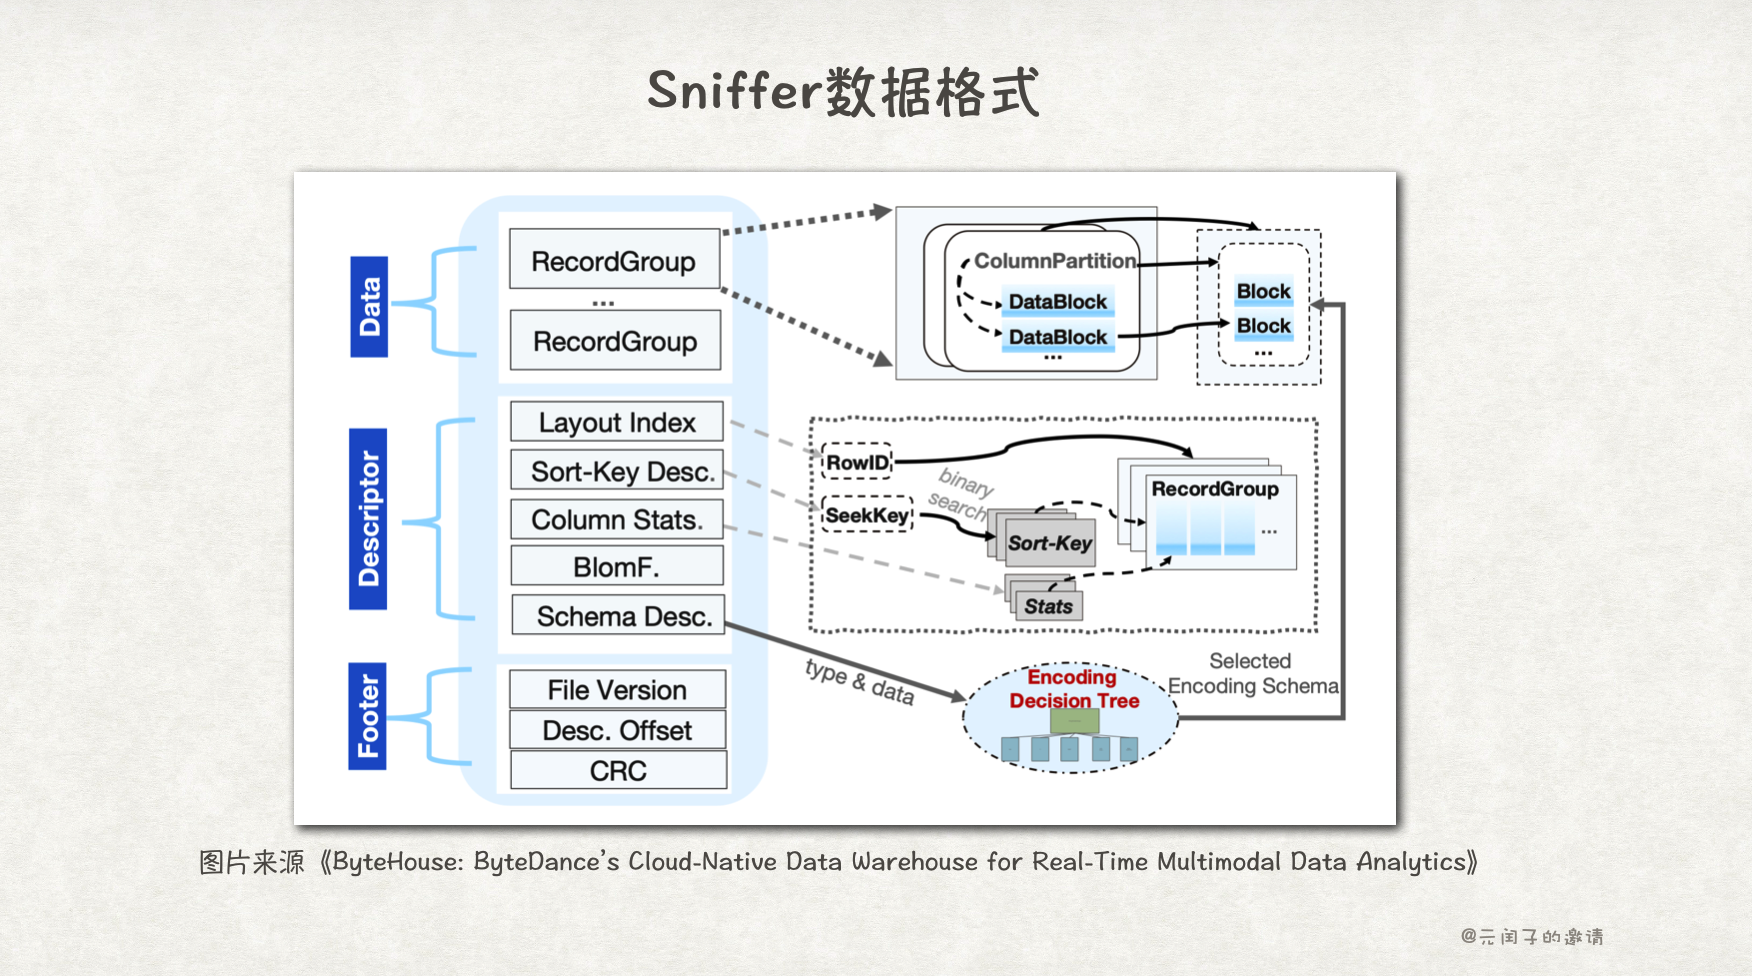
从布局上看,Sniffer 分成 3 部分:
- Data:存储实际数据,布局跟 Parquet 很像,DataBlock 是数据压缩的最小单位。
| Sniffer | Parquet |
|---|---|
| RecordGroup | RowGroup |
| ColumnPartition | Column |
| DataBlock | Page |
- Descriptor:统一存储索引、Schema 等元数据。
- Footer:只保留 File Version、Descriptor offset、CRC,长度固定。
通过 Descriptor, Sniffer 把 Sort-Key 与数据放在一个文件里面,不用引入额外的辅助索引就能进行二分搜索,点查路径更短了。
Descriptor 常驻内存,并通过 LRU 进行缓存管理。这也意味着 Sniffer 在缓存命中的情况下,只需 1 次内存元数据获取 + 1 次 IO 即可实现点查,时延可达微秒级。
ByteHouse 包含一个 Encoding Decision Tree,能够根据不同的数据类型、数据采样特征,自动选择合适的编码,从而使得 Sniffer 存储和检索更高效。
Sniffer 把向量作为“一等公民”,抛弃了 Parquet 的 Repetition&Definition 编码,采用 Length-and-Presence (L&P) 编码,为每个向量附加了向量范式等单独的元数据。
这样做的一个好处是,即使是同一列的不同向量,也能根据向量的特征选择不同 FOR 或 ALP 等不同的编码,更灵活了。代价是元数据存储体积更大了。
另外,Sniffer 对稀疏向量也做了优化,对于值为 0 的部分不再需要 padding,节省了存储空间。
总结来说,Sniffer 相比 Parquet 能够以更少的 IO 次数和更短的查询路径完成点查操作,并在向量存储和检索上做了优化。
不过,读放大问题,Sniffer 并没有解决。读取某个数据单元,仍需把整个 DataBlock 拉取到内存中解压。
Lance 数据格式倒是通过 Full Zip 编码解决了该问题,它的压缩单位是单个数据单元。所以,它能直接索引到某列某行的数据。代价是更低的压缩率。
表模型设计
ByteHouse 仍保留了表模型的设计,并针对多模态数据做了优化。
我们很容易通过 Table 来表征传统结构化数据,每个数据存储为一个数据单元,检索时用该数据单元作匹配即可。
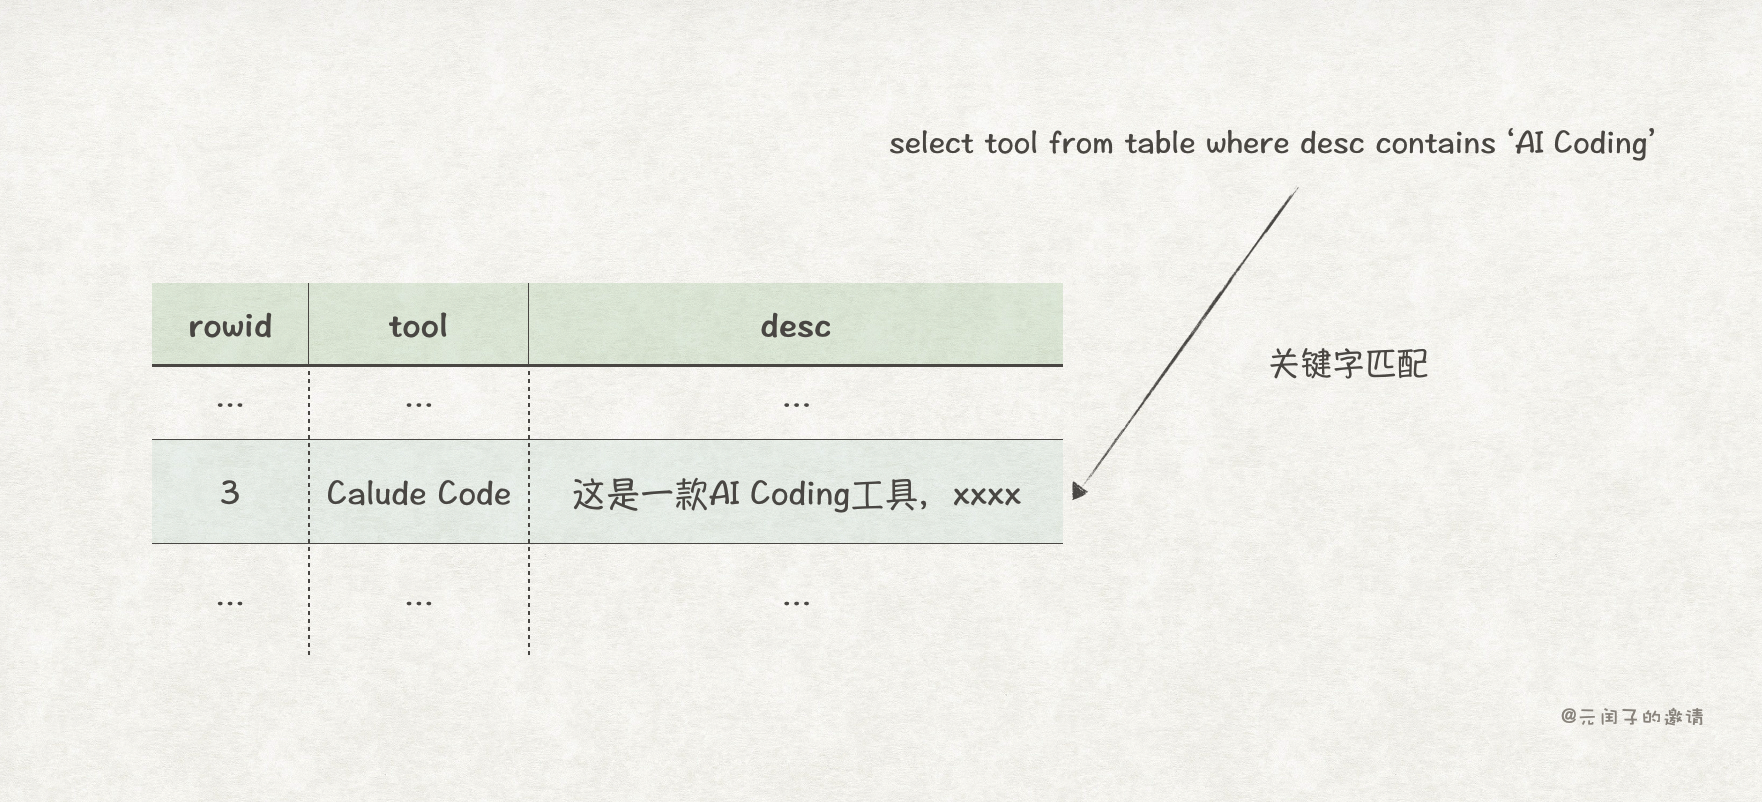
但对多模态数据,我们常常需要进行向量语义检索,这时该模型就不灵了。
以文档为例。虽然可以把文档全部内容都塞进一个数据单元,但对整个文档作向量 Embedding 后,会因为向量表征的文档太大,导致关键信息丢失。语义检索失效。
常见的做法是对文档进行切片,以切片为 Embedding 粒度,保留更多的语义信息。
视频、音频、图片也是类似的。
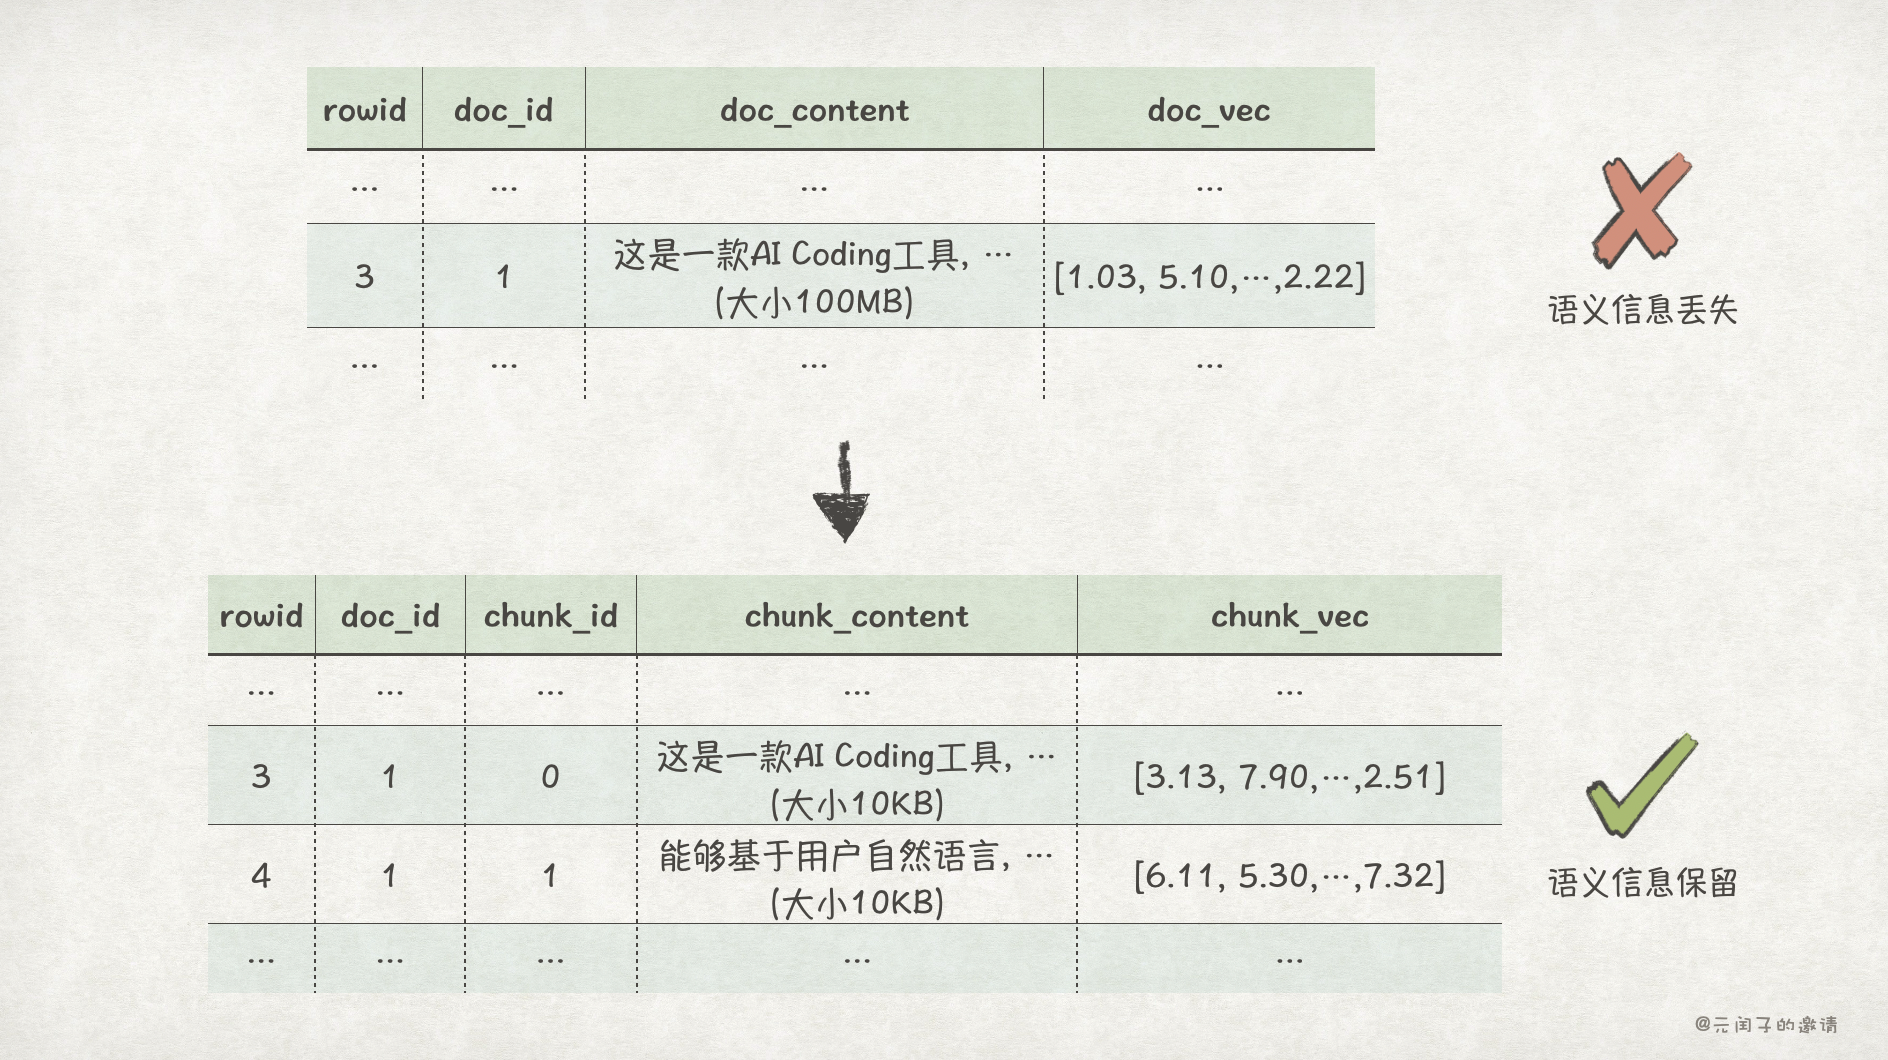
ByteHouse 就是采用 <document_id, chunk_id> 的表模型设计。
另外,在物理存储时,每个 Table 都包含 stable segments 和 delta segments 两部分。
- stable segments 不可变,针对 OLAP 吞吐量作优化。
- delta segments 应对数据的 insert、update,并根据自适应的 Compact 策略将变更数据合并到 stable segments 部分。
通过 MVCC 机制保证数据访问的一致性,从而能够支持实时 ETL 负载。
为了避免频繁小 IO,ByteHouse 的数据存储管道分 2 步:
- Key-Value 缓存。将行级写入缓存到 ByteKV 中,基于 WAL 保证数据持久化。
- 刷入列式存储。当缓存累积到阈值后,刷入列式存储。
整体看下来,有点像 LSM-Tree 的设计。
SSD 缓存
Sniffer 虽然降低了读数据的 IO 次数,但对象存储的带宽和时延硬伤,仍可能导致数据读写成为系统瓶颈。
ByteHouse 的生产数据表明,在处理小 IO、随机 IO 时,对象存储的读取时延可占端到端的 70%!
为此,ByteHouse 在存储层引入了 SSD 缓存,Cluster-Scale Caching。
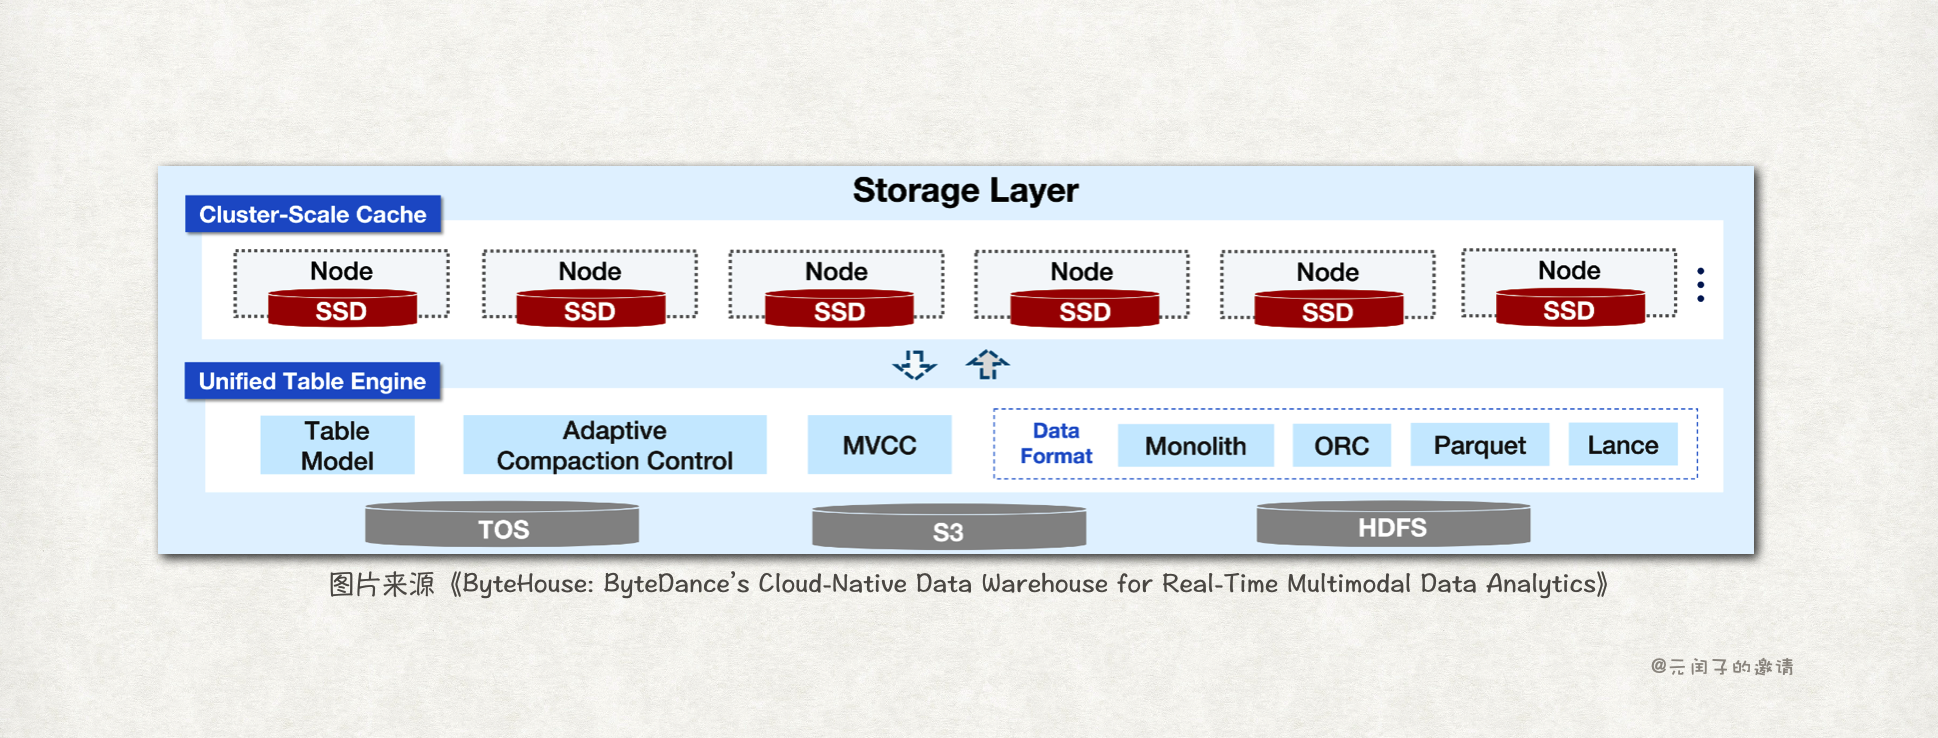
Cluster-Scale Caching 是一个分布式的缓存系统,包含 2 种角色:
- Cache Coordinators (CCs) :管理全局 namespace 和 metadata。
- Cache Nodes (CNs):提供 SSD 数据缓存。逻辑上将文件按照固定的大小(默认 12MB)分块管理,物理上会进一步将数据块分成 更小的块,从而减缓读放大问题。
文件系统抽象
到这里,存储层已经准备好,还需要能被计算节点访问的 API。
ByteHouse 把它抽象成 NexusFS,提供文件访问接口,集成在计算节点,是连接存储层和计算层的桥梁。
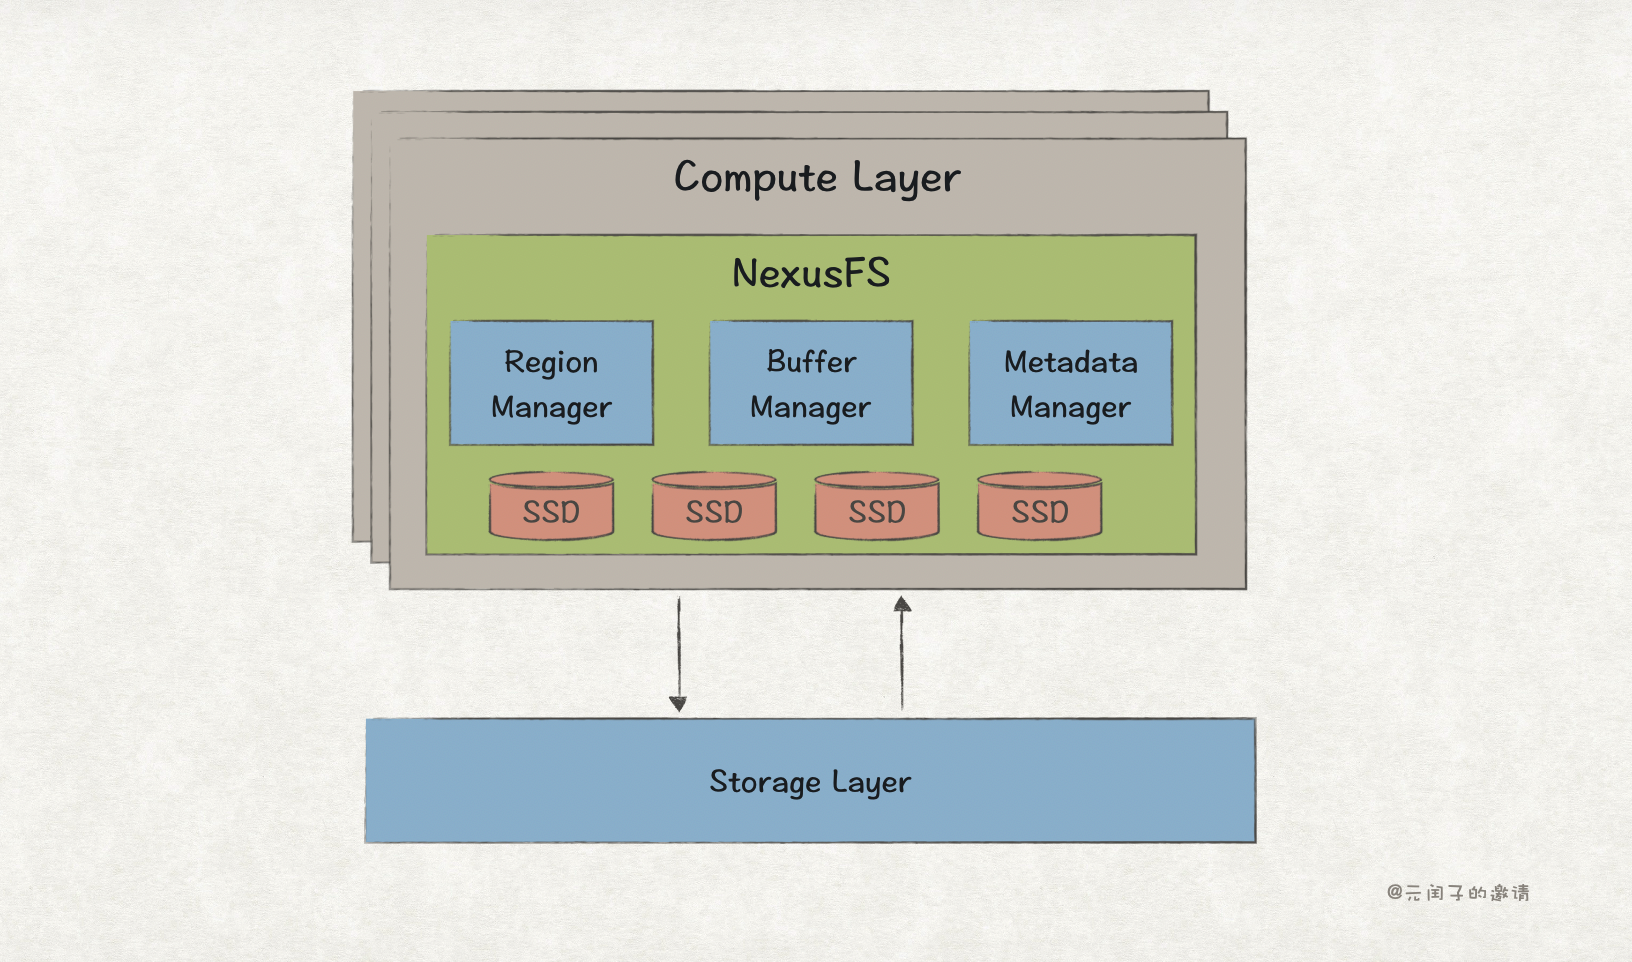
NexusFS 在计算侧也有本地 SSD 缓存,包含 3 个组件:
- Region Manager:将本地 SSD 划分成 1MB 大小的 region 进行管理,region 会被进一步划分成更小的 data segments,后者是 IO 调度和缓存的单位。
- Buffer Manager:对内存数据进行管理,计算层算子能够零拷贝读取其中的数据。
- Metadata Manager:管理 data segments 的元数据,比如该 data segment 所在的文件,该文件所在的 region 信息等。
NexusFS 采用全链路对齐 IO 的策略,确保数据在本地内存->本地 SSD->远端存储层都是 IO 对齐的,按照固定大小的 data segment 加载,消除碎片化 IO。
总结
本文主要介绍了 ByteHouse 存储层的一些设计思路。
在原有面向 OLAP 负载的设计上,增加了对多模检索和实时 ETL 能力的增强。
核心是:
- 统一 3 种不同负载的数据格式,将索引和数据放在同一文件,降低点查 IO 次数。
- 在对象存储之上增加 SSD 缓存,降低数据加载时延、提升 IO 带宽。
不过,ByteHouse 在点查负载上,并没有 Lance 优化的彻底,是压缩率和点查性能的权衡。
文章配图
可以在 用Keynote画出手绘风格的配图 中找到文章的绘图方法。
参考
[1] ByteHouse: ByteDance’s Cloud-Native Data Warehouse for Real-Time Multimodal Data Analytics, ByteDance
[2] Parquet File Format, Apache Parquet
(完)

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)