r6:LSTM实现糖尿病探索与预测
·
- **🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/o-DaK6aQQLkJ8uE4YX1p3Q) 中的学习记录博客**
- **🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)**
文章目录
概要
- 这是一个用 LSTM 神经网络预测糖尿病 的项目。
整体架构流程
读取数据 → 数据可视化 → 数据预处理 → 构建模型 → 训练模型 → 评估结果- 读取数据 — 从 Excel 读入1006条患者体检数据
- 可视化 — 用箱线图看各指标与糖尿病的关系
- 预处理 — 去掉无关列,转成 Tensor,切分训练集/测试集(8:2)
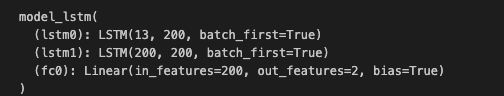
- 构建模型 — 两层 LSTM + 一层全连接,输出0或1(是否糖尿病)
- 训练 — 跑30轮,每轮记录准确率和损失值
- 评估 — 画出 Loss 和 Accuracy 曲线,观察模型效果
代码运行
import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision

# M2 芯片设置
device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")
print("使用设备:", device)

import numpy as np    #数字计算
import pandas as pd   #处理表格数据
import seaborn as sns  #画统计图
from sklearn.model_selection import train_test_split   #划分训练集和测试集
import matplotlib.pyplot as plt    #画图
plt.rcParams['savefig.dpi'] = 500    # 保存图片时的像素,500很清晰
plt.rcParams['figure.dpi'] = 500     # 显示图片时的分辨率
plt.rcParams['font.sans-serif'] = ['SimHei']  # 支持显示中文,否则中文会变成方块
import warnings
warnings.filterwarnings("ignore")  # 忽略警告信息

DataFrame = pd.read_excel('/Users/lilyj/Downloads/dia.xls')  # 读取一个叫 dia.xls 的 Excel 文件
DataFrame.head()   # 显示前5行,看看数据长什么样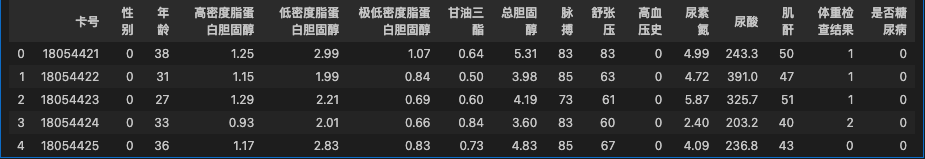
print('数据缺失值-----------------------------')
print(DataFrame.isnull().sum())  # 每列缺失值的数量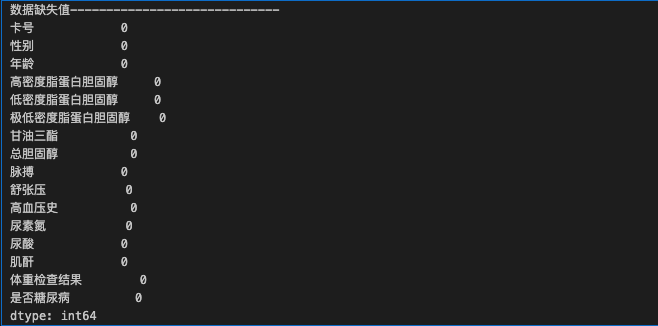
plt.rcParams['font.sans-serif'] = ['Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False

feature_map = {
    '年龄': '年龄',
    '高密度脂蛋白胆固醇': '高密度脂蛋白胆固醇',
    '低密度脂蛋白胆固醇': '低密度脂蛋白胆固醇',
    '极低密度脂蛋白胆固醇': '极低密度脂蛋白胆固醇',
    '甘油三酯': '甘油三酯',
    '总胆固醇': '总胆固醇',
    '脉搏': '脉搏',
    '舒张压': '舒张压',
    '高血压史': '高血压史',
    '尿素氮': '尿素氮',
    '尿酸': '尿酸',
    '肌酐': '肌酐',
    '体重检查结果': '体重检查结果'  # 修正这里
}

plt.figure(figsize=(15, 10))  # 宽15,高10(单位:英寸)

for i, (col, col_name) in enumerate(feature_map.items(), 1):
    plt.subplot(3, 5, i)
    sns.boxplot(x=DataFrame['是否糖尿病'], y=DataFrame[col])
    plt.title(f'{col_name}的箱线图', fontsize=14)
    plt.ylabel('数值', fontsize=12)
    plt.grid(axis='y', linestyle='--', alpha=0.7)

plt.tight_layout()
plt.show()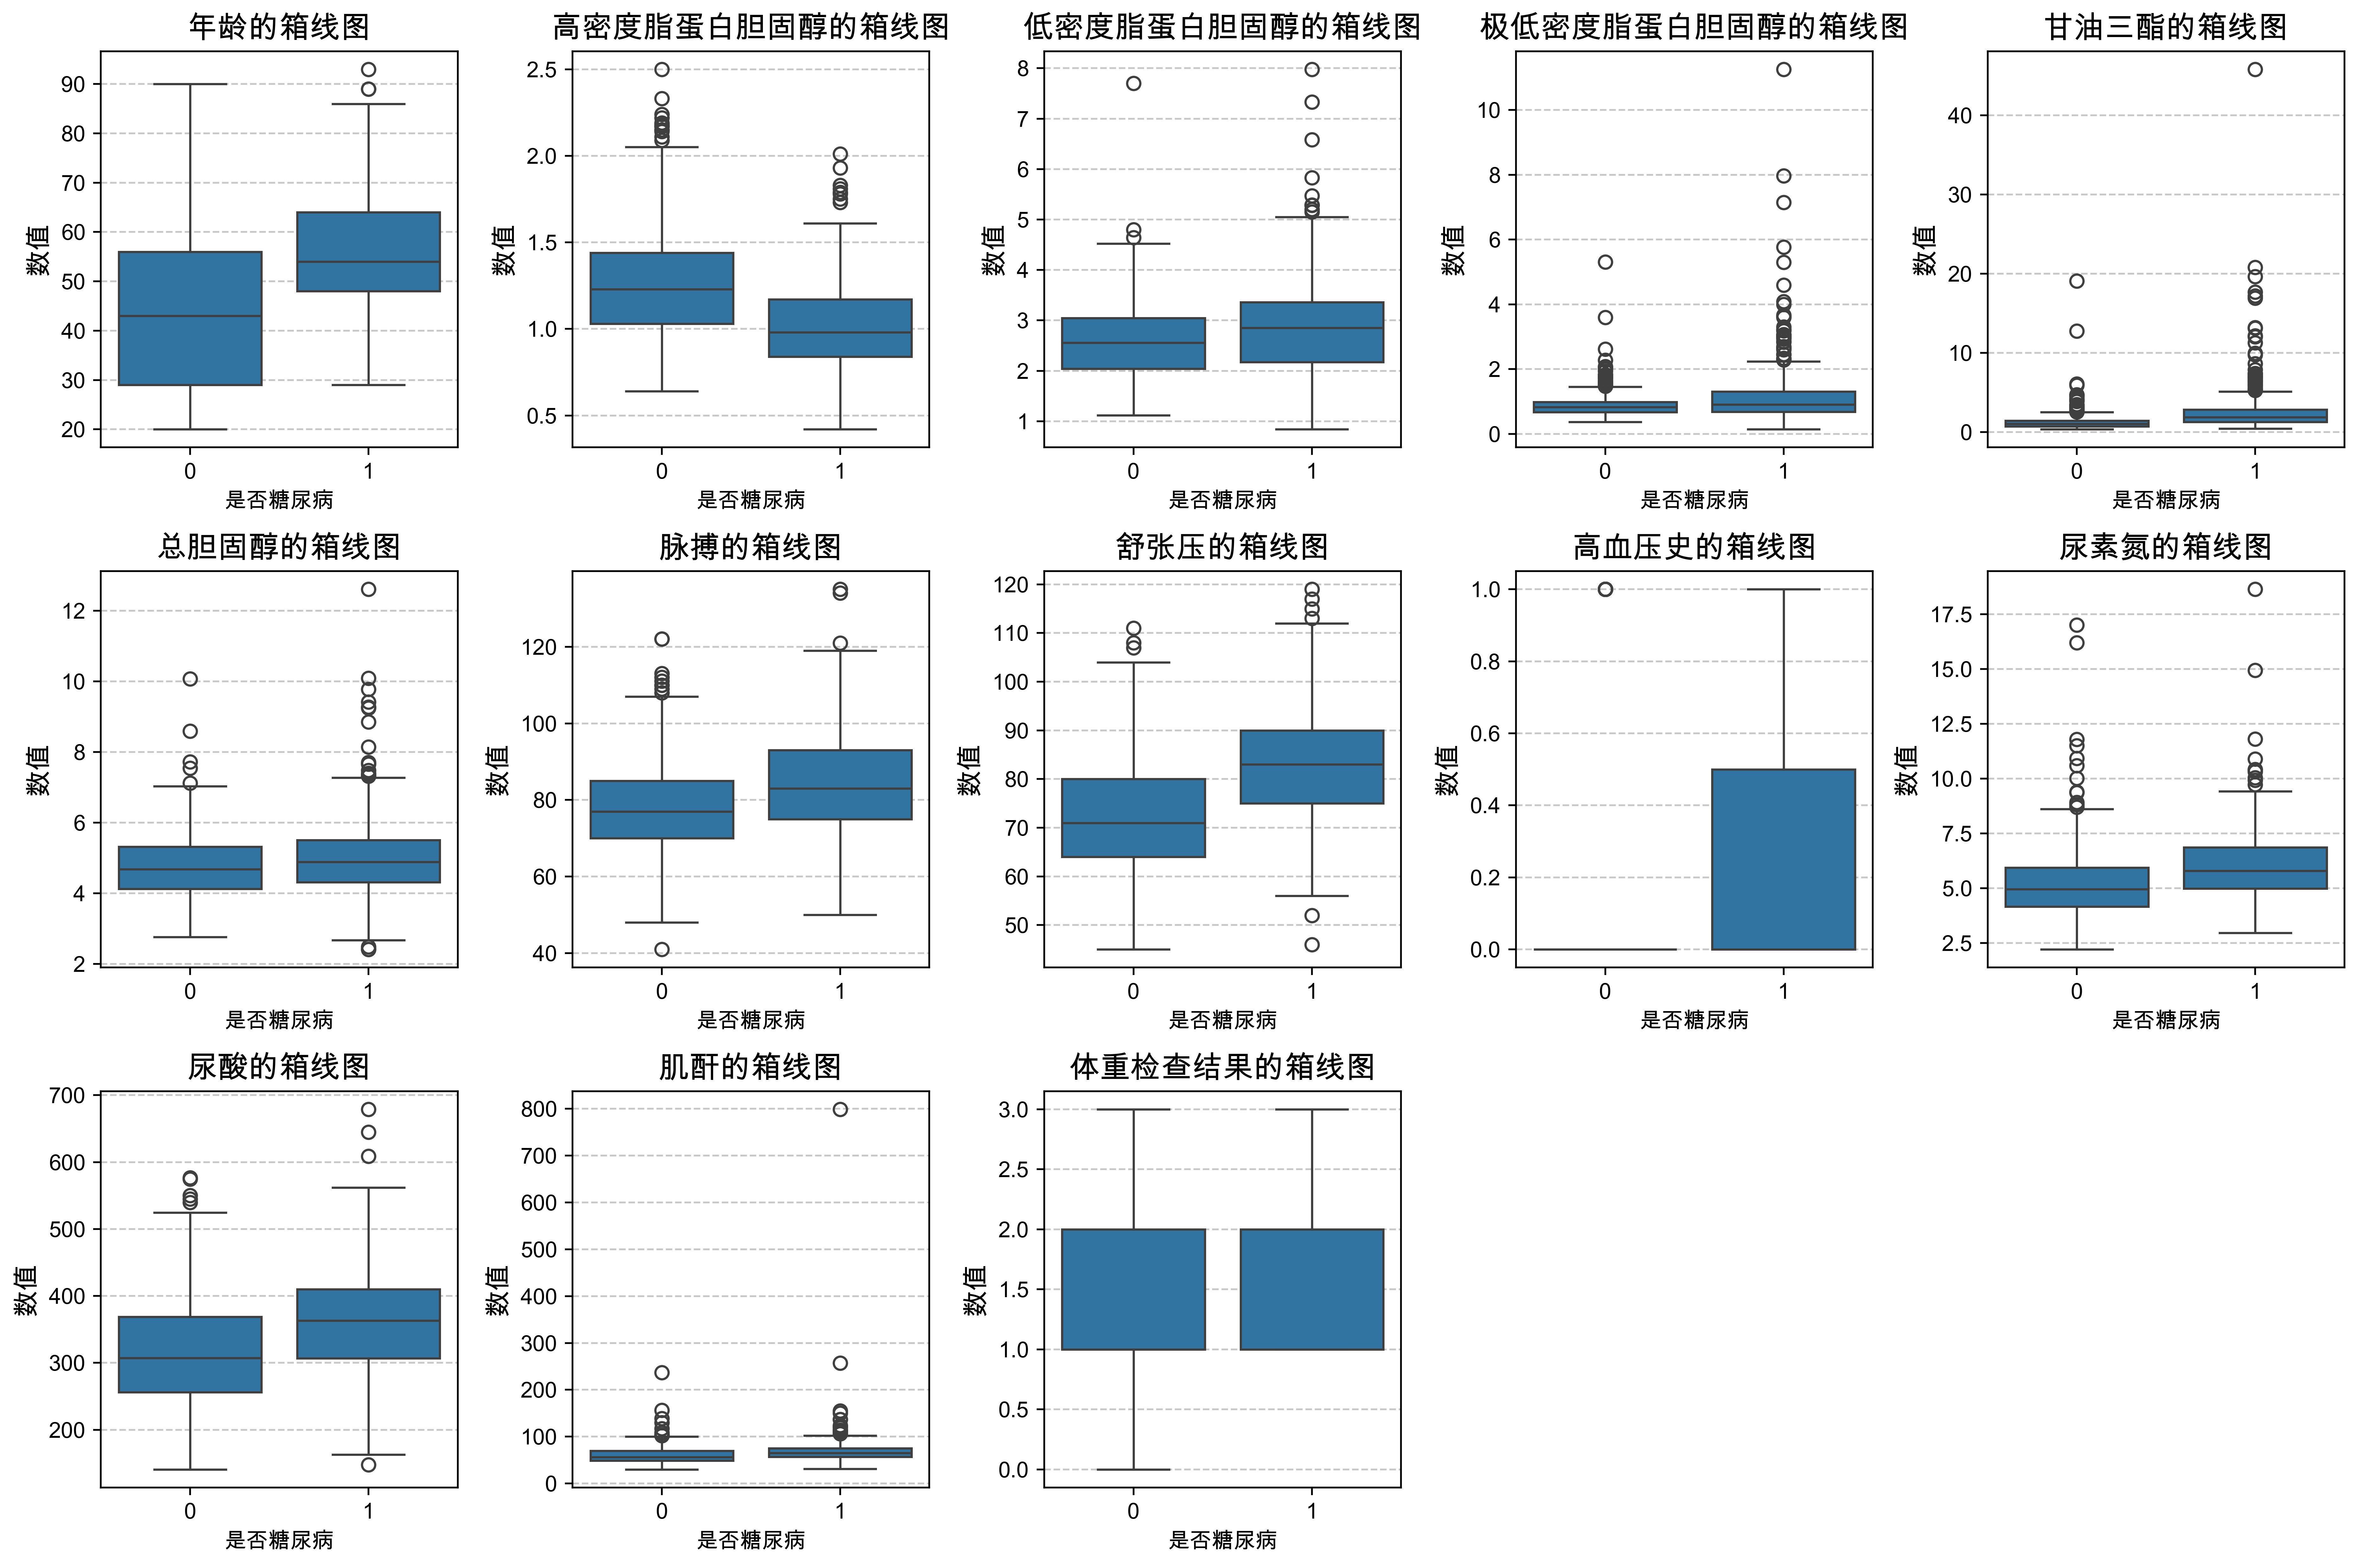
from sklearn.preprocessing import StandardScaler

# '高密度脂蛋白胆固醇'与糖尿病负相关,故在X中去掉该字段
X = DataFrame.drop(['卡号','是否糖尿病','高密度脂蛋白胆固醇'], axis=1)
y = DataFrame['是否糖尿病']

# sc_X = StandardScaler()
# X = sc_X.fit_transform(X)

X = torch.tensor(np.array(X), dtype=torch.float32)
y = torch.tensor(np.array(y), dtype=torch.int64)

train_X, test_X, train_y, test_y = train_test_split(X, y,
                                                      test_size=0.2,
                                                      random_state=1)
train_X.shape, train_y.shape

from torch.utils.data import TensorDataset, DataLoader

train_dl = DataLoader(TensorDataset(train_X, train_y),
                      batch_size=64,
                      shuffle=False)

test_dl = DataLoader(TensorDataset(test_X, test_y),
                     batch_size=64,
                     shuffle=False)


class model_lstm(nn.Module):
    def __init__(self):
        super(model_lstm, self).__init__()
        self.lstm0 = nn.LSTM(input_size=13, hidden_size=200,
                             num_layers=1, batch_first=True)
        self.lstm1 = nn.LSTM(input_size=200, hidden_size=200,
                             num_layers=1, batch_first=True)
        self.fc0 = nn.Linear(200, 2)

    def forward(self, x):
        out, hidden1 = self.lstm0(x)
        out, _ = self.lstm1(out, hidden1)
        out = self.fc0(out)
        return out

model = model_lstm().to(device)
model
# 训练循环
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)   # 训练集的大小
    num_batches = len(dataloader)    # 批次数目(size/batch_size,向上取整)

    train_loss, train_acc = 0, 0     # 初始化训练损失和正确率

    for X, y in dataloader:          # 获取图片及其标签
        X, y = X.to(device), y.to(device)

        # 计算预测误差
        pred = model(X)              # 网络输出
        loss = loss_fn(pred, y)      # 计算网络输出和真实值之间的差距

        # 反向传播
        optimizer.zero_grad()        # grad属性归零
        loss.backward()              # 反向传播
        optimizer.step()             # 每一步自动更新

        # 记录acc与loss
        train_acc  += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc  /= size
    train_loss /= num_batches

    return train_acc, train_loss

def test(dataloader, model, loss_fn):
    size       = len(dataloader.dataset)   # 测试集的大小
    num_batches = len(dataloader)          # 批次数目
    test_loss, test_acc = 0, 0

    # 当不进行训练时,停止梯度更新,节省计算内存消耗
    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            # 计算loss
            target_pred = model(imgs)
            loss        = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc  += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc  /= size
    test_loss /= num_batches

    return test_acc, test_loss


loss_fn    = nn.CrossEntropyLoss()  # 创建损失函数
learn_rate = 1e-4                   # 学习率
opt        = torch.optim.Adam(model.parameters(), lr=learn_rate)
epochs     = 30

train_loss = []
train_acc  = []
test_loss  = []
test_acc   = []

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, opt)

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    # 获取当前的学习率
    lr = opt.state_dict()['param_groups'][0]['lr']

    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%, Test_loss:{:.3f}, Lr:{:.2E}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss,
                          epoch_test_acc*100, epoch_test_loss, lr))

print("="*20, 'Done', "="*20)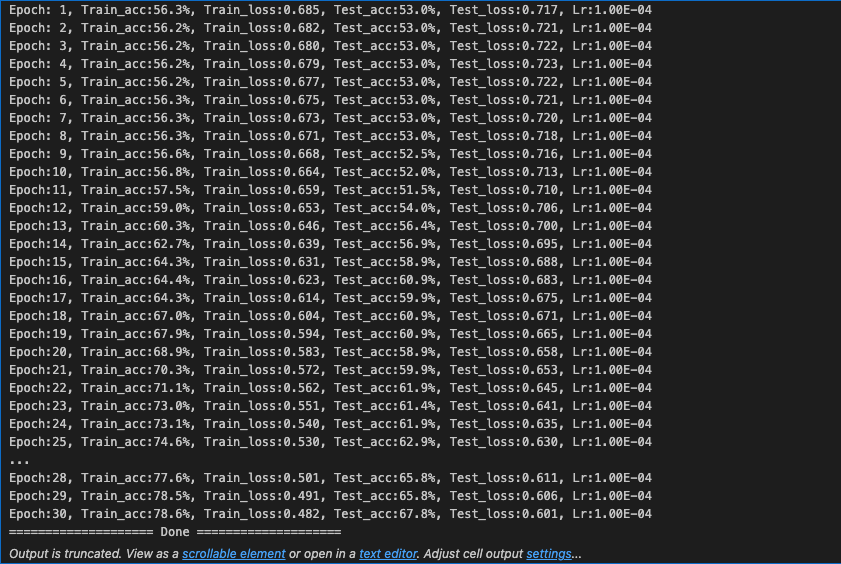
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")         # 忽略警告信息

plt.rcParams['font.sans-serif']    = ['Arial Unicode MS']  # 改成Mac支持的字体
plt.rcParams['axes.unicode_minus'] = False                 # 用来正常显示负号
plt.rcParams['figure.dpi']         = 100                  # 分辨率

from datetime import datetime
current_time = datetime.now()  # 获取当前时间

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc,  label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)  # 打卡请带上时间截图,否则代码截图无效

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss,  label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()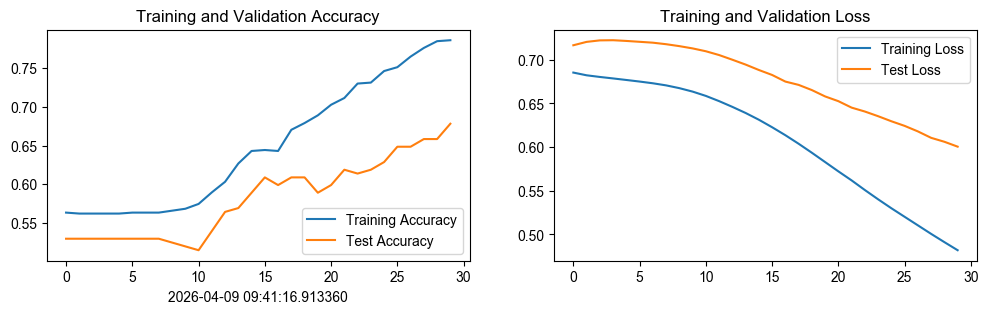
小结
- 输入是13个体检指标(血脂、血压、尿酸等),输出是是否患糖尿病;
- 用的是 LSTM,其实它更擅长处理时序数据(如股票、语音);
- M2 Mac 用的是 MPS 加速,相当于苹果版的 GPU 加

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 6
 0
- 0


 已为社区贡献6条内容

所有评论(0)