大云海山数据库(He3DB) PG内核分析-子查询优化
大云海山数据库(He3DB) 内核分析-子查询优化
概述
子查询分类:
相关子查询:子查询语句引用了外层查询中表的列属性。eg : select * from t1 where c1 exists (select c1 from t2 where t1.c2 = t2.c2);
非相关子查询:子查询语句和外层表没有直接关系,子查询可以单独执行一次,外层查询重复使用子查询的执行结果。eg :select * from t1 where c1 exists (select c1 from t2);
He3DB子查询分类:
子连接:出现在表达式中的子查询叫做子连接(where、on、having条件、投影中)。
eg:select * from t1 where c1 in (select c1 from t2);
子查询:出现在范围表中的子查询叫做子查询(from子句)。
eg:select * from t1 , (select * from t2) t ;
抛开大云海山数据库(He3DB) 不看,单独理解子查询优化可以分为:子查询合并、子查询反嵌套(子查询上拉)、聚集子查询消除三种优化思路,在He3DB中仅仅实现了子查询上拉中的部分优化功能,对于另外两种是完全不支持。
子连接上拉
He3DB中子连接有以下几种
typedef enum SubLinkType
{
EXISTS_SUBLINK,
ALL_SUBLINK,
ANY_SUBLINK,
ROWCOMPARE_SUBLINK,
EXPR_SUBLINK,
MULTIEXPR_SUBLINK,
ARRAY_SUBLINK,
CTE_SUBLINK /* for SubPlans only */
} SubLinkType;
He3DB主要对其中的EXISTS_SUBLINK、ANY_SUBLINK两种子连接做了上拉优化,其他类型的子连接不做上拉处理,EXISTS_SUBLINK对应的是SQL语句中的exists、not exists谓词,ANY_SUBLINK对应的是any、in、not in、some谓词,ALL_SUBLINK对应的是all谓词,但是ALL_SUBLINK在He3DB中没有做上拉不在详细展开,着重看一下EXISTS_SUBLINK和ANY_SUBLINK类型的子连接上拉。
EXISTS_SUBLINK上拉:He3DB优化器会上拉相关联的exists子连接,变形成为semijoin,非相关exists子连接不上拉形成initplan单独求解,一次求解全局使用。
exists相关子连接:
postgres=# explain select * from t1 where exists (select c1 from t2 where t1.c1 = t2.c1);
QUERY PLAN
Hash Semi Join (cost=271.00…555.88 rows=10100 width=8)
Hash Cond: (t1.c1 = t2.c1)
-> Seq Scan on t1 (cost=0.00…146.00 rows=10100 width=8)
-> Hash (cost=146.00…146.00 rows=10000 width=4)
-> Seq Scan on t2 (cost=0.00…146.00 rows=10000 width=4)
(5 rows)
exists非相关子连接:
postgres=# explain select * from t1 where exists (select c1 from t2 );
QUERY PLAN
Result (cost=0.01…146.01 rows=10100 width=8)
One-Time Filter: $0
InitPlan 1 (returns $0)
-> Seq Scan on t2 (cost=0.00…146.00 rows=10000 width=0)
-> Seq Scan on t1 (cost=0.01…146.01 rows=10100 width=8)
(5 rows)
not exists 相关子连接
postgres=# explain select * from t1 where not exists (select c1 from t2 where t1.c1 = t2.c1);
QUERY PLAN
Hash Anti Join (cost=271.00…454.88 rows=1 width=8)
Hash Cond: (t1.c1 = t2.c1)
-> Seq Scan on t1 (cost=0.00…146.00 rows=10100 width=8)
-> Hash (cost=146.00…146.00 rows=10000 width=4)
-> Seq Scan on t2 (cost=0.00…146.00 rows=10000 width=4)
(5 rows)
not exists非相关子连接
postgres=# explain select * from t1 where not exists (select c1 from t2 );
QUERY PLAN
Result (cost=0.01…146.01 rows=10100 width=8)
One-Time Filter: (NOT $0)
InitPlan 1 (returns $0)
-> Seq Scan on t2 (cost=0.00…146.00 rows=10000 width=0)
-> Seq Scan on t1 (cost=0.01…146.01 rows=10100 width=8)
(5 rows)
ANY_LINK上拉:any类型的子连接理论上相关和非相关都可以上拉转成semijoin,在He3DB中只做了非相关的子连接上拉,相关子连接还是以subplan的形式执行。
any相关子连接:
postgres=# explain select * from t1 where c1 > any (select c1 from t2 where t1.c2 = t2.c2);
QUERY PLAN
Seq Scan on t1 (cost=0.00…863733.88 rows=5050 width=8)
Filter: (SubPlan 1)
SubPlan 1
-> Seq Scan on t2 (cost=0.00…171.00 rows=1 width=4)
Filter: (t1.c2 = c2)
(5 rows)
any非相关子连接
postgres=# explain select * from t1 where c1 > any (select c1 from t2);
QUERY PLAN
Nested Loop Semi Join (cost=0.00…1010368.00 rows=3367 width=8)
Join Filter: (t1.c1 > t2.c1)
-> Seq Scan on t1 (cost=0.00…146.00 rows=10100 width=8)
-> Materialize (cost=0.00…196.00 rows=10000 width=4)
-> Seq Scan on t2 (cost=0.00…146.00 rows=10000 width=4)
(5 rows)
子连接上拉代码实现
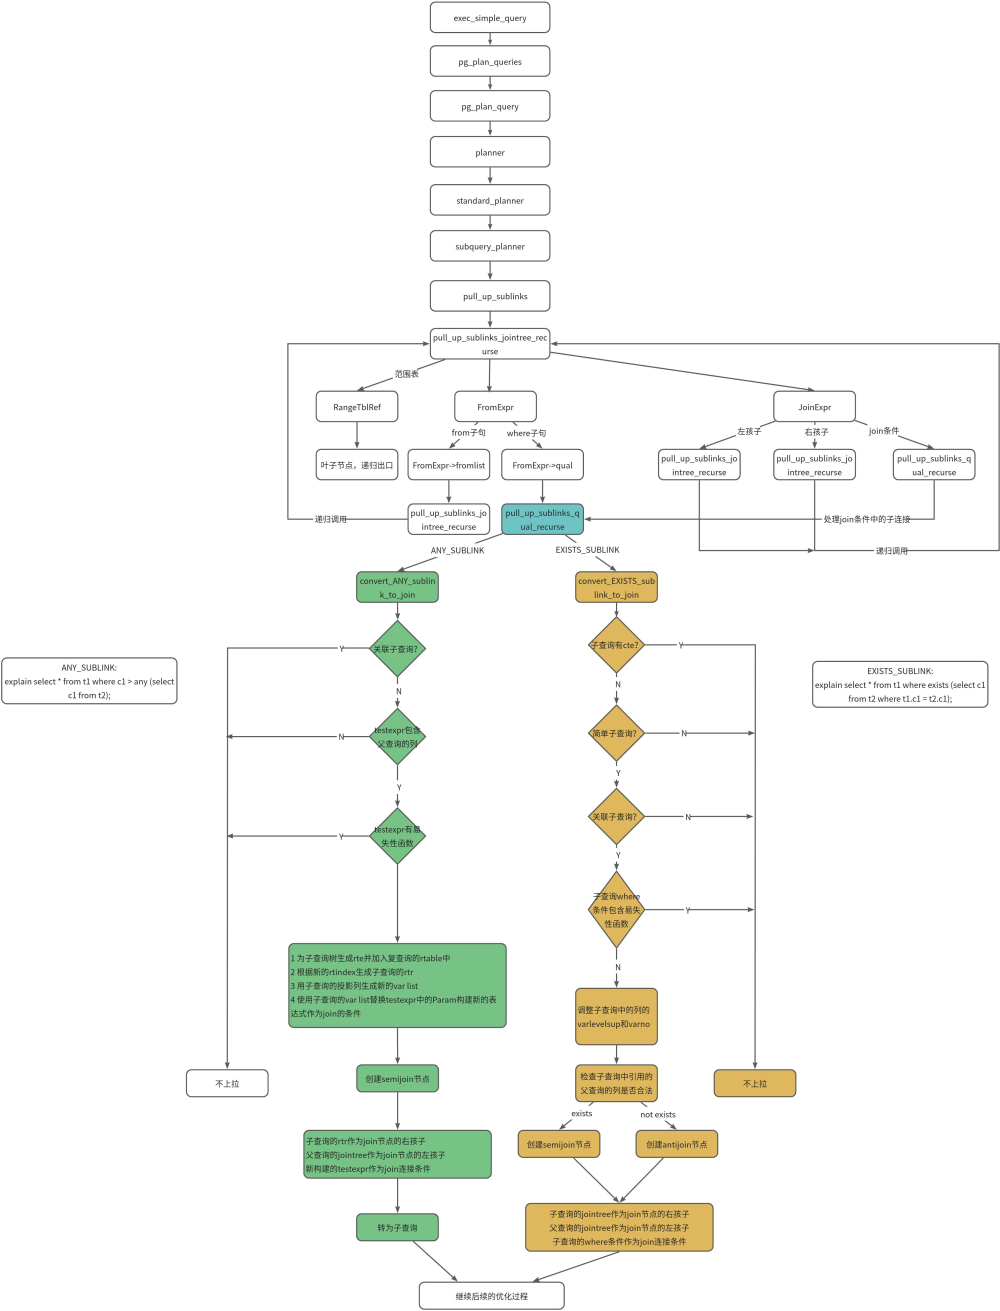
从上面的流程图可以看出子连接的优化在He3DB中相当的苛刻,必须要严格满足必要的条件才能执行子连接上拉的优化逻辑。
对于EXISTS_SUBLINK类型的子连接需要满足以下条件才能上拉:
1)子查询中不能包含cte语句。
2)子查询必须要是简单的语句:不能有聚集、分组、窗口函数、limit等子句。
3)子查询中where/on条件必须包含父查询的列(关联子查询),其他子句必须不包含父查询的列。
4)子查询不能含有易失性函数。
EXISTS_SUBLINK类型子连接上拉过程:
1)调整子查询中var的varno和varlevelsup值
2)子查询的范围表添加到父查询的rtable链表中
3)创建join节点,左孩子使用父查询的范围表,右孩子使用子查询的范围表,根据exists和not exists分别使用semijoin和antijoin。
对于ANY_SUBLINK类型的子连接上拉的条件:
1)子查询必须为非关联子查询
2)any表达式必须包含父查询相关的列(testexpr)
3)any表达式不能有易失性函数
ANY_SUBLINK类型子连接上拉过程:
1)为子查询生成RangetableEntry(rte),并插入父查询的rtable中
2)生成新的RangeTableRef(rtr)
3)使用子查询的投影列生成新的var list,替换testexpr中的Param,构建新的表达式作为join的条件
4)创建semijoin节点,左孩子使用父查询的范围表,右孩子使用子查询的rtr,连接条件使用varlist生成的新表达式。
从上面的步骤可以看出EXISTS_SUBLINK是直接转为表和表之间的连接,而ANY_SUBLINK类型的子连接则是转为子查询,再由后续的子查询上拉逻辑处理变形后查询树,到此He3DB中的子连接上拉优化逻辑就梳理完了。
子查询上拉
子查询上拉代码实现
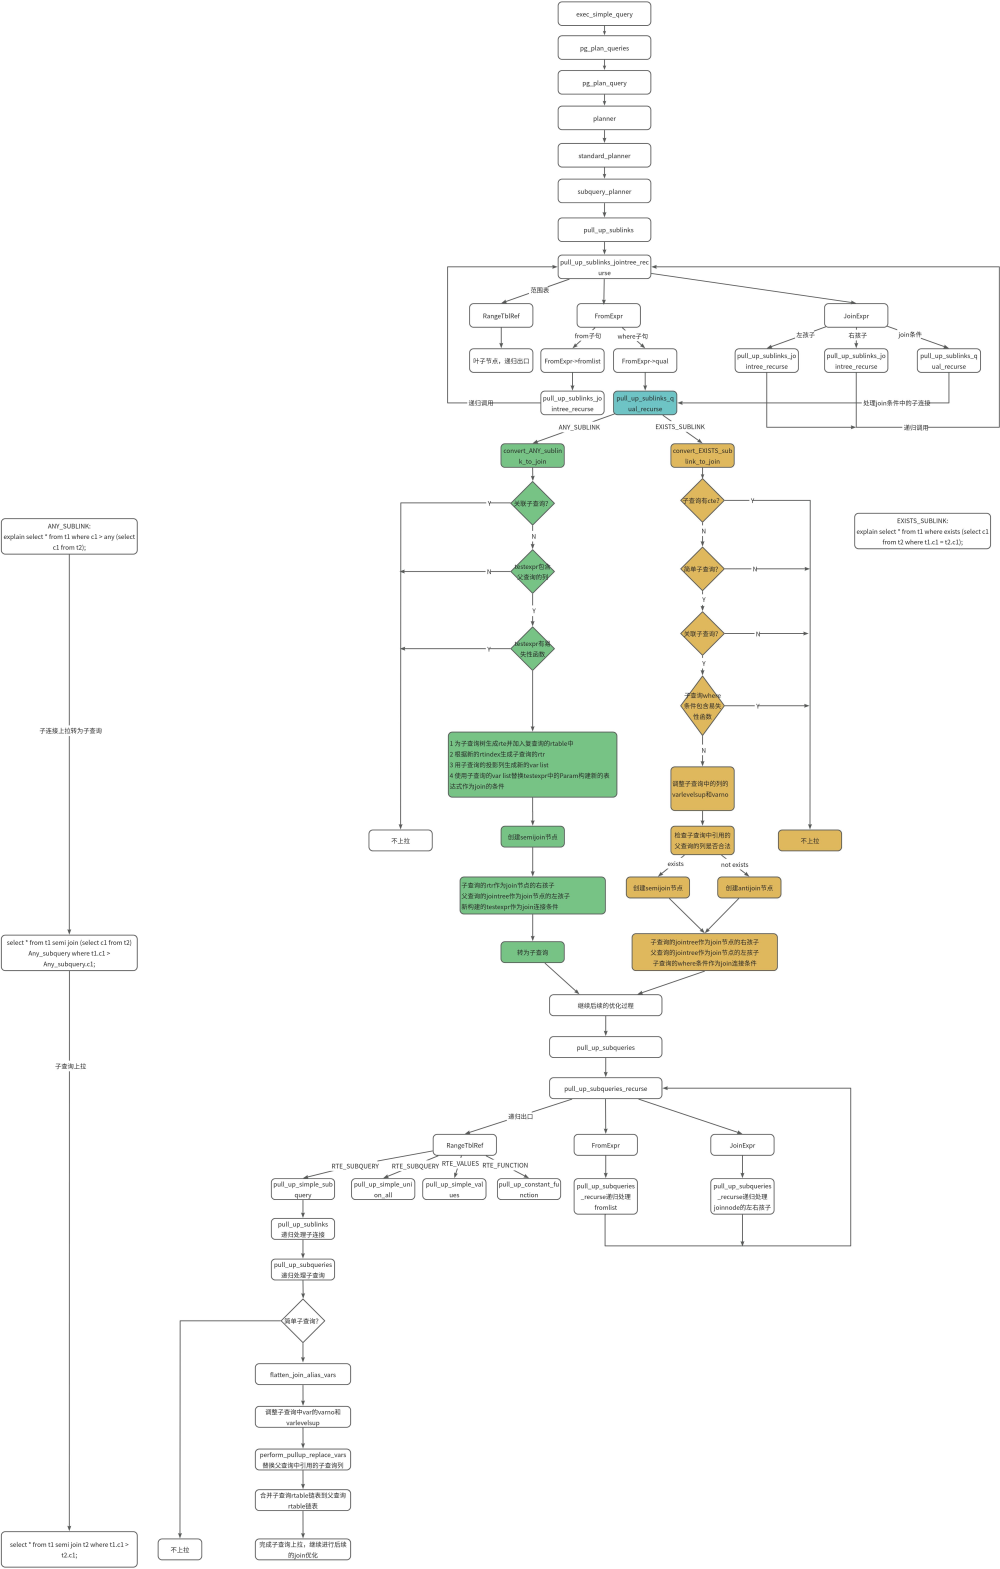
子查询上拉功能主要实现函数是pull_up_subqueries_recurse,该函数根据输入节点类型分三种不同情况处理:RangeTblRef、FromExpr、JoinExpr,其中RangeTblRef是叶子节点,也是递归逻辑的出口,其他两种类型最终都会递归处理到RangeTblRef类型中,在RangeTblRef类型中又根据rtekind分为四种情况处理
1)RTE_SUBQUERY(simple):调用pull_up_simple_subquery函数处理
2)RTE_SUBQUERY(union):调用pull_up_simple_union_all函数处理
3)RTE_SUBQUERY(values):调用pull_up_simple_values函数处理
4)RTE_SUBQUERY(function):调用pull_up_constant_function函数处理
其中simple类型的子查询最常使用,下面看一下该类型的子查询的提升逻辑实现。
和子连接一样RTE_SUBQUERY(simple)子查询想要上拉也得满足一定的条件:
1)子查询是select类型的子查询
2)子查询不能包含集合操作,setOperations为NULL
3)子查询不能有agg、group by、sort、limit、cte、窗口函数等操作
4)子查询不能含有易失性函数
RTE_SUBQUERY(simple)子查询上拉过程:
1)调整子查询中列的varno和varlevelsup值
2)如果父查询中引用了子查询的列,使用调整后var替换父查询的引用
3)合并子查询的rtable链表到父查询的rtable链表中,合并父子查询树

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 13
 0
- 0


 已为社区贡献3条内容

所有评论(0)