R1 TensorFlow|RNN-心脏病预测
- **🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/o-DaK6aQQLkJ8uE4YX1p3Q) 中的学习记录博客**
- **🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)**
文章目录
概要
这是一个用 SimpleRNN(简单循环神经网络)做二分类任务的完整流程,数据集共 302 条样本,13 个特征,目标是预测一个 0/1 的类别标签(比如心脏病有无)。
整体架构流程
设置GPU→数据分割→标准化→构建模型→编译模型→训练模型→可视化评估
数据分割
df.iloc[:,:-1] 取除最后一列外的所有列作为特征 X,df.iloc[:,-1] 取最后一列作为标签 y。然后用 train_test_split 按 9:1 的比例划分训练集(272条)和测试集(30条)。
标准化
StandardScaler 把每一列特征变换为均值为 0、标准差为 1 的分布,消除不同特征量纲差异的影响。注意 fit_transform 只在训练集上拟合(学习均值和标准差),测试集只用 transform(用训练集的参数来变换),防止数据泄露。
之后 reshape 把数据从 (样本数, 13) 变成 (样本数, 13, 1),这是因为 RNN 要求输入是三维的:(batch_size, 时间步, 特征数)。这里把 13 个特征当作 13 个时间步,每步 1 个特征。
构建模型
用 Sequential 顺序堆叠三层:
SimpleRNN(200)—— 循环层,输入形状(13,1),输出 200 维的隐藏状态,激活函数 reluDense(100, relu)—— 全连接隐藏层,进一步提取特征Dense(1, sigmoid)—— 输出层,sigmoid 将输出压缩到 0~1 之间,表示属于正类的概率
总参数 60,601 个,全部可训练。
编译模型
指定训练时用的三个要素:损失函数用 binary_crossentropy(二分类标准损失),优化器用 Adam(学习率 0.0001,比默认的 0.001 更保守,训练更稳定),评价指标用准确率。
训练模型
训练 100 个 epoch,每批次 128 条数据,同时传入测试集作为验证集,每轮结束后都会输出训练集和验证集的 loss 和 accuracy,便于观察是否过拟合。
可视化评估
画两张折线图:左图对比训练准确率和验证准确率随 epoch 的变化,右图对比训练损失和验证损失的变化。通过两条曲线是否出现明显分叉,判断模型是否过拟合
代码运行
#1.设置gpu
import tensorflow as tf
gpus = tf.config.list_physical_devices("GPU")  #TensorFlow 能看到哪些物理 GPU
if gpus:
    gpu0 = gpus[0]   #如果有 GPU,就选第一块(GPU:0)
    tf.config.experimental.set_memory_growth(gpu0, True)  #设置显存按需增长
    tf.config.set_visible_devices([gpu0], "GPU")  #限制 TF 只看见这一块 GPU
gpus

#2.导入数据
import pandas as pd
import numpy as np
df = pd.read_csv("heart.csv")
df

#3.检查数据
df.isnull().sum()  #检查是否有空值

#4.数据预处理
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split

X = df.iloc[:,:-1]
y = df.iloc[:,-1]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.1, random_state=1)
X_train.shape, y_train.shape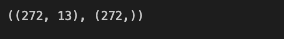
# 将每一列特征标准化为标准正态分布,注意,标准化是针对每一列而言的
sc       = StandardScaler()
X_train = sc.fit_transform(X_train)
X_test  = sc.transform(X_test)

X_train = X_train.reshape(X_train.shape[0], X_train.shape[1], 1)
X_test  = X_test.reshape(X_test.shape[0], X_test.shape[1], 1)

import tensorflow
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, LSTM, SimpleRNN

model = Sequential()  #创建一个空模型
model.add(SimpleRNN(200, input_shape=(13,1), activation='relu'))
model.add(Dense(100, activation='relu'))
model.add(Dense(1, activation='sigmoid'))
model.summary()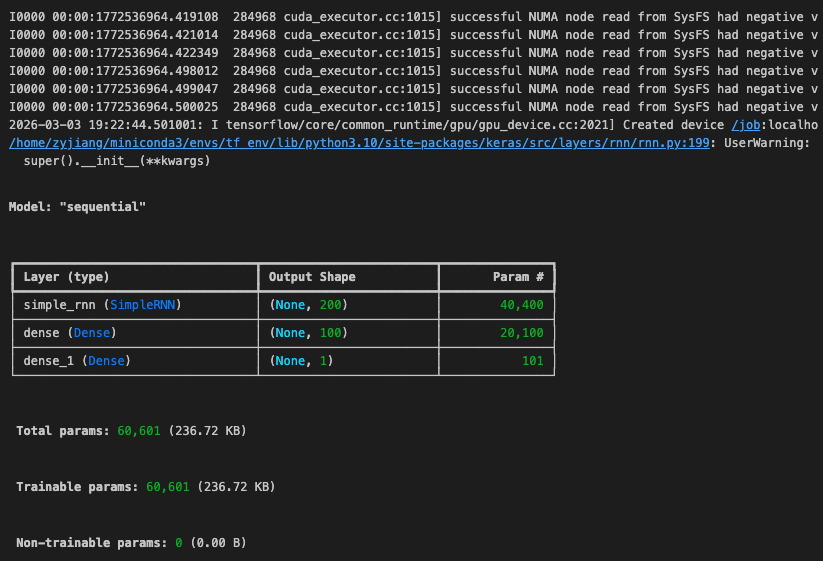
#编译模型
opt = tf.keras.optimizers.Adam(learning_rate=1e-4)

model.compile(loss='binary_crossentropy',
              optimizer=opt,
              metrics=['accuracy'])

epochs = 100

history = model.fit(X_train, y_train,
                    epochs=epochs,
                    batch_size=128,
                    validation_data=(X_test, y_test),
                    verbose=1)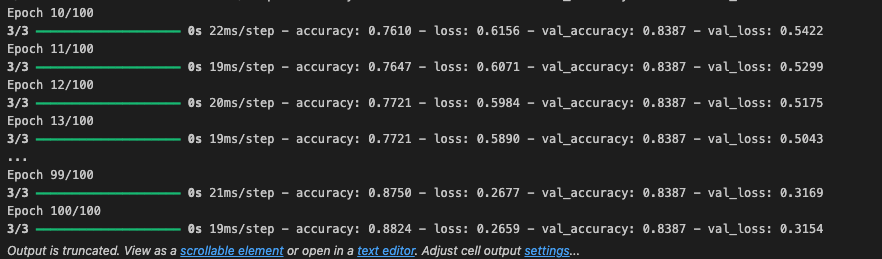
import matplotlib.pyplot as plt
from datetime import datetime
current_time = datetime.now()  # 获取当前时间

acc     = history.history['accuracy']
val_acc = history.history['val_accuracy']

loss     = history.history['loss']
val_loss = history.history['val_loss']

epochs_range = range(epochs)

plt.figure(figsize=(14, 4))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, acc, label='Training Accuracy')
plt.plot(epochs_range, val_acc, label='Validation Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)  # 打卡请带上时间戳,否则代码截图无效

plt.subplot(1, 2, 2)
plt.plot(epochs_range, loss, label='Training Loss')
plt.plot(epochs_range, val_loss, label='Validation Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()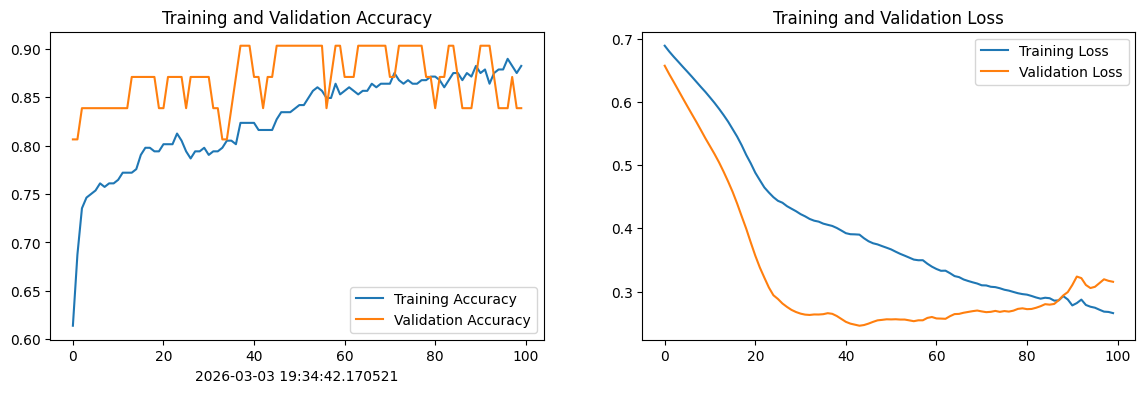
技术名词解释
编译模型
loss(损失函数) → 用什么标准衡量"预测有多错"
optimizer(优化器)→ 用什么方法来纠错、更新权重
metrics(评价指标)→ 训练过程中展示什么指标给你看
小结
时间步本来应该有顺序关系,比如昨天的股价影响今天的。但这13个医疗特征之间并没有先后顺序,年龄和血压谁先谁后没有意义。
实际上这个任务用普通的全连接网络(MLP)效果可能差不多甚至更好

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)