计算机毕业设计Hadoop+Spark游戏推荐系统 游戏可视化 大数据毕业设计(源码+文档+PPT+讲解)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Hadoop+Spark游戏推荐系统文献综述
引言
随着全球游戏市场规模突破2000亿美元,Steam等平台日均活跃用户超9500万,游戏数量呈指数级增长至超10万款。玩家面临严重的信息过载问题,传统推荐系统因依赖单机算法和单一特征维度,暴露出冷启动困难、实时性不足、长尾游戏曝光率低等核心缺陷。Hadoop与Spark作为大数据技术栈的核心组件,通过分布式存储与内存计算的协同,为构建高效、智能的游戏推荐系统提供了突破性解决方案。本文从技术架构、算法创新、应用场景及挑战等维度,系统梳理国内外相关研究进展,为游戏推荐系统的智能化升级提供理论支撑。
技术架构演进:从单机到分布式协同
Hadoop的分布式存储与容错机制
Hadoop的HDFS通过主从架构实现游戏数据的高容错性存储。例如,清华大学团队利用HDFS分块存储MOBA游戏高清截图、视频预告片及用户评论等非结构化数据,通过3副本机制保障数据可靠性,支持PB级历史数据的高并发访问。某开放世界游戏厂商采用HDFS存储10TB原始数据,结合Hive数据仓库按游戏类型、发布时间等维度组织数据,使复杂聚合查询效率提升3倍。HDFS的扩展性优势显著,单集群可横向扩展至100节点,支撑每日TB级数据增量存储。
Spark的内存计算与实时处理能力
Spark通过RDD抽象机制和内存计算特性,显著提升了数据处理效率。实验表明,在处理10万用户对5万款游戏的TB级交互数据时,Spark的ALS协同过滤模型训练时间较Hadoop MapReduce缩短80%,实时推荐延迟控制在200ms以内。Netflix通过Spark实现用户观看行为实时分析,将推荐延迟从分钟级压缩至毫秒级;复旦大学提出的Transformer序列推荐模型,利用Spark捕捉用户游戏时长、付费行为等时序特征,在MOBA类游戏推荐中提升准确率13%。Spark Streaming与Kafka的集成进一步优化了实时流处理性能,例如某FPS游戏厂商通过Kafka采集玩家每秒产生的百万级点击事件,Spark Streaming实时更新用户特征向量并触发推荐模型重训练,使推荐结果响应延迟降低至50ms。
算法创新:从单一模型到混合推荐
传统算法的优化与突破
协同过滤算法在冷启动场景下效果不佳,研究者通过引入辅助信息缓解数据稀疏性问题。例如,结合游戏IP关联(如《魔兽世界》与《炉石传说》的联动)构建知识图谱,使跨领域推荐准确率提高22%。内容推荐算法则利用自然语言处理(NLP)技术提取游戏描述文本特征,如通过BERT模型从Steam商店描述中提取玩法标签(如“生存建造”“开放世界”),F1值达0.85。深度学习算法通过自动学习特征表示,显著提升推荐准确性。CNN处理游戏截图:采用ResNet50模型对游戏截图进行风格分类(如赛博朋克、像素风),准确率达92%;RNN捕捉行为序列:通过LSTM模型分析用户历史游戏序列,预测其长期兴趣演变规律,某FPS游戏厂商利用该技术使新游戏上线后的推荐曝光率提升60%。
混合推荐模型的崛起
混合推荐模型通过动态权重融合多算法优势,成为当前研究热点。例如,某系统采用“协同过滤(50%)+深度学习(30%)+知识图谱(20%)”的权重分配策略,其中深度学习部分基于Transformer模型捕捉用户行为序列的时序依赖,知识图谱整合游戏IP关联。实验表明,该模型在长尾游戏推荐准确率上较传统方法提升28%,跨领域推荐准确率提高22%。北京大学构建的游戏知识图谱,将IP关联、玩法相似度等结构化知识融入推荐逻辑,使推荐多样性提升40%。Spark MLlib的Word2Vec算法生成游戏语义向量,构建用户-游戏特征矩阵,进一步优化推荐效果。
应用场景:从离线批处理到实时动态推荐
离线批处理推荐
Hadoop+Spark组合可高效处理大规模离线推荐任务。例如,基于Spark MLlib实现ALS算法,在Hadoop集群上训练10亿级用户-游戏评分矩阵,相比单机版本提速20倍。内容过滤(CB)通过Hive提取游戏标签(如RPG、MOBA),结合Spark计算游戏相似度矩阵,解决新游戏冷启动问题。某科技企业基于Kubernetes部署Spark集群,支持动态扩缩容至100节点,通过Hive LLAP加速复杂查询,实现推荐API QPS≥10万。
实时动态推荐
Spark Streaming与Kafka的集成实现了毫秒级响应的实时推荐引擎。例如,某系统构建Lambda架构:
- Batch Layer:每日通过Spark SQL离线计算用户长期兴趣;
- Speed Layer:通过Spark Streaming处理Kafka中的实时行为,更新短期兴趣向量。
文献提出基于Spark的增量学习框架,仅更新模型受新数据影响的部分参数,将训练时间缩短70%。Redis缓存热门推荐结果进一步降低延迟,QPS支持达10万次/秒。
挑战与未来趋势
现有挑战
- 数据稀疏性:游戏行为数据稀疏度通常>99%,导致协同过滤准确率下降。
- 冷启动问题:新用户/新游戏缺乏历史数据,依赖内容过滤或规则引擎。
- 系统复杂性:多组件(Hadoop/Spark/Hive)集成增加运维难度,需自动化监控工具。
- 算法可解释性:深度学习模型的黑盒特性降低用户信任度,需结合LIME、SHAP等技术提供特征重要性排序。
未来趋势
- 边缘计算与云原生架构:迁移至Kubernetes上的Spark Operator,实现弹性资源调度。例如,采用Kubernetes容器化部署Spark集群,结合边缘节点实时处理玩家操作数据,使推荐延迟降低至50ms。
- 联邦学习与隐私保护:在跨平台数据隐私保护下联合训练模型,解决单一平台数据孤岛问题。
- 多模态数据融合:利用CLIP模型实现游戏截图与文本描述的联合嵌入,优化视觉驱动型推荐。
- 强化学习与动态策略:引入DQN算法动态调整推荐策略,实现用户长期价值最大化。
结论
Hadoop+Spark技术栈通过分布式存储、内存计算与数据仓库的协同,显著提升了游戏推荐系统的性能与扩展性。混合推荐模型、多模态特征融合与实时流处理技术的创新,有效解决了传统系统的冷启动、实时性和长尾问题。未来,随着可解释AI、边缘计算与云原生架构的深化应用,游戏推荐系统将向智能化、实时化与普惠化方向演进,为玩家提供“千人千面”的个性化体验,同时助力游戏产业实现精准营销与长尾价值挖掘。
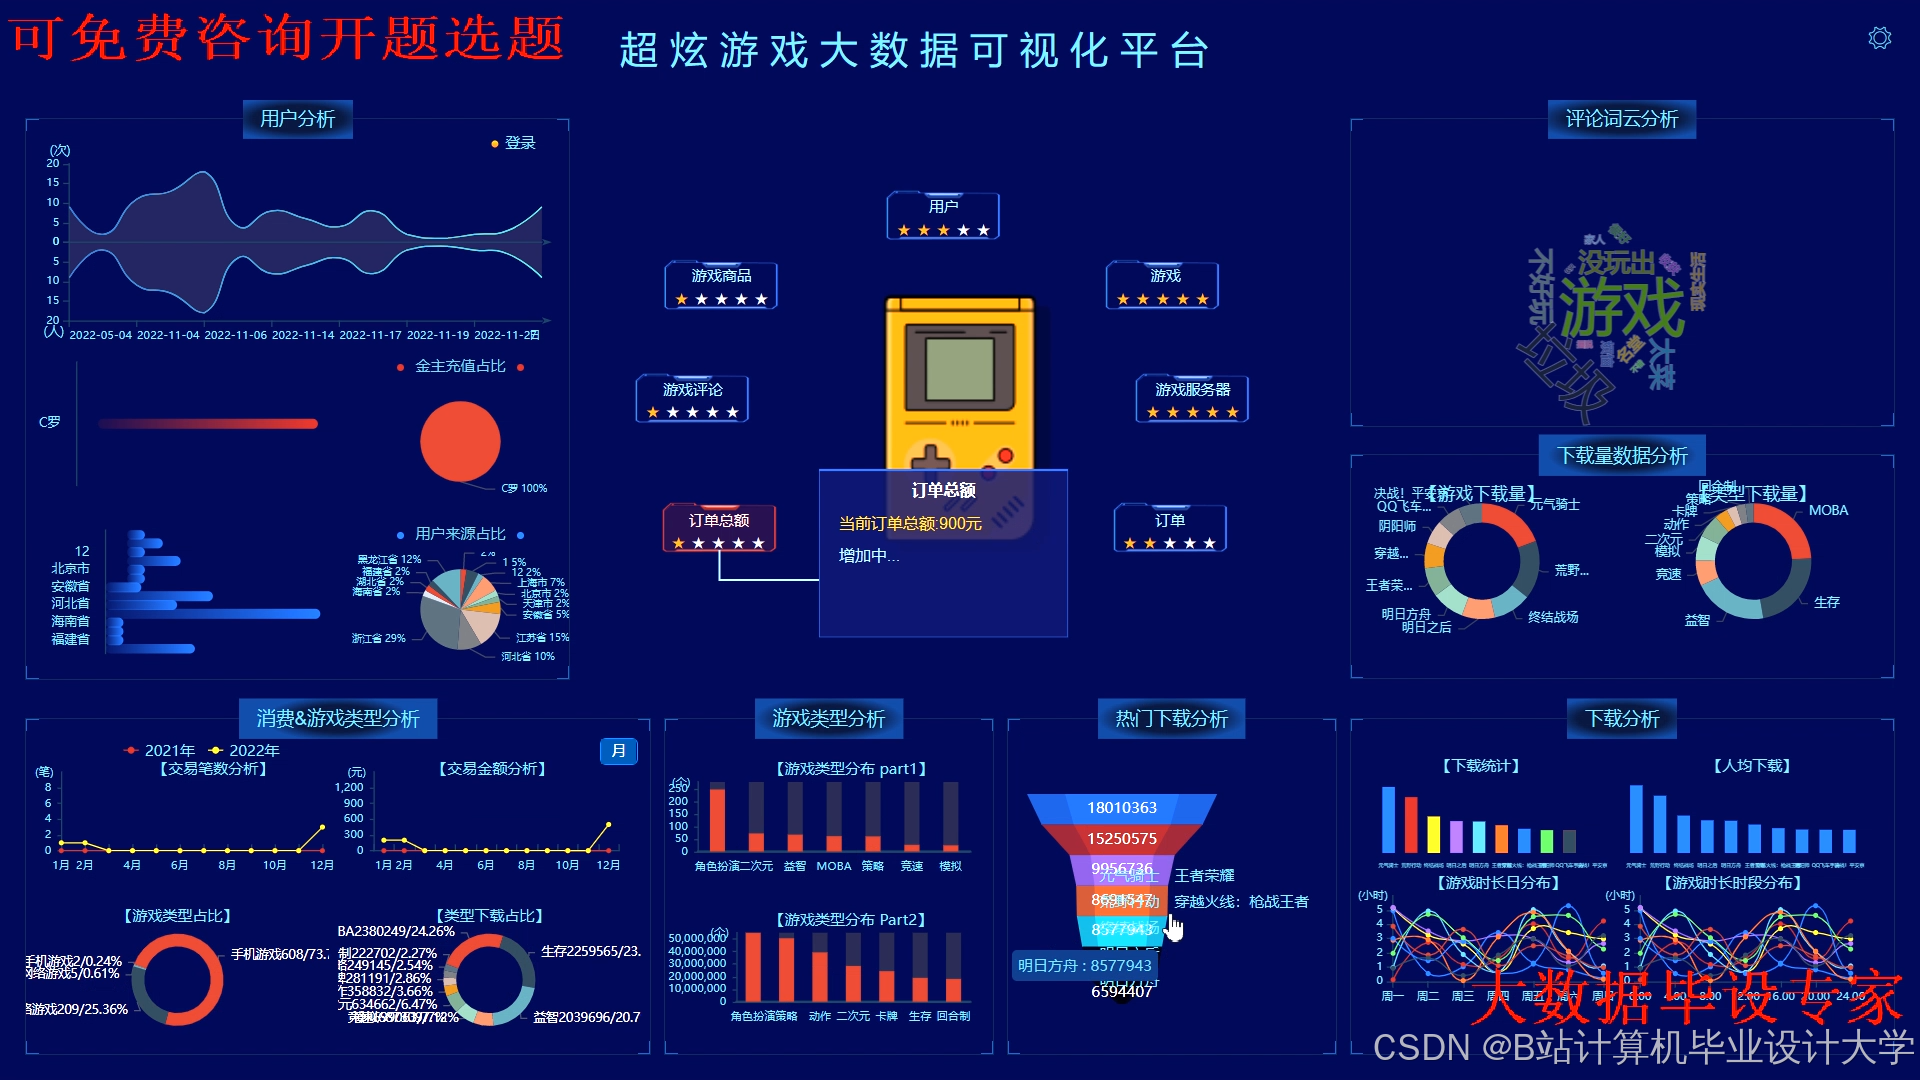
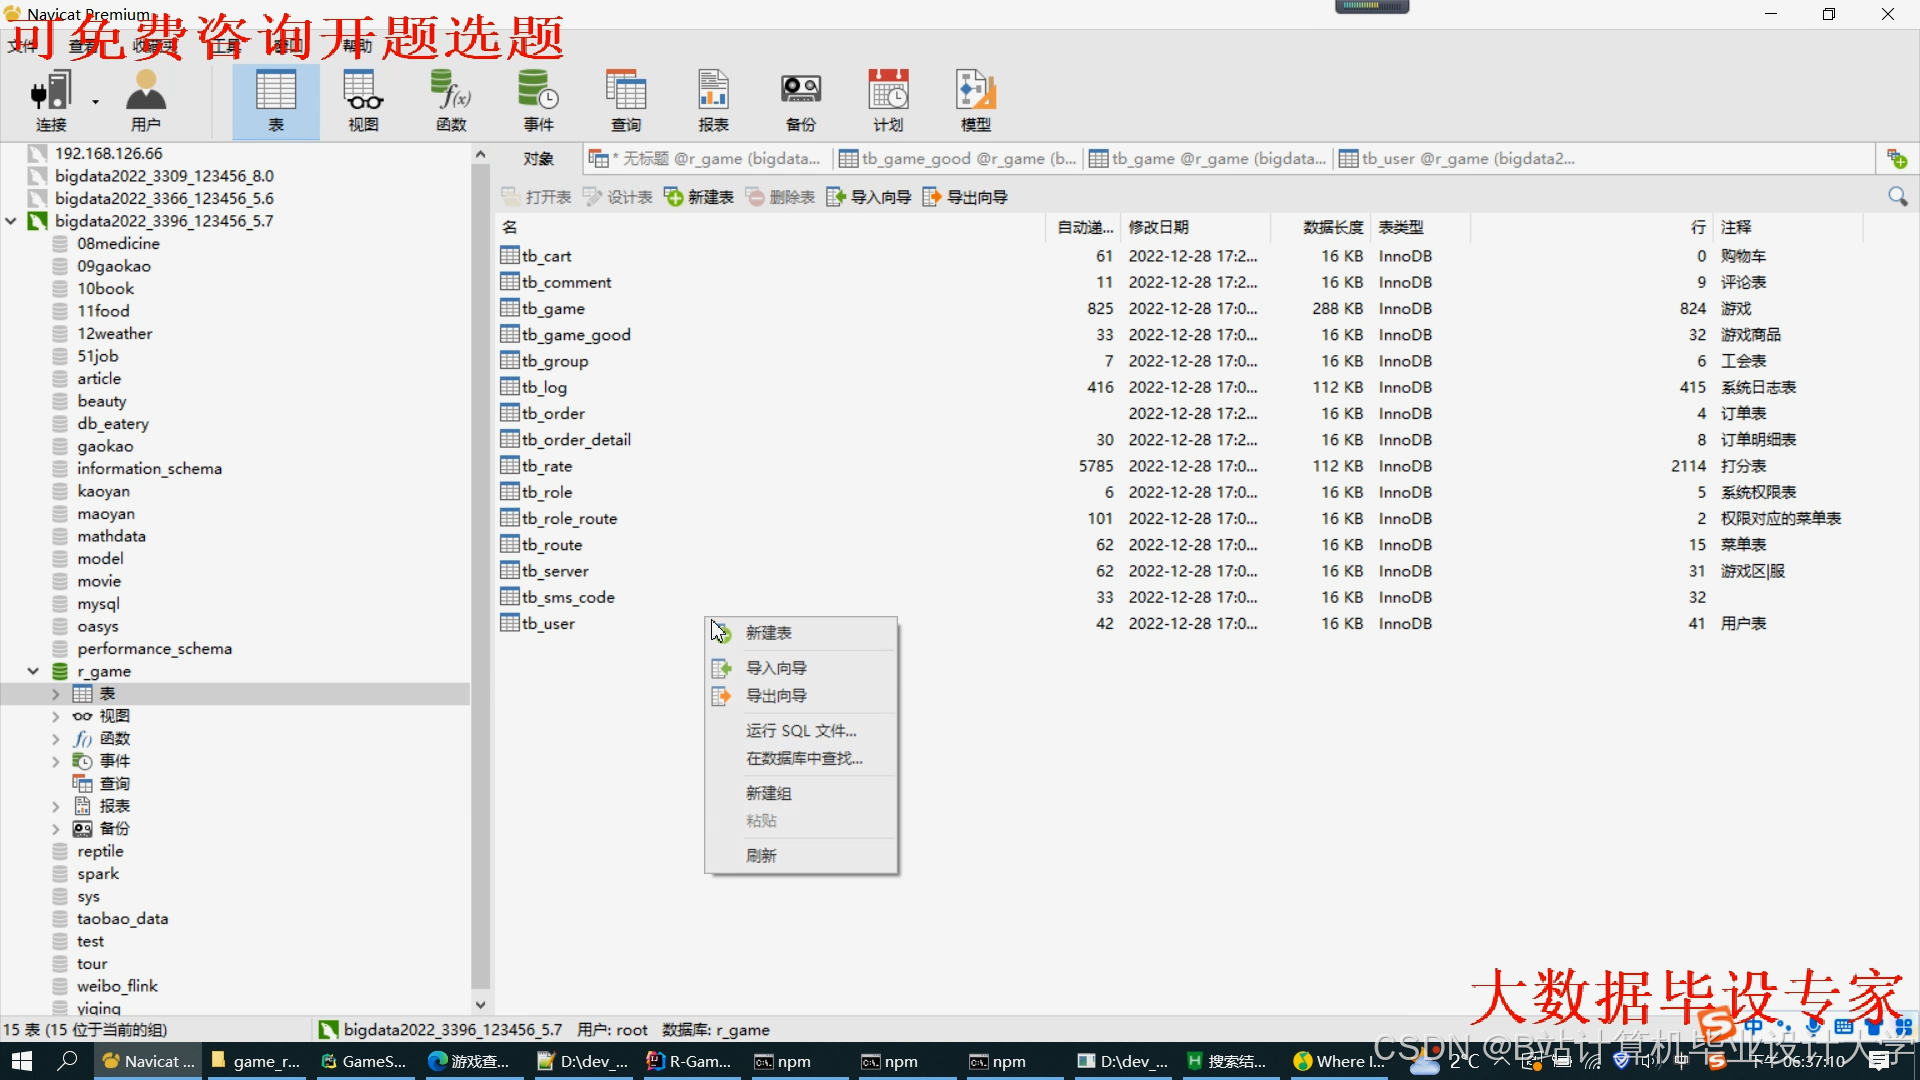
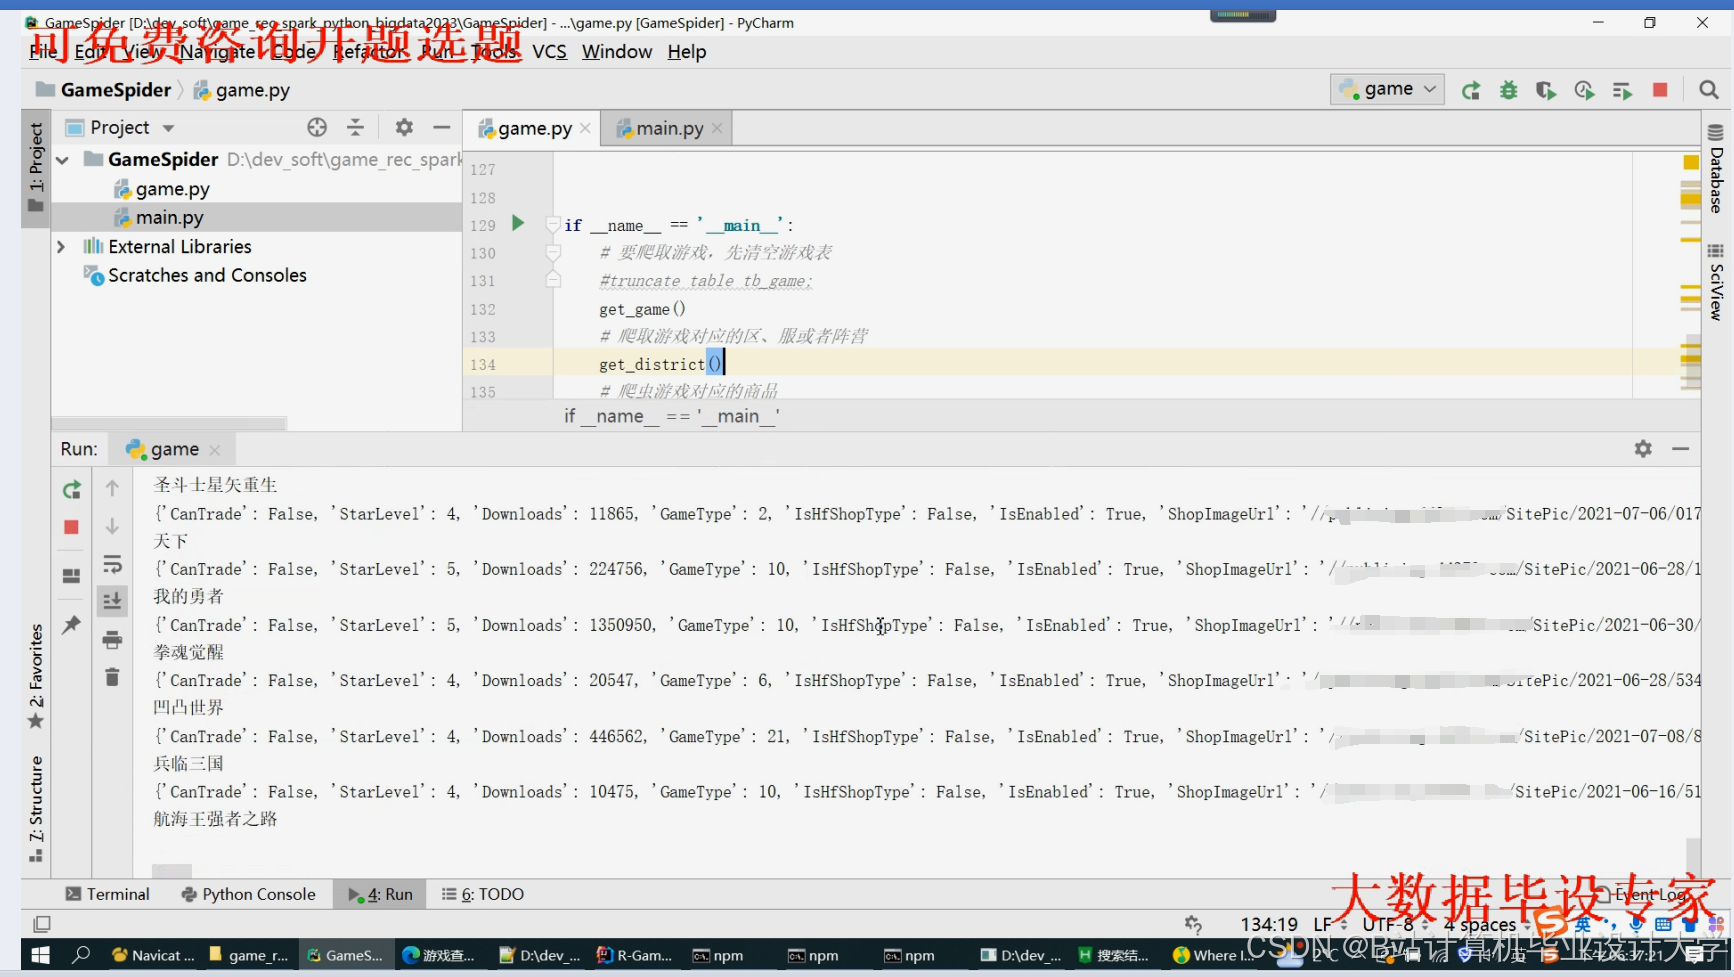
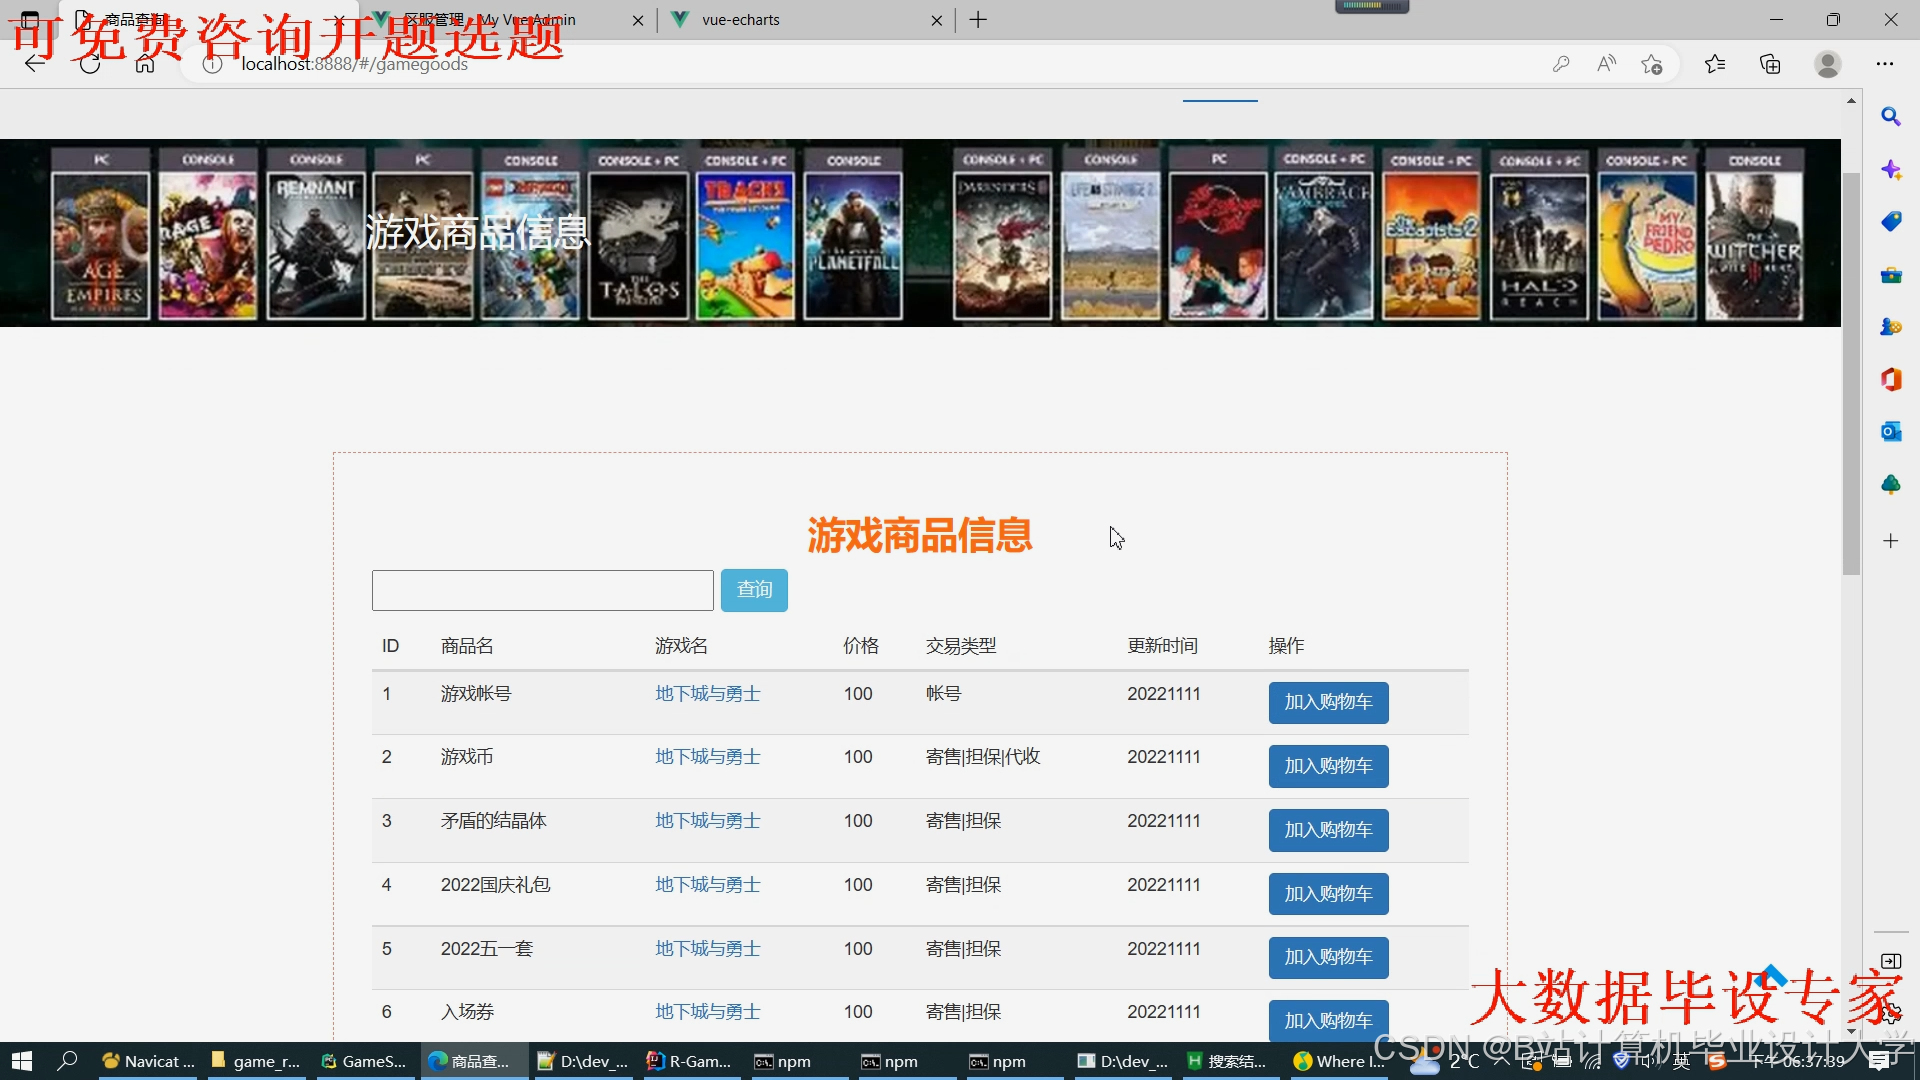
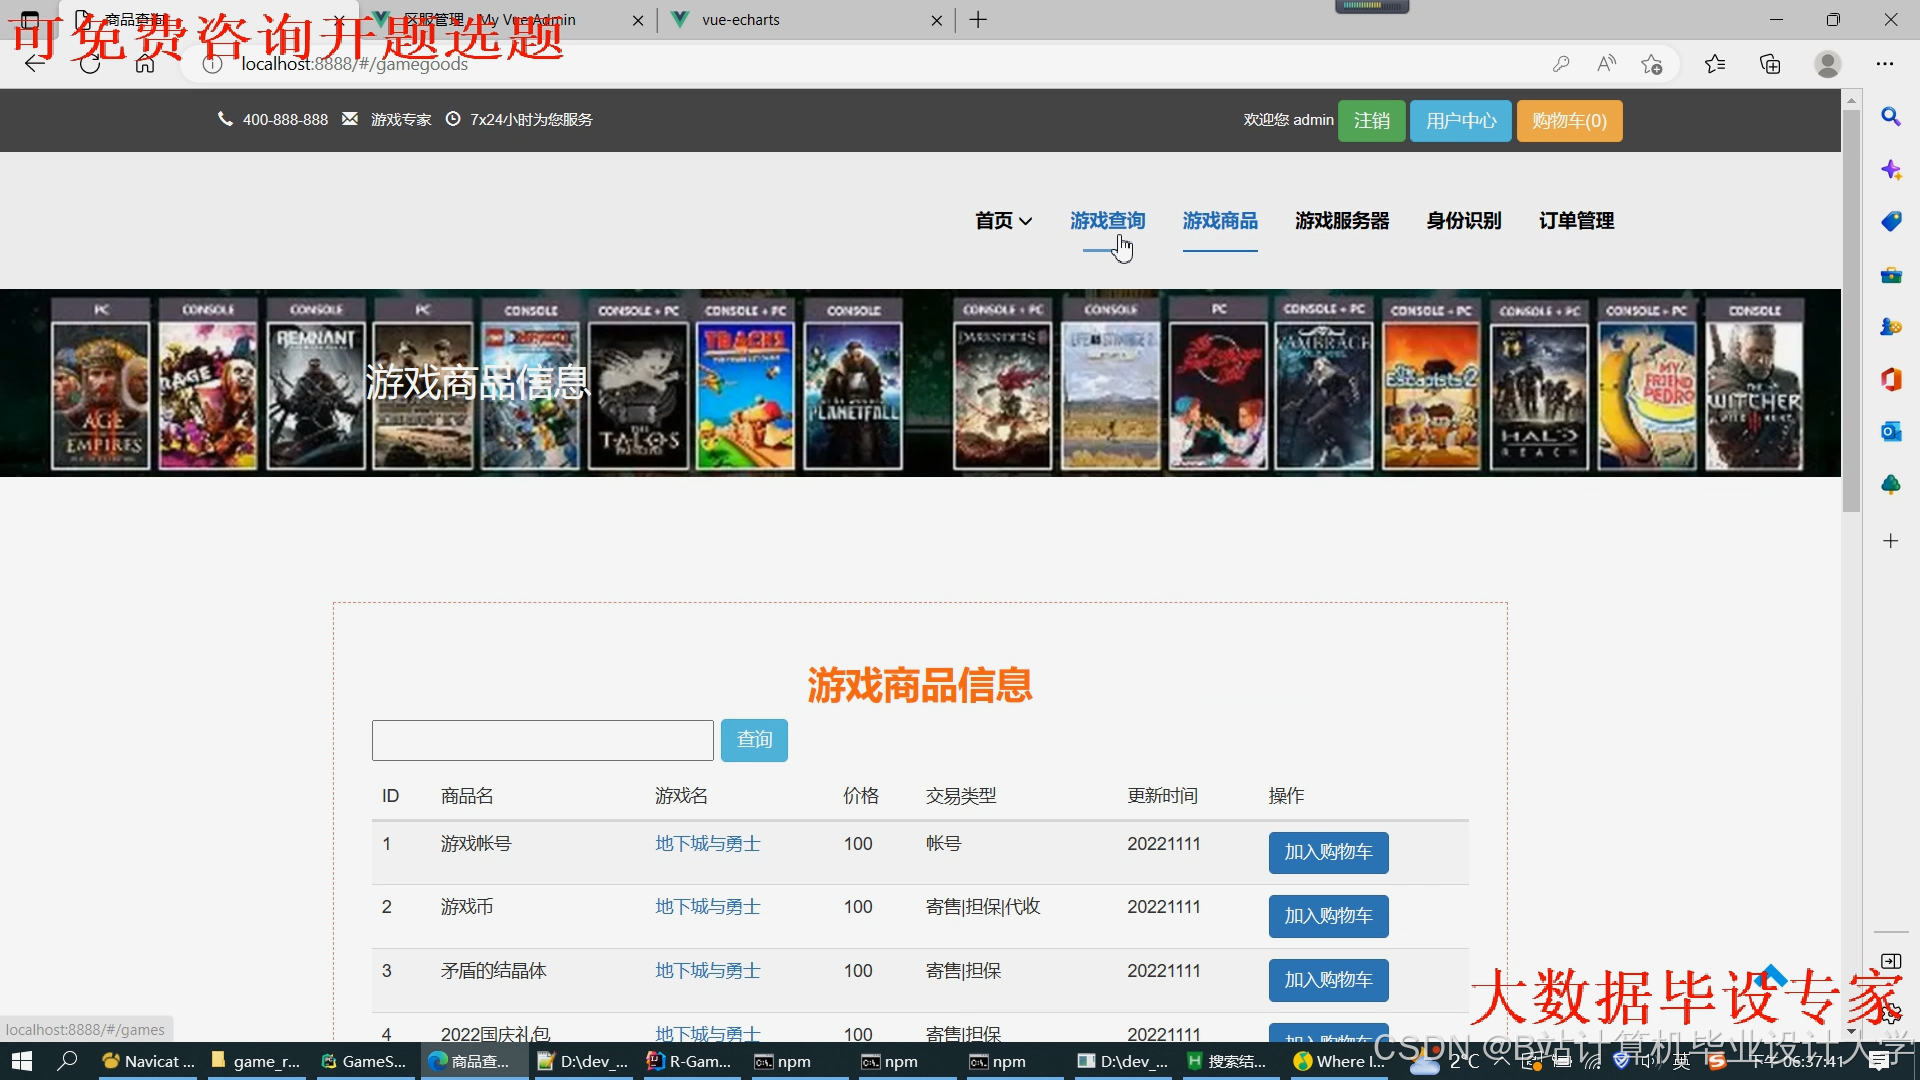
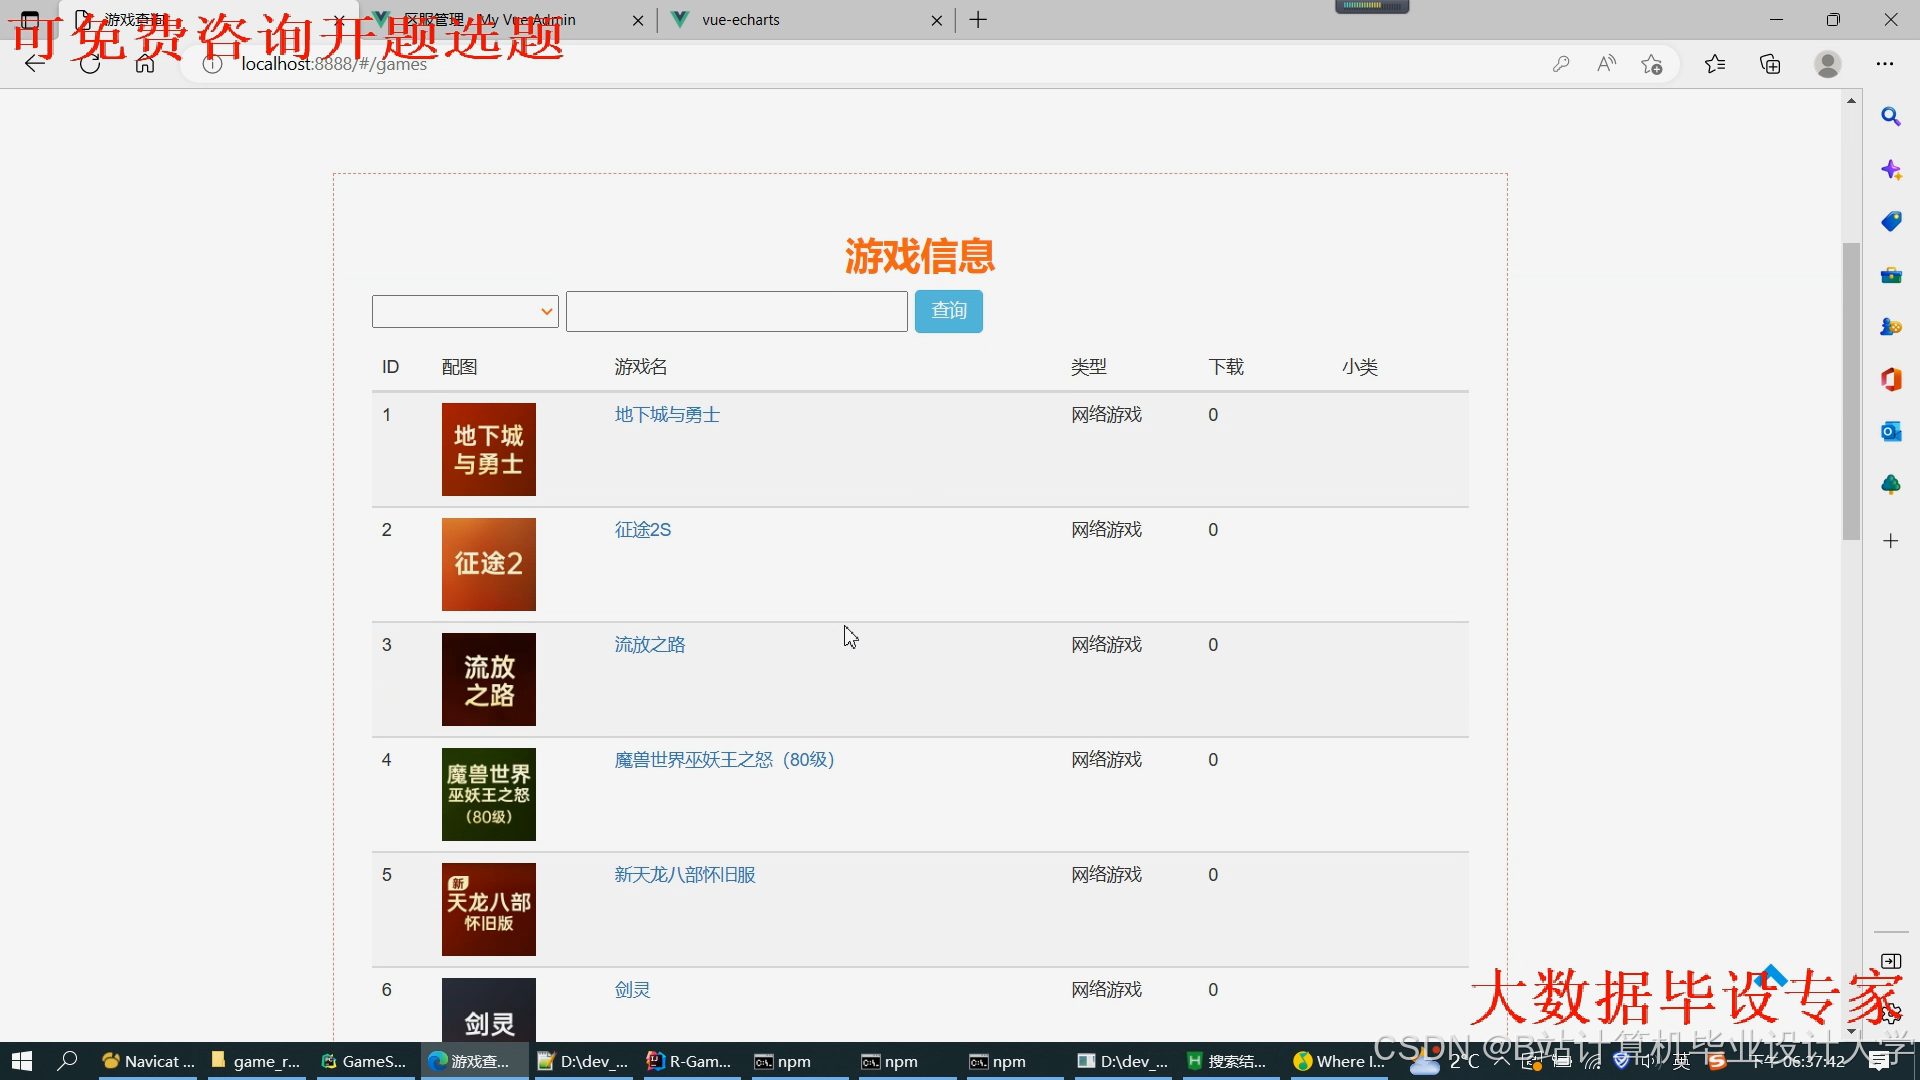
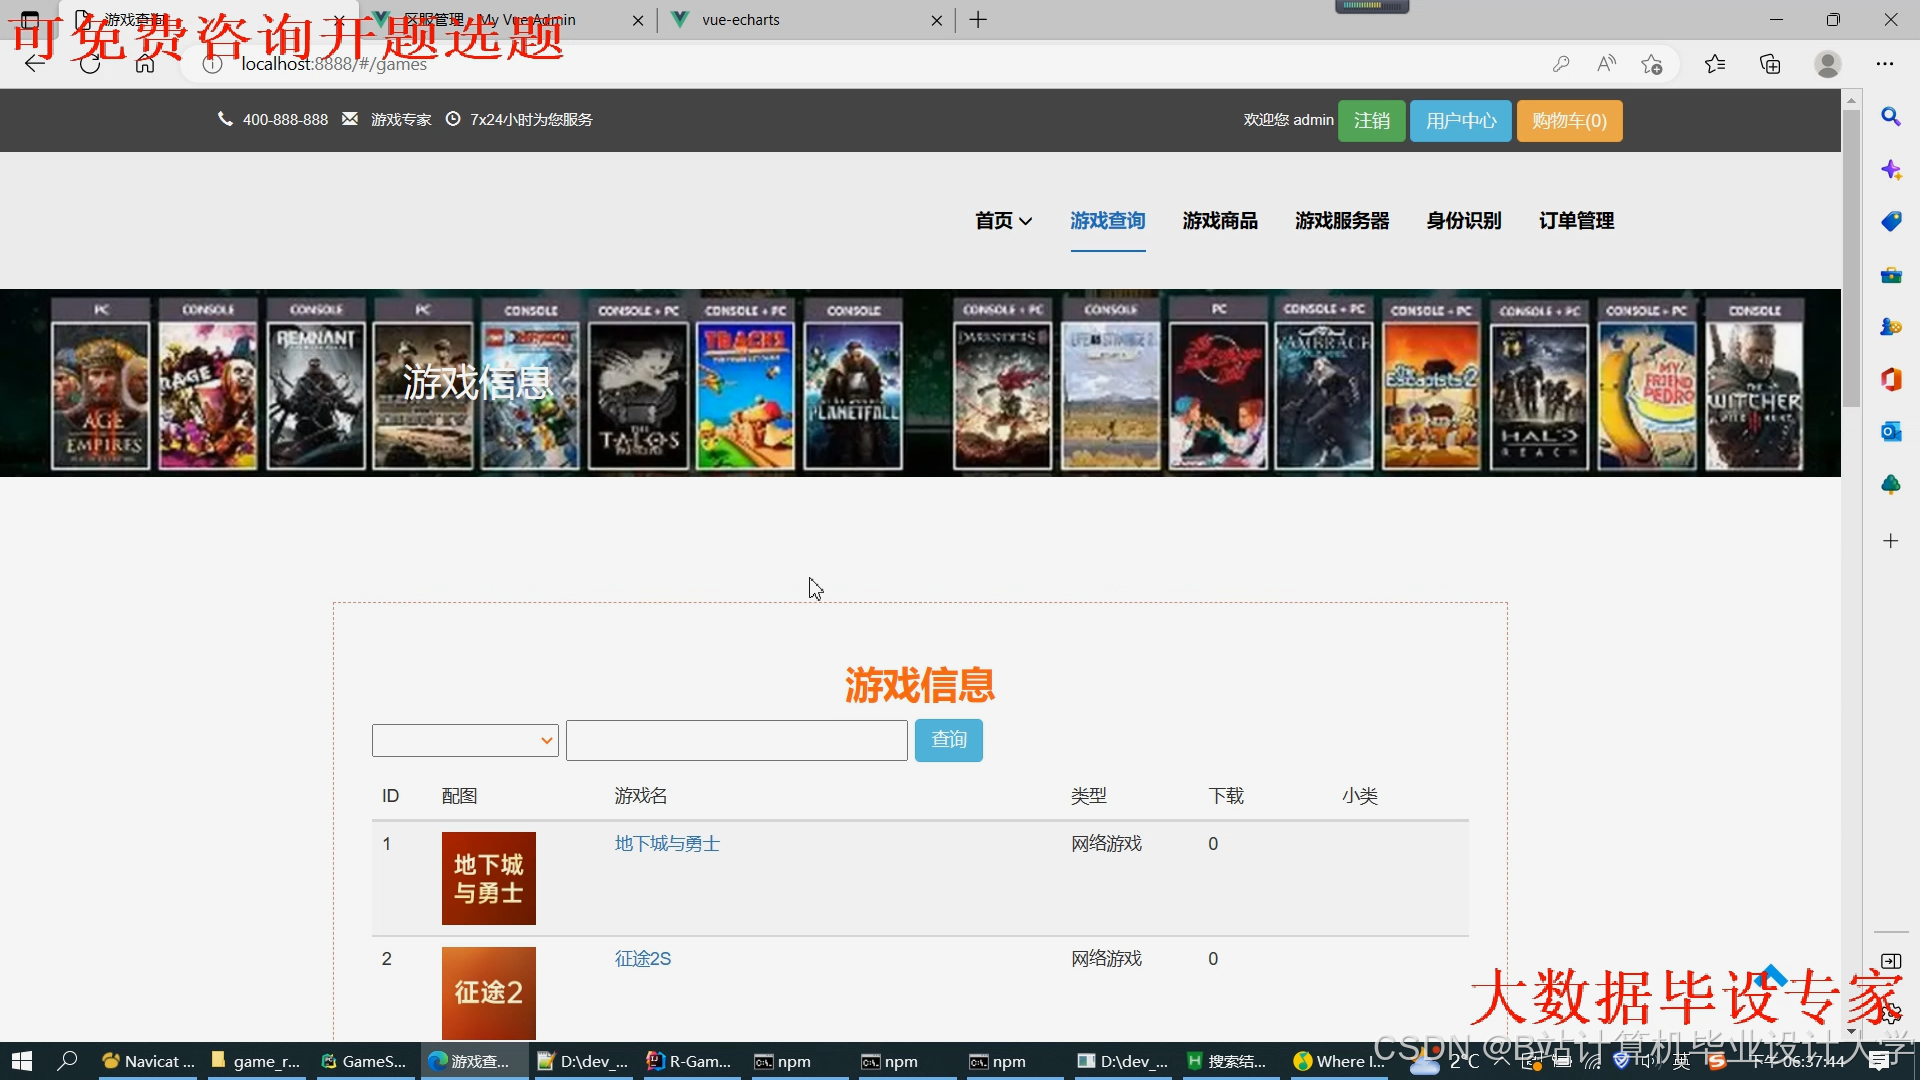
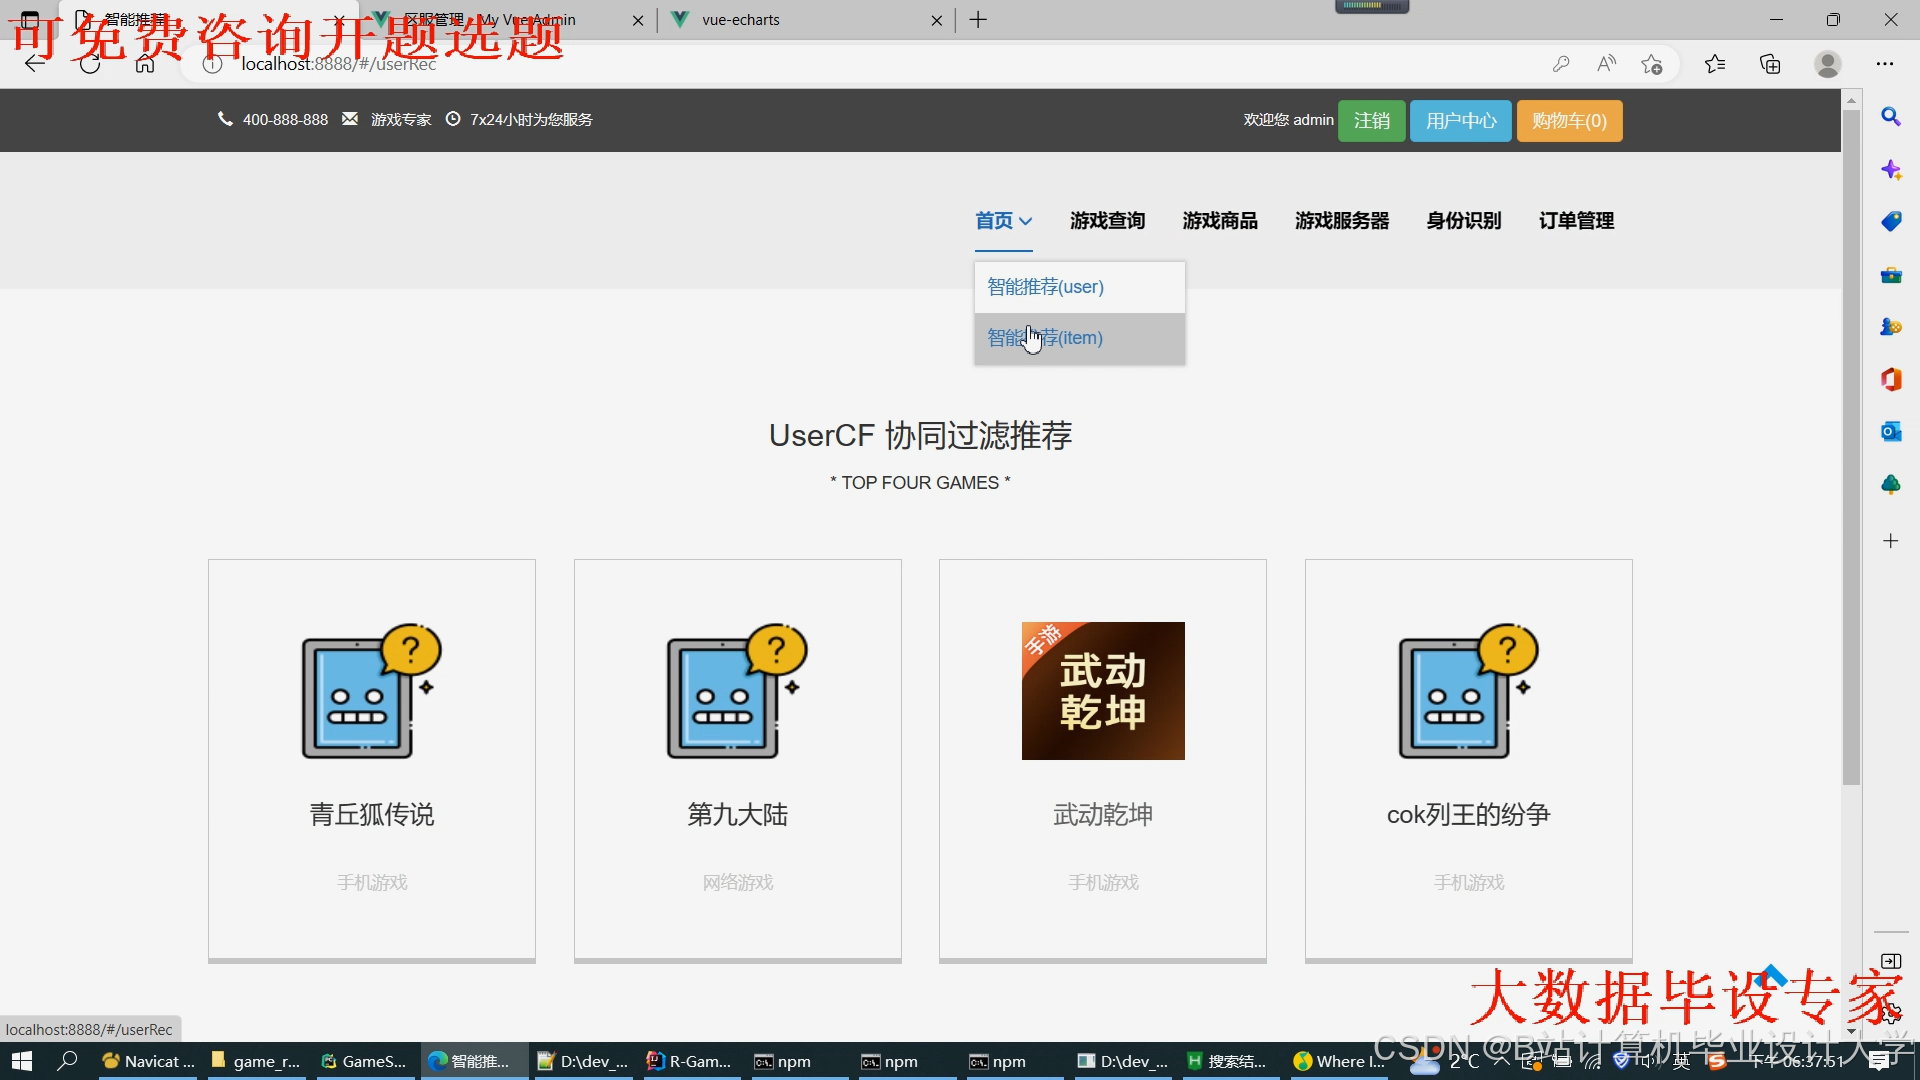
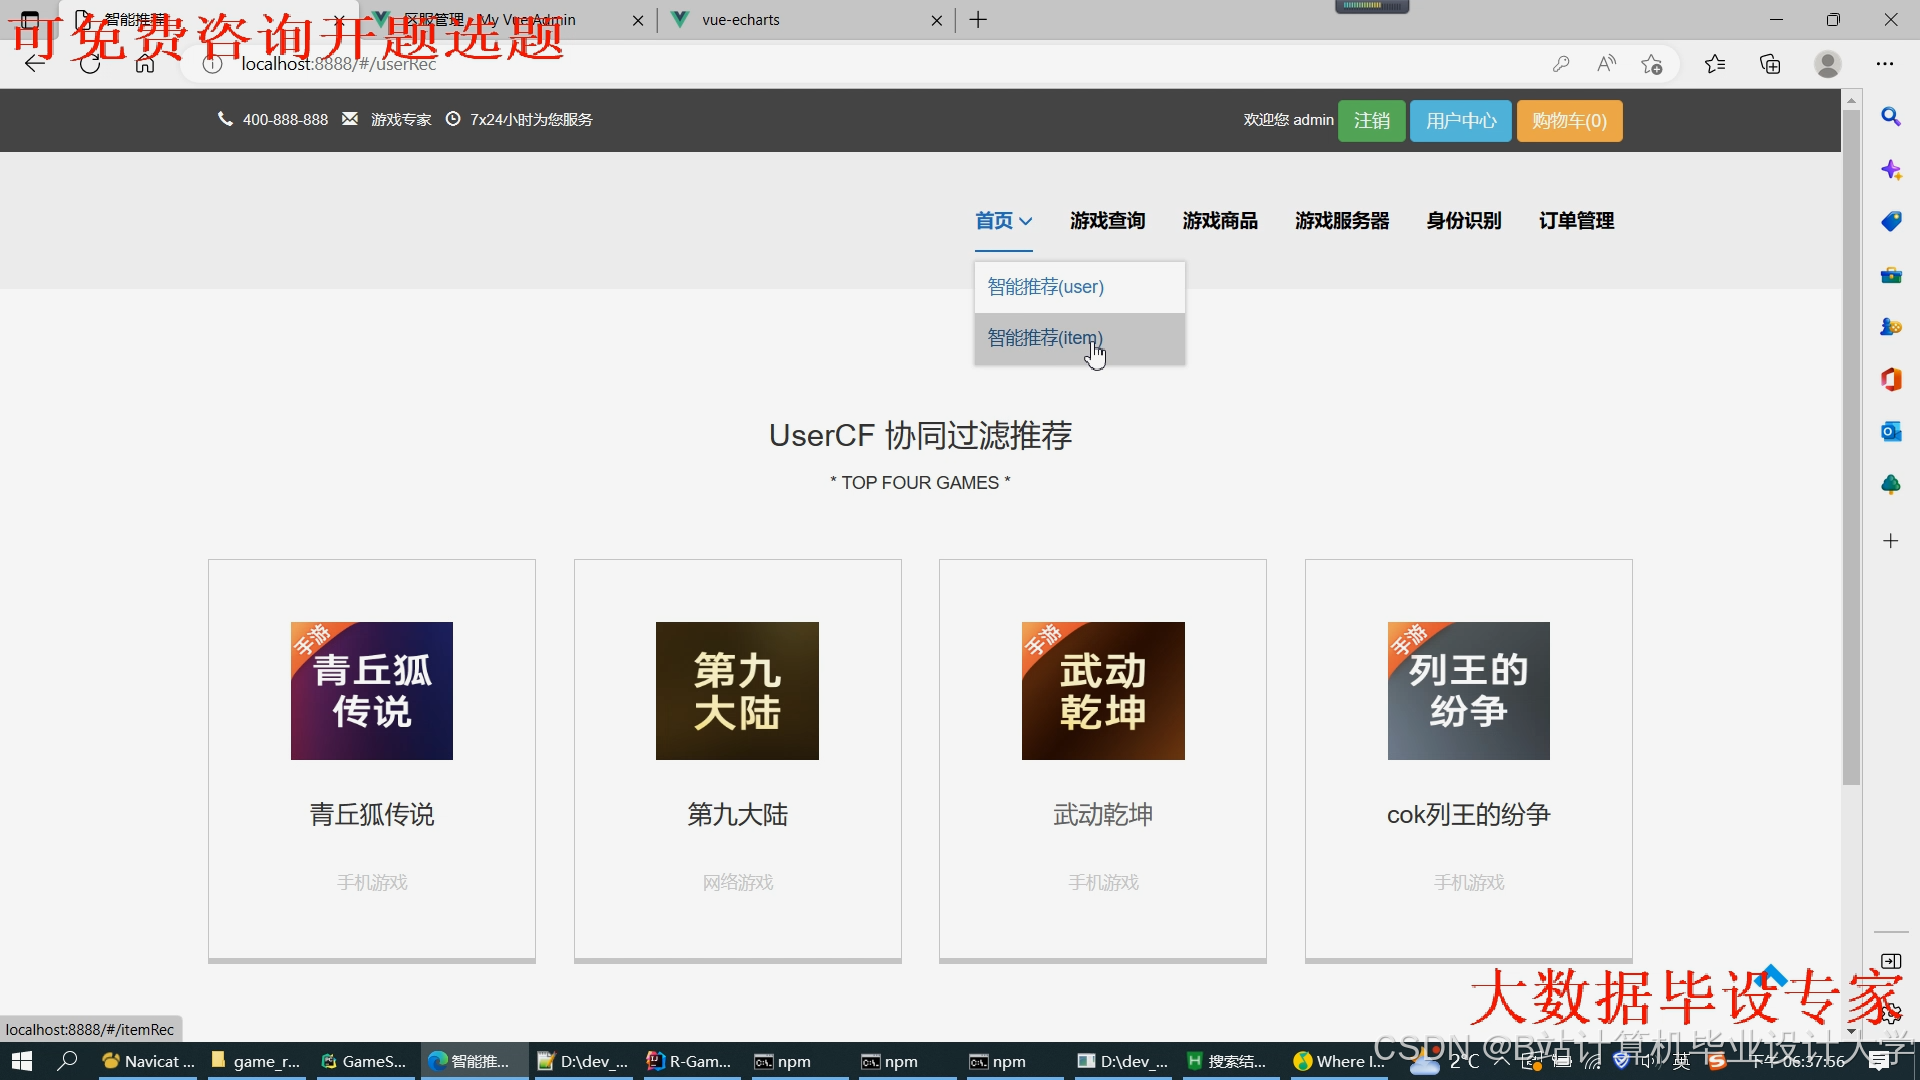
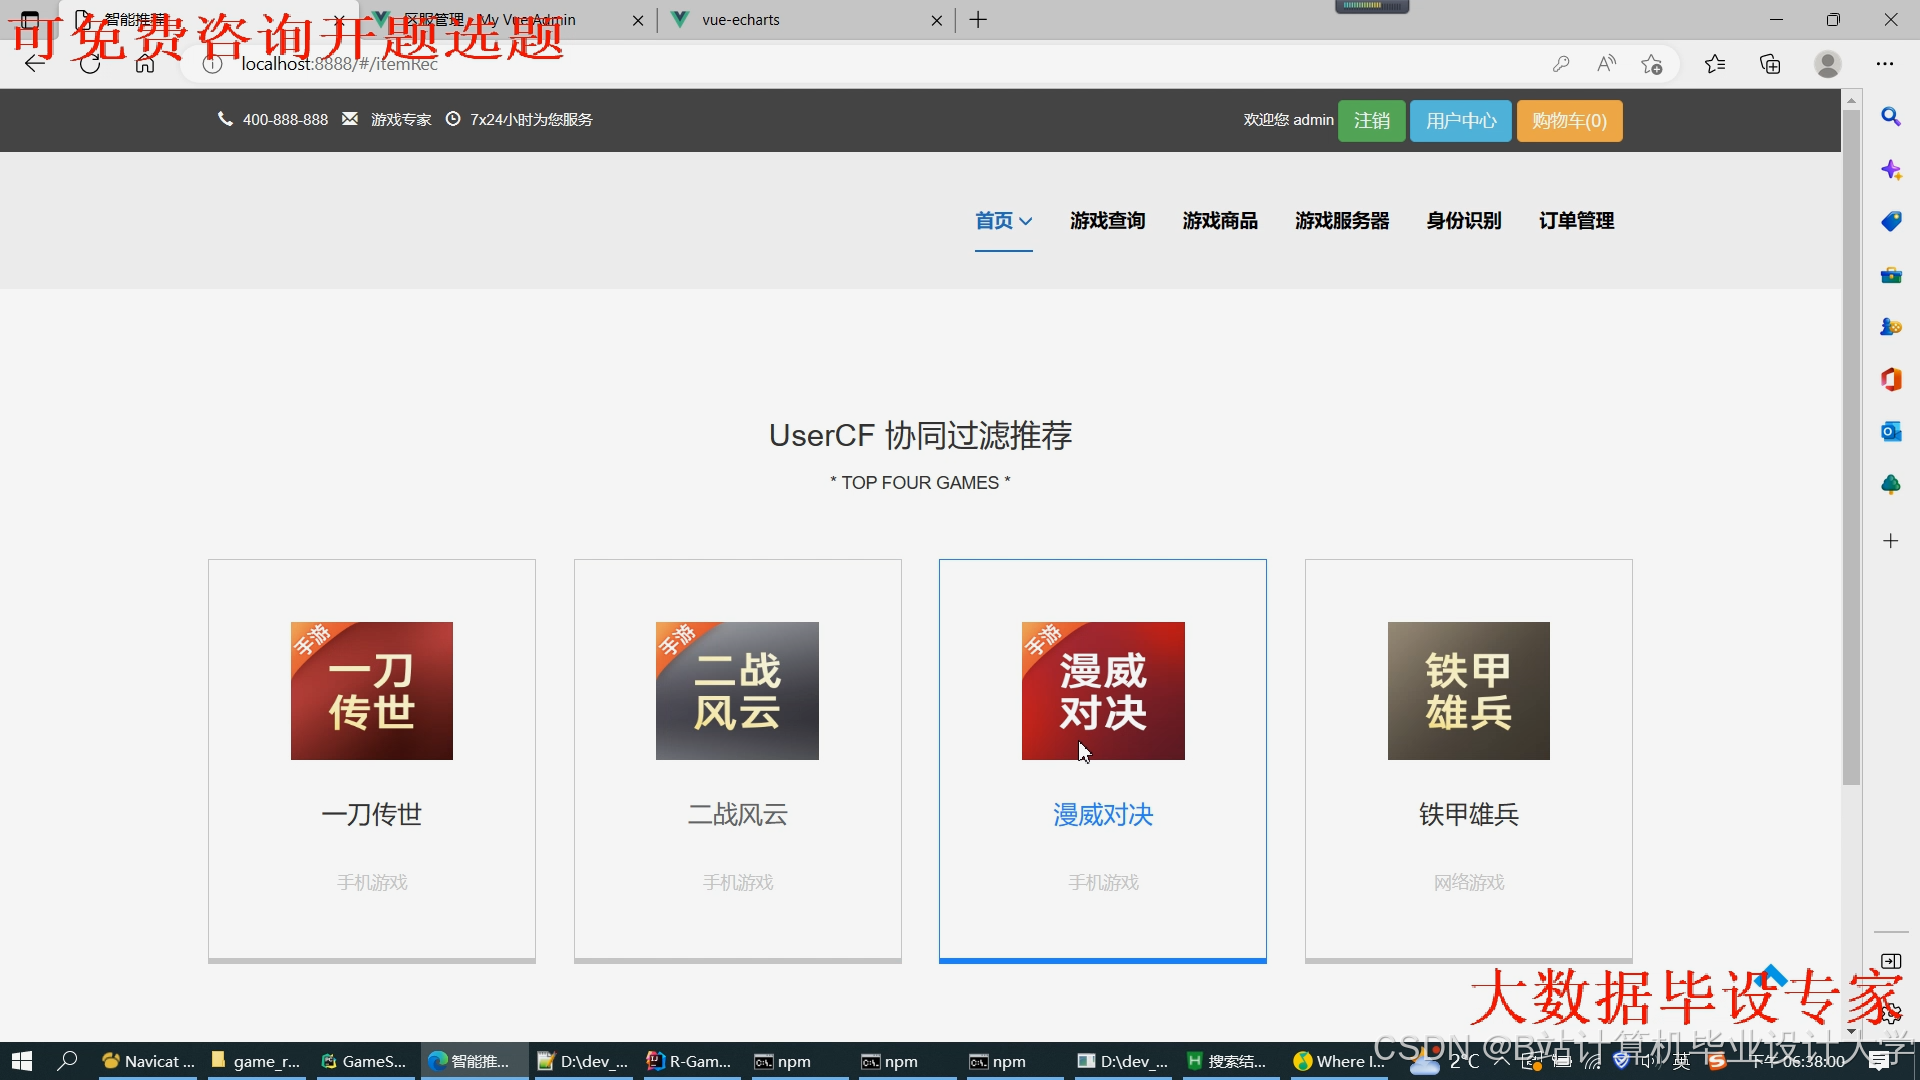
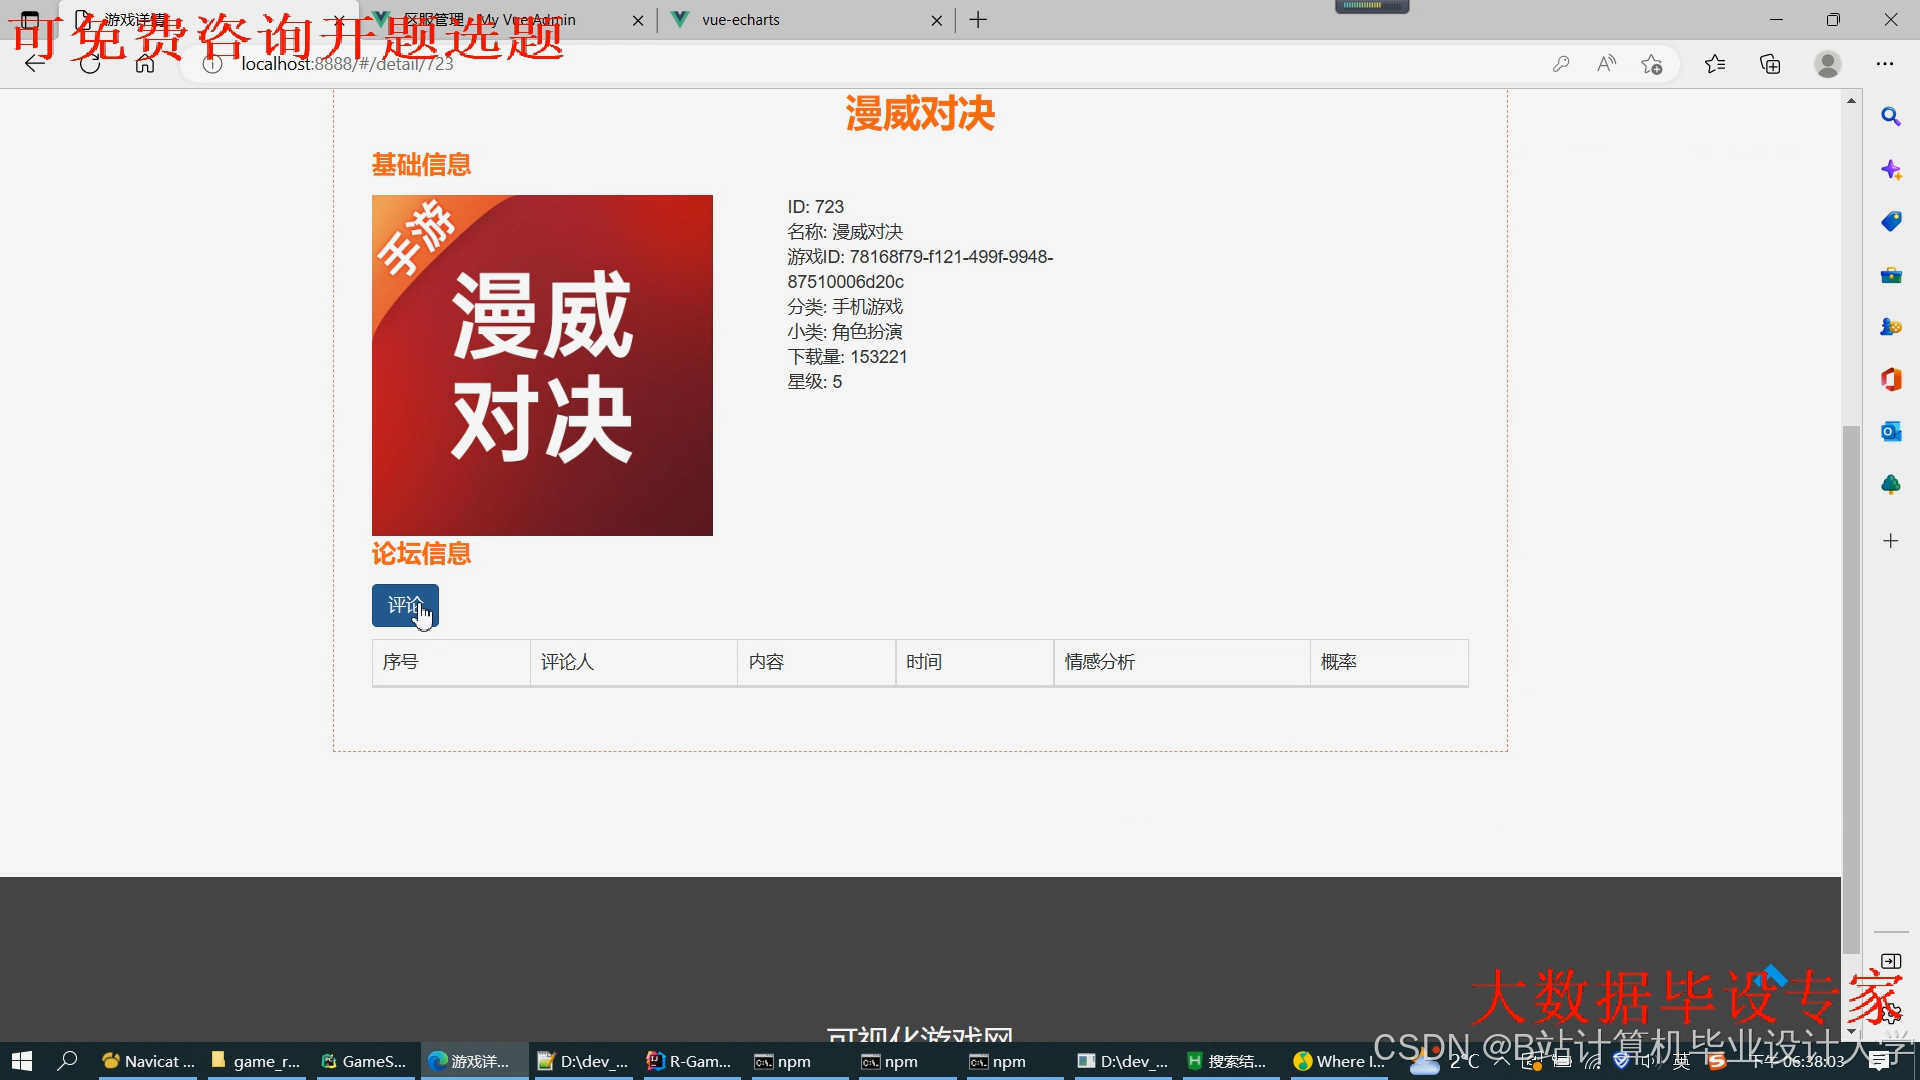
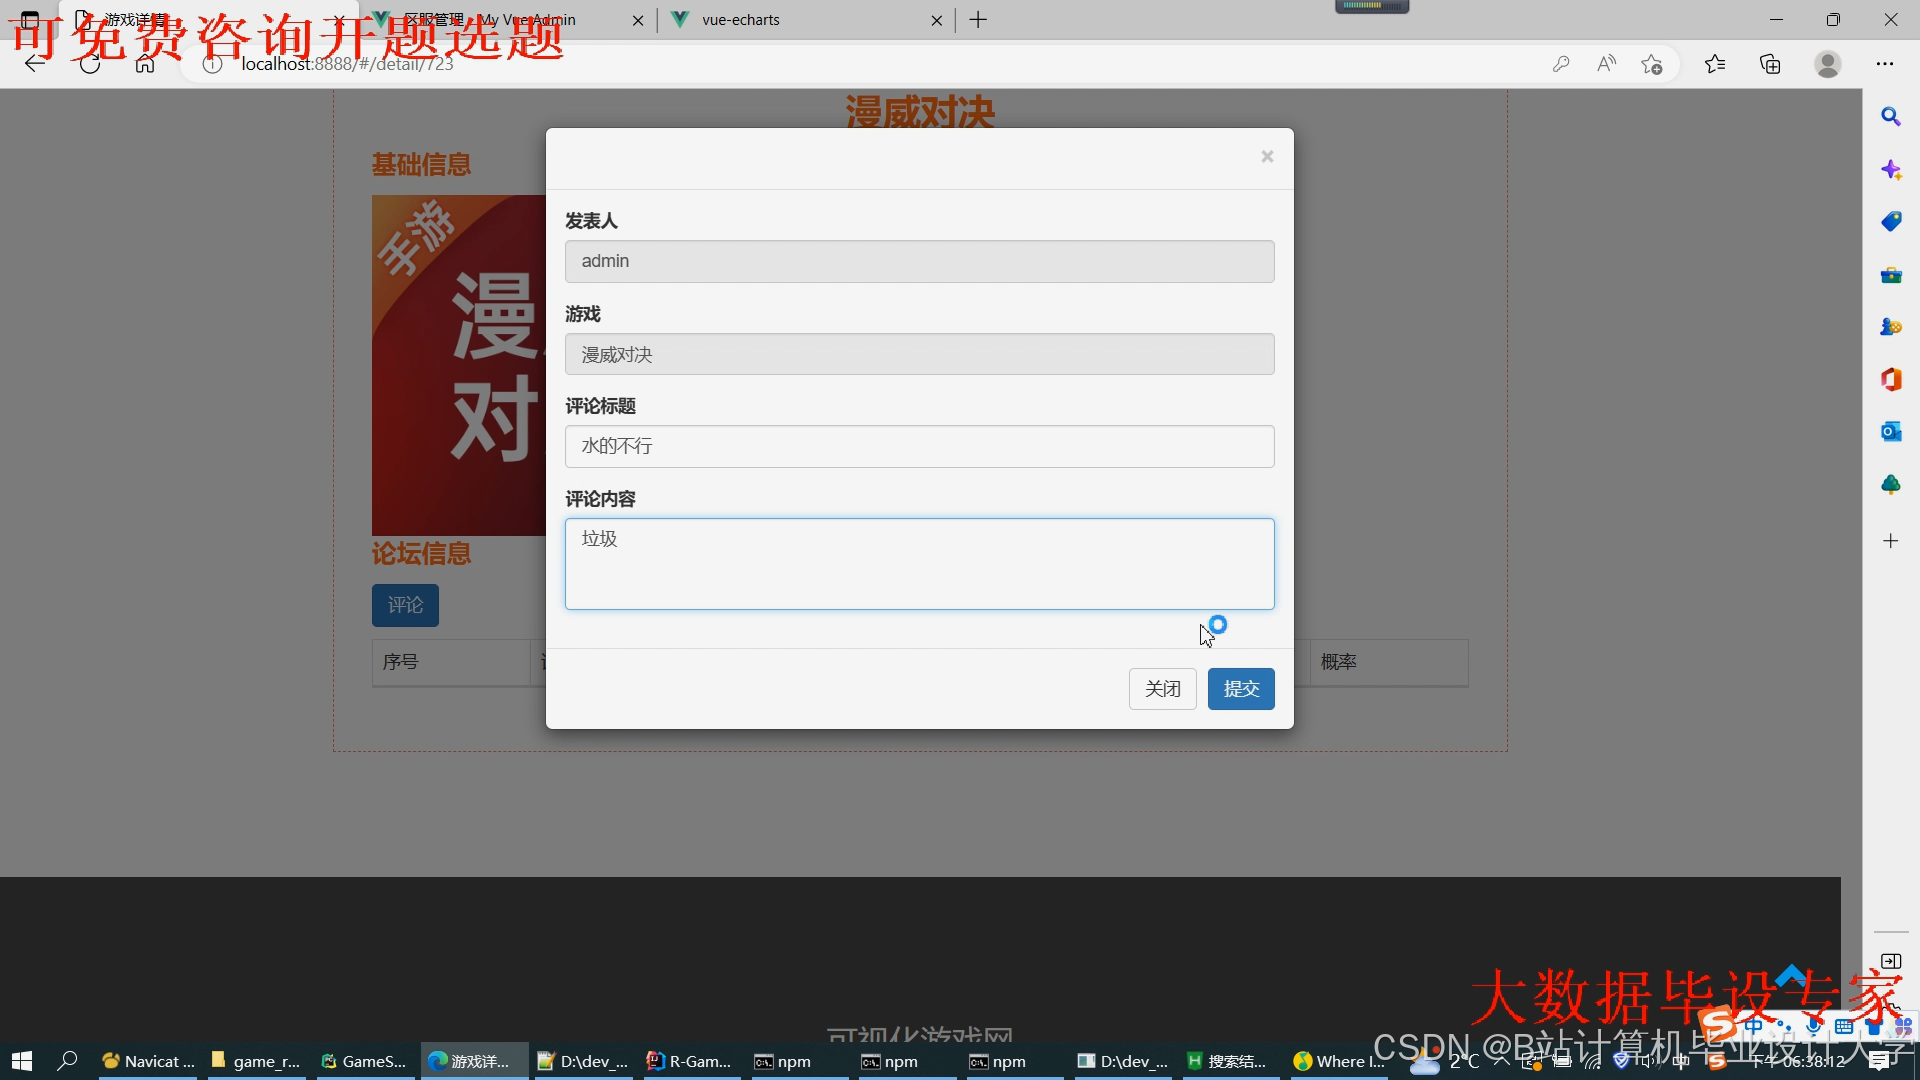
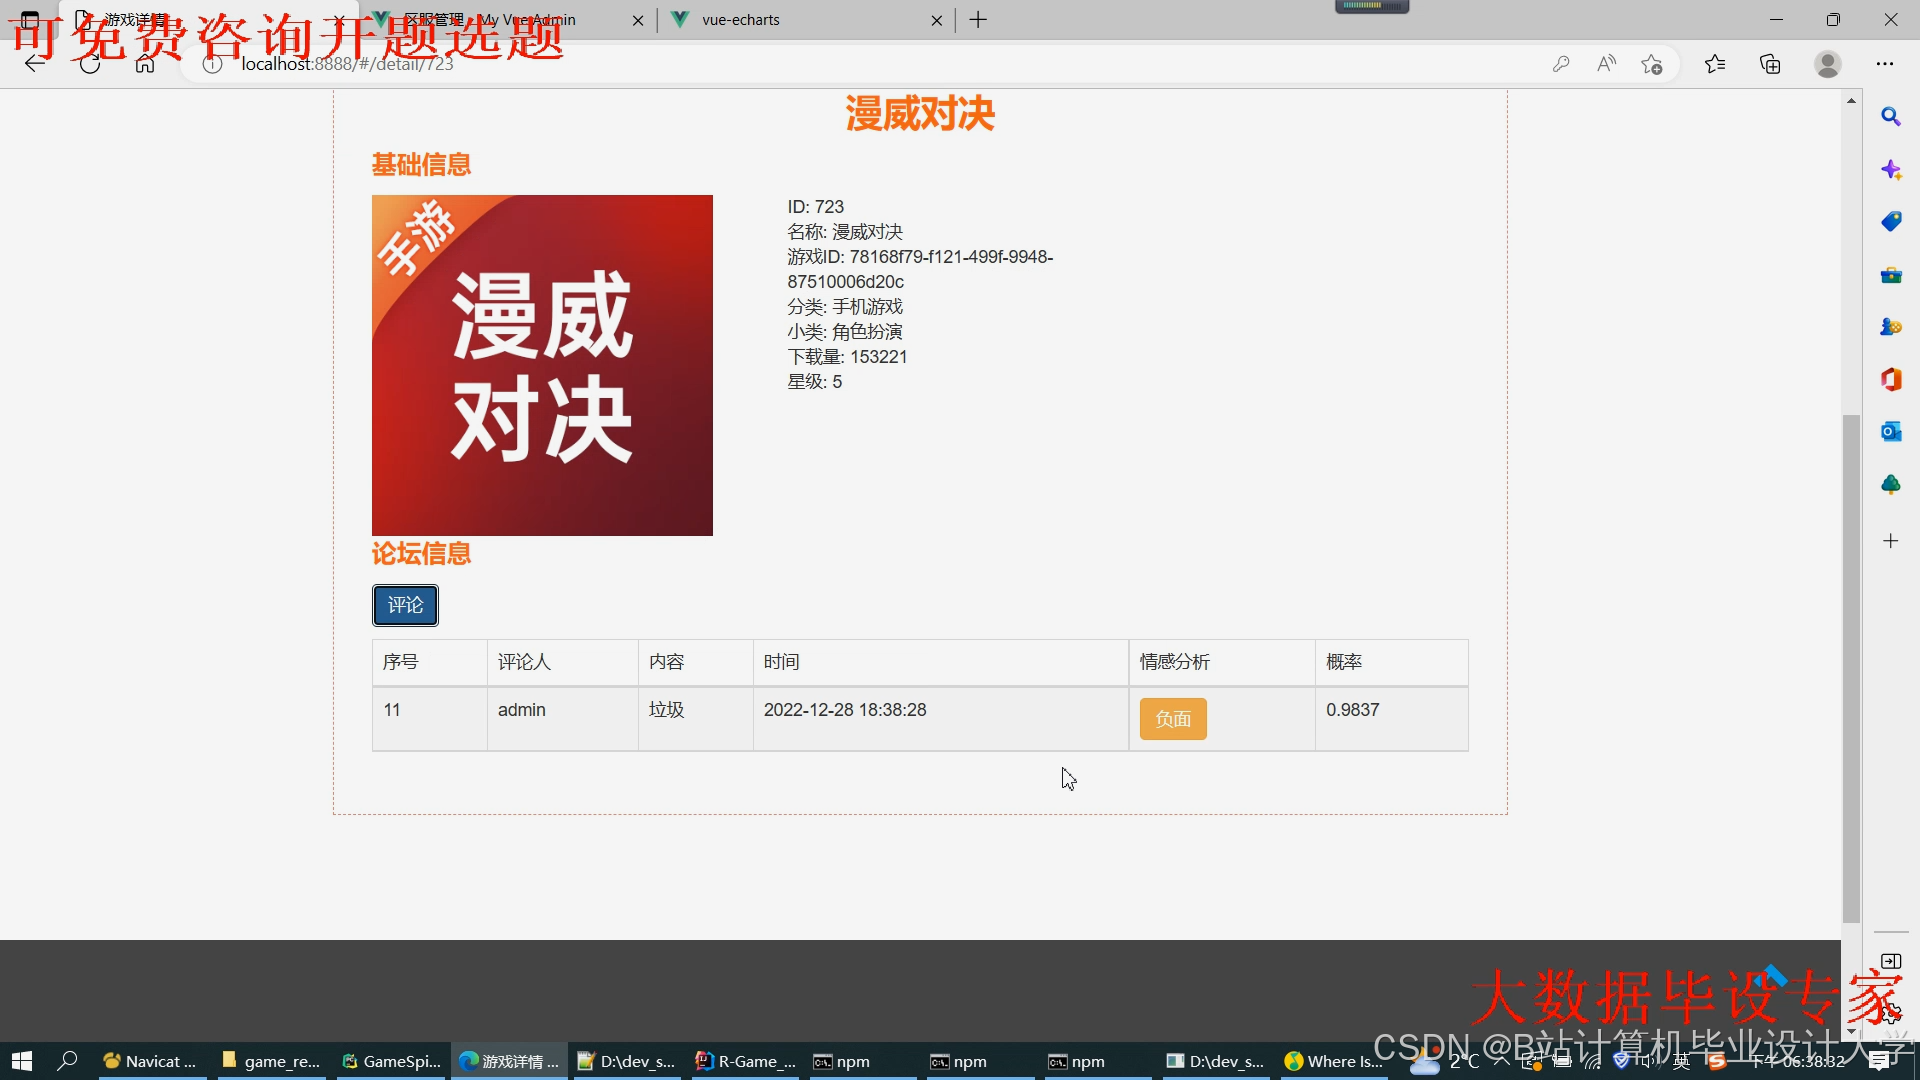
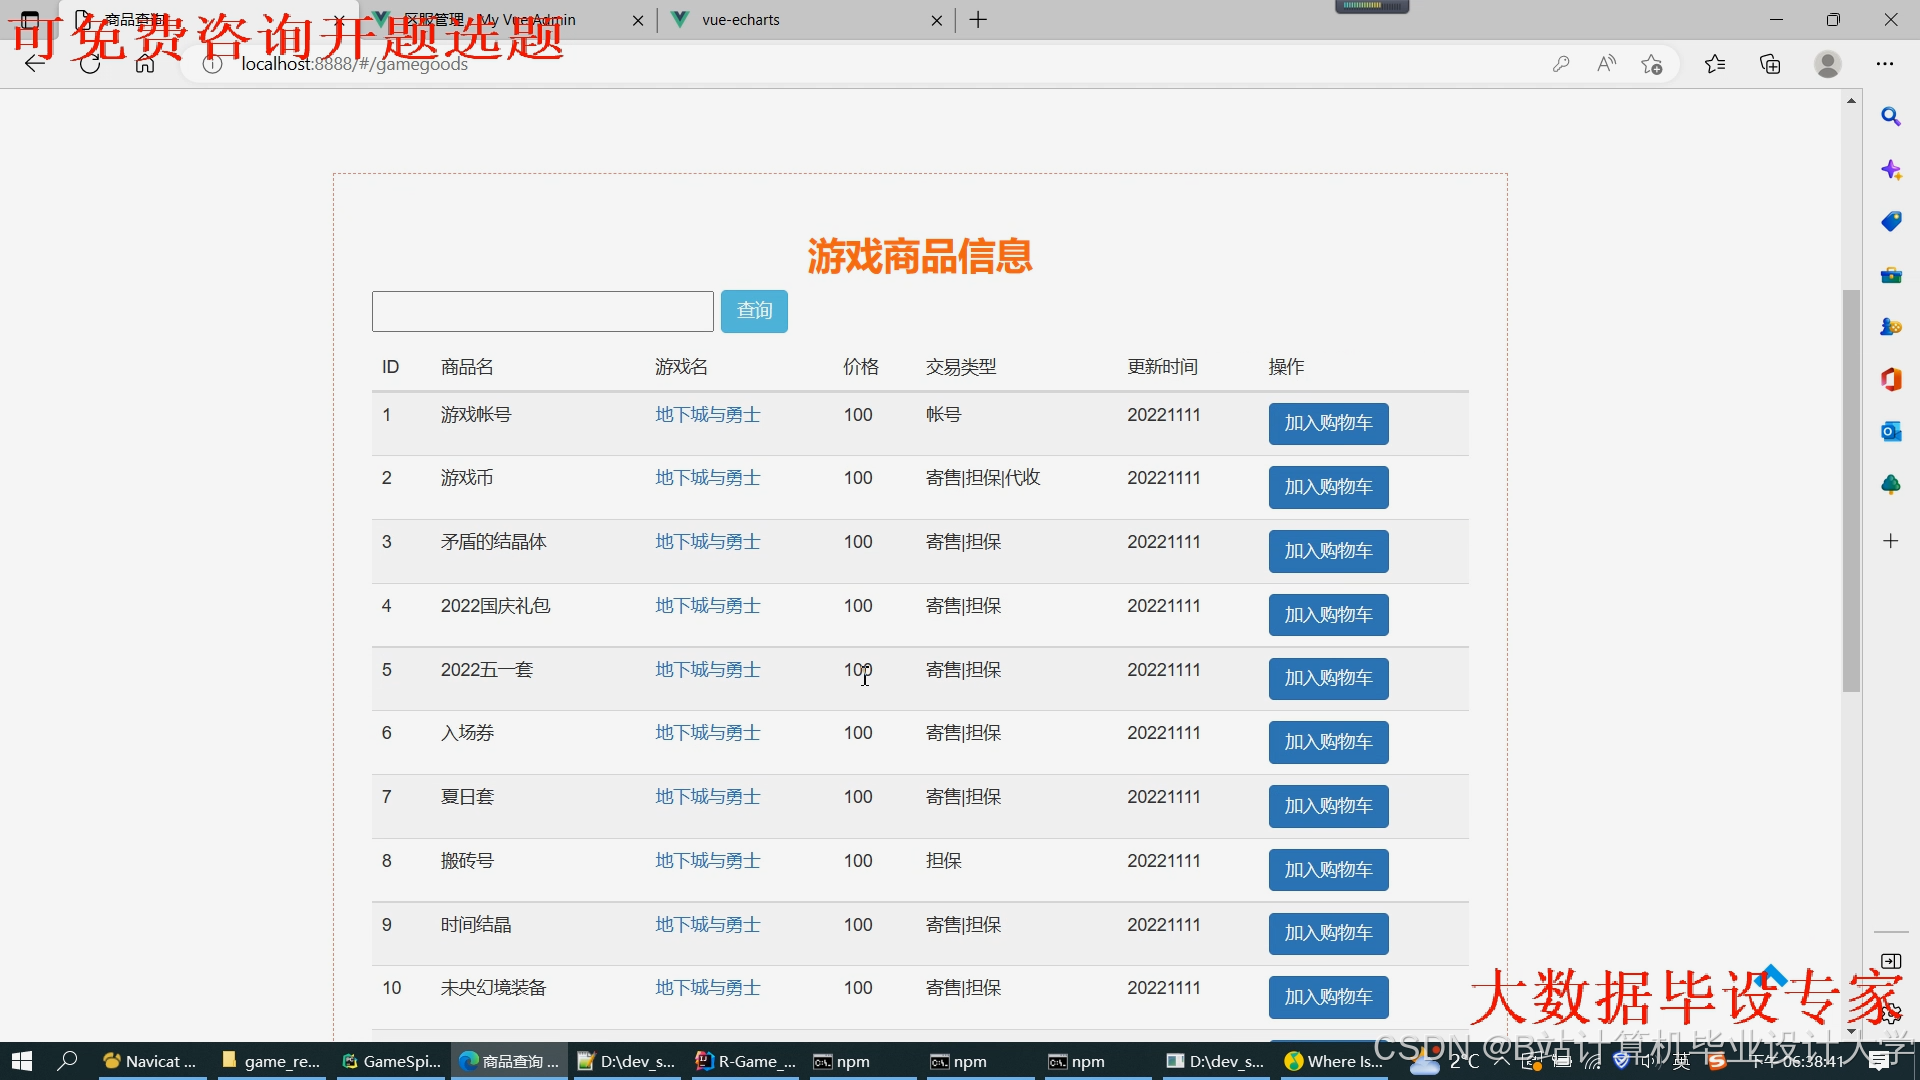
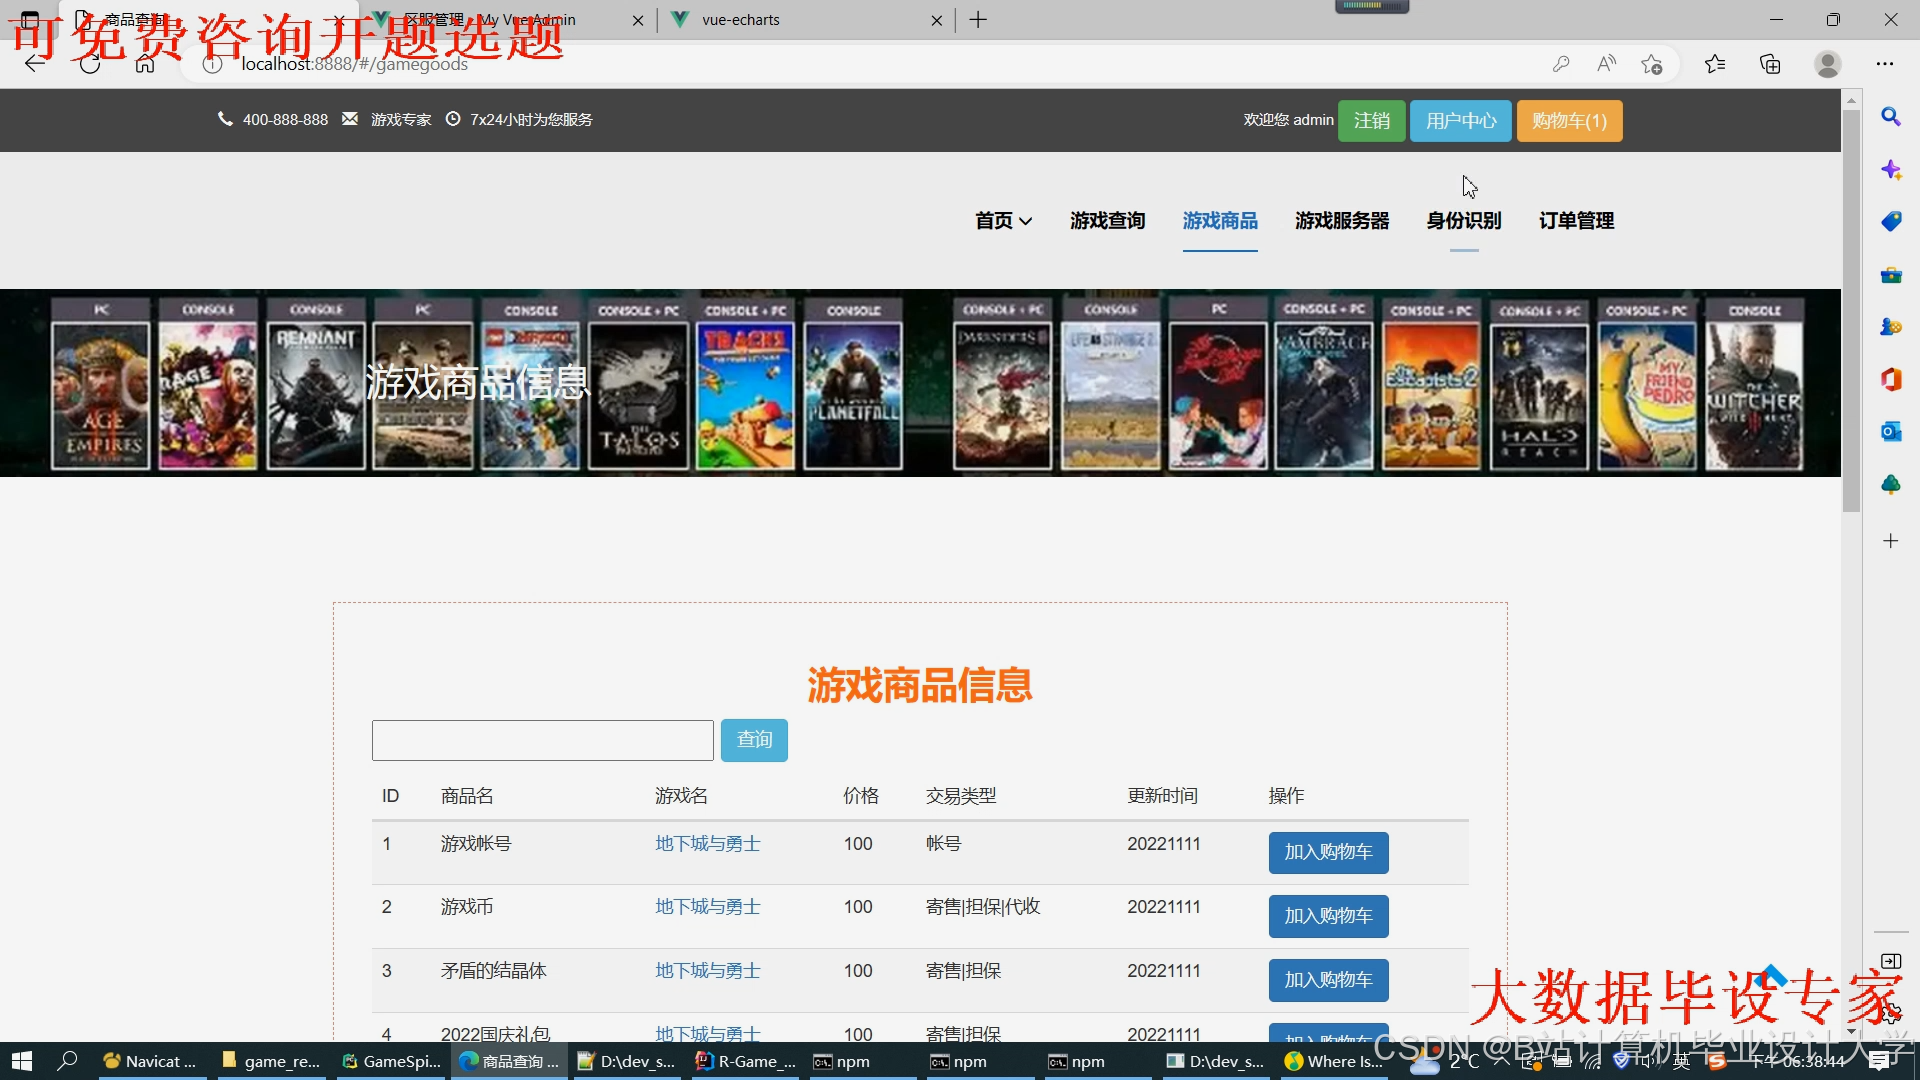
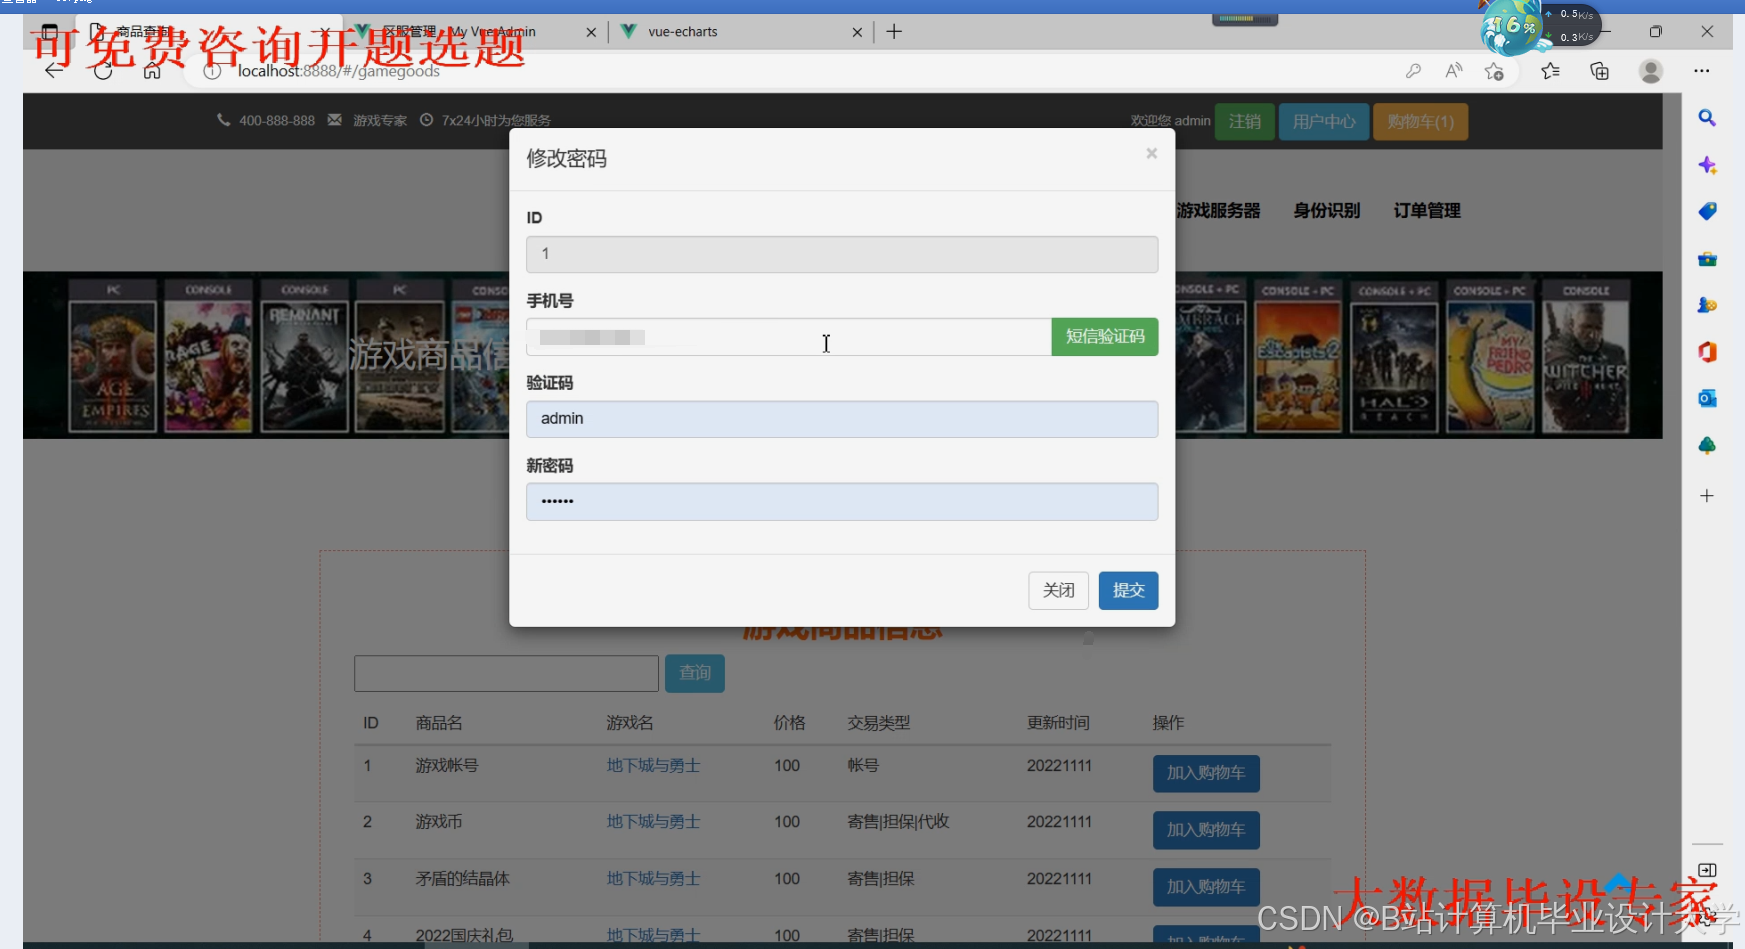
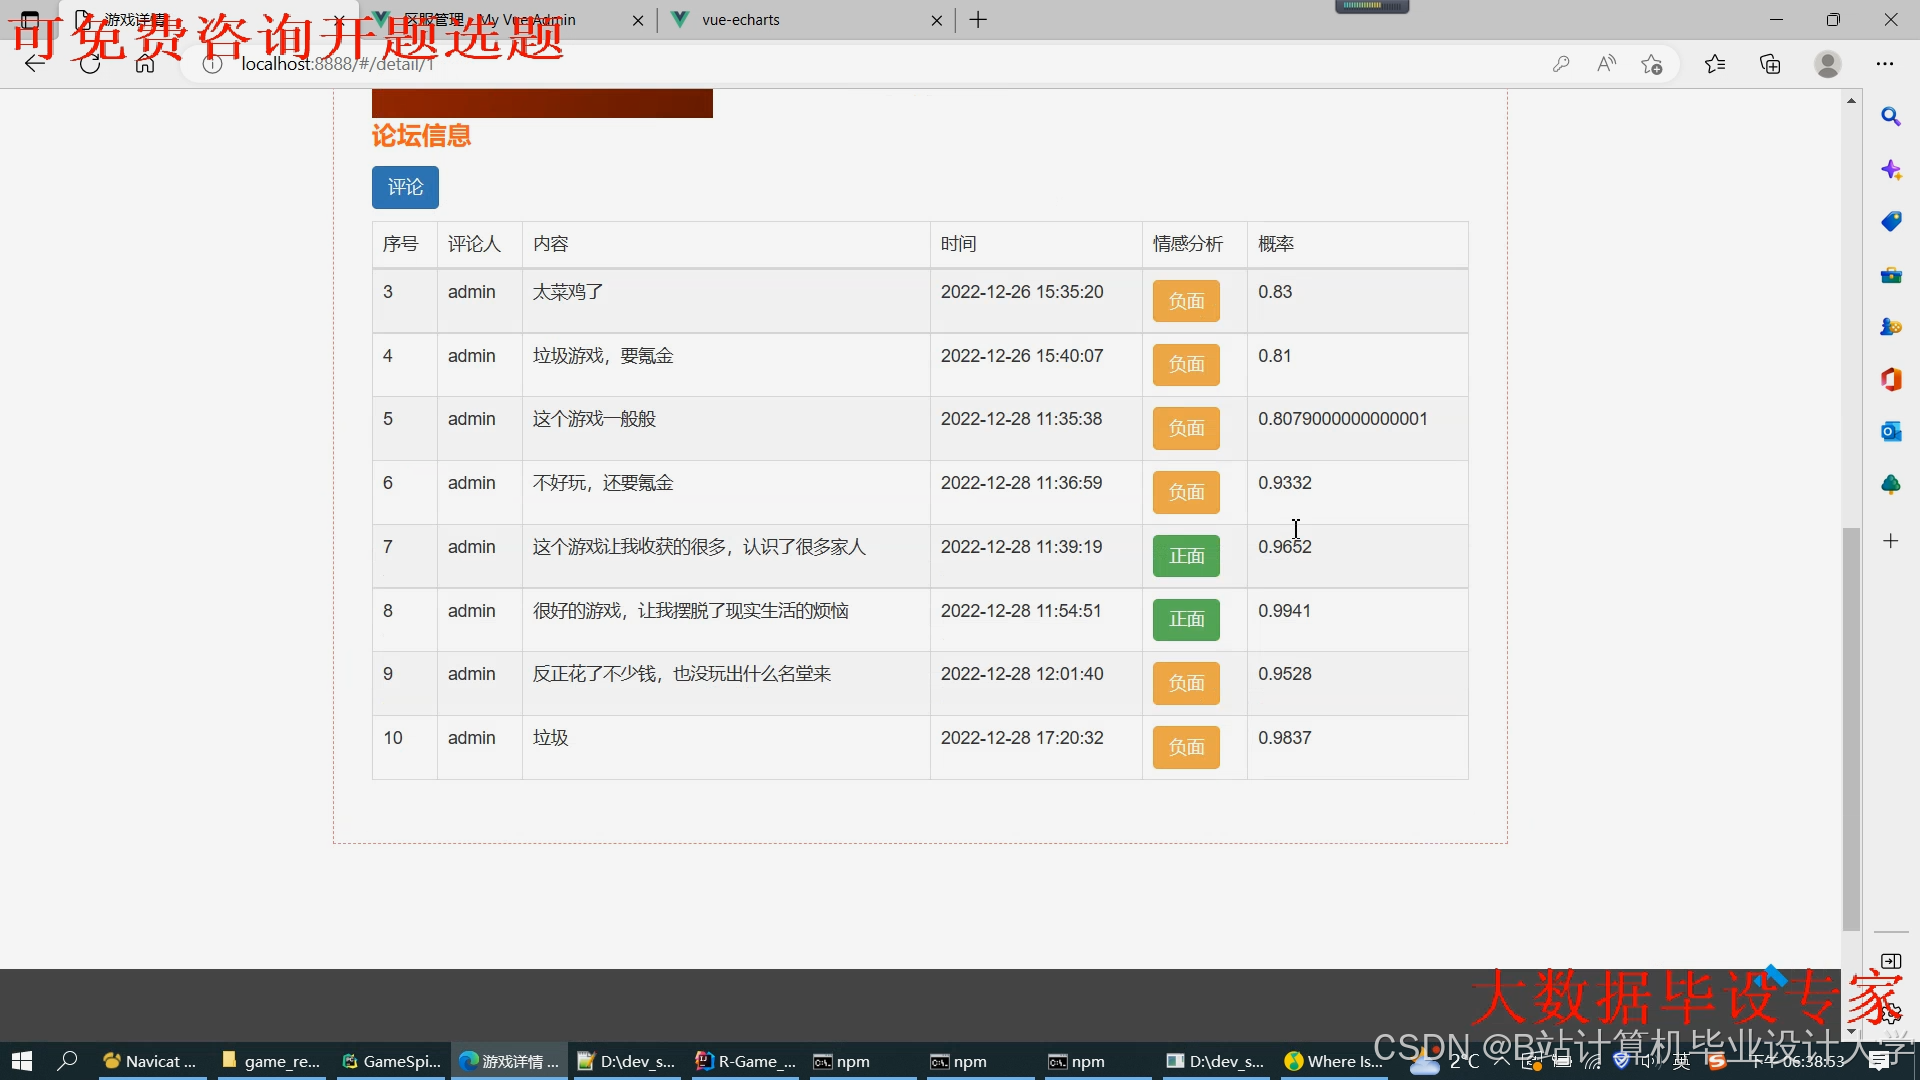
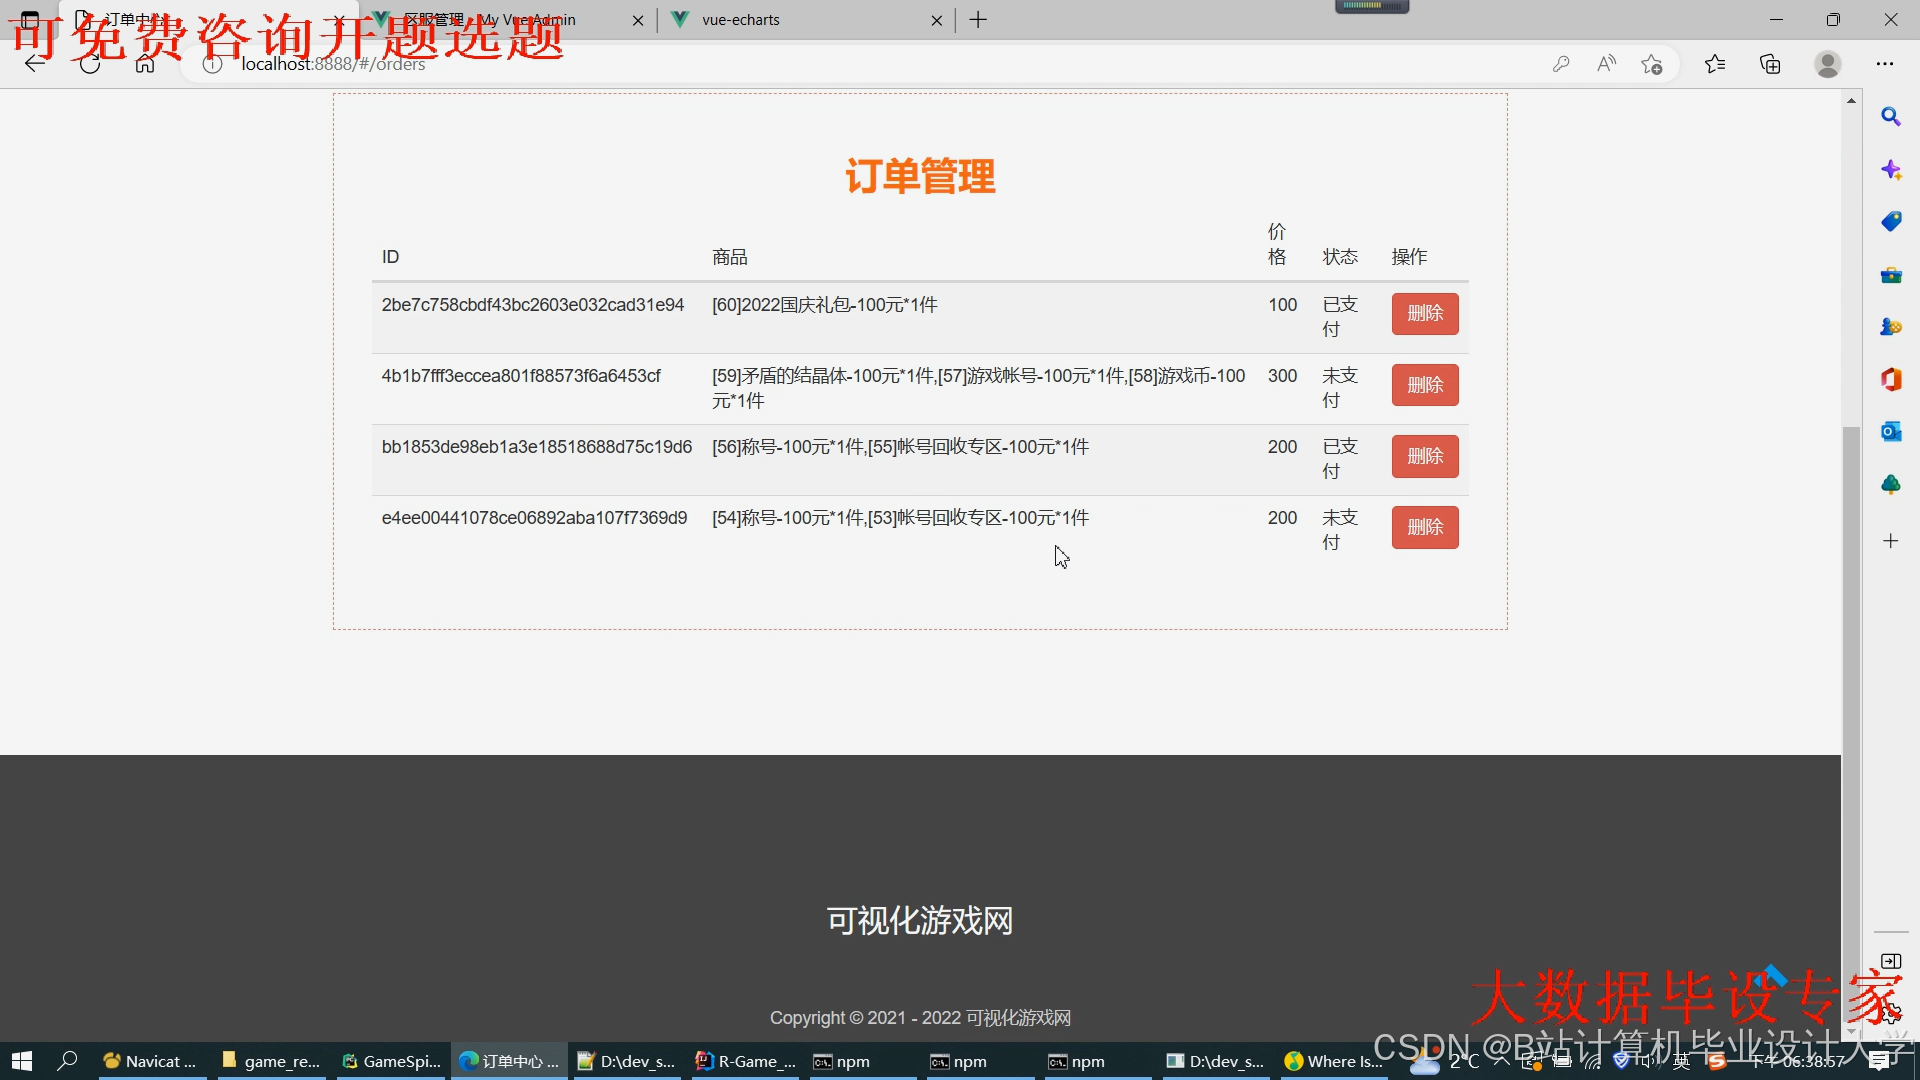
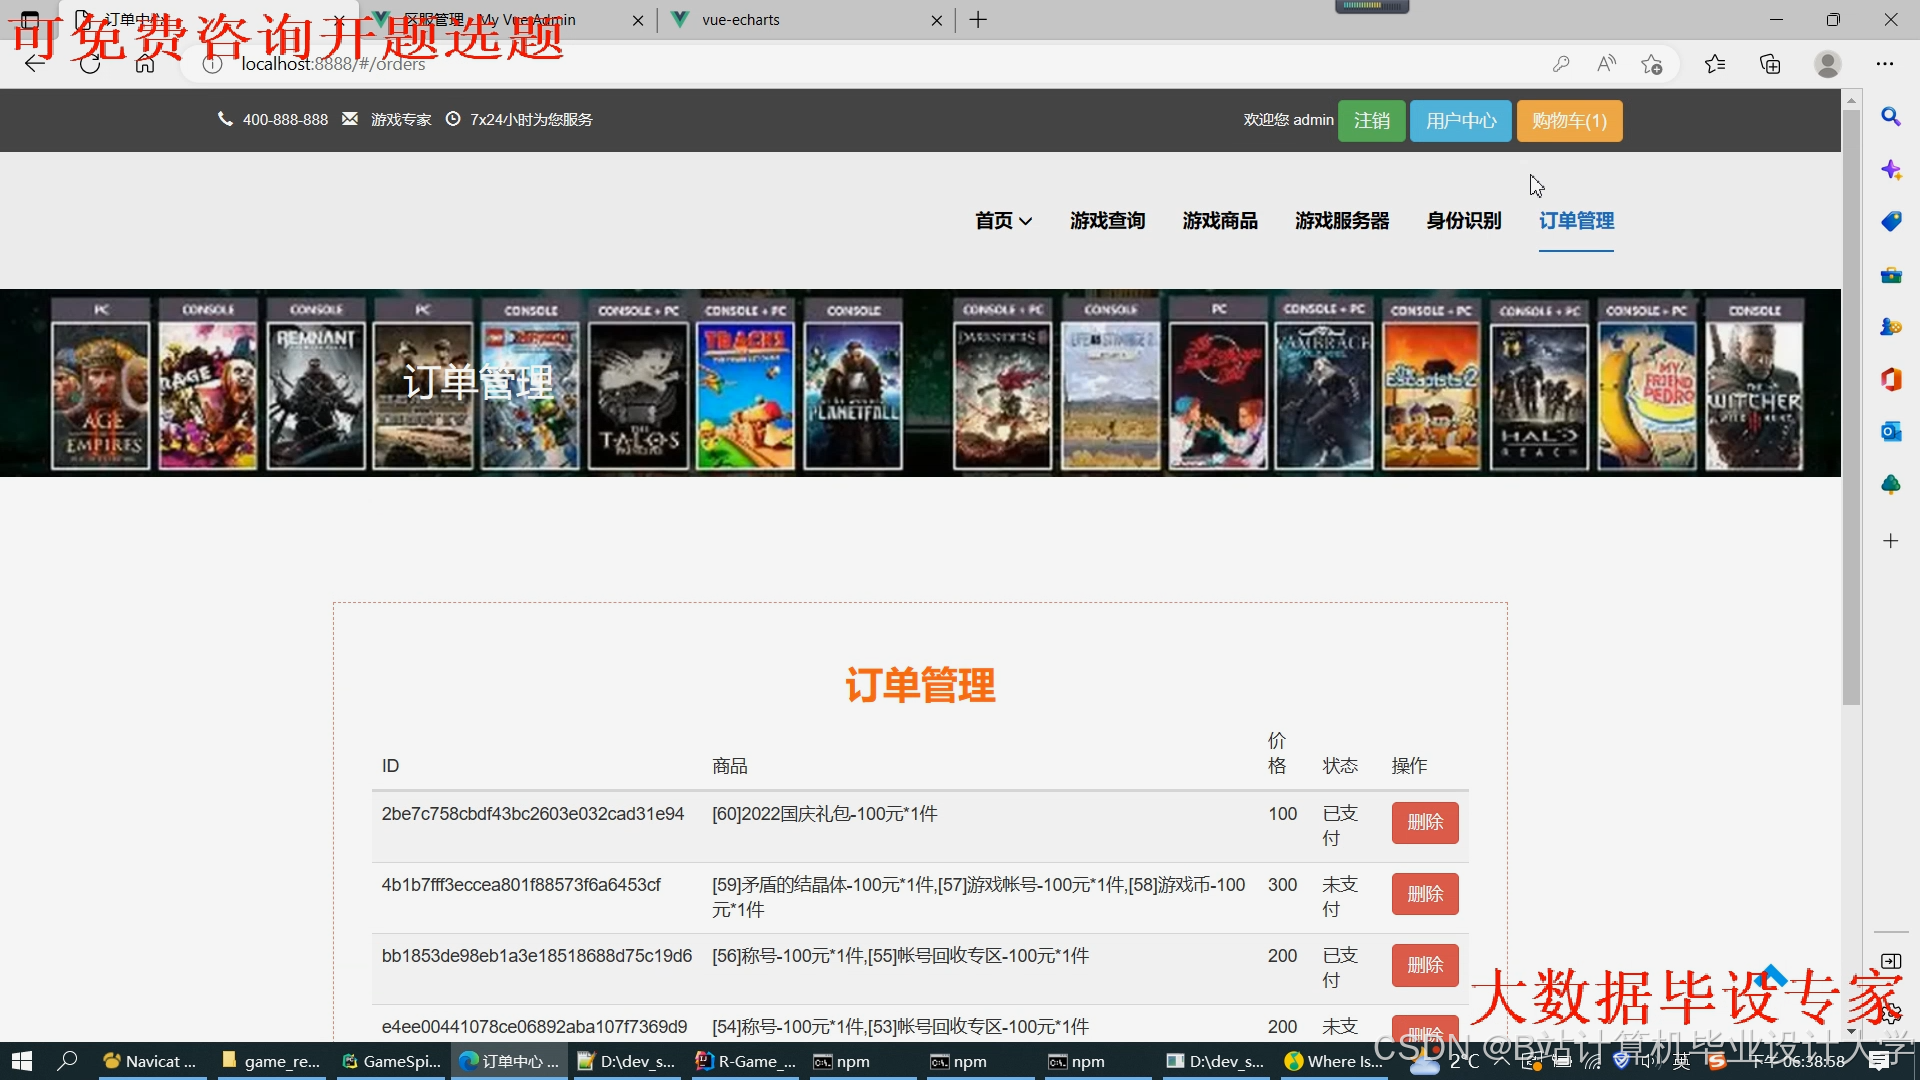
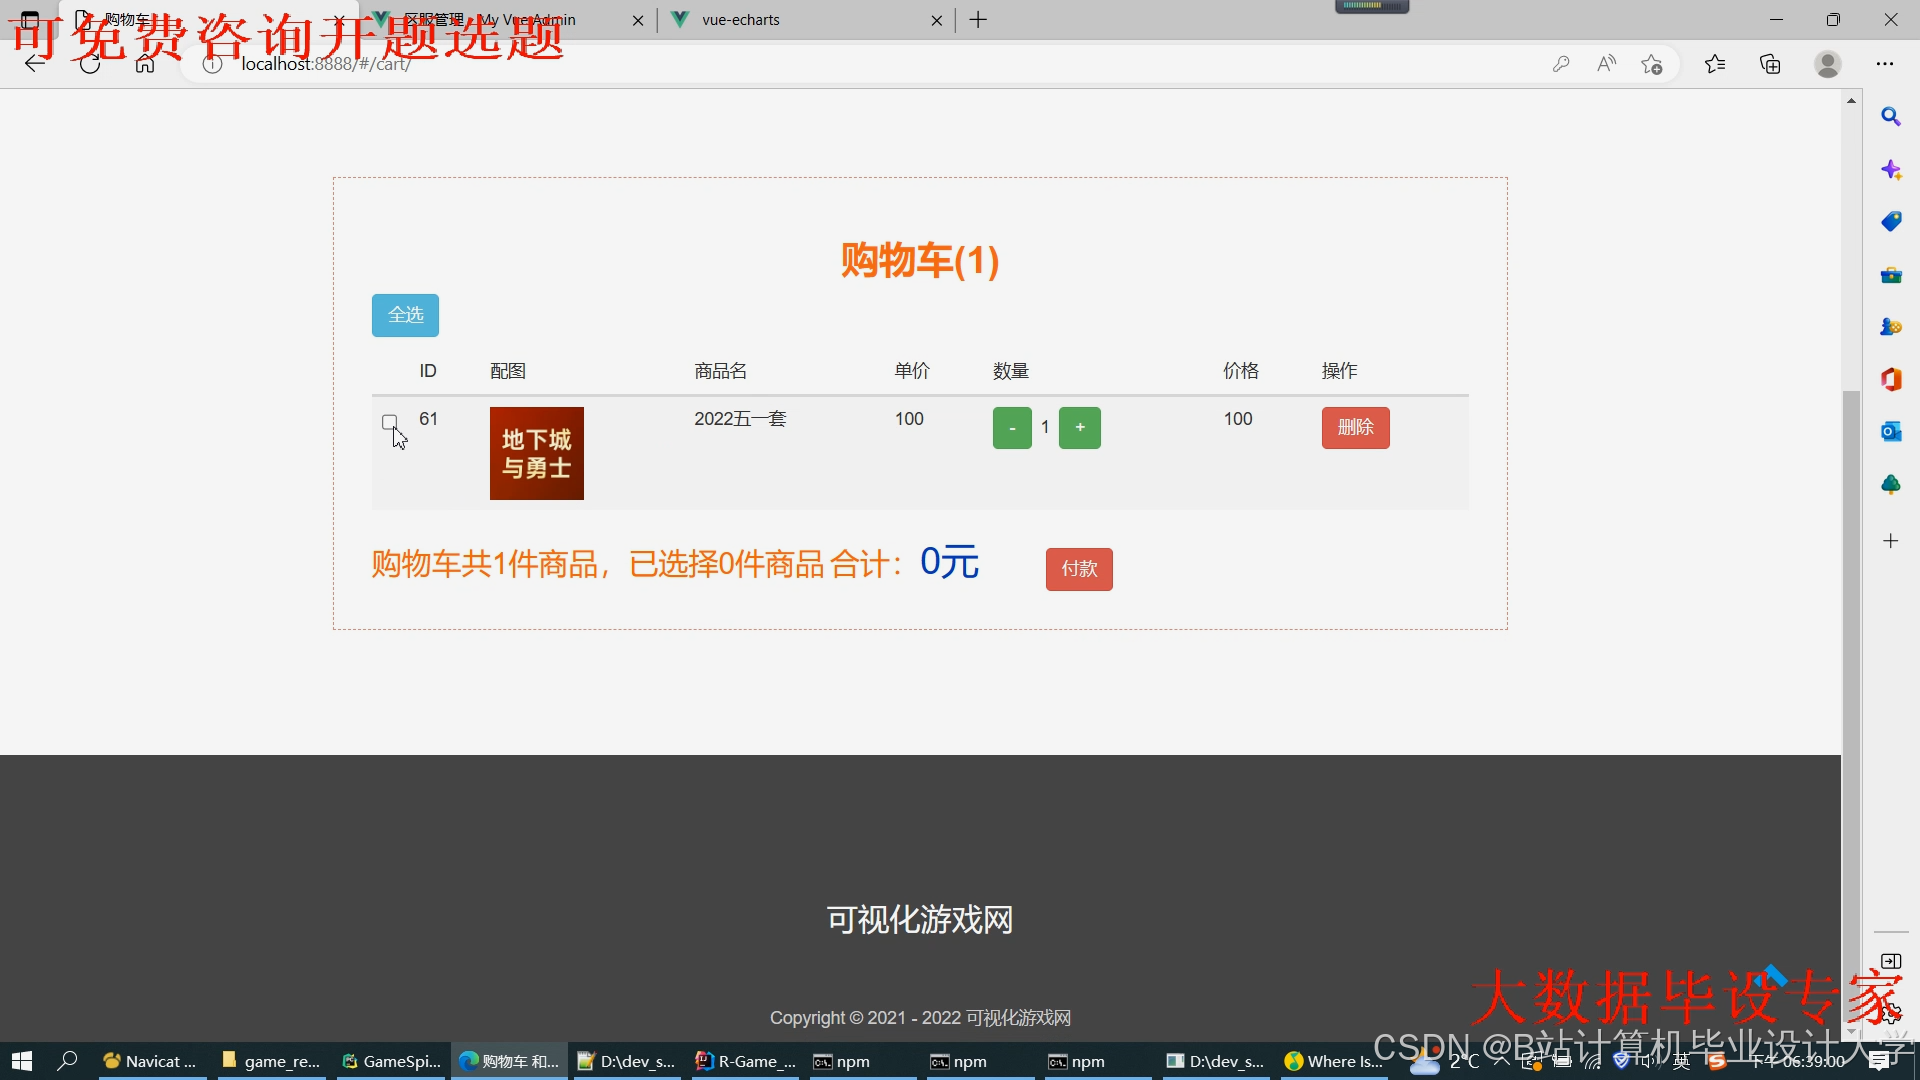
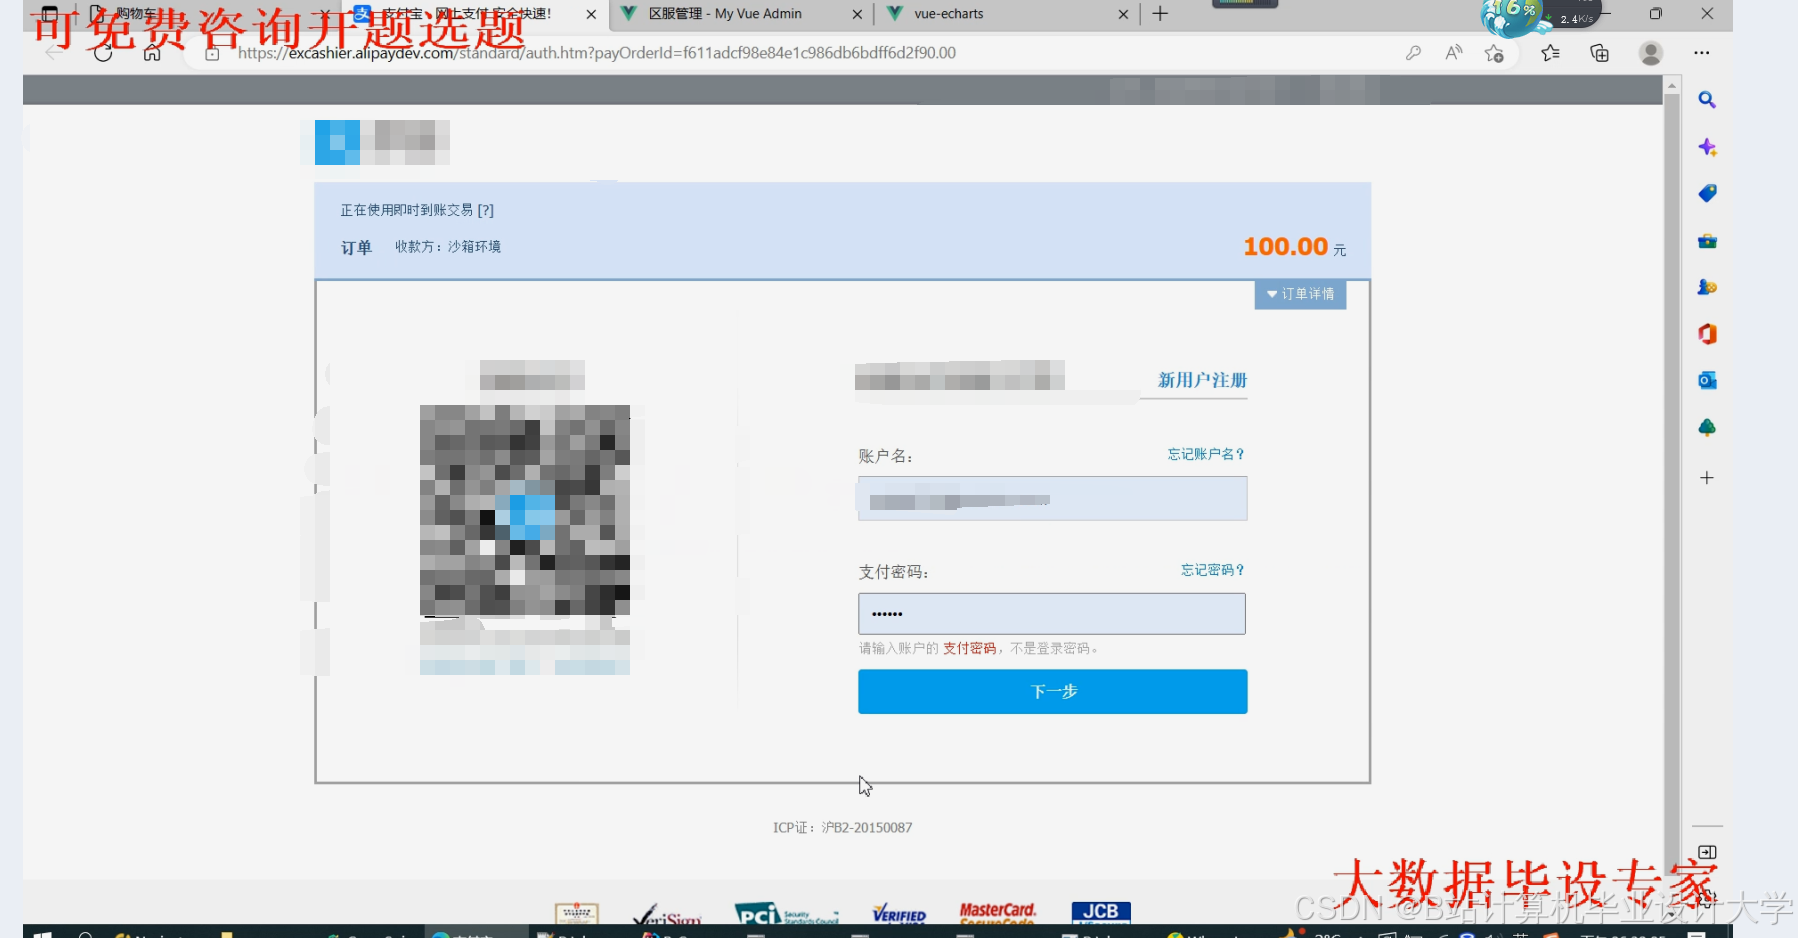
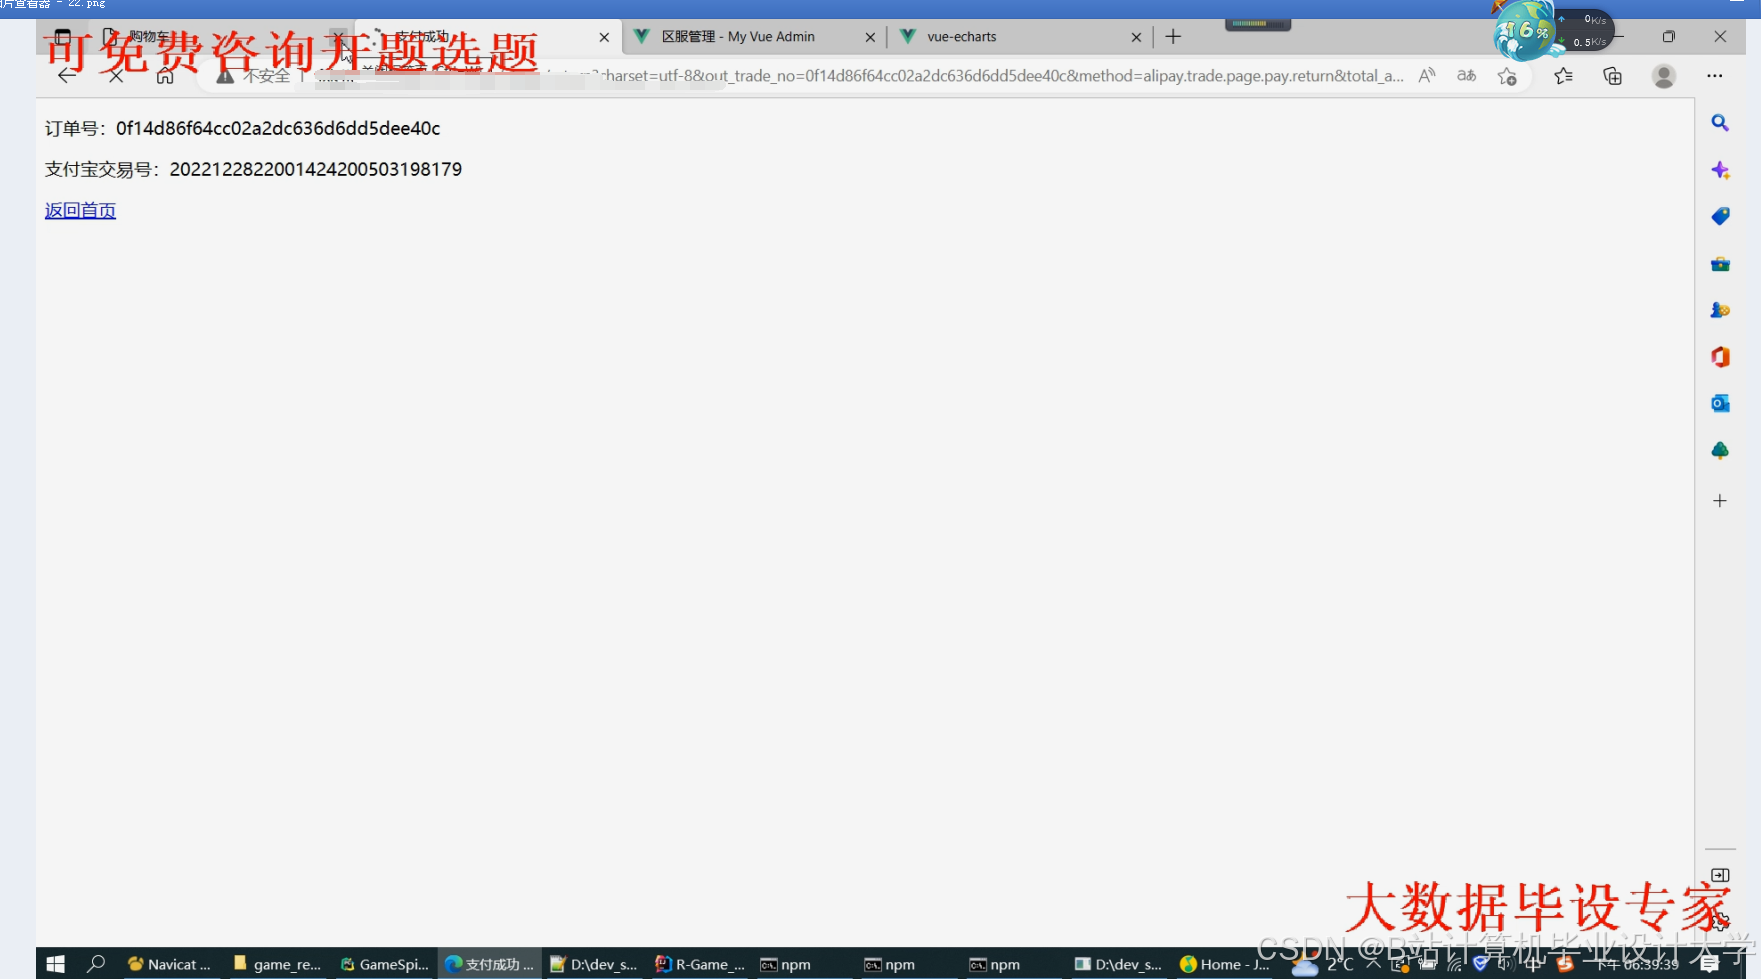
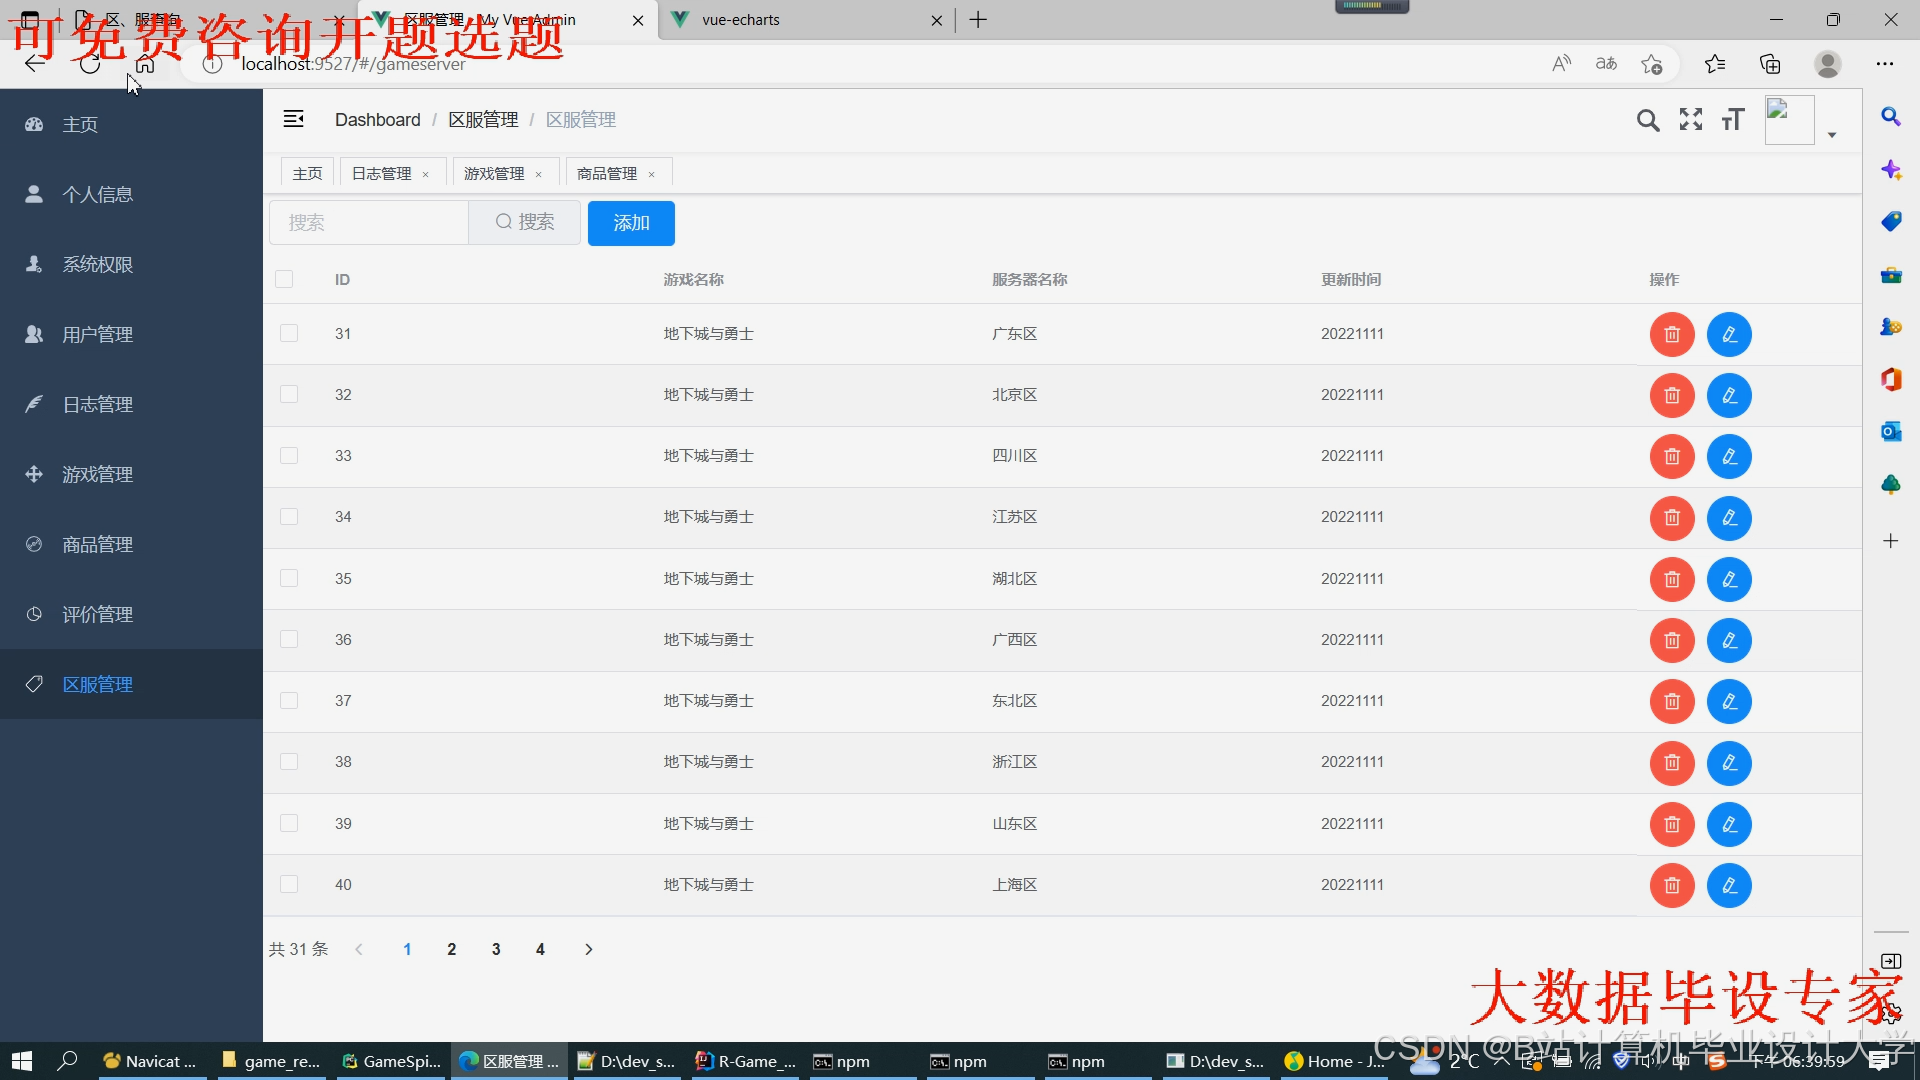
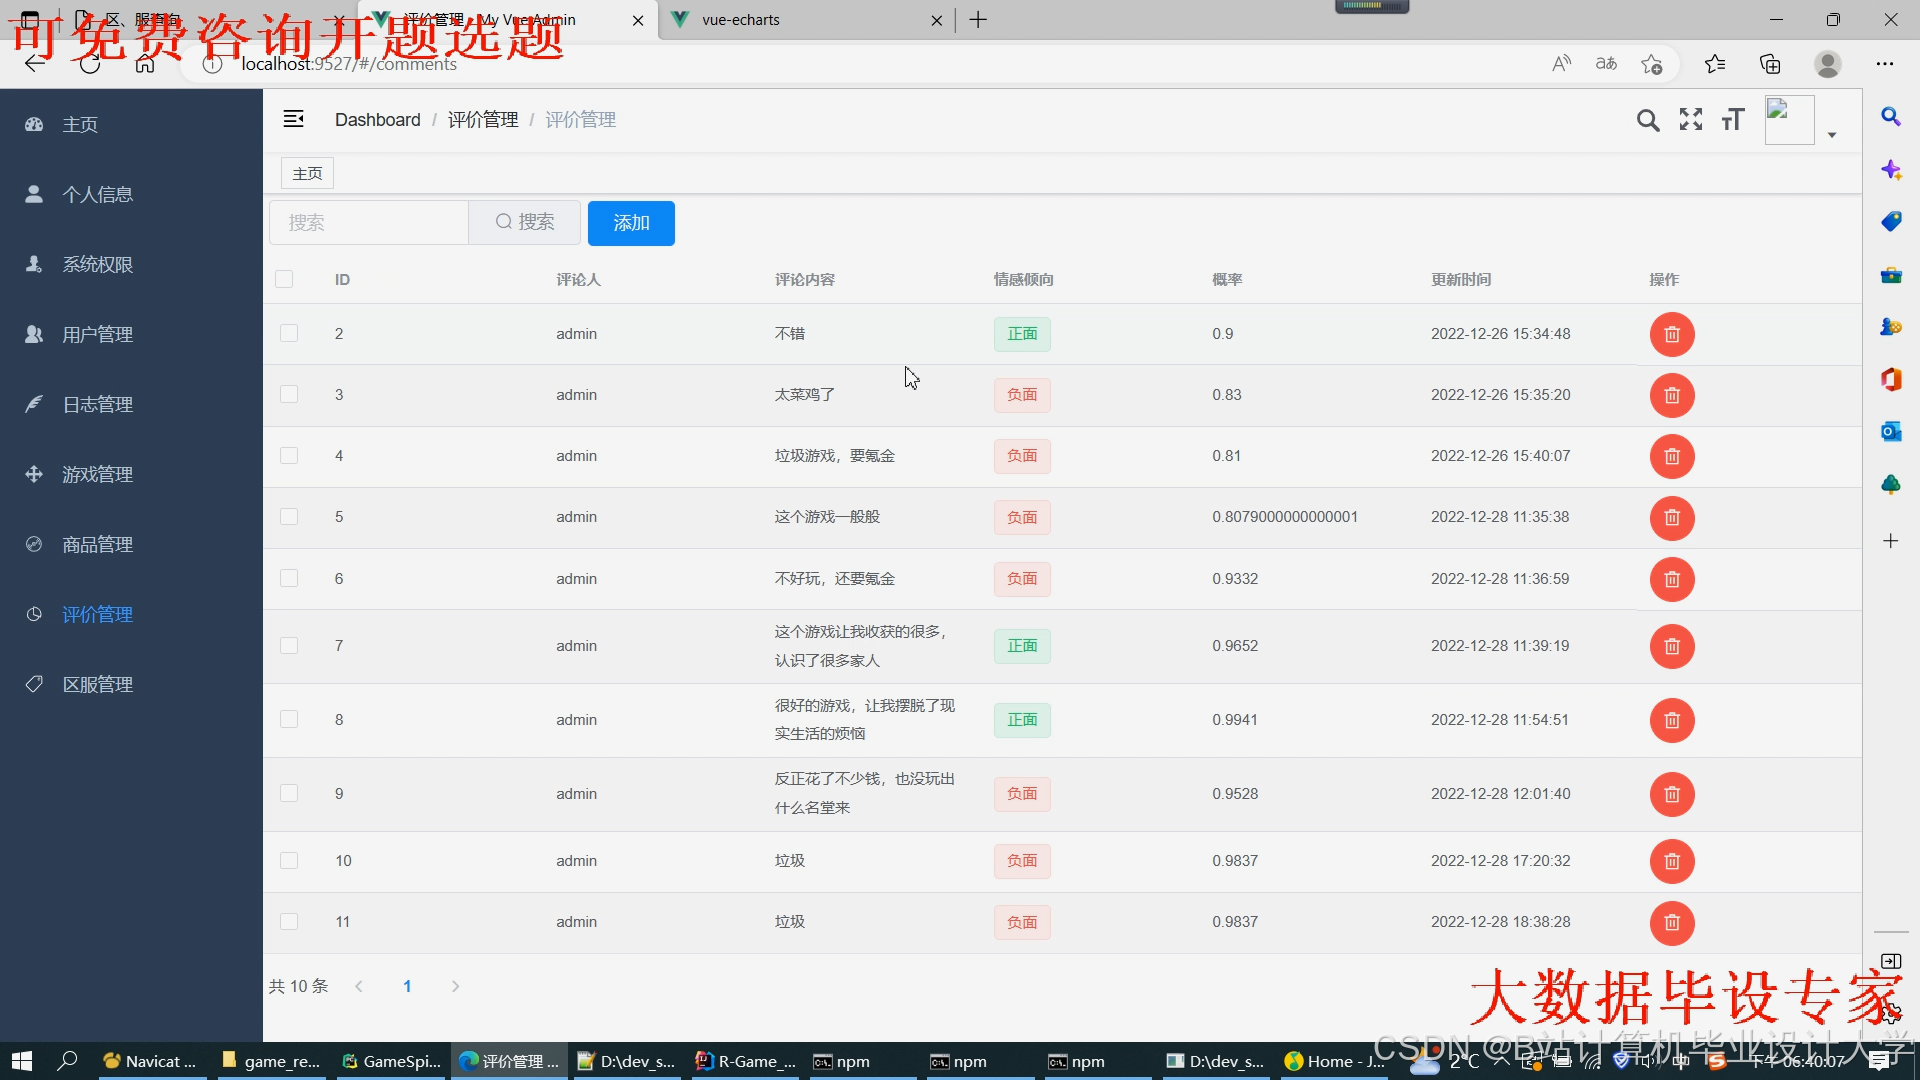
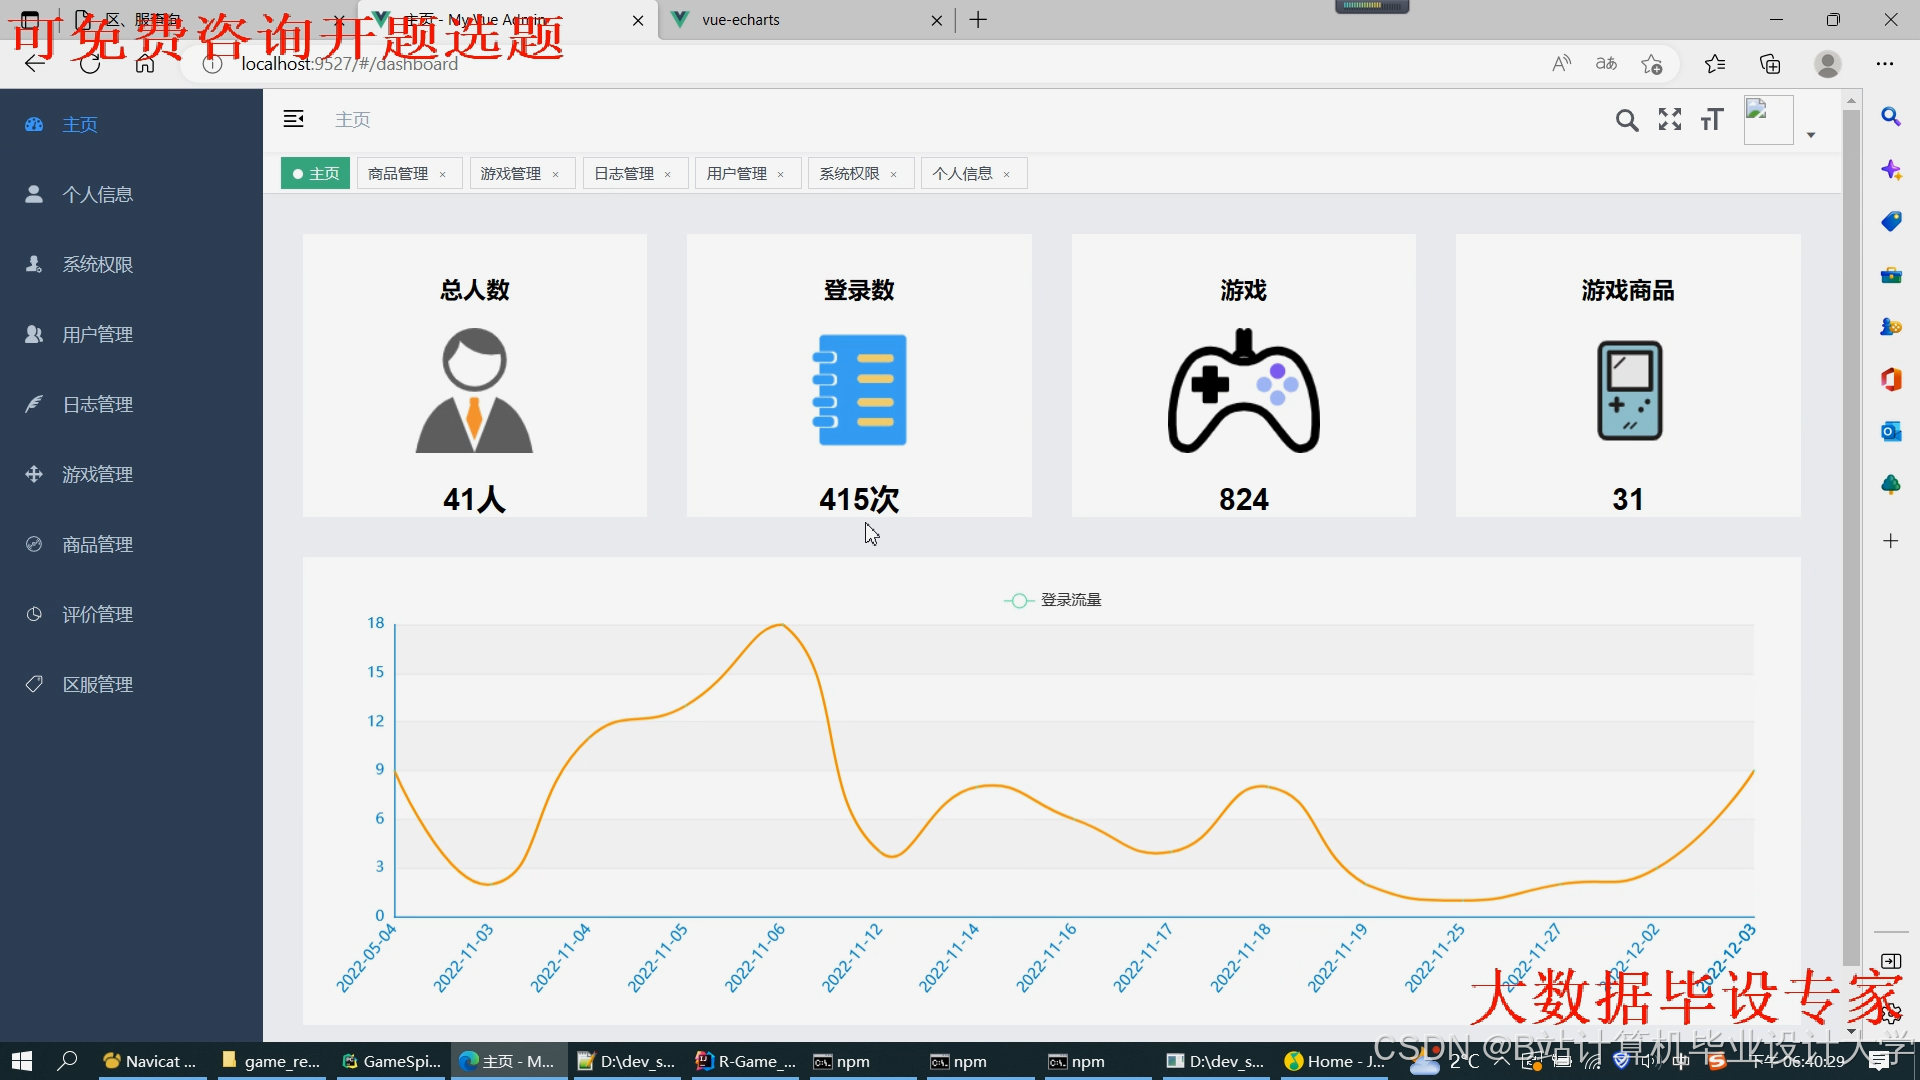
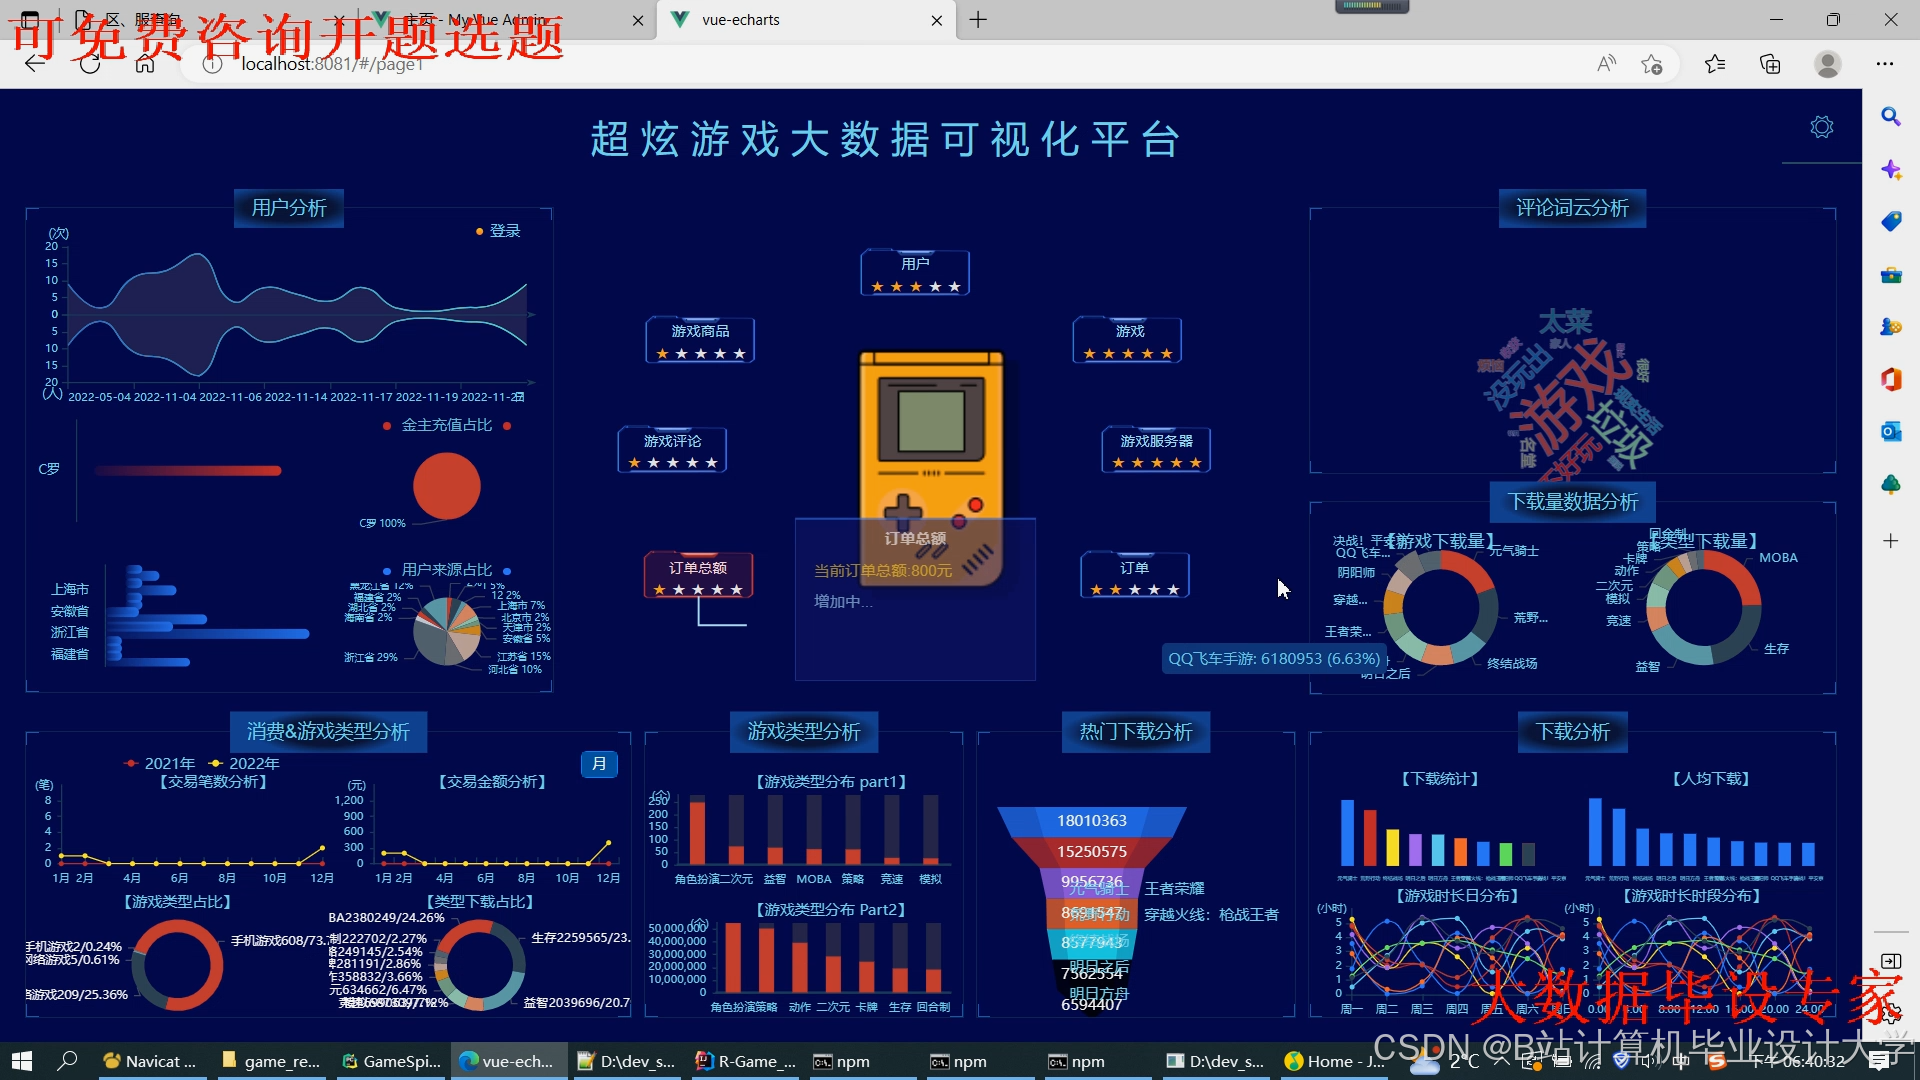
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例
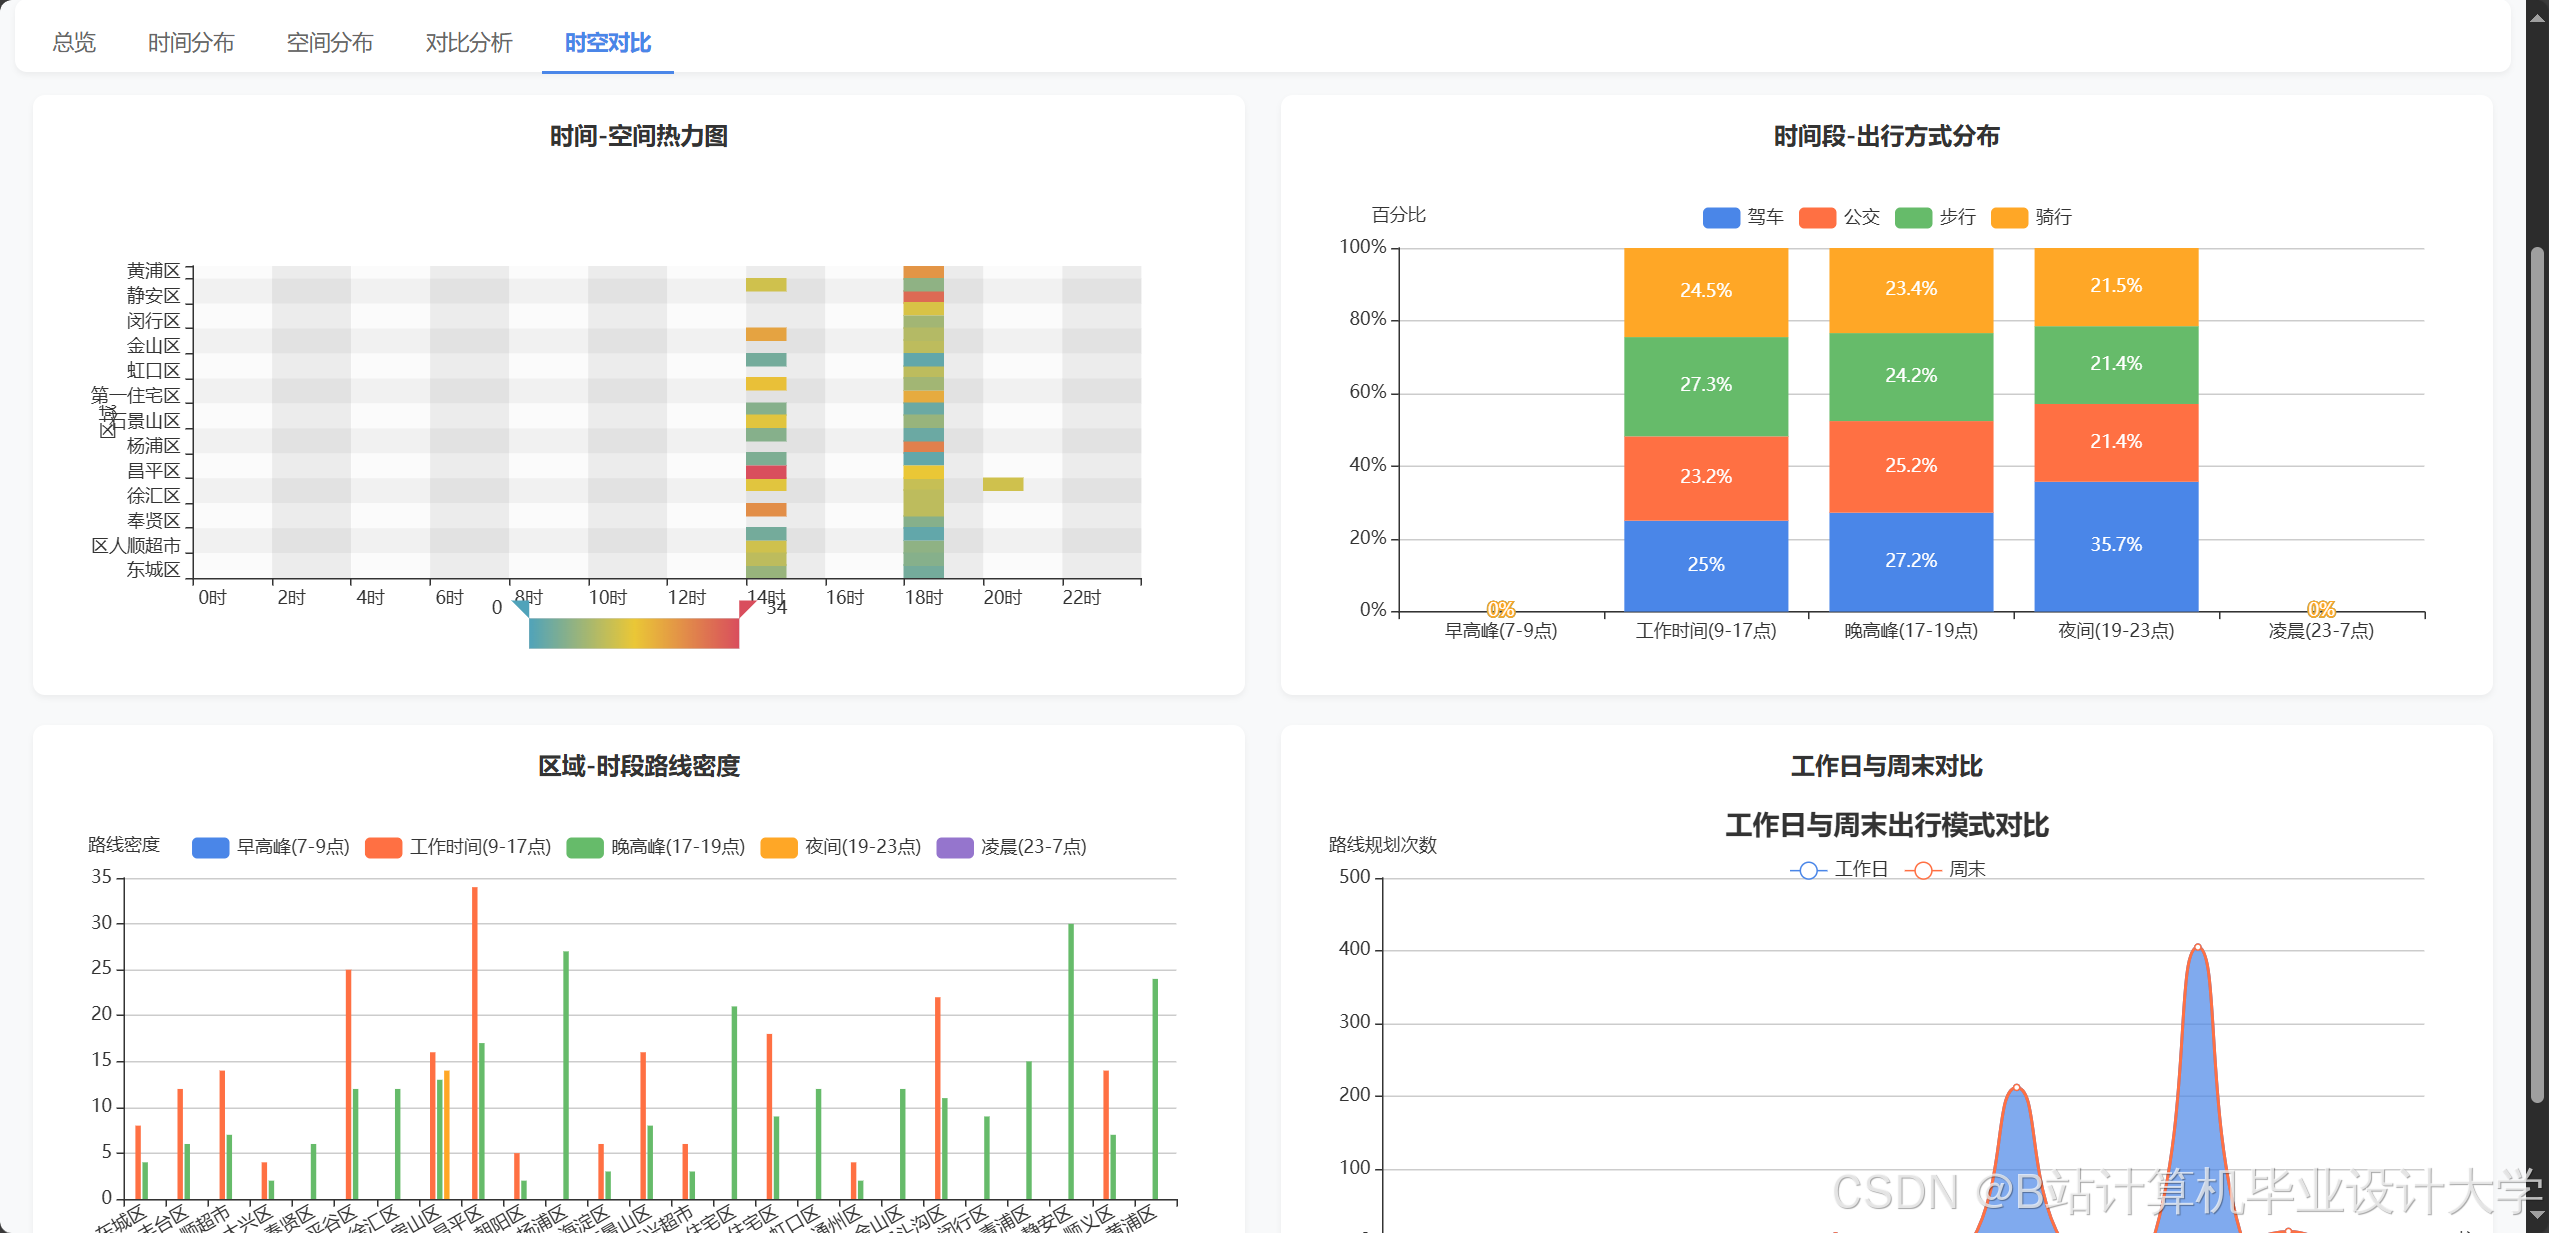
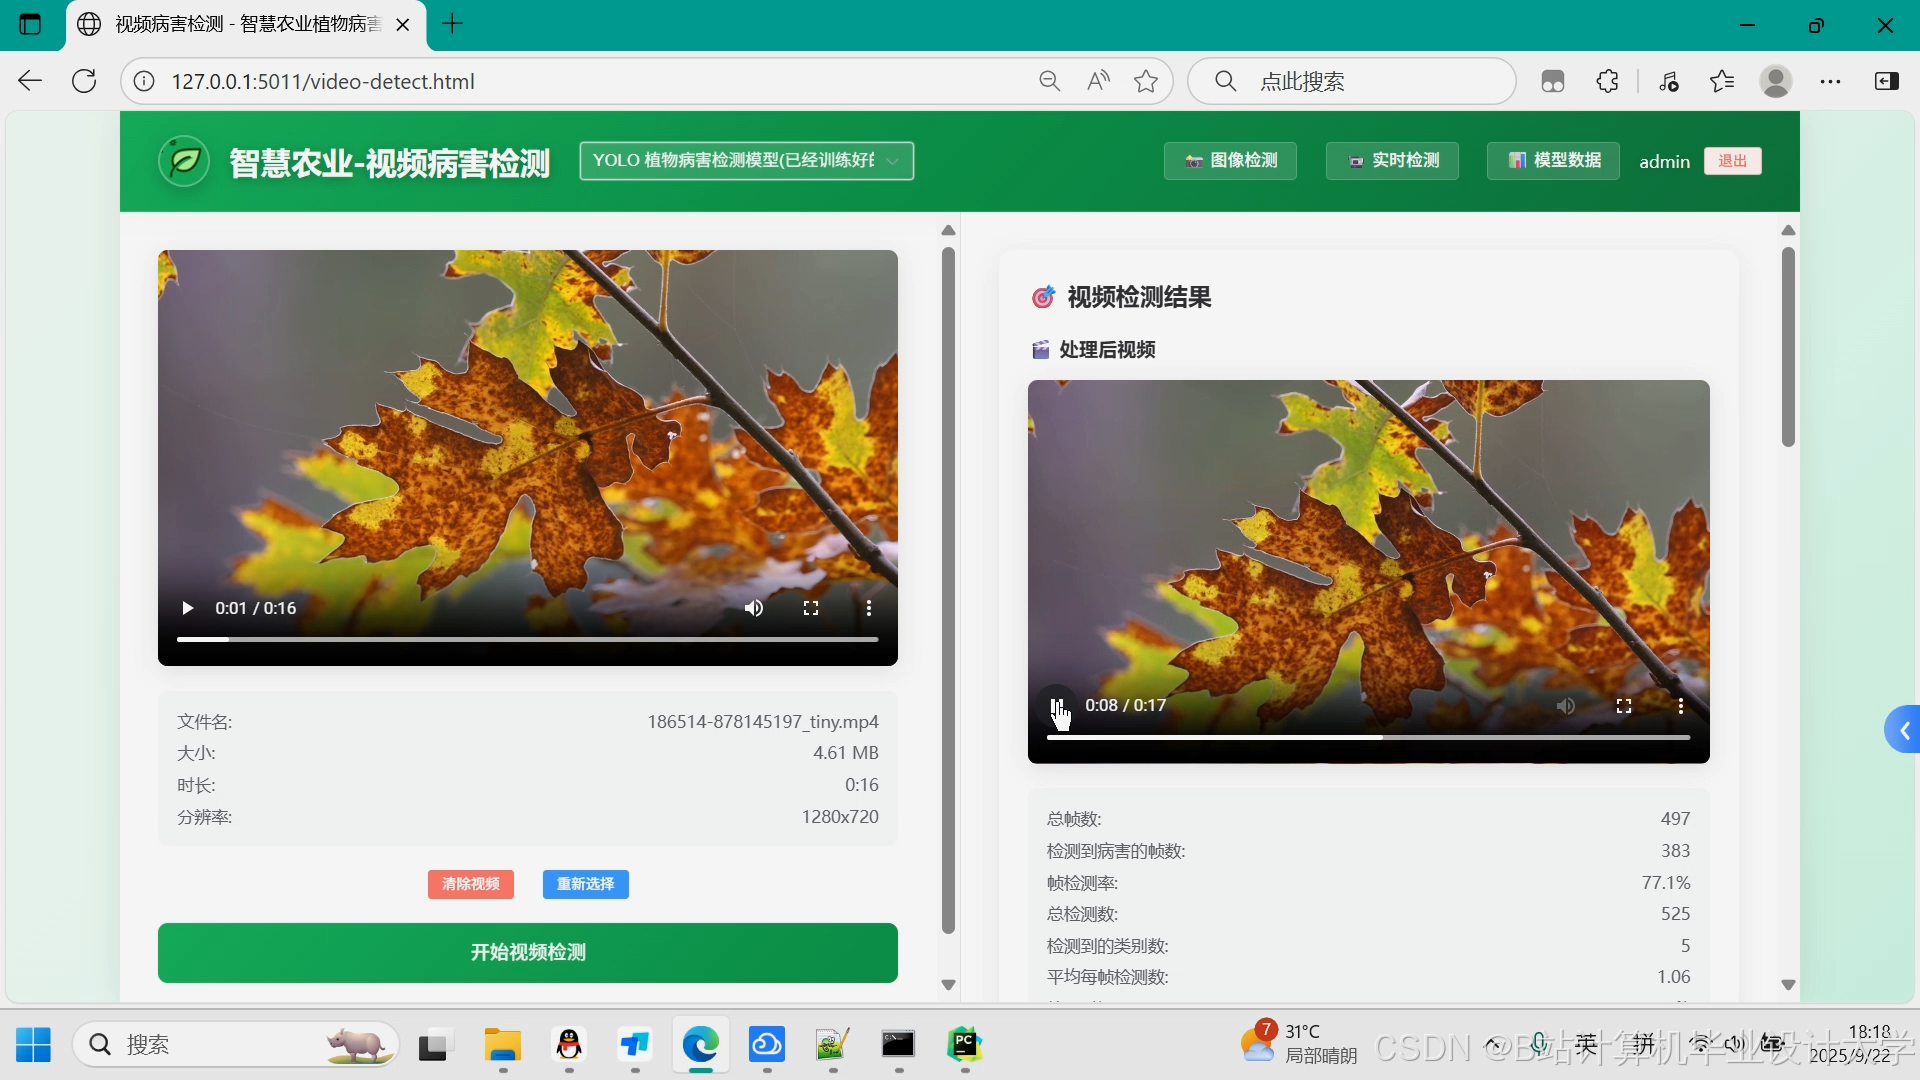


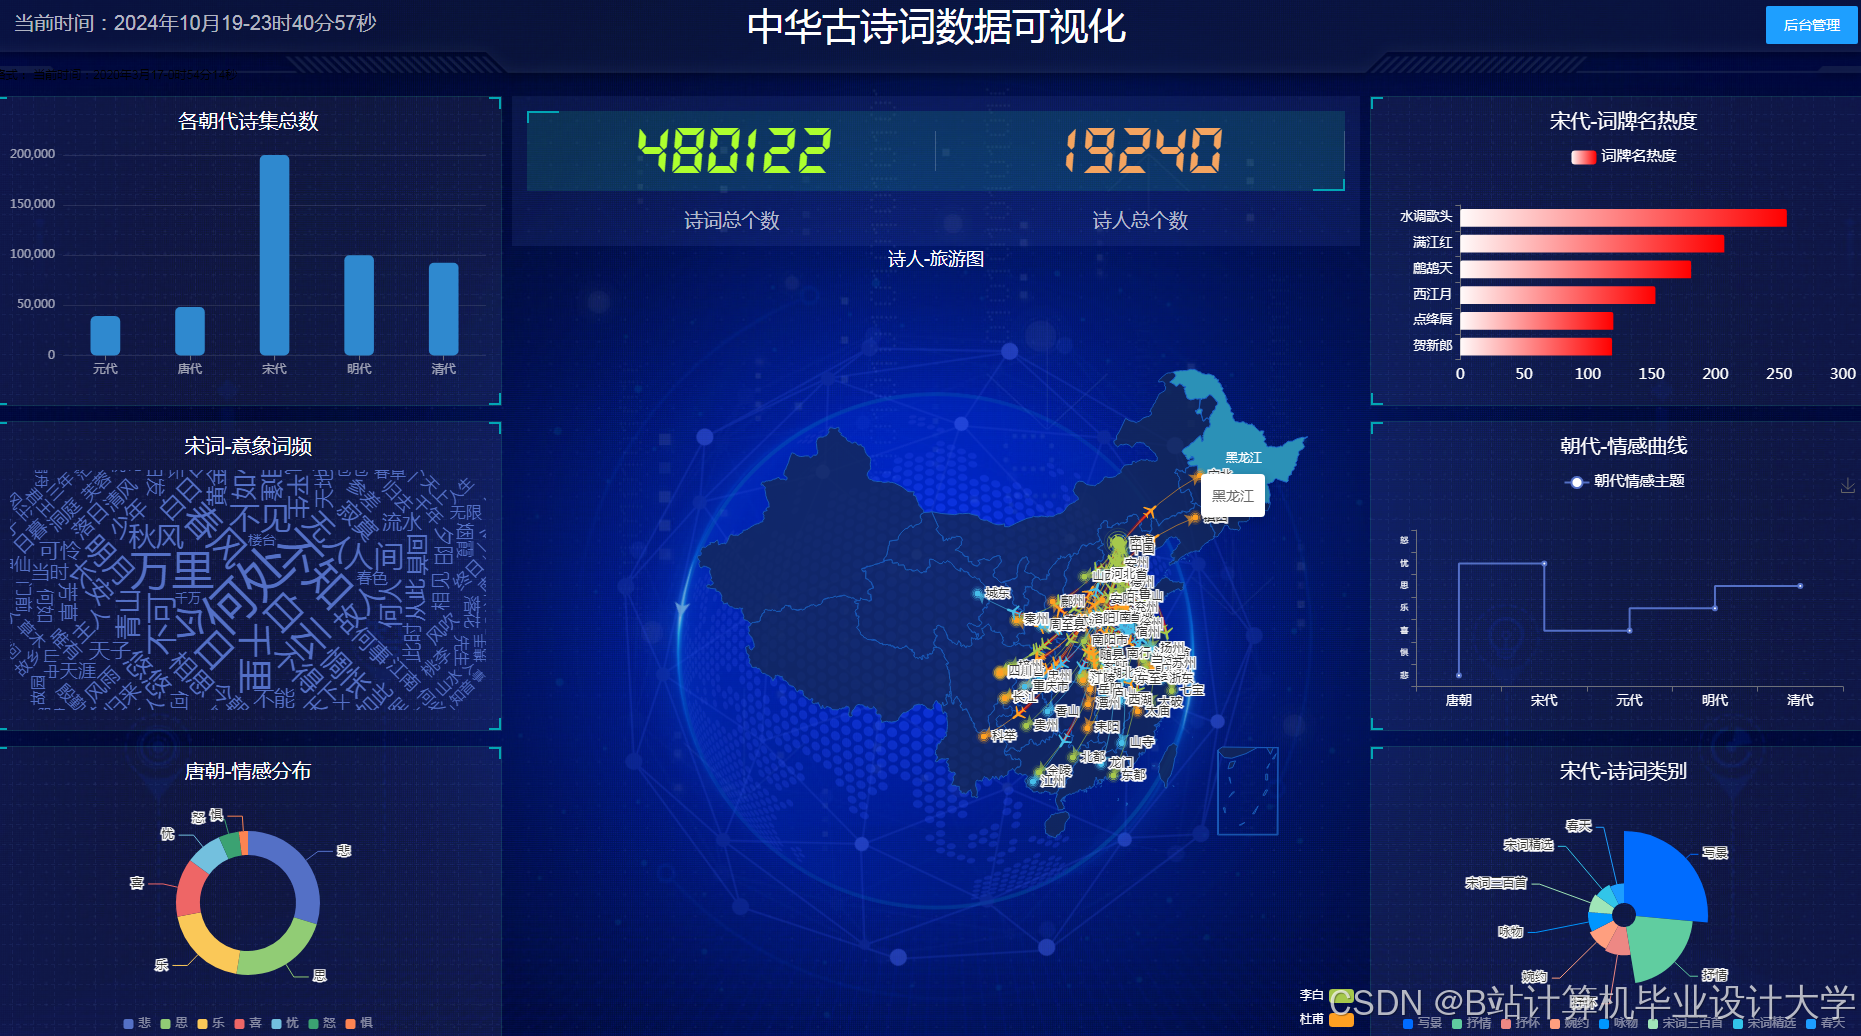


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 11
 0
- 0


 已为社区贡献583条内容

所有评论(0)