R2 医疗成本预测
·
- **🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/o-DaK6aQQLkJ8uE4YX1p3Q) 中的学习记录博客**
- **🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)**
文章目录
概要
- 拿到一份医疗数据,先探索分析找规律,再训练LSTM模型来预测每个人的年度医疗费用。
整体架构流程
一.探索数据:相关性热力图、箱线图、小提琴图、气泡图
二.数据预处理
1. 检查缺失值
→ 发现只有insurance_type有缺失
→ 用"0"填充(代表无保险)
2. 切分特征和标签
X = 除最后一列的所有列(19个特征)
y = 最后一列(annual_medical_cost,要预测的目标)
3. 编码文字列
gender, smoker, physical_activity_level,
insurance_type, city_type
→ 用OrdinalEncoder转成数字
4. 切分训练集和测试集
训练集 → 用来训练模型
测试集 → 用来验证模型好不好
5. 标准化
→ 用StandardScaler让每列数据均值=0,标准差=1
→ 注意:只用训练集fit,测试集直接transform
6. 转成PyTorch张量
→ 深度学习模型只能读张量格式
→ X从二维变三维(样本数, 1, 19),符合LSTM输入要求
三.特征重要性分析
四.LSTM模型训练
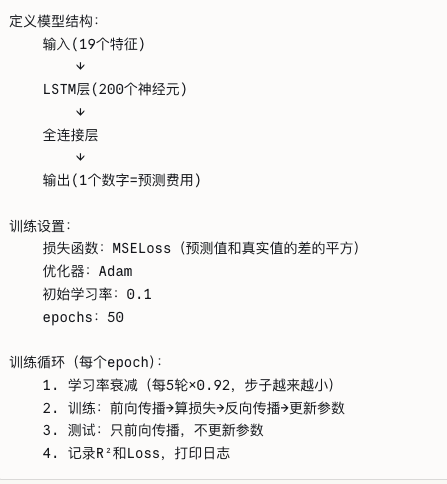
代码运行
import pandas as pd
import torch
import torch.utils.data as data
import matplotlib.pyplot as plt
import seaborn as sns
from torch import nn
from sklearn import metrics
import warnings
warnings.filterwarnings("ignore")

df = pd.read_csv('/Users/lilyj/Downloads/medical_cost_prediction_dataset.csv') # 读取 CSV 文件
df.head(5)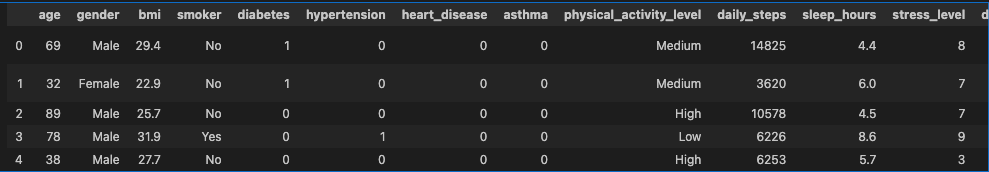
numeric_cols = df.select_dtypes(include=['int64', 'float64'])   #只挑选数值型的列

plt.figure(figsize=(12,8))
sns.heatmap(numeric_cols.corr(), cmap='coolwarm', annot=True)
plt.title("Correlation Heatmap")
plt.show()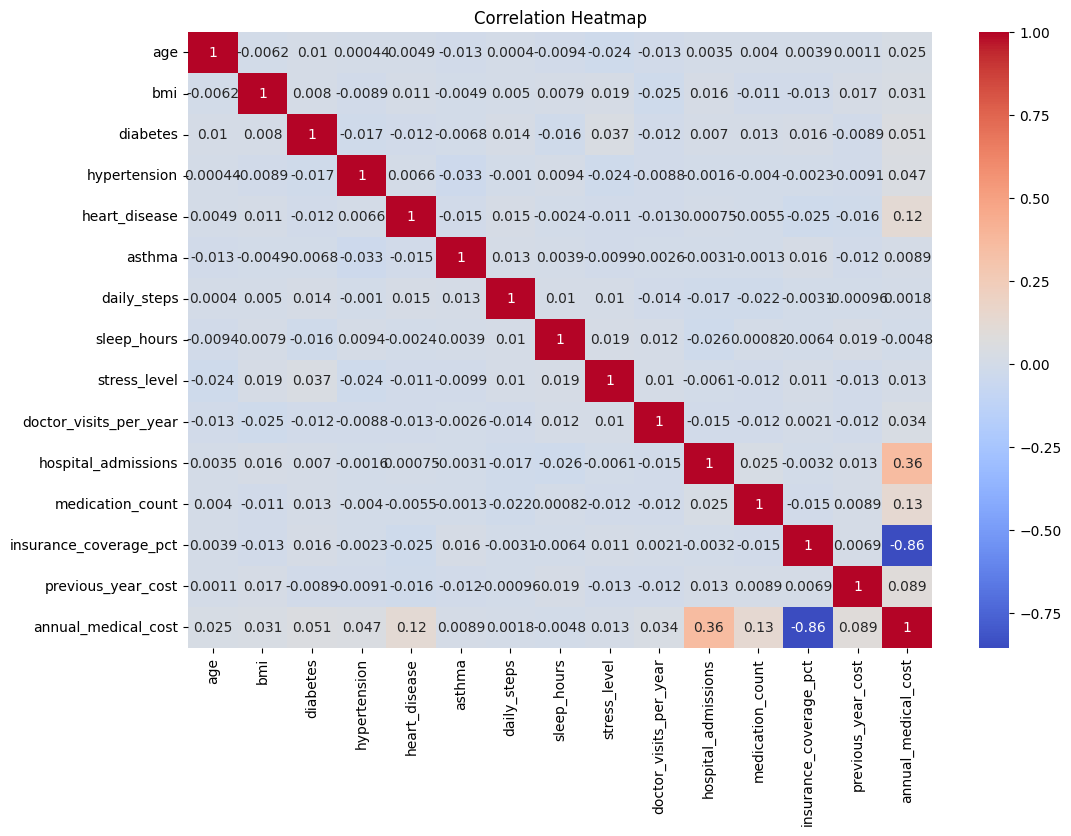
#  → 设置字体为黑体,否则中文会显示成乱码"口口口";字体缩小到80%,防止字太大挤在一起;背景用深灰色网格
sns.set(font='Arial Unicode MS', font_scale=0.8, style="darkgrid")

# 创建matplotlib的fig对象和子图对象ax。创建1行3列共3个并排子图
fig, ax = plt.subplots(1,3, figsize=(12,4))

# 多个数值变量的箱线图
sns.boxplot(data=df.loc[:, ['annual_medical_cost']], ax=ax[0], whis=3)
ax[0].set_title('多个数值变量')

# 一个数值变量多个分组的箱线图  看每组里医疗费用的分布
sns.boxplot(x=df["hospital_admissions"], y=df["annual_medical_cost"], ax=ax[1], whis=3)
ax[1].set_title('一个数值变量多个分组')

# 一个数值变量多个分组子分组的箱线图   每组再按吸烟/不吸烟拆成两个颜色的箱子
sns.boxplot(x="hospital_admissions", y="annual_medical_cost", hue="smoker",
            data=df, palette="Set1", width=0.5, ax=ax[2], whis=3)
ax[2].set_title('一个数值变量多个分组/子分组')

# 调整间距并展示
plt.tight_layout()
plt.show()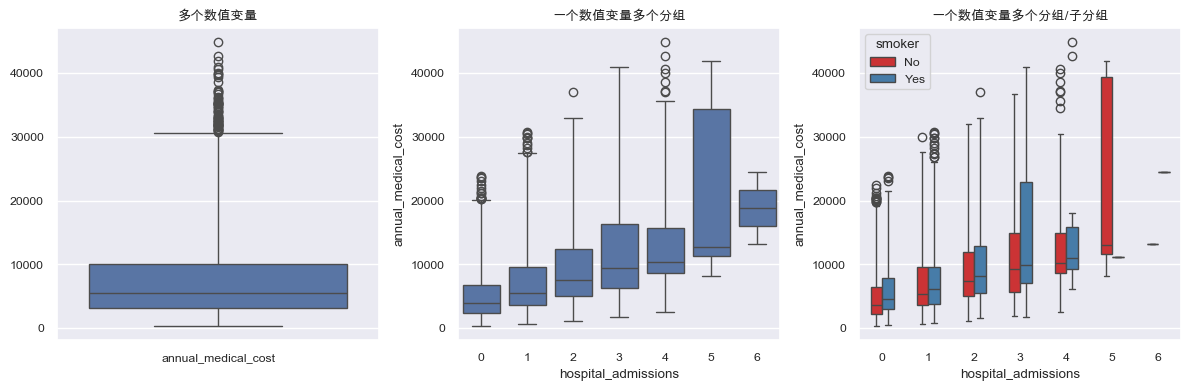
sns.set(font='Arial Unicode MS', font_scale=0.8, style="darkgrid") # 解决Seaborn中文显示问题

# 创建matplotlib的fig对象和子图对象ax
fig, ax = plt.subplots(1,3, figsize=(12,4))

# 多个数值变量的箱线图
sns.violinplot(data=df.loc[:, ['annual_medical_cost']], ax=ax[0])
ax[0].set_title('多个数值变量')

# 一个数值变量多个分组的箱线图
sns.violinplot(x=df["heart_disease"], y=df["annual_medical_cost"], ax=ax[1])
ax[1].set_title('一个数值变量多个分组')

# 一个数值变量多个分组子分组的箱线图
sns.violinplot(x="heart_disease", y="annual_medical_cost", hue="smoker",
            data=df, palette="Set1", width=0.5, ax=ax[2])
ax[2].set_title('一个数值变量多个分组/子分组')

# 调整间距并展示
plt.tight_layout()
plt.show()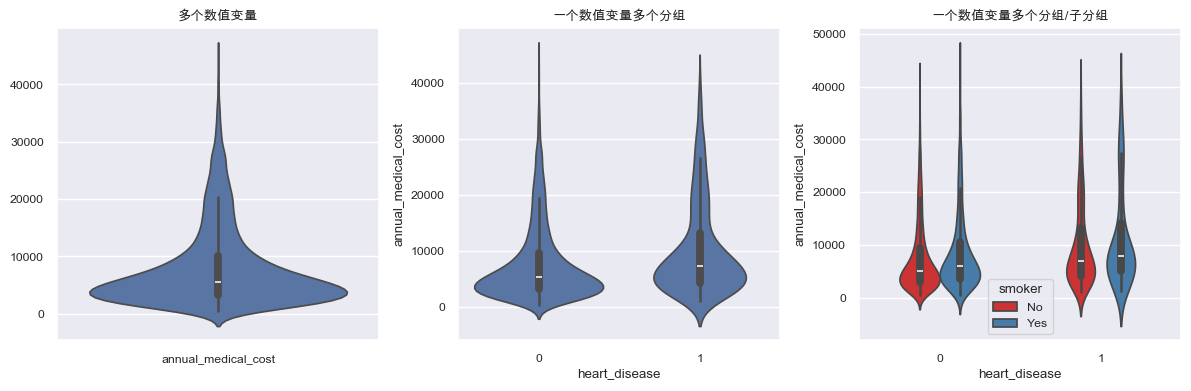
# 1. 创建3个子图布局
fig, ax = plt.subplots(1, 3, figsize=(12, 4))

# 子图1
sns.scatterplot(
    data=df[:100],
    x="previous_year_cost",  # 第一个数值变量(对应原x轴)
    y="annual_medical_cost", # 第二个数值变量(对应原y轴)
    size="age",              # 气泡大小映射:年龄越大,气泡越大
    sizes=(20, 200),         # 气泡大小范围(避免过大/过小)
    alpha=0.6,               # 透明度(避免重叠遮挡)
    color="#2E86AB",         # 统一气泡颜色(突出大小差异)
    ax=ax[0]
)
ax[0].set_title('(气泡大小=年龄)')
ax[0].set_xlabel('上一年费用(元)')
ax[0].set_ylabel('年度医疗费用(元)')
ax[0].legend(title='年龄', bbox_to_anchor=(1.05, 1), loc='upper left')  # 图例位置调整

# 子图2
sns.scatterplot(
    data=df[:100],
    x="bmi",              # 分组变量(性别)
    y="annual_medical_cost", # 核心数值变量
    size="age",              # 气泡大小=年龄
    sizes=(40, 250),
    alpha=0.7,
    hue="gender",            # 颜色区分性别(增强分组识别)
    palette="Set2",
    legend=False,            # 隐藏重复图例(x轴已体现性别)
    ax=ax[1]
)
ax[1].set_title('按bmi分组(气泡大小=年龄)')
ax[1].set_xlabel('bmi')
ax[1].set_ylabel('年度医疗费用(元)')

# 子图3
sns.scatterplot(
    data=df[:100],
    x="sleep_hours", # 主分组(性别)
    y="annual_medical_cost", # 核心数值变量
    hue="smoker",            # 子分组(吸烟状态)- 颜色区分
    size="age",              # 气泡大小=年龄(第三维度)
    sizes=(40, 300),
    alpha=0.7,
    palette="Set1",          # 子分组颜色(和原代码一致)
    ax=ax[2]
)
ax[2].set_title('睡眠时间+吸烟状态(气泡大小=年龄)')
ax[2].set_xlabel('睡眠时间')
ax[2].set_ylabel('年度医疗费用(元)')
ax[2].legend(title='吸烟状态', bbox_to_anchor=(1.05, 1), loc='upper left')

# 调整布局,避免标签重叠
plt.tight_layout()
plt.show()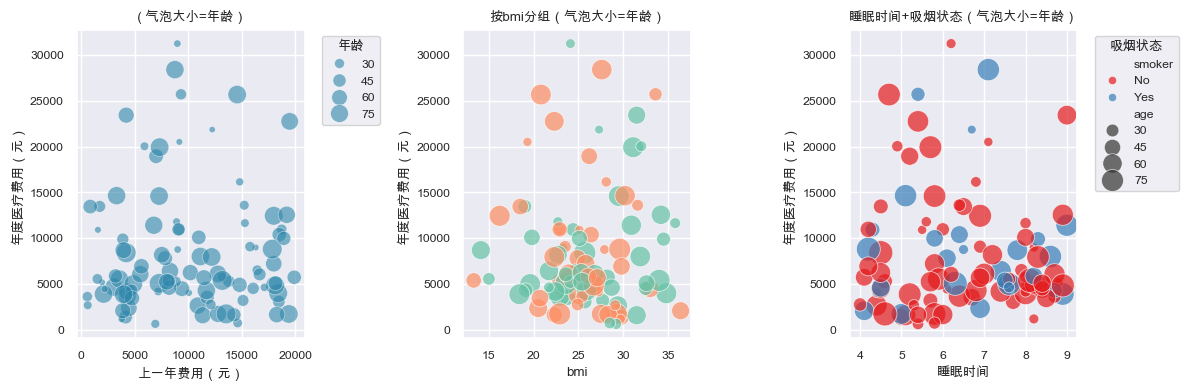
df.isnull().any() # 检查是否存在缺失值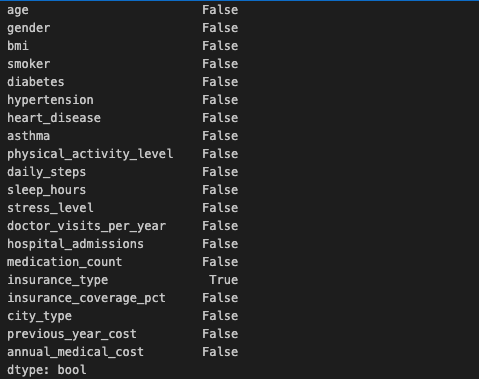
df["insurance_type"].fillna("0", inplace=True)

from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split

X = df.iloc[:,:-1]
y = df.iloc[:,-1]

from sklearn.preprocessing import LabelEncoder,OrdinalEncoder

label_cols = [1, 3, 8, 15, 17]  # 需要编码的列索引  第1列  → gender 第1列  → gender...
oe = OrdinalEncoder()
X.iloc[:, label_cols] = oe.fit_transform(X.iloc[:, label_cols])  #fit → 先学习这几列里有哪些类别,transform → 把这些类别转换成数字

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.2, random_state = 1)

X_train.shape, X_test.shape, y_train.shape, y_test.shape
from sklearn.ensemble import RandomForestRegressor

rf = RandomForestRegressor(n_estimators=100, random_state=42)  #n_estimators=100 → 建100棵决策树;random_state=42 → 固定随机种子,保证每次运行结果一样
rf.fit(X_train, y_train)   # 用训练数据让模型学习

feature_importance = pd.DataFrame({
    'feature': X_train.columns,            # 特征名称
    'importance': rf.feature_importances_      # 每个特征的重要性分数
}).sort_values('importance', ascending=False)  # 从高到低排序

print("\n前10个重要特征:")
print(feature_importance.head(10))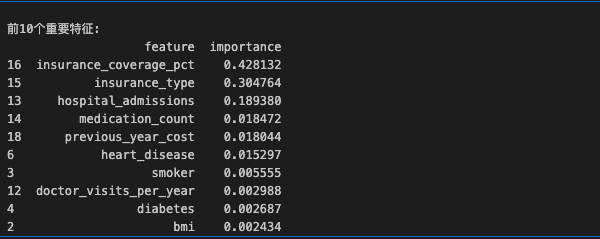
from sklearn.preprocessing import StandardScaler
import numpy as np

#将数据归一化,范围是0到1
sc  = StandardScaler()

X_train = sc.fit_transform(X_train)
X_test  = sc.transform(X_test)

X_train = torch.tensor(X_train, dtype=torch.float32).unsqueeze(1)
X_test  = torch.tensor(X_test,  dtype=torch.float32).unsqueeze(1)
y_train = torch.tensor(y_train.values, dtype=torch.float32)
y_test  = torch.tensor(y_test.values,  dtype=torch.float32)

X_train.shape, X_test.shape, y_train.shape, y_test.shape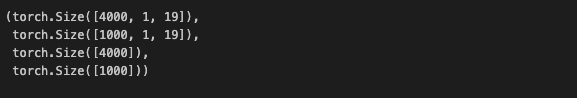
from torch.utils.data import DataLoader

batch_size = 32

# 封装数据
train_dataset = data.TensorDataset(X_train, y_train)
test_dataset  = data.TensorDataset(X_test, y_test)

# 加载数据
train_dataloader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)#
test_dataloader  = DataLoader(test_dataset, batch_size=batch_size) #, shuffle=True

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

device

class model_lstm(nn.Module):
    def __init__(self):
        super(model_lstm, self).__init__()
        self.lstm0 = nn.LSTM(input_size=19 ,hidden_size=200,
                             num_layers=1, batch_first=True)

        self.fc0   = nn.Linear(200, 1)

    def forward(self, x):

        out, _ = self.lstm0(x)
        out    = self.fc0(out)

        return out

model = model_lstm()

from torchinfo import summary
summary(model, (64, 1, 19))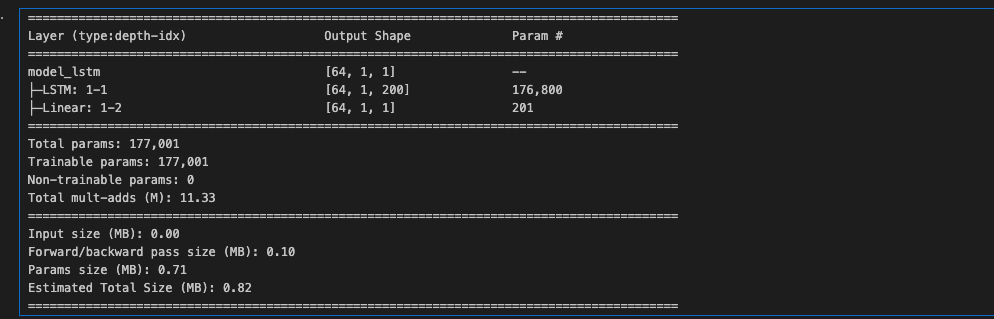
# 训练循环
def train(dataloader, model, loss_fn, optimizer):
    size        = len(dataloader.dataset)  # 训练集的大小
    num_batches = len(dataloader)   # 批次数目, (size/batch_size,向上取整)

    train_loss, train_acc = 0, 0  # 初始化训练损失和正确率

    pred_list = []
    y_list =[]

    for X, y in dataloader:

        X, y = X.to(device), y.to(device)
        # 计算预测误差
        pred = model(X)          # 网络输出
        pred = pred.squeeze()

        y_list    += [i.detach().numpy() for i in y.cpu()]
        pred_list += [i.detach().numpy() for i in pred.cpu()]#

        loss = loss_fn(pred, y)  # 计算网络输出和真实值之间的差距,y为真实值,计算二者差值即为损失

        # 反向传播
        optimizer.zero_grad()  # grad属性归零
        loss.backward()        # 反向传播
        optimizer.step()       # 每一步自动更新

        train_loss += loss.item()

    R2   = metrics.r2_score(y_list, pred_list) #第一个必须是真实值,第二个必须是预测值,否值 R2 可能会为负数

    train_loss /= num_batches

    return R2, train_loss

def test (dataloader, model, loss_fn):
    size        = len(dataloader.dataset)  # 测试集的大小
    num_batches = len(dataloader)          # 批次数目, (size/batch_size,向上取整)
    test_loss, test_acc = 0, 0

    pred_list = []
    y_list =[]

    # 当不进行训练时,停止梯度更新,节省计算内存消耗
    with torch.no_grad():
        for X, y in dataloader:
            X, y = X.to(device), y.to(device)

            pred = model(X)
            pred = pred.squeeze()

            y_list += [i.detach().numpy() for i in y.cpu()]
            pred_list += [i.detach().numpy() for i in pred.cpu()]

            loss = loss_fn(pred, y)

            test_loss += loss.item()

    R2   = metrics.r2_score(y_list, pred_list) #第一个必须是真实值,第二个必须是预测值,否值 R2 可能会为负数
    test_loss /= num_batches

    return R2, test_loss

def adjust_learning_rate(optimizer, epoch, start_lr):
    # 每 5 个epoch衰减到原来的 0.92
    lr = start_lr * (0.92 ** (epoch // 5))
    for param_group in optimizer.param_groups:
        param_group['lr'] = lr

learn_rate = 0.1 # 初始学习率
optimizer  = torch.optim.Adam(model.parameters(), lr=learn_rate)


import torch.nn.functional as F

loss_fn    = nn.MSELoss()
epochs     = 50

train_loss = []
train_R2   = []
test_loss  = []
test_R2    = []

for epoch in range(epochs):
    # 更新学习率(使用自定义学习率时使用)
    adjust_learning_rate(optimizer, epoch, learn_rate)

    model.train()
    epoch_train_R2, epoch_train_loss = train(train_dataloader, model, loss_fn, optimizer)

    model.eval()
    epoch_test_R2, epoch_test_loss = test(test_dataloader, model, loss_fn)

    train_R2.append(epoch_train_R2)
    train_loss.append(epoch_train_loss)
    test_R2.append(epoch_test_R2)
    test_loss.append(epoch_test_loss)

    # 获取当前的学习率
    lr = optimizer.state_dict()['param_groups'][0]['lr']

    template = ('Epoch:{:2d}, Train_R2:{:.3f}, Train_loss:{:.3f}, Test_R2:{:.4f}, Test_loss:{:.3f}, Lr:{:.2E}')
    print(template.format(epoch+1, epoch_train_R2, epoch_train_loss,epoch_test_R2, epoch_test_loss, lr))
print('Done')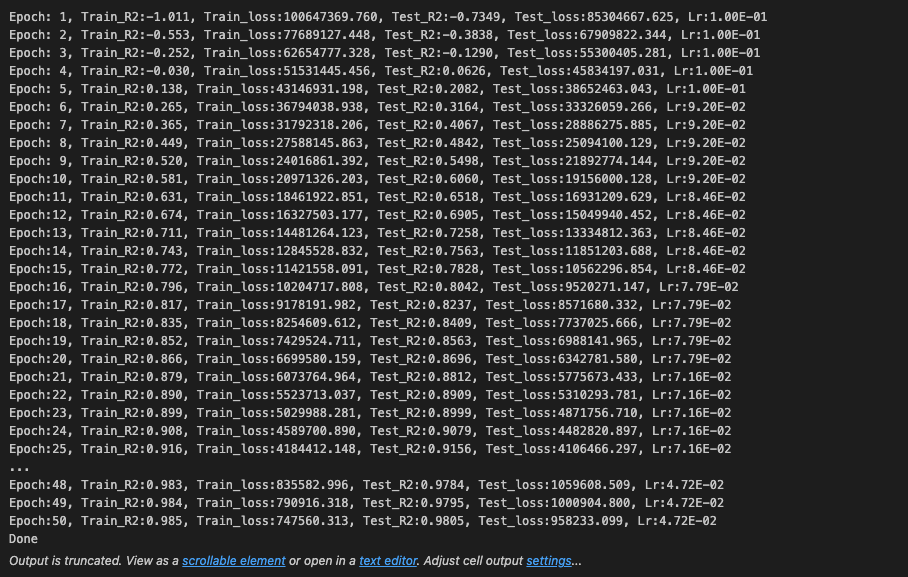
import matplotlib.pyplot as plt
#隐藏警告
import warnings
warnings.filterwarnings("ignore")                    #忽略警告信息
plt.rcParams['font.sans-serif']   = ['SimHei']      # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False           # 用来正常显示负号
plt.rcParams['figure.dpi']        = 100             #分辨率

from datetime import datetime
current_time = datetime.now() # 获取当前时间

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_R2, label='Training Accuracy')
plt.plot(epochs_range, test_R2, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()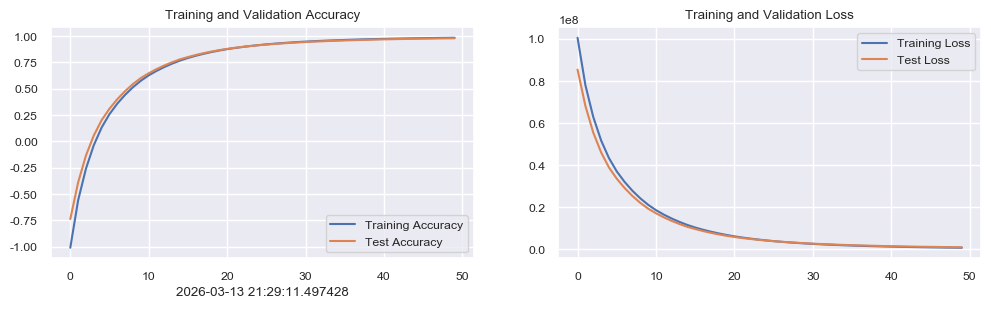
小结
数据探索,预处理必不可少

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 6
 0
- 0


 已为社区贡献6条内容

所有评论(0)