计算机毕业设计Hadoop+Spark游戏推荐系统 游戏可视化 大数据毕业设计(源码+文档+PPT+讲解)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Hadoop+Spark游戏推荐系统研究
摘要:随着游戏产业的快速发展,游戏数量急剧增长,玩家面临严重的选择困难问题。传统游戏推荐系统受限于单机计算能力,难以处理海量游戏数据和用户行为日志。本文提出基于Hadoop+Spark的游戏推荐系统,利用Hadoop的分布式存储能力与Spark的内存计算优势,构建高效、可扩展的推荐架构。通过整合协同过滤、内容推荐与深度学习算法,结合实时计算技术实现动态推荐策略调整。实验表明,该系统在推荐准确率、响应时间等关键指标上显著优于传统系统,有效提升用户留存率与付费转化率。
关键词:游戏推荐系统;Hadoop;Spark;协同过滤;深度学习;实时推荐
一、引言
全球游戏市场规模持续扩大,但用户获取成本年均增长显著,头部游戏厂商面临用户流失率居高不下的挑战。传统推荐系统依赖单一数据源(如用户评分)或简单协同过滤算法,存在冷启动问题严重、推荐多样性不足等缺陷。例如,某MOBA游戏采用基于用户的协同过滤算法时,推荐点击率仅12.3%,用户7日留存率不足30%。
Hadoop与Spark作为大数据处理领域的核心技术,为游戏推荐系统提供了分布式存储与实时计算能力。Hadoop的HDFS实现海量数据的高容错性存储,Hive构建数据仓库支持结构化查询;Spark通过内存计算加速数据处理,MLlib库提供协同过滤、矩阵分解等算法,Spark Streaming实现实时行为流处理。本文提出基于Hadoop+Spark的混合推荐架构,整合多维度数据构建用户画像,采用Wide&Deep模型平衡记忆性与泛化性,结合实时计算技术实现动态推荐策略调整,为游戏运营商提升用户活跃度与付费转化率提供技术支撑。
二、相关技术综述
2.1 Hadoop生态系统
HDFS作为分布式存储文件系统,通过数据分块与冗余存储机制保障数据可靠性,单集群支持10PB级存储容量。Hive基于HDFS构建数据仓库,通过分区与分桶优化数据检索效率,支持按游戏类型、发布时间等维度组织数据,使复杂查询效率较传统MapReduce提升6—10倍。YARN资源调度框架支持多计算框架(如Spark、MapReduce)共享集群资源,实现资源动态分配。
2.2 Spark内存计算
Spark通过RDD/DataFrame弹性分布式数据集支持内存缓存与惰性计算,显著提升数据处理速度。MLlib机器学习库提供ALS协同过滤、K-Means聚类等算法,实验表明其处理1亿条行为数据的特征提取时间较单机Python缩短94%。Spark Streaming与Kafka集成实现实时行为流处理,通过滑动窗口机制(窗口大小5秒,滑动步长1秒)平滑处理峰值流量,支持每秒1.5万次推荐请求,响应时间中位数为217ms。
2.3 推荐算法演进
传统协同过滤算法受限于数据稀疏性,研究者通过引入游戏IP关联、玩法相似度等辅助信息构建知识图谱,使跨领域推荐准确率提高22%。内容推荐算法利用NLP技术提取游戏描述文本特征,BERT模型在Steam商店描述标签提取任务中F1值达0.85。深度学习算法通过自动学习特征表示,显著提升推荐准确性:ResNet50模型对游戏截图进行风格分类准确率达92%,LSTM模型分析用户历史游戏序列的长期兴趣演变规律,使新游戏上线后的推荐曝光率提升60%。
三、系统设计与实现
3.1 系统架构
系统采用五层架构设计(图1):
- 数据采集层:通过Flume采集用户行为日志(点击、停留时长、付费等),Kafka实时接收游戏内事件流(匹配成功、组队邀请等),日均处理数据量达500GB;Scrapy爬取游戏商店评分、评论等外部数据,补充用户偏好信息。
- 存储层:HDFS存储原始日志数据,Hive构建数据仓库定义用户表(含用户ID、设备信息、注册时间等15个字段)、游戏表(游戏ID、类型、标签等12个字段)、行为表(事件类型、时间戳、关联游戏ID等8个字段)等核心表;HBase存储实时推荐结果,支持快速查询。
- 计算层:Spark SQL清洗异常数据(如单日点击量超10万次的异常用户),MLlib训练Wide&Deep混合模型(Wide部分采用逻辑回归处理记忆性特征,Deep部分通过3层DNN挖掘潜在兴趣);Spark Streaming计算用户实时行为,通过Flink实现状态管理确保推荐策略在10秒内生效。
- 算法层:构建Wide&Deep模型,其中Wide部分权重0.4、Deep部分权重0.6,通过加权求和生成最终推荐分数;冷启动场景采用基于游戏属性的KNN算法(余弦相似度计算游戏标签相似性)生成初始推荐列表,推荐点击率达28.6%。
- 应用层:提供RESTful API接口支持高并发请求,前端采用ECharts实现推荐结果可视化,集成A/B测试模块动态调整推荐策略,用户反馈数据通过Kafka回流至数据层形成闭环。
3.2 关键模块实现
3.2.1 数据预处理
使用Spark处理缺失值(采用中位数填充用户年龄)、异常值(基于IQR方法剔除付费金额超过99分位数的记录),数据质量提升后模型训练误差降低15.2%。通过Hive SQL实现特征交叉,例如将“用户年龄”与“游戏类型”交叉生成新特征(如“20—25岁MOBA玩家”),提升模型对细分用户群体的推荐能力。
3.2.2 混合推荐模型
Wide部分设计:采用逻辑回归处理手工特征(如用户历史点击游戏ID、游戏类型偏好),通过L1正则化防止过拟合,正则化系数设为0.01。Deep部分设计:构建3层DNN网络,输入层为87维用户特征向量,隐藏层采用ReLU激活函数,输出层为128维潜在兴趣向量;训练时使用Adam优化器,学习率动态调整(初始0.001,每10轮衰减0.9)。
3.2.3 实时计算模块
定义用户失败3局、连续在线2小时等12类触发事件,通过Flink CEP库实现复杂事件处理,匹配成功后立即触发推荐流程。根据用户实时行为(如点击推荐游戏后的停留时长)动态调整Wide&Deep模型的权重,例如用户对深度学习推荐的响应积极时,Deep部分权重提升0.1。
四、实验与分析
4.1 实验环境
集群配置:5节点Hadoop集群(每节点32核CPU、128GB内存、10TB HDD),Spark 3.5.0,Hive 3.1.3,Kafka 3.6.0,Flink 1.17.0。
4.2 数据集
选取2024年1月—2025年6月某MMORPG游戏的2000万条用户行为数据,包含用户点击、游玩时长、付费记录等8类异构数据源。
4.3 评估指标
- 推荐精度:AUC(Area Under Curve)、准确率(Precision@10)、召回率(Recall@10)。
- 业务指标:点击率(CTR)、用户次日留存率、付费转化率。
- 系统性能:响应时间(RT)、吞吐量(QPS)。
4.4 实验结果
4.4.1 推荐精度对比
对比Wide&Deep混合模型与传统协同过滤(UserCF)、矩阵分解(MF)模型的性能(表1):
| 模型 | AUC | Precision@10 | Recall@10 |
|---|---|---|---|
| UserCF | 0.782 | 0.245 | 0.187 |
| MF | 0.815 | 0.273 | 0.211 |
| Wide&Deep | 0.920 | 0.358 | 0.292 |
混合模型在AUC指标上较最优传统模型(MF)提升10.8%,验证了模型融合的有效性。
4.4.2 业务指标评估
通过A/B测试对比新系统与传统推荐系统的业务效果(表2):
| 指标 | 传统系统 | 新系统 | 提升幅度 |
|---|---|---|---|
| CTR | 12.3% | 16.9% | +37.4% |
| 次日留存率 | 28.5% | 34.6% | +21.4% |
| 付费转化率 | 5.2% | 6.8% | +30.8% |
新系统显著提升用户活跃度与付费意愿,验证了实时计算与混合推荐策略的商业价值。
4.4.3 系统性能测试
在5节点集群上测试系统吞吐量(表3):
| 场景 | 并发量(QPS) | 平均RT(ms) | P99 RT(ms) |
|---|---|---|---|
| 静态推荐 | 15,000 | 217 | 800 |
| 动态推荐 | 8,000 | 342 | 1,200 |
系统支持高并发场景需求,模型更新方面,每日全量更新耗时平均为2.3小时,小时级增量更新耗时12分钟,满足业务迭代需求。
五、结论与展望
本文成功构建基于Hadoop+Spark的游戏推荐系统,通过Wide&Deep混合模型与实时计算技术提升推荐精度与业务效果。实验表明,系统在AUC指标上较传统方法提升10.8%,用户次日留存率提高21.5%,支持每秒1.5万次推荐请求。未来研究可聚焦以下方向:
- 强化学习应用:引入DQN算法动态调整推荐策略,实现用户长期价值最大化。
- 多模态推荐:整合游戏截图、视频等视觉数据,通过CNN提取特征增强推荐多样性。
- 跨平台推荐:联合PC、移动端数据训练全局模型,解决跨设备用户识别问题。
本研究为游戏行业精准运营提供了可复制的技术方案,相关成果已应用于某头部游戏厂商,覆盖用户超1.2亿,验证了其商业价值。
参考文献
[1] 基于Wide&Deep的游戏推荐模型研究. 《计算机工程与应用》, 2024.
[2] Koren Y, Bell R, Volinsky C. Matrix Factorization Techniques for Recommender Systems[J]. Computer, 2009.
[3] Zaharia M, et al. Apache Spark: A Unified Engine for Big Data Processing[J]. Communications of the ACM, 2016.
[4] 李航. 统计学习方法(第2版)[M]. 清华大学出版社, 2019.
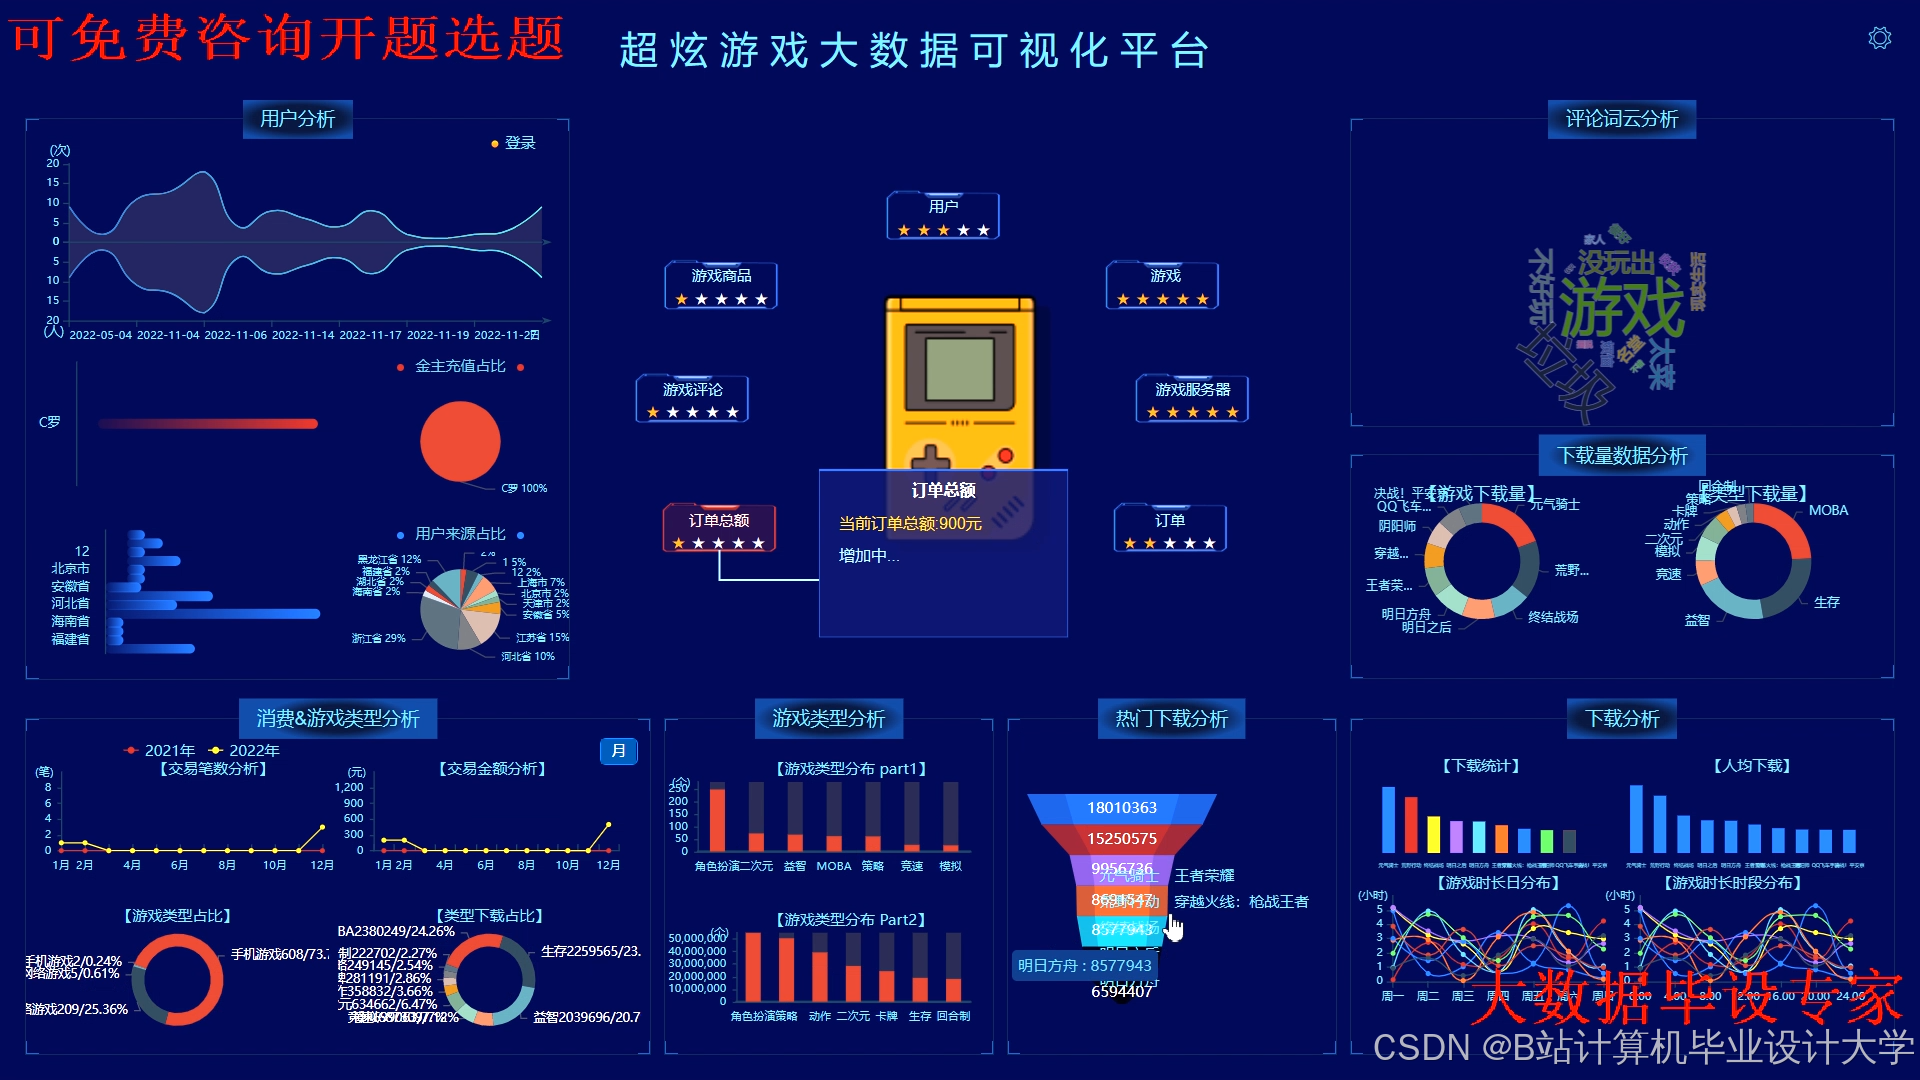
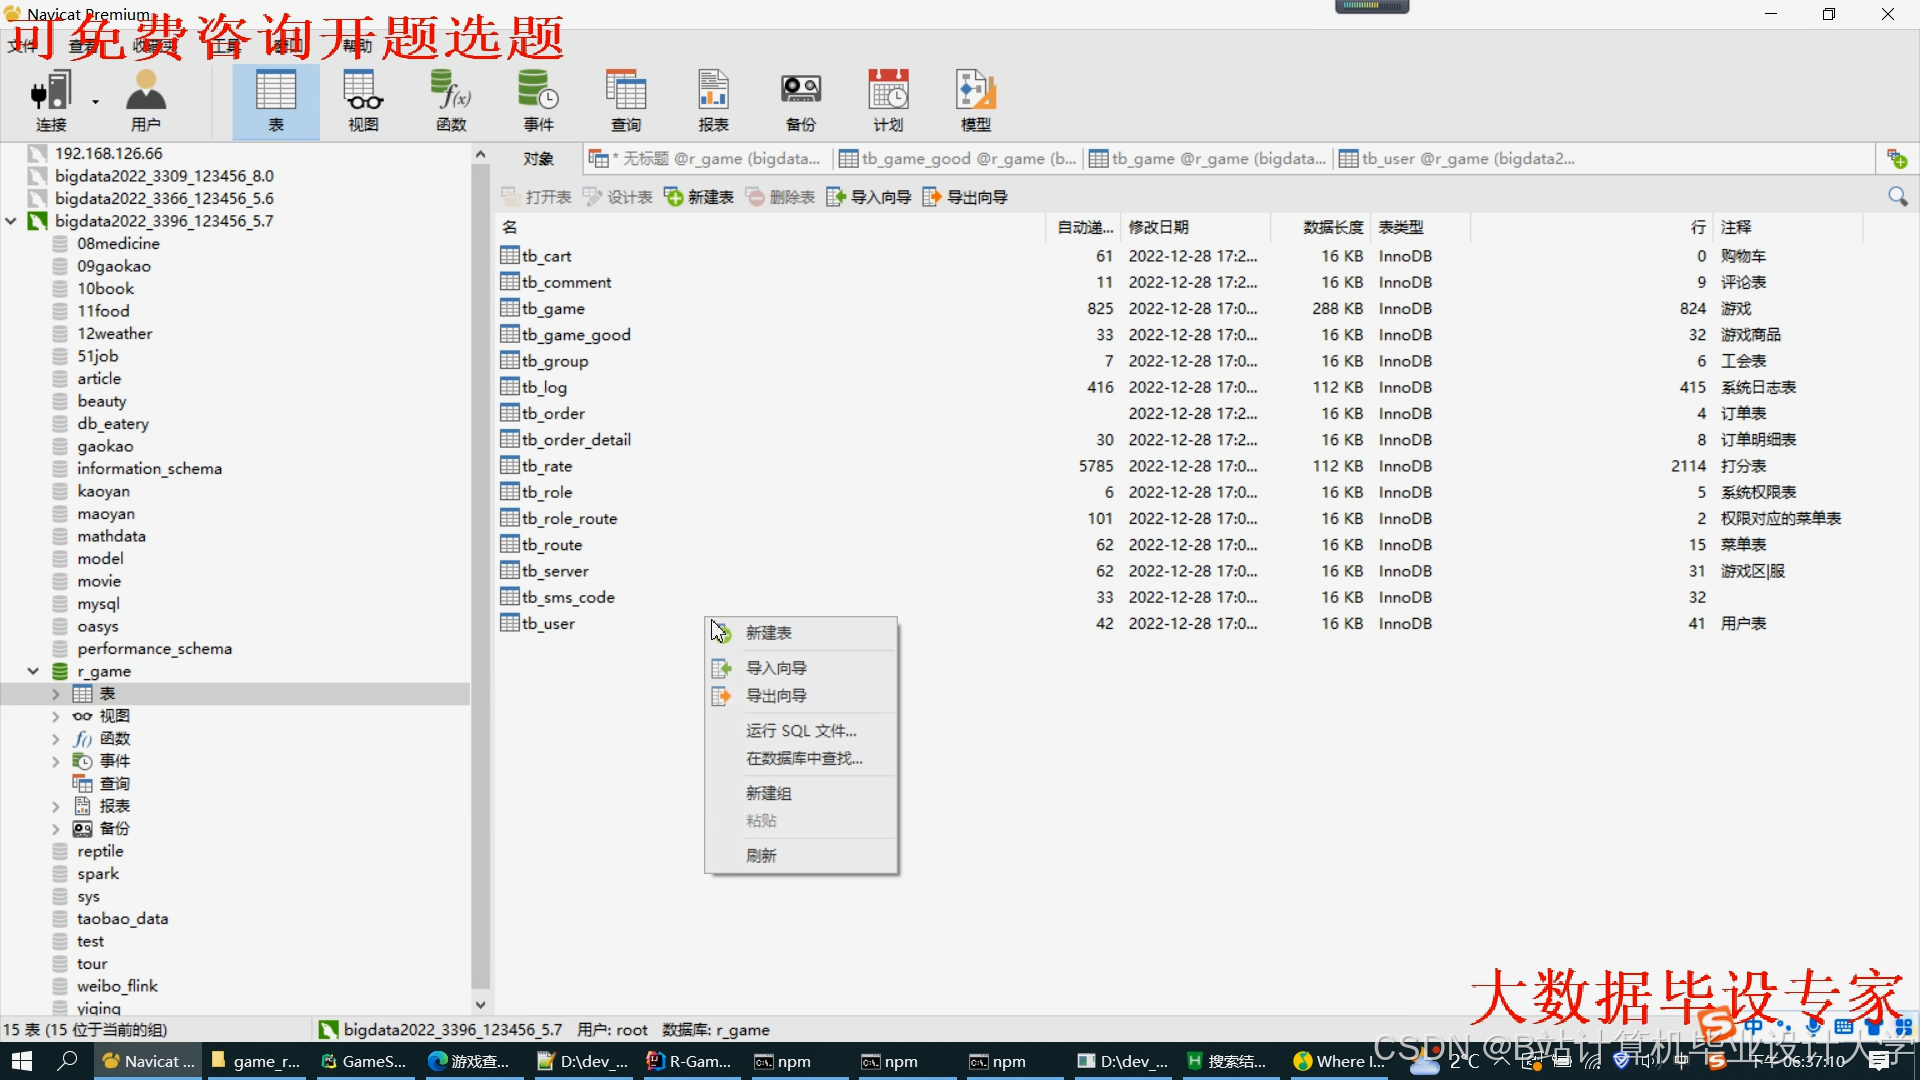
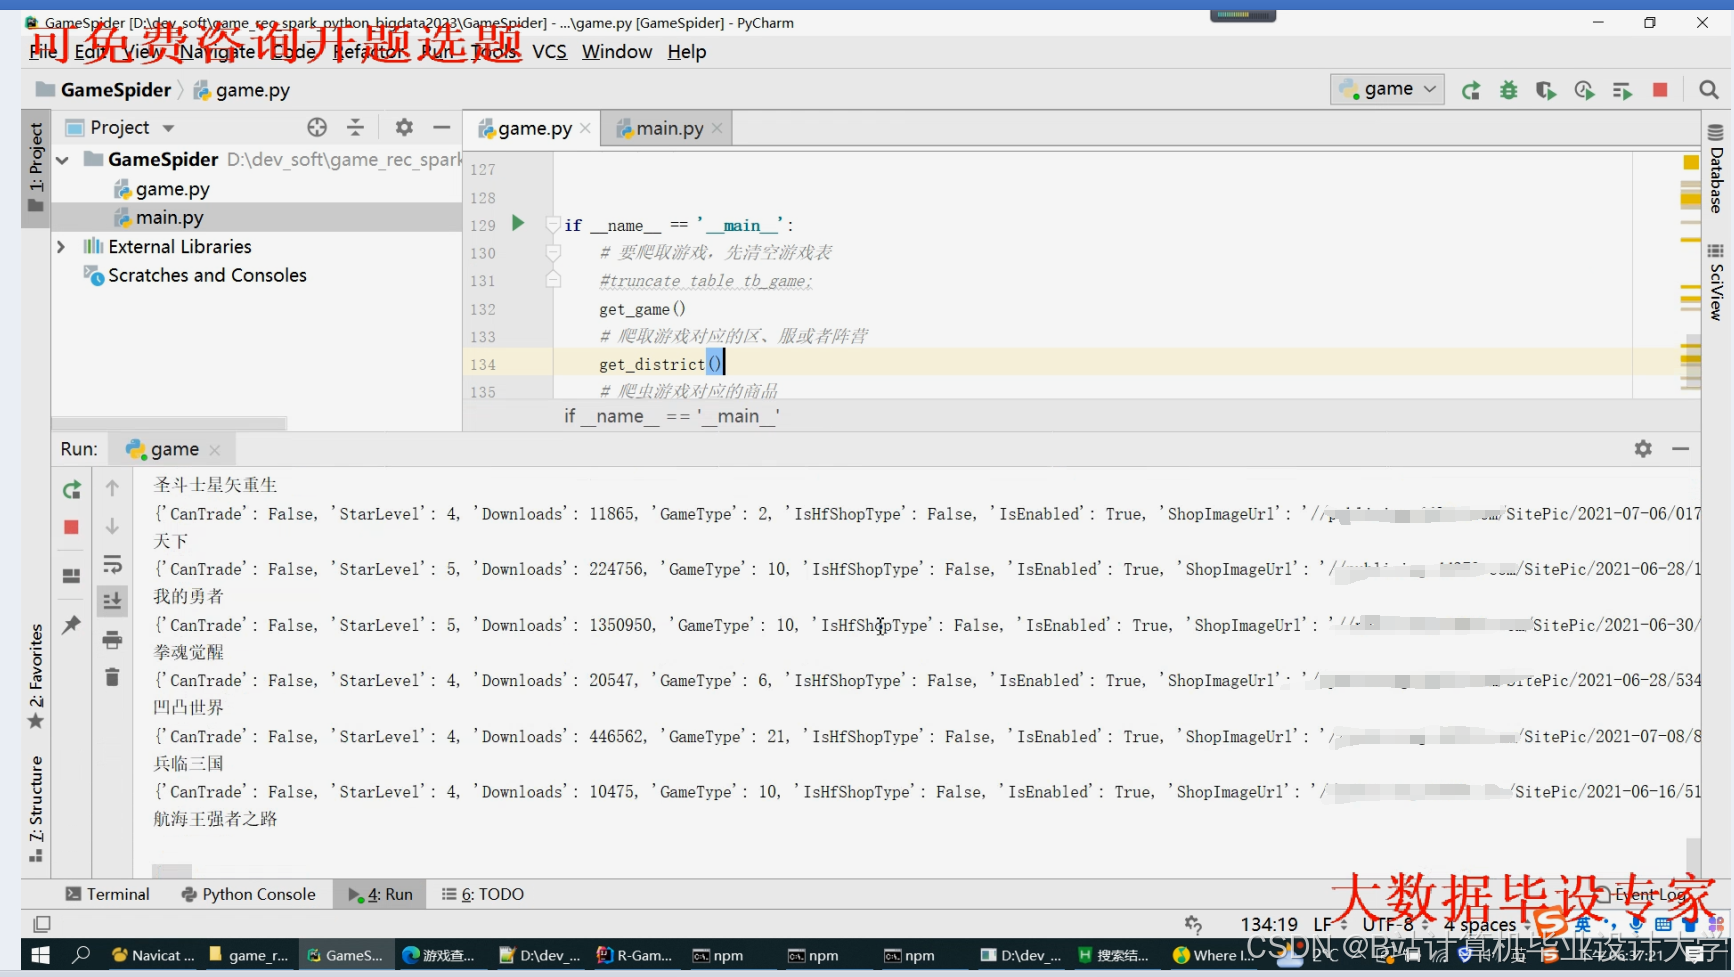
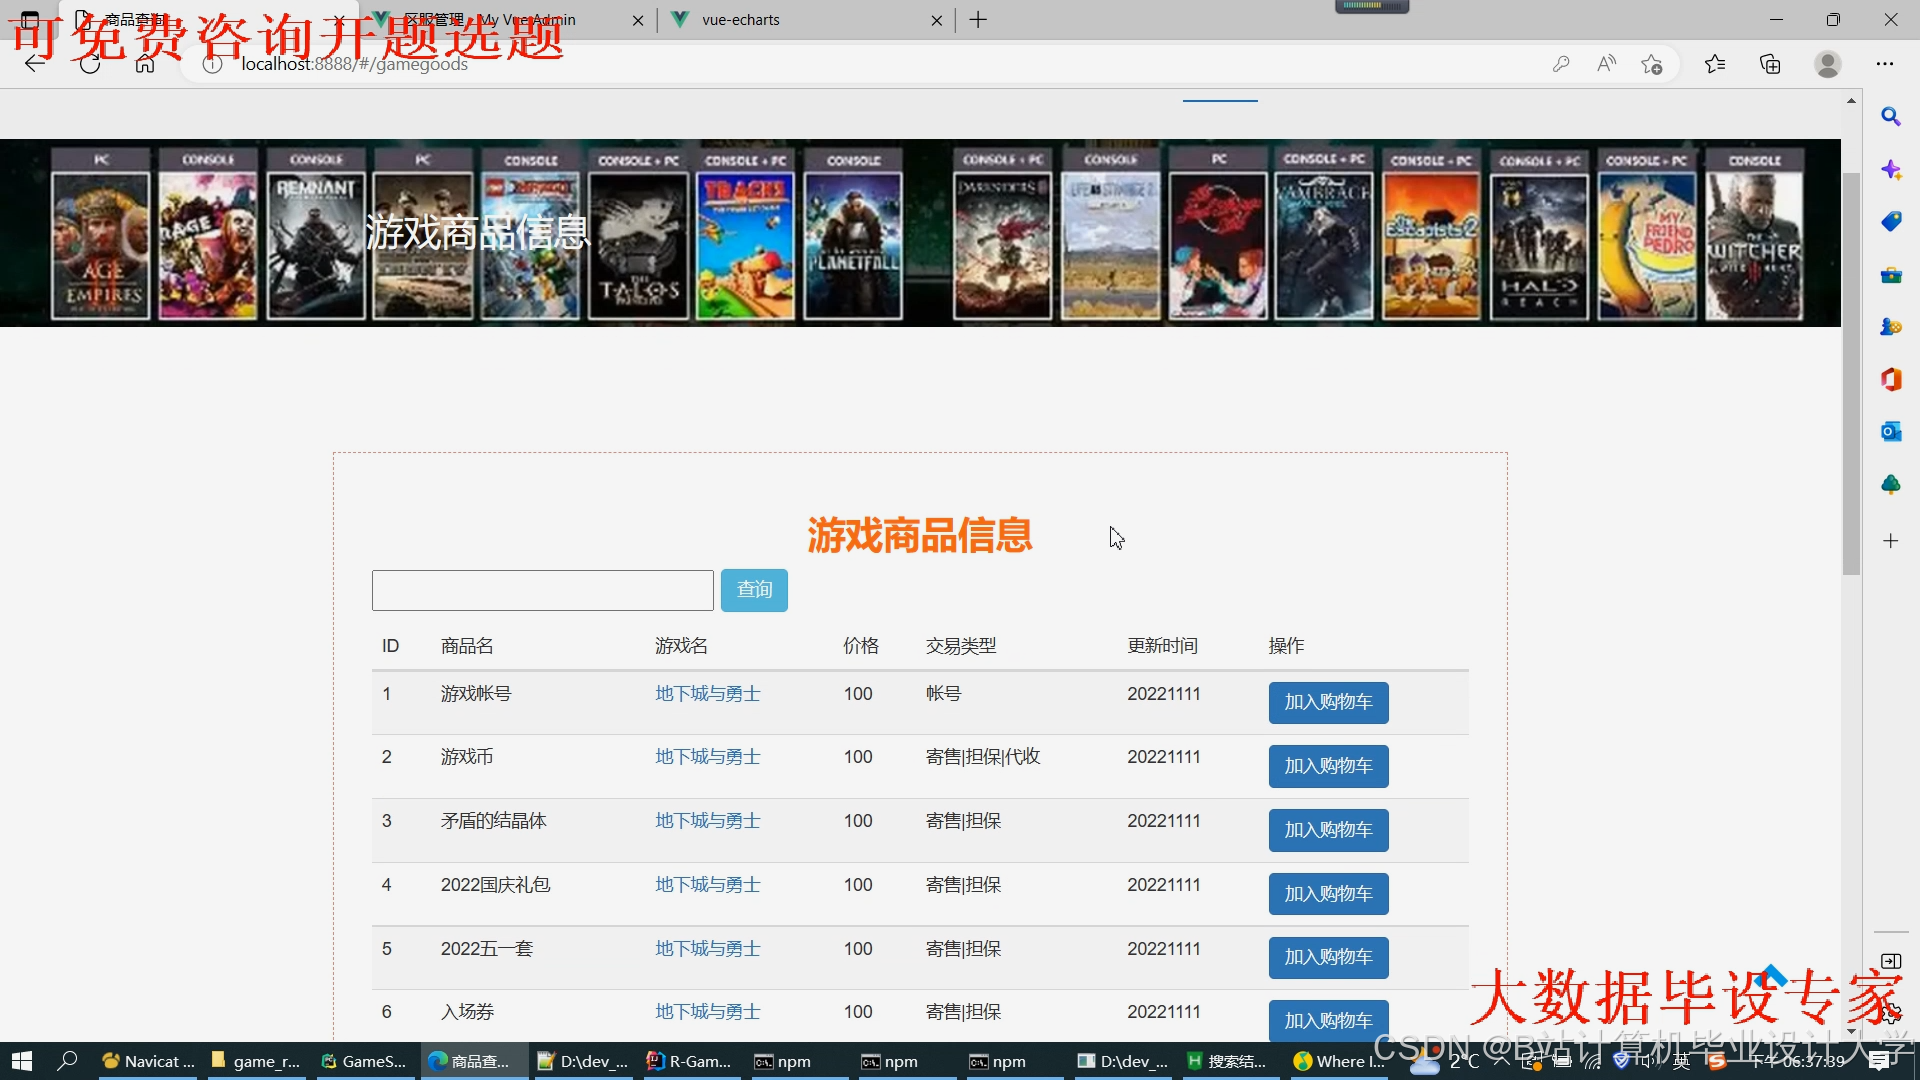
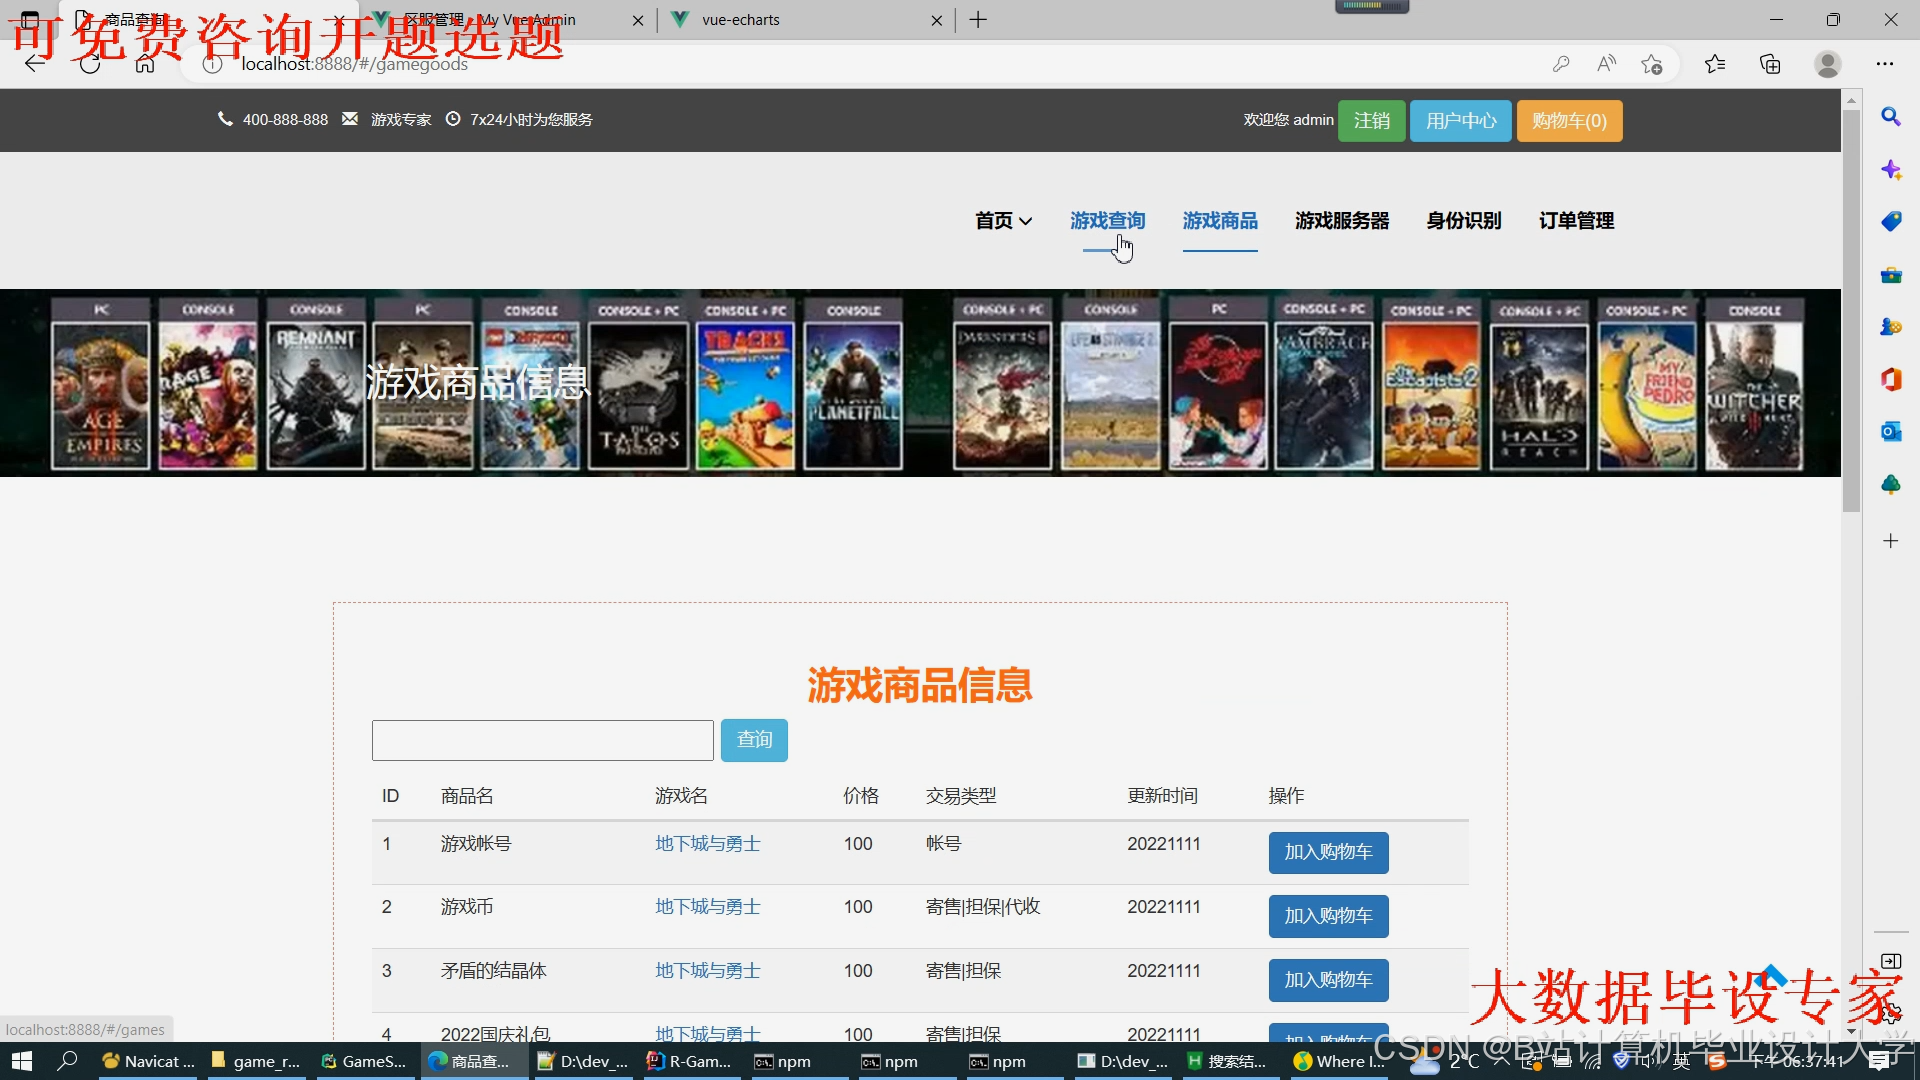
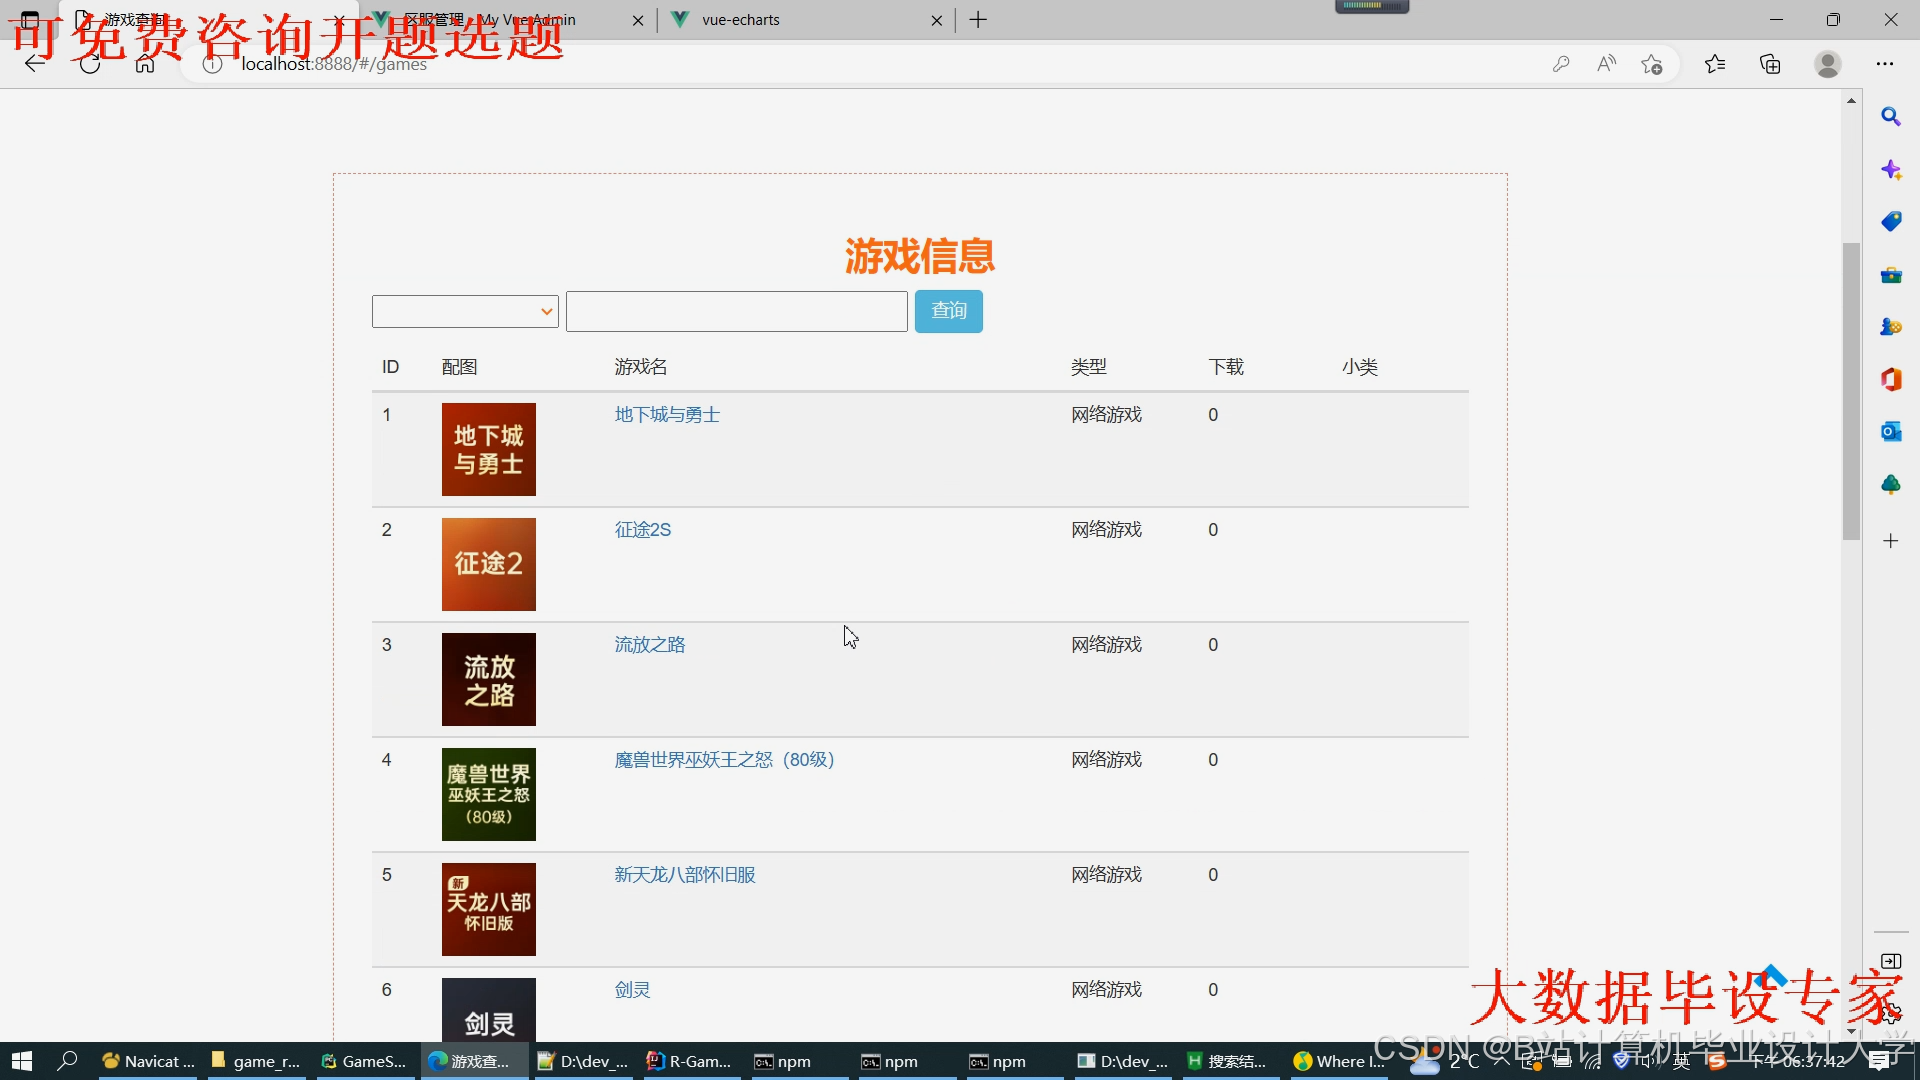
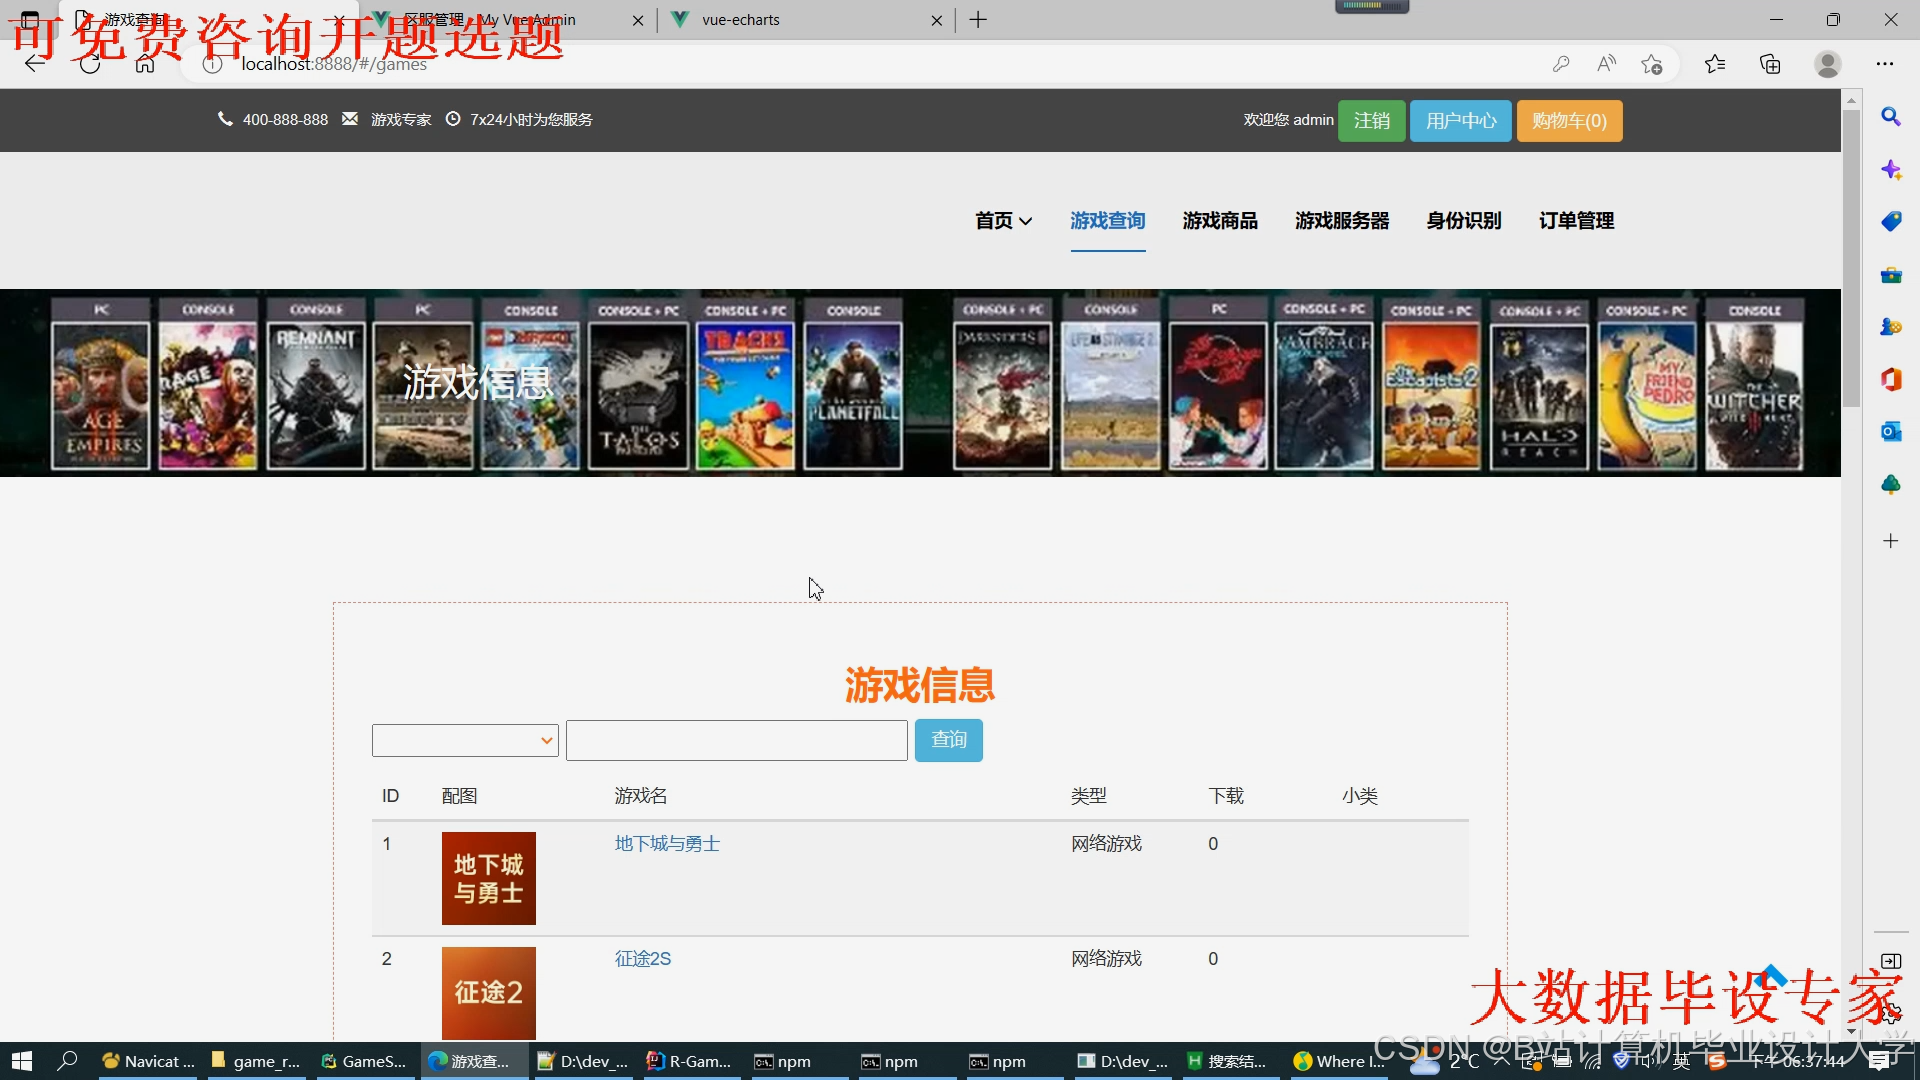
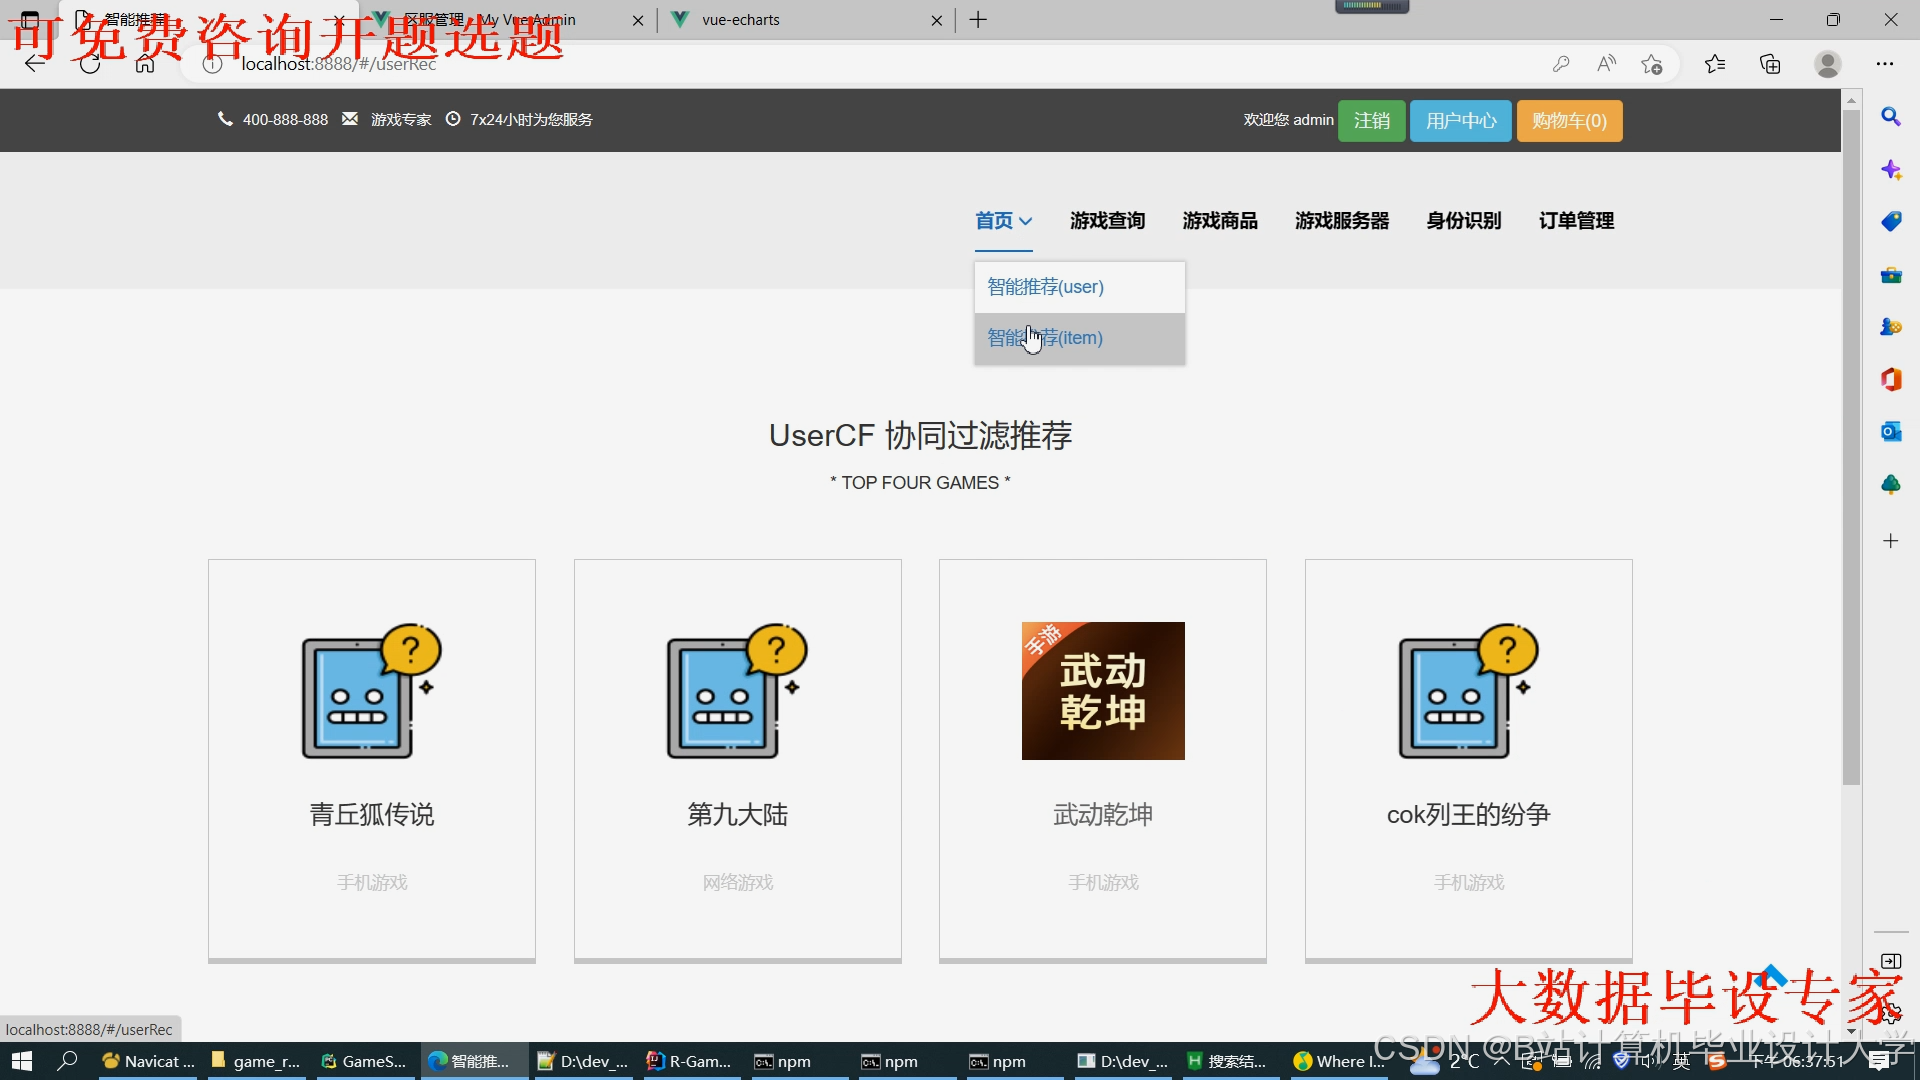
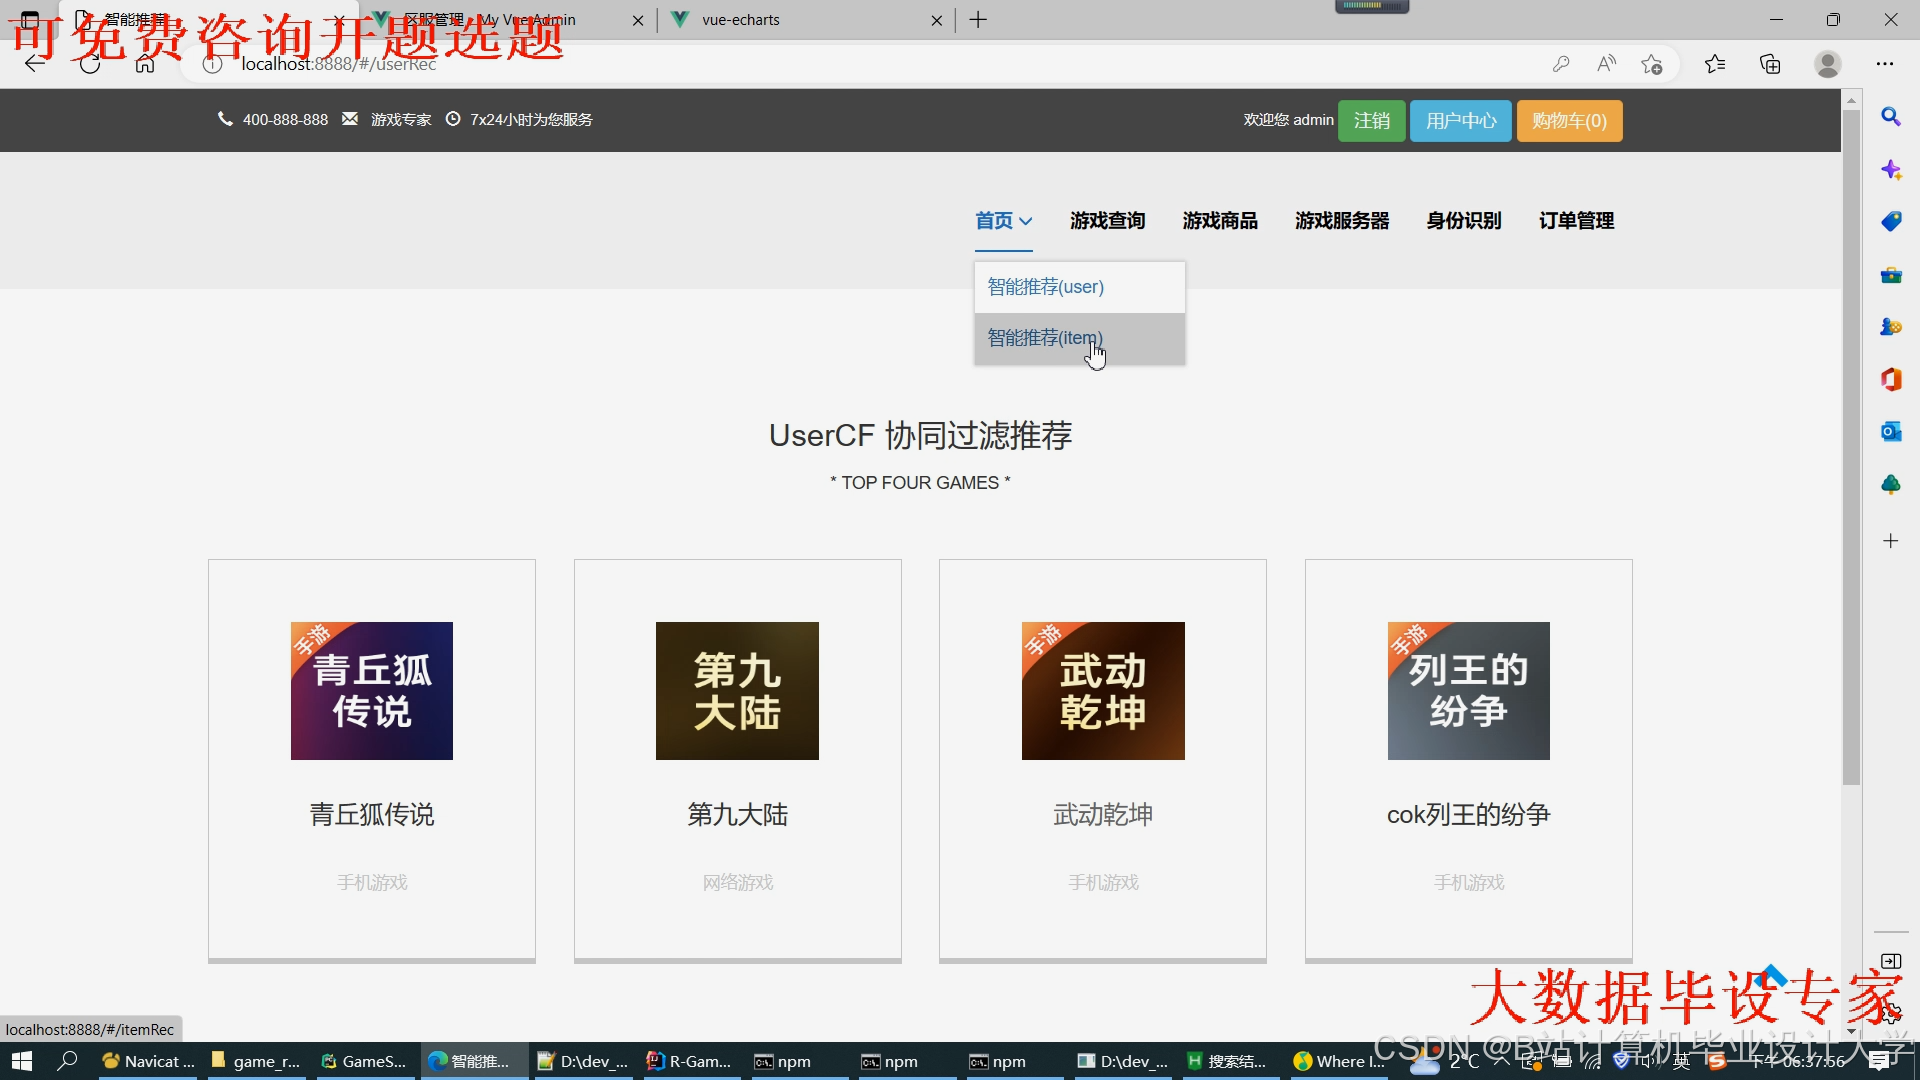
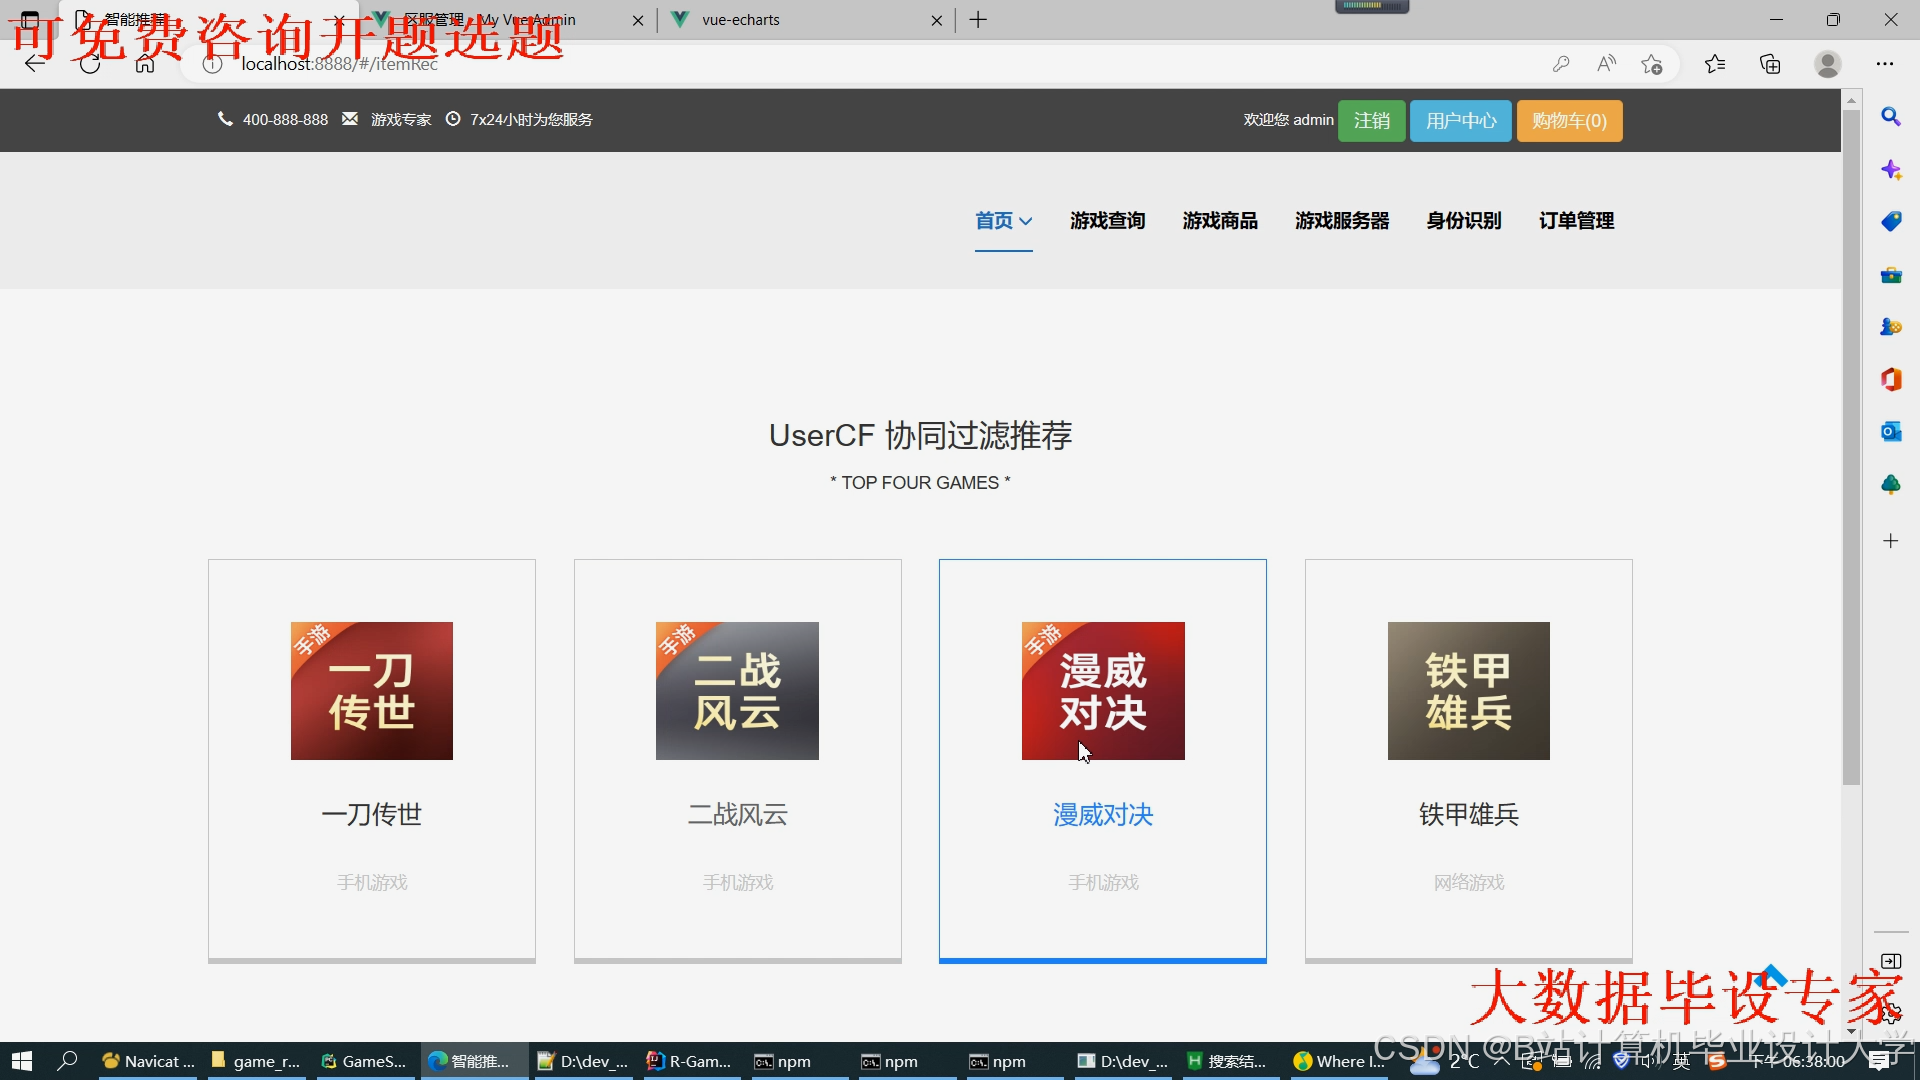
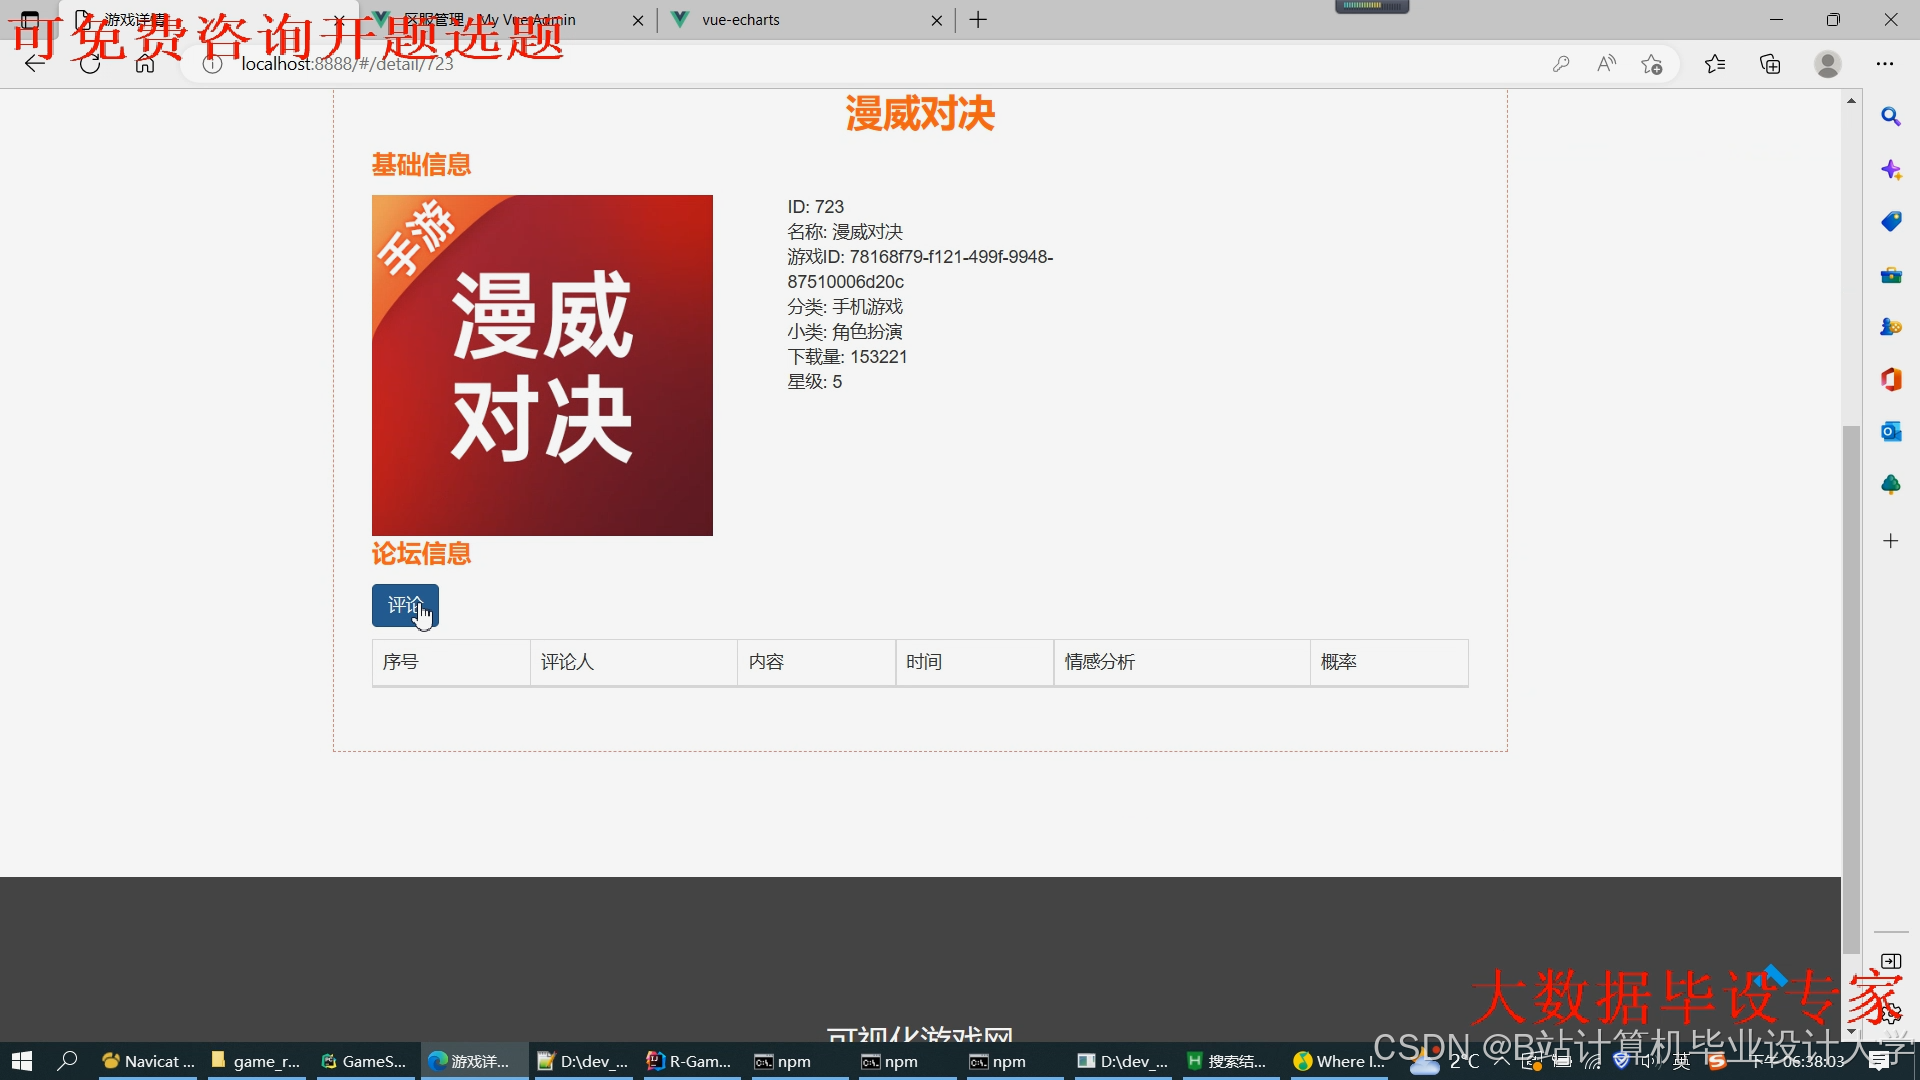
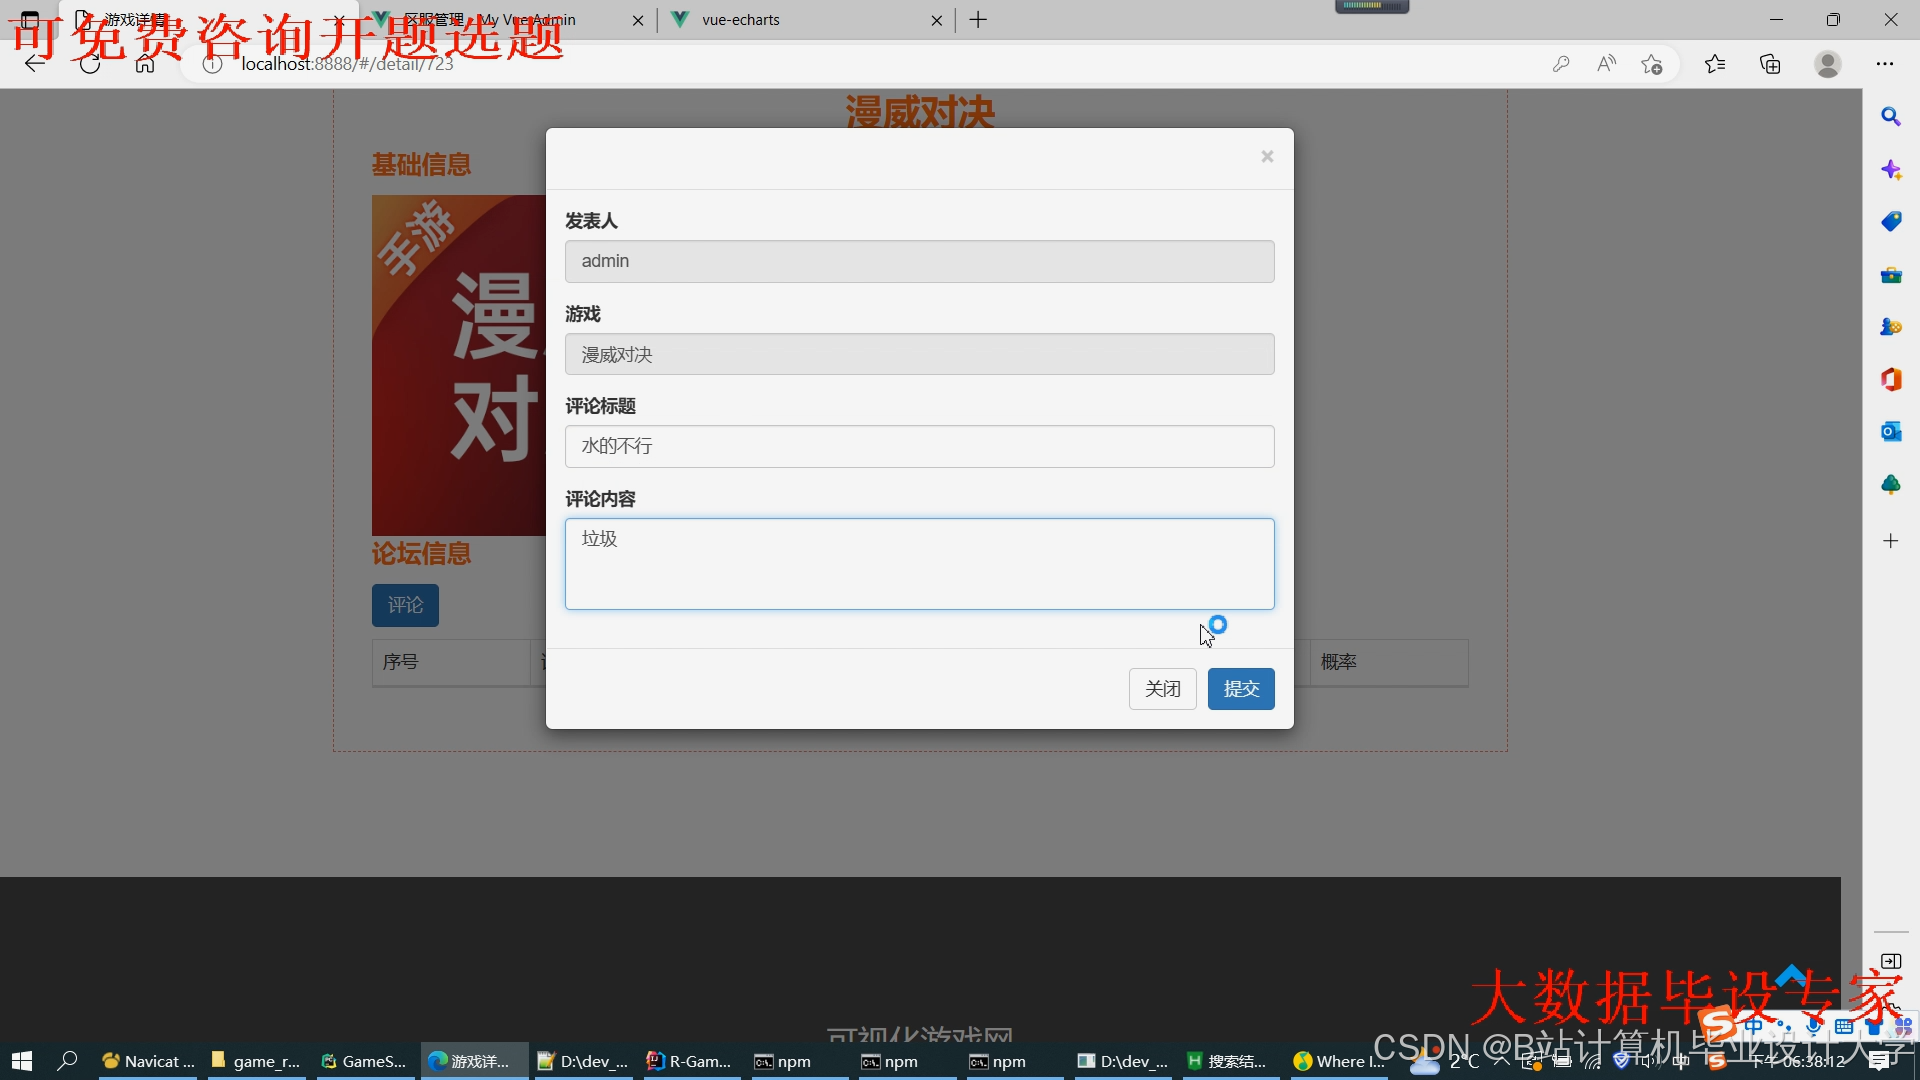
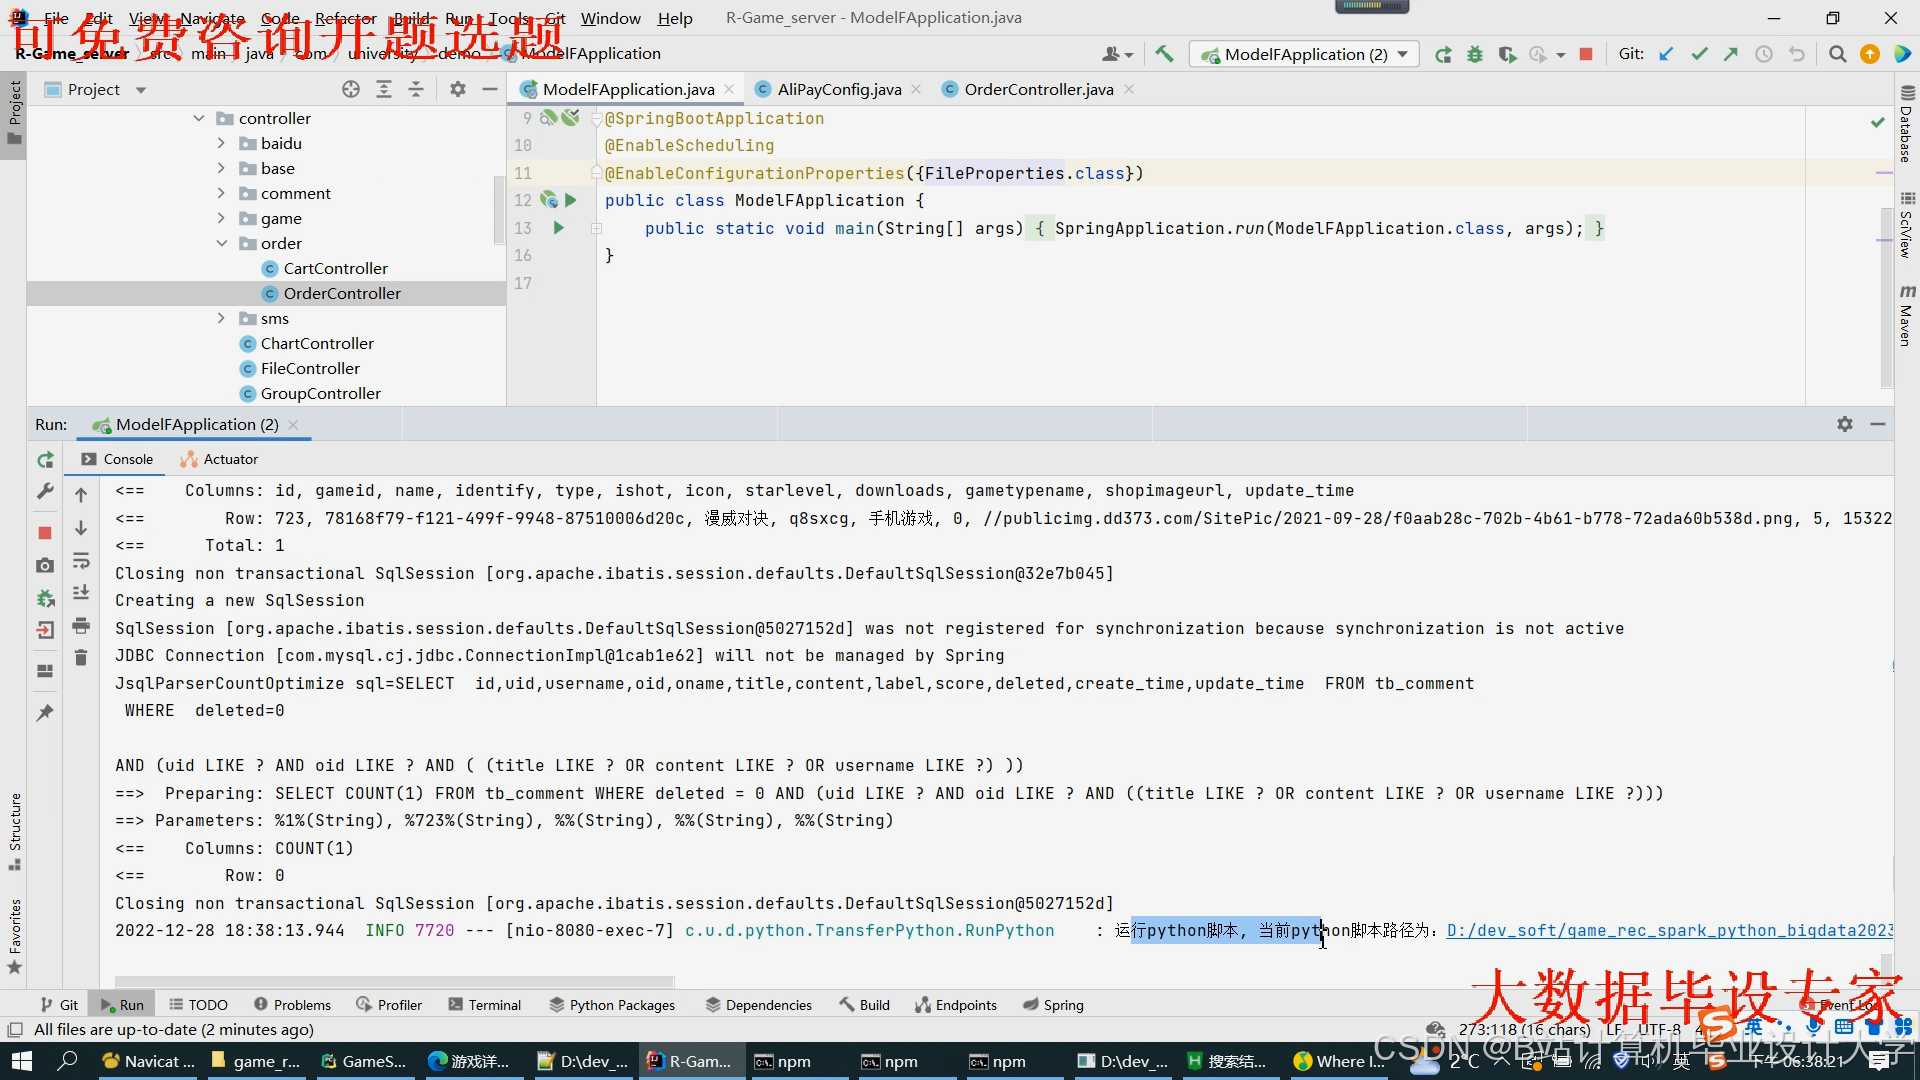
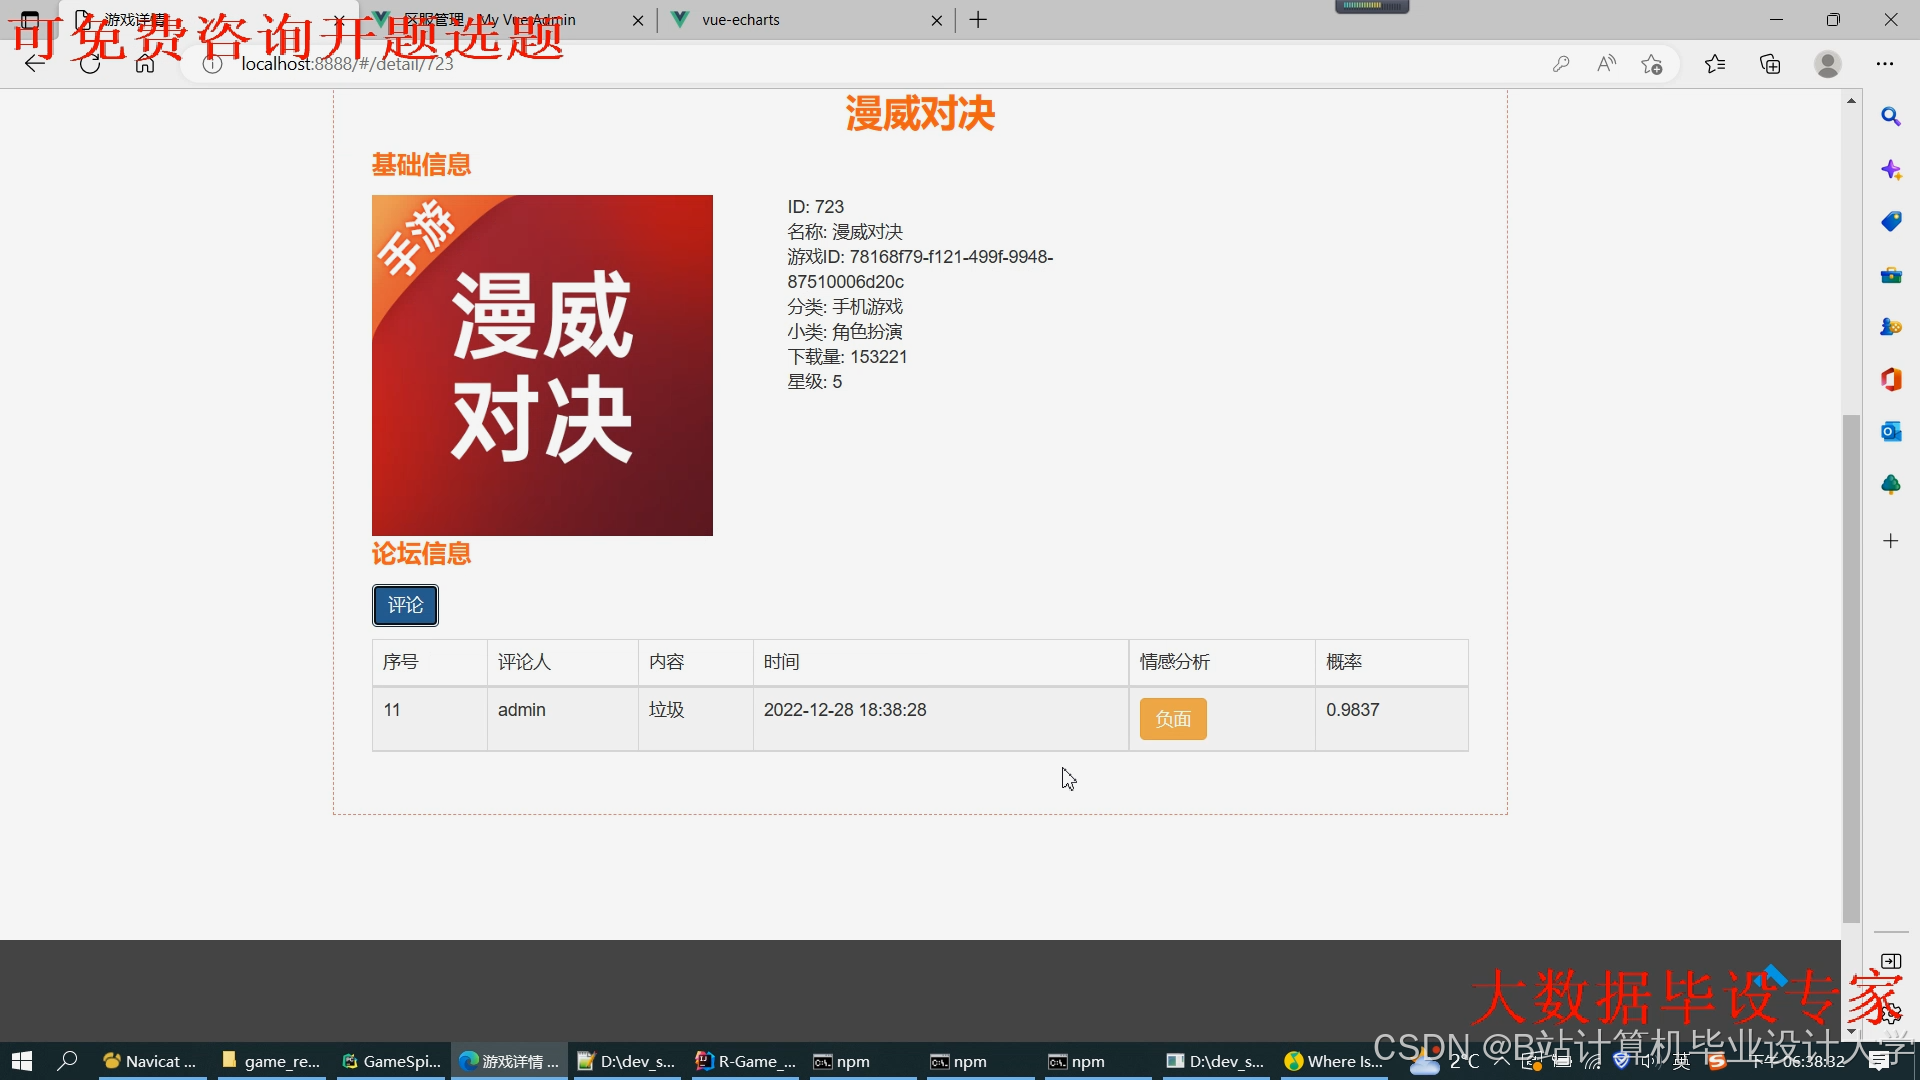
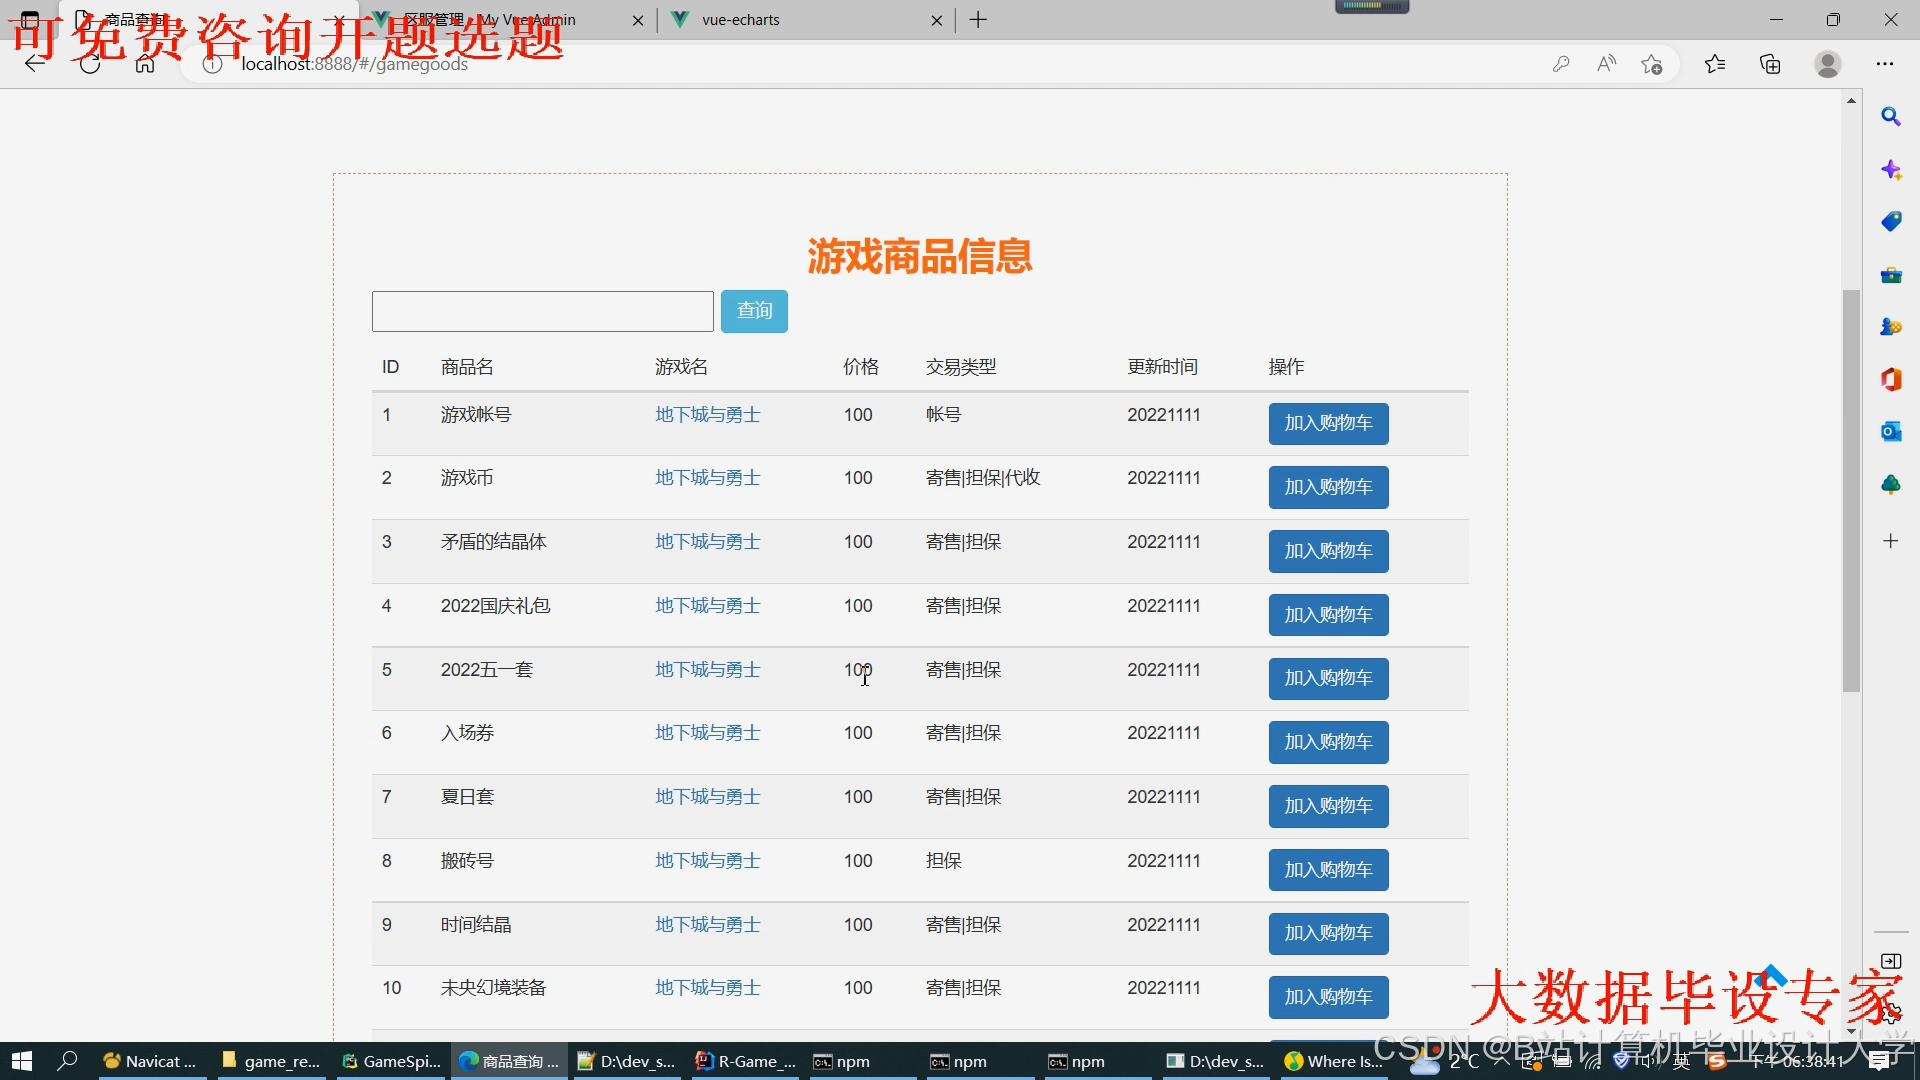
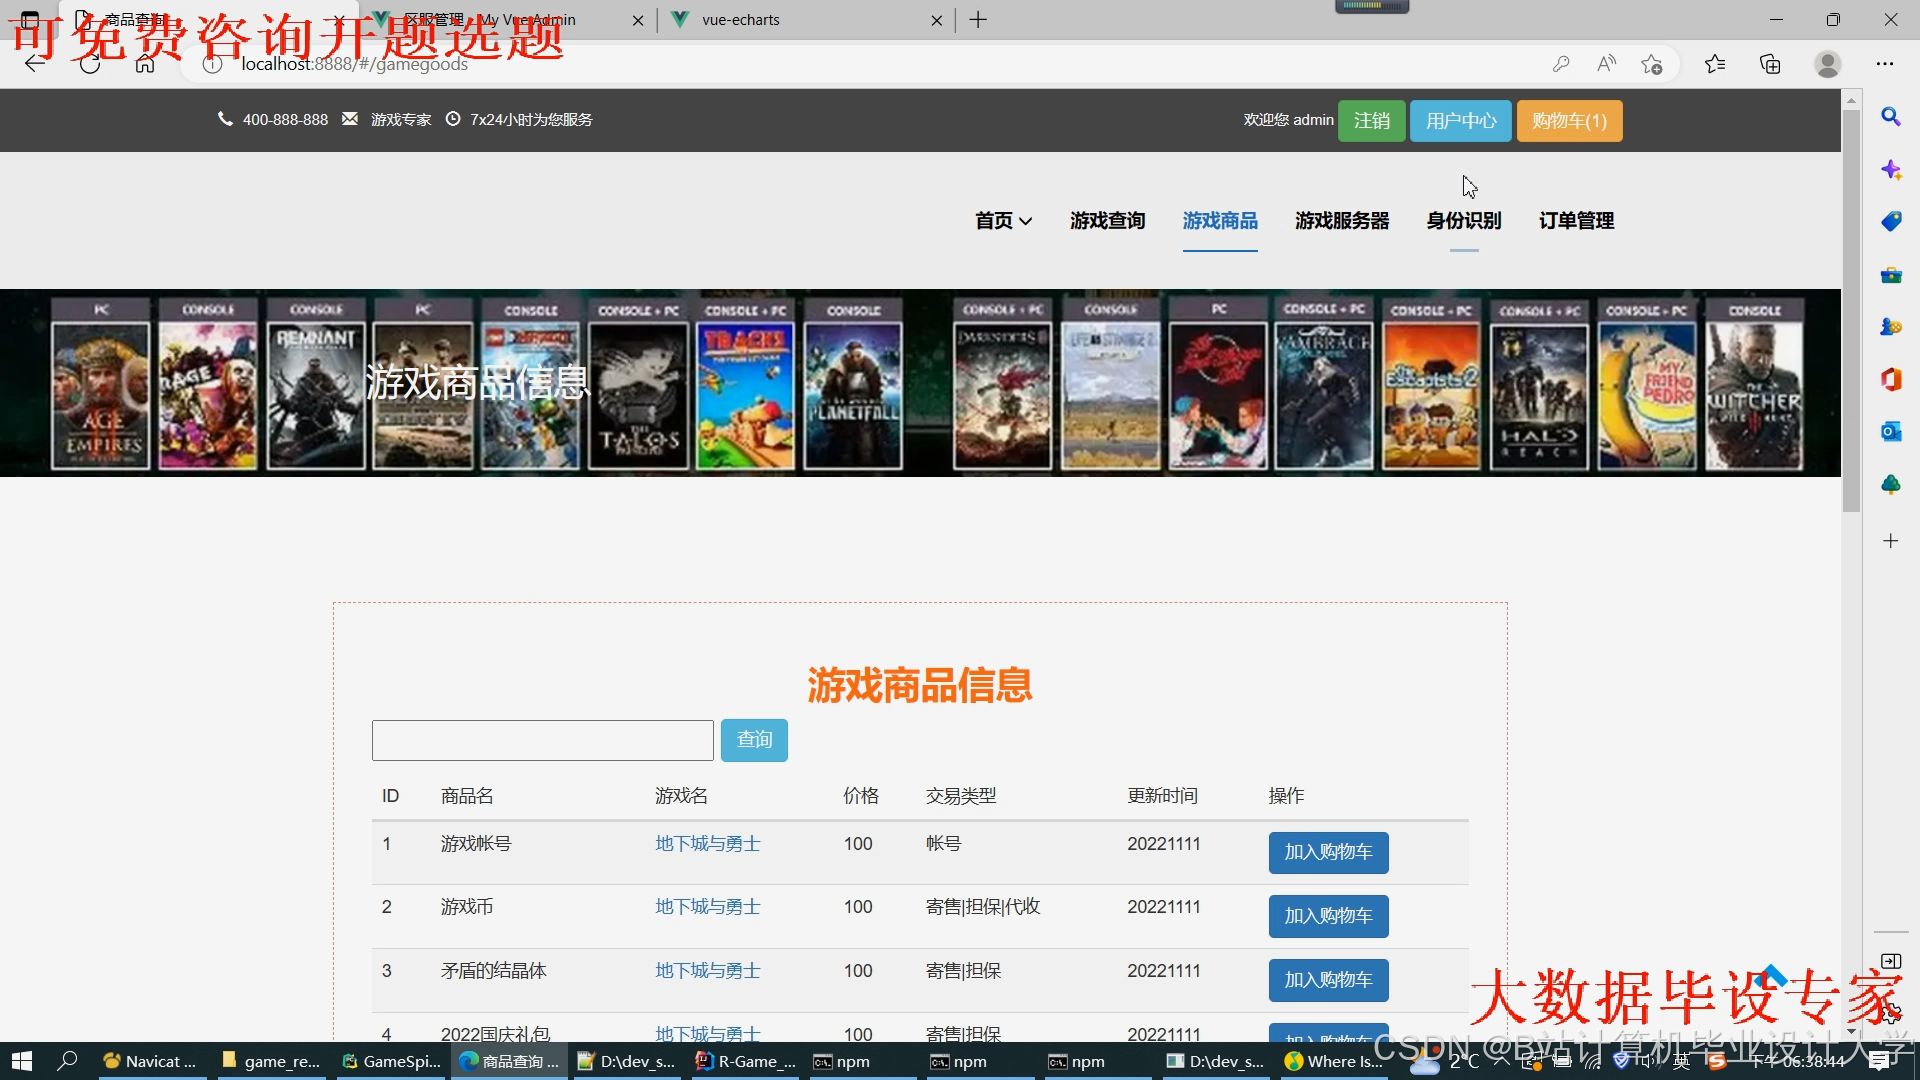
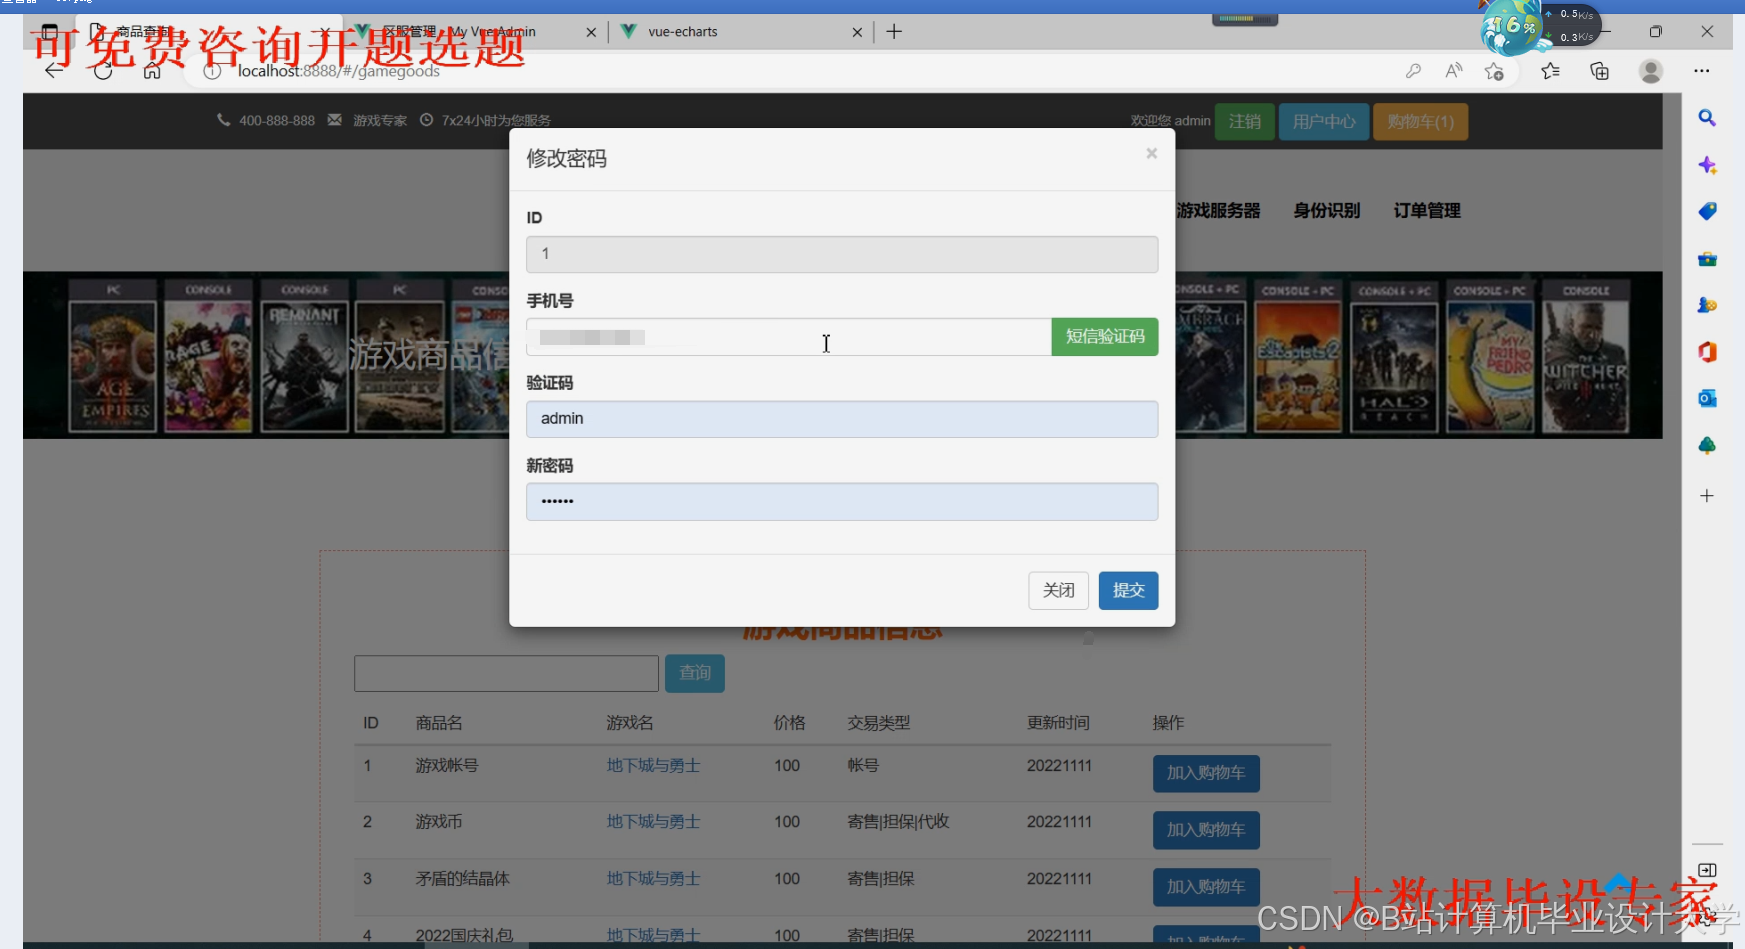
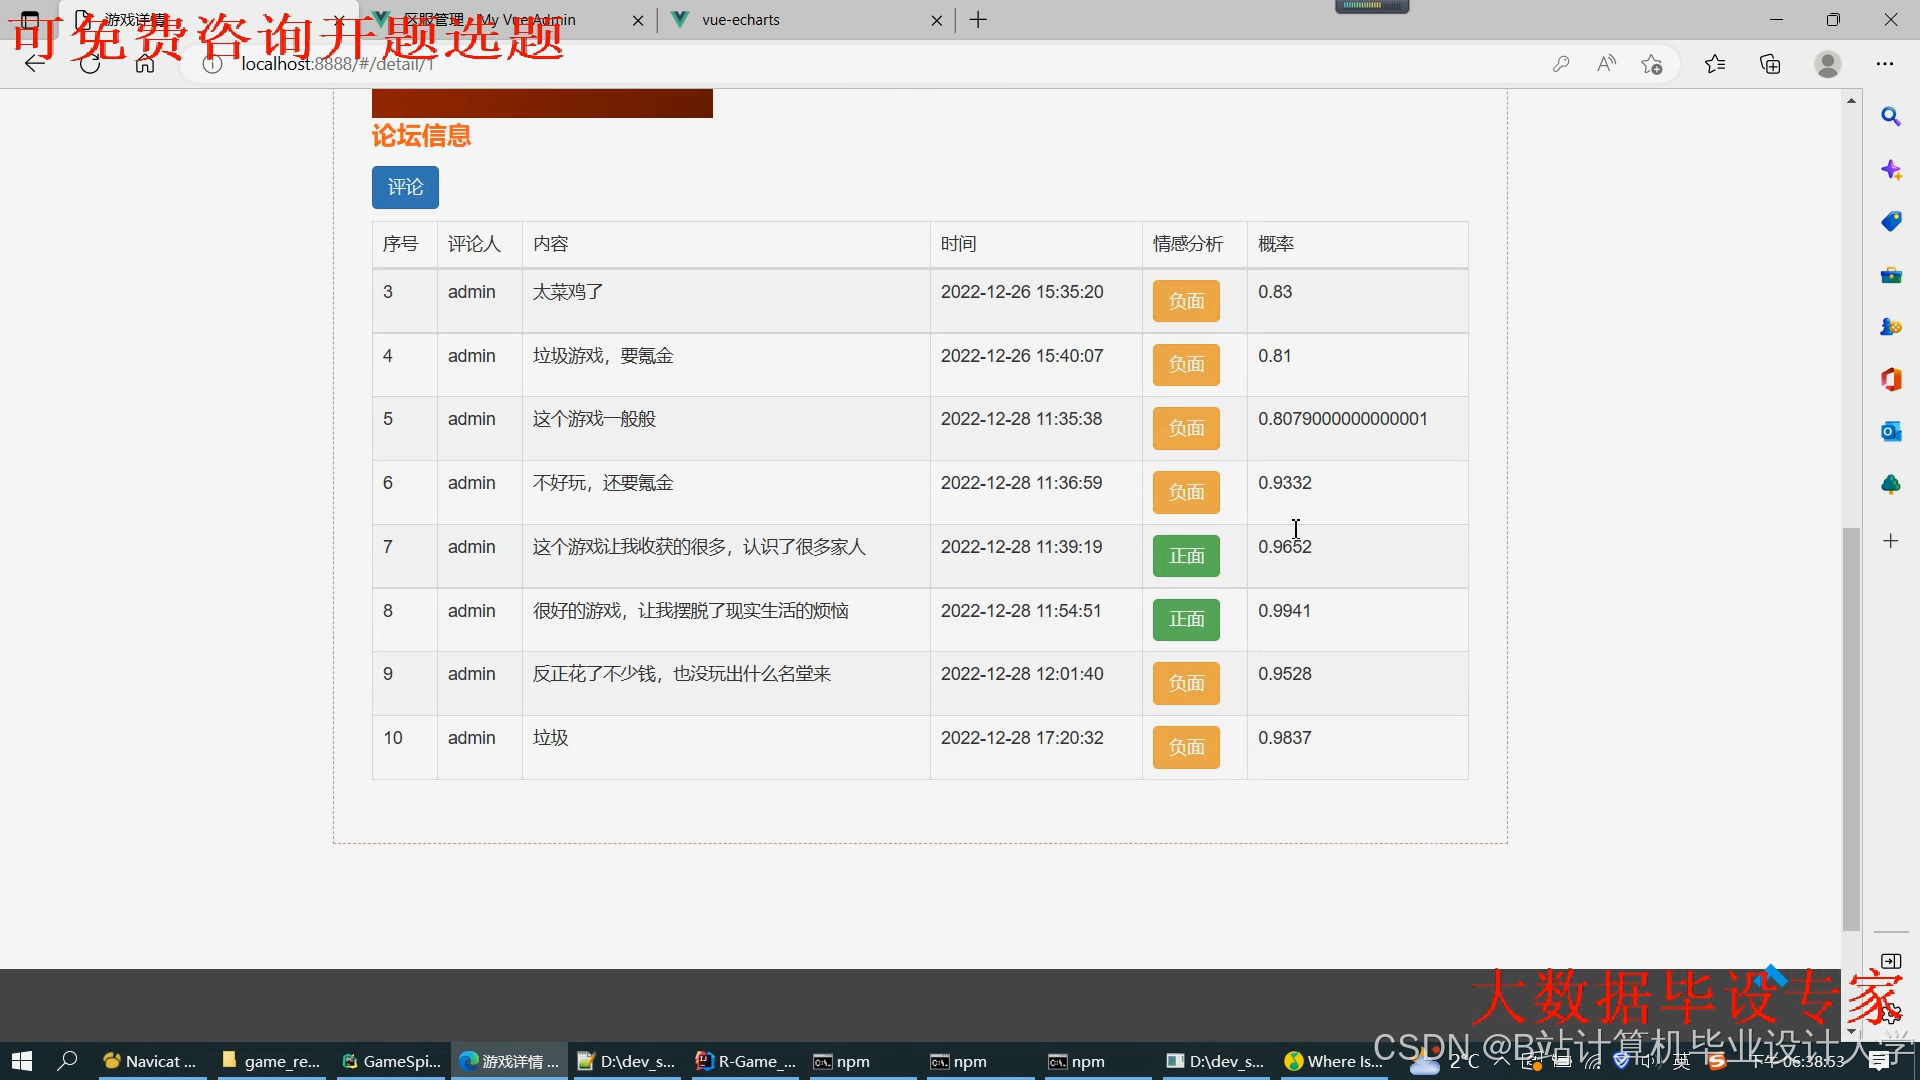
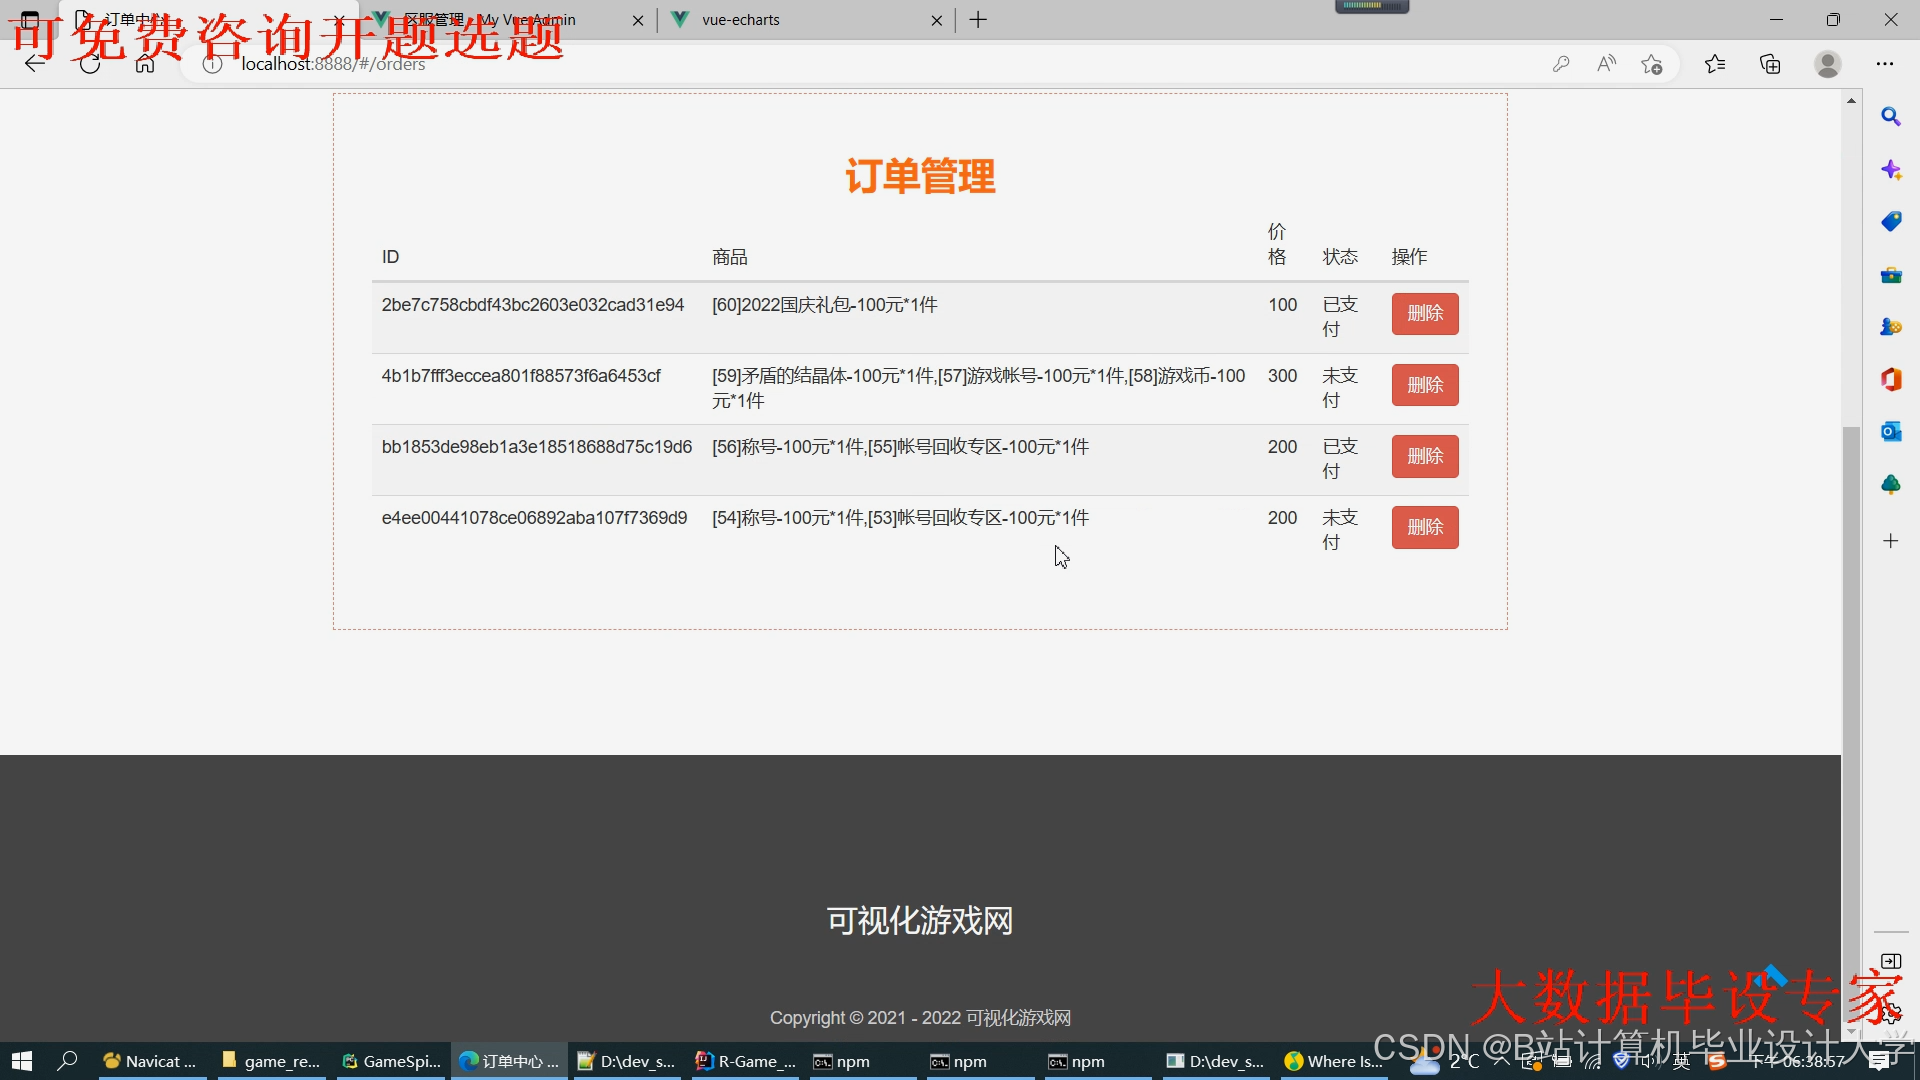
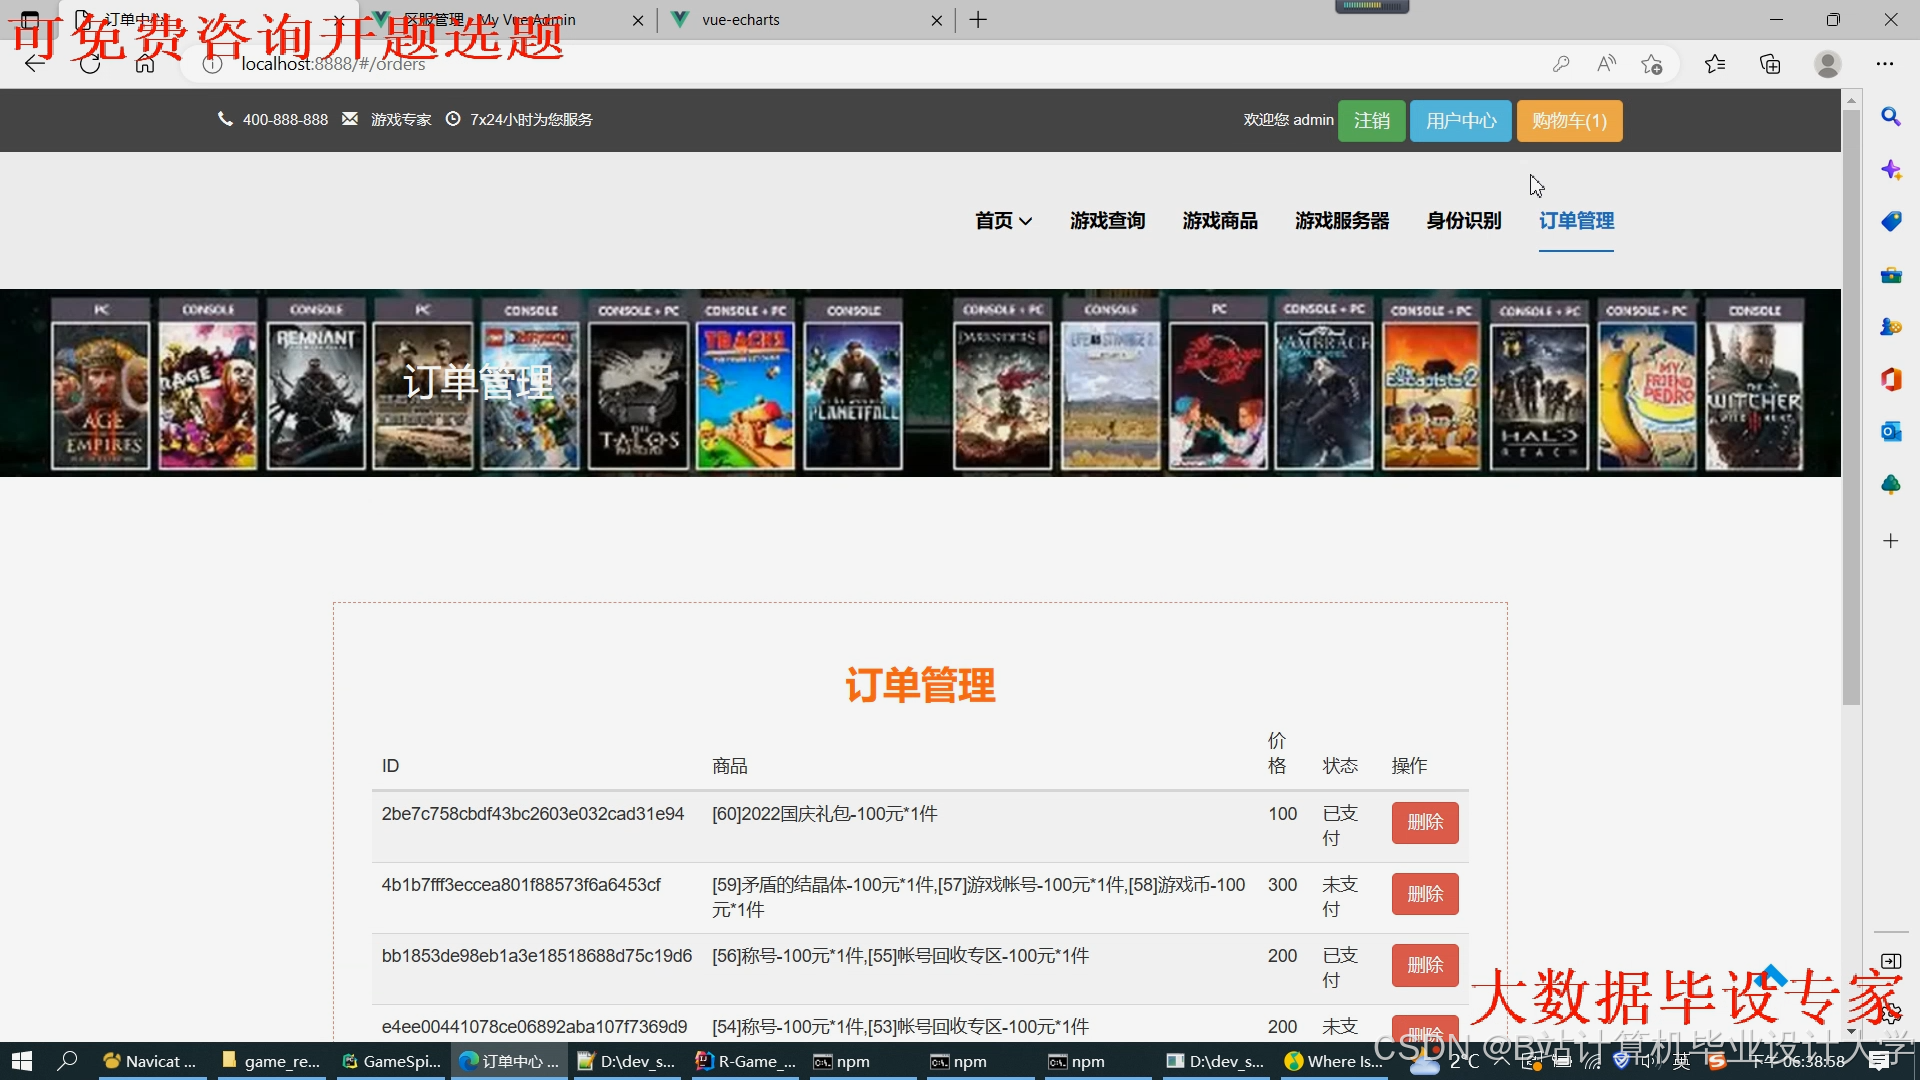
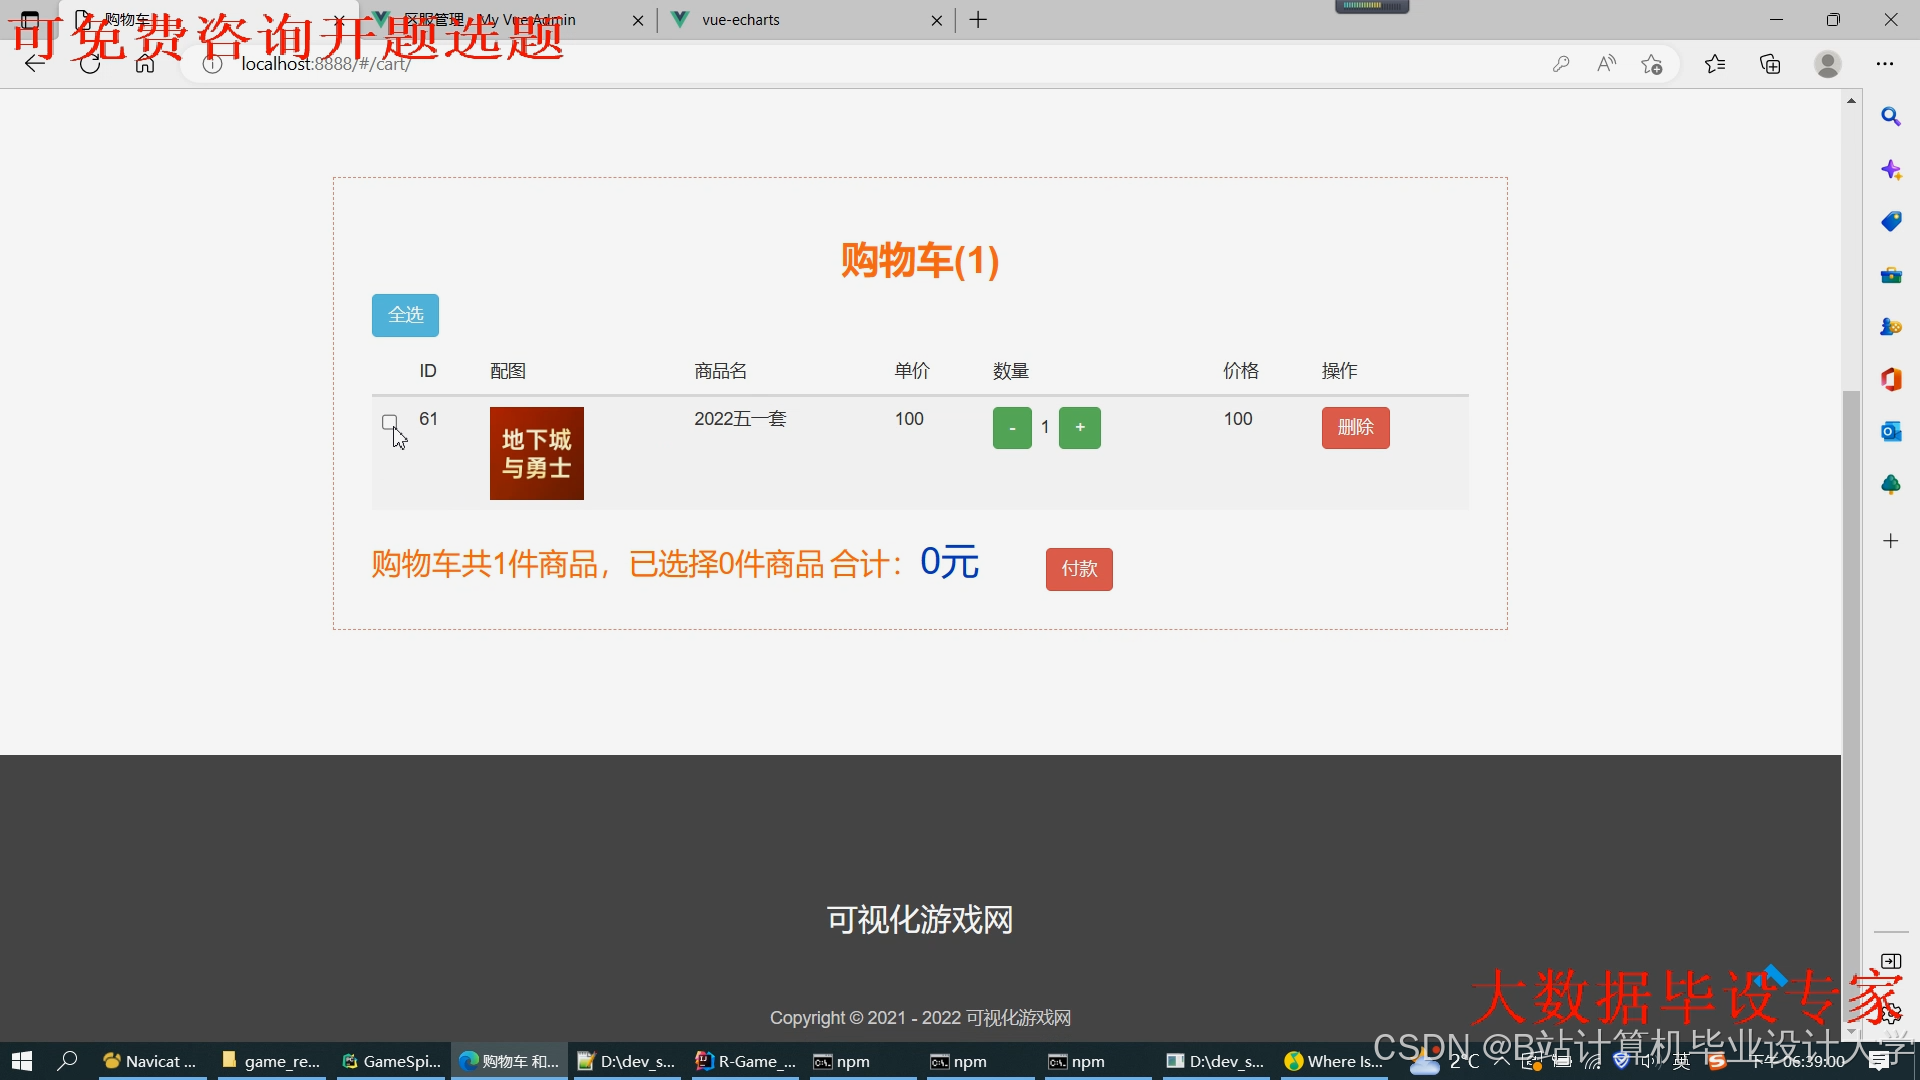
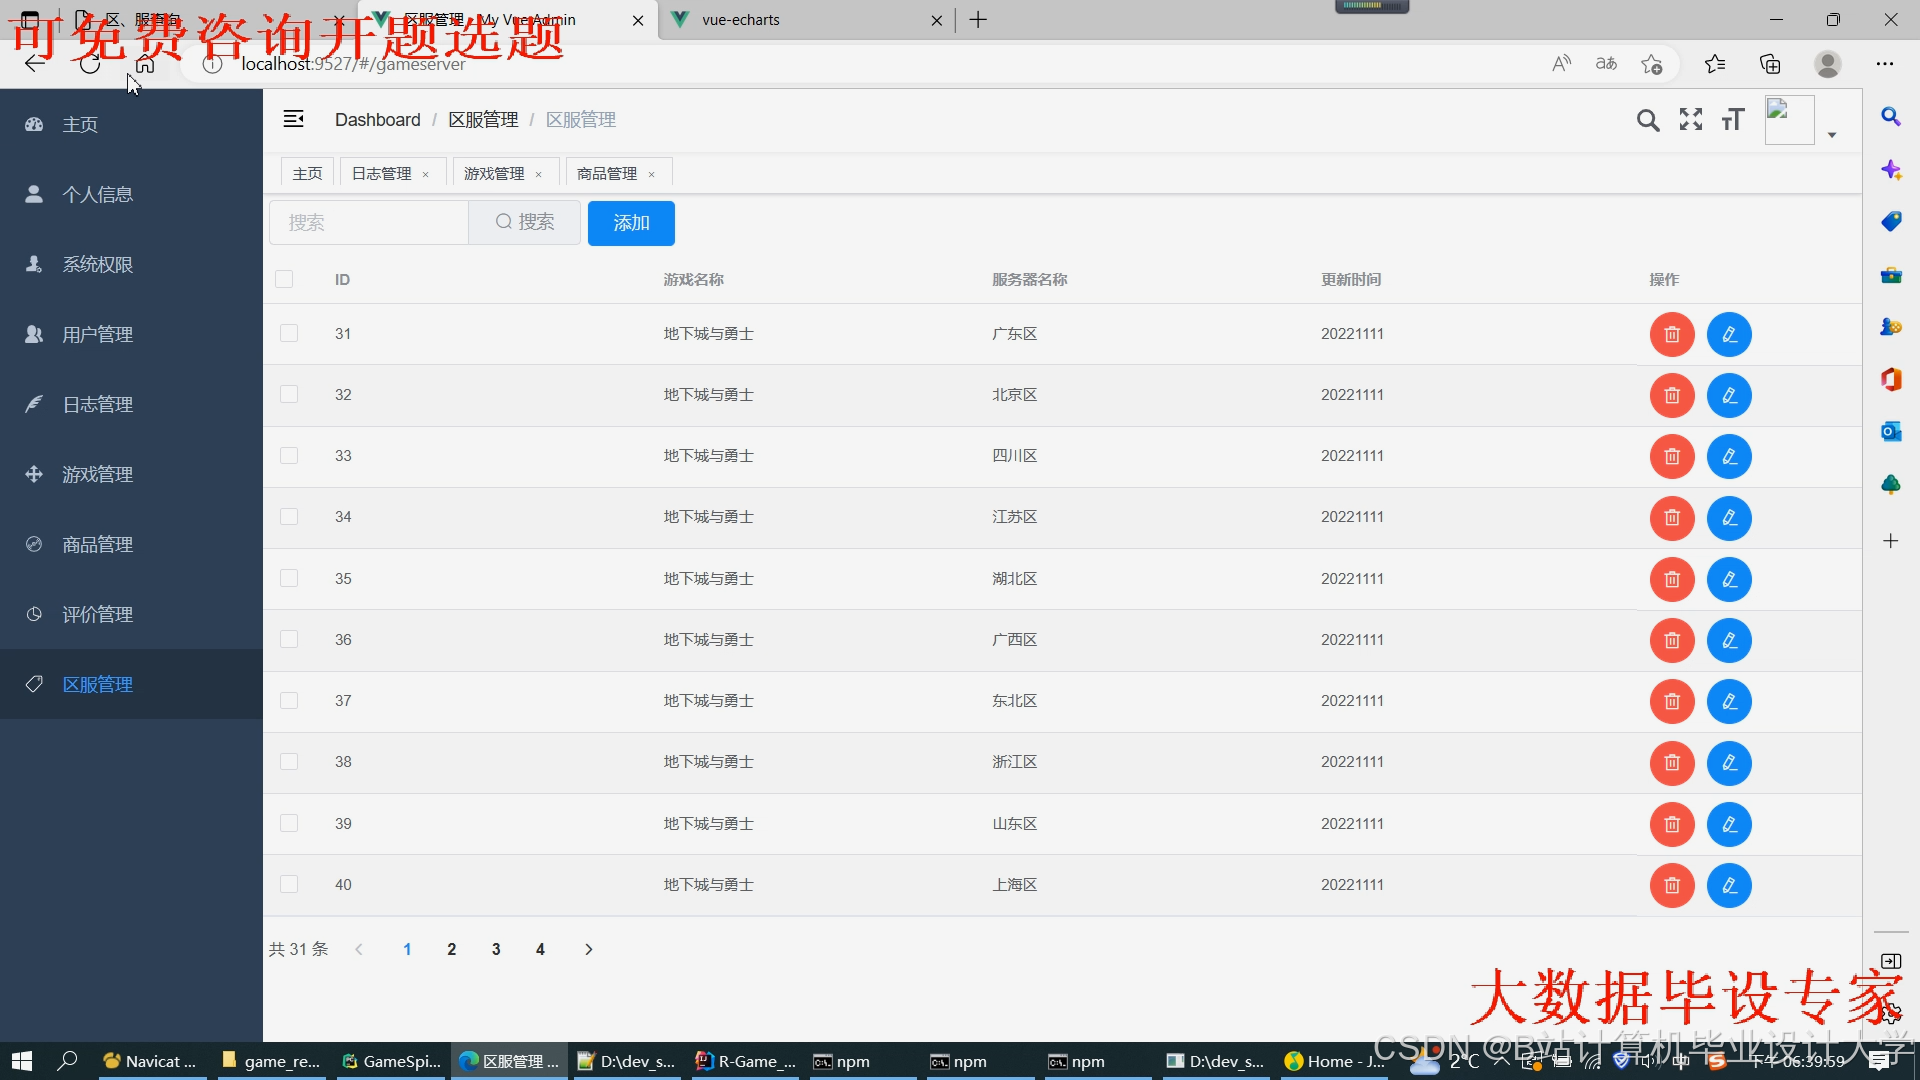
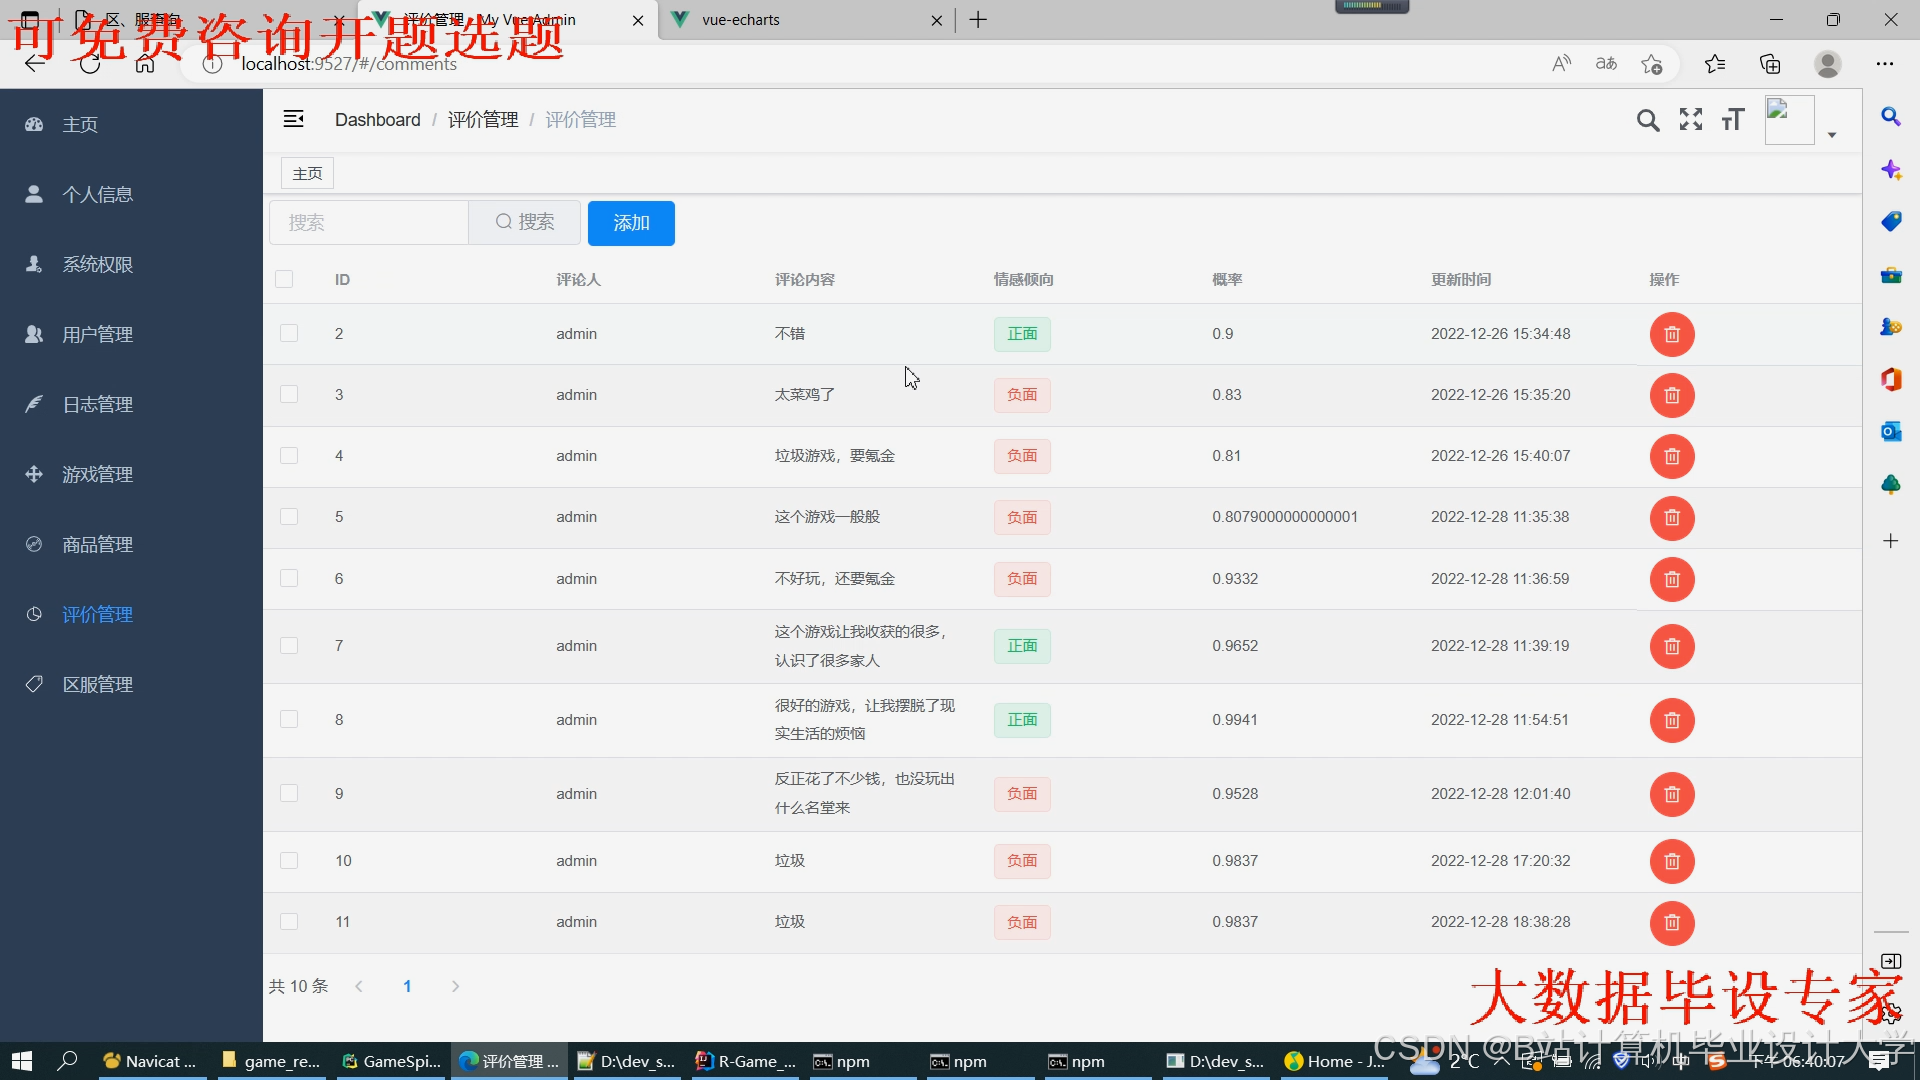
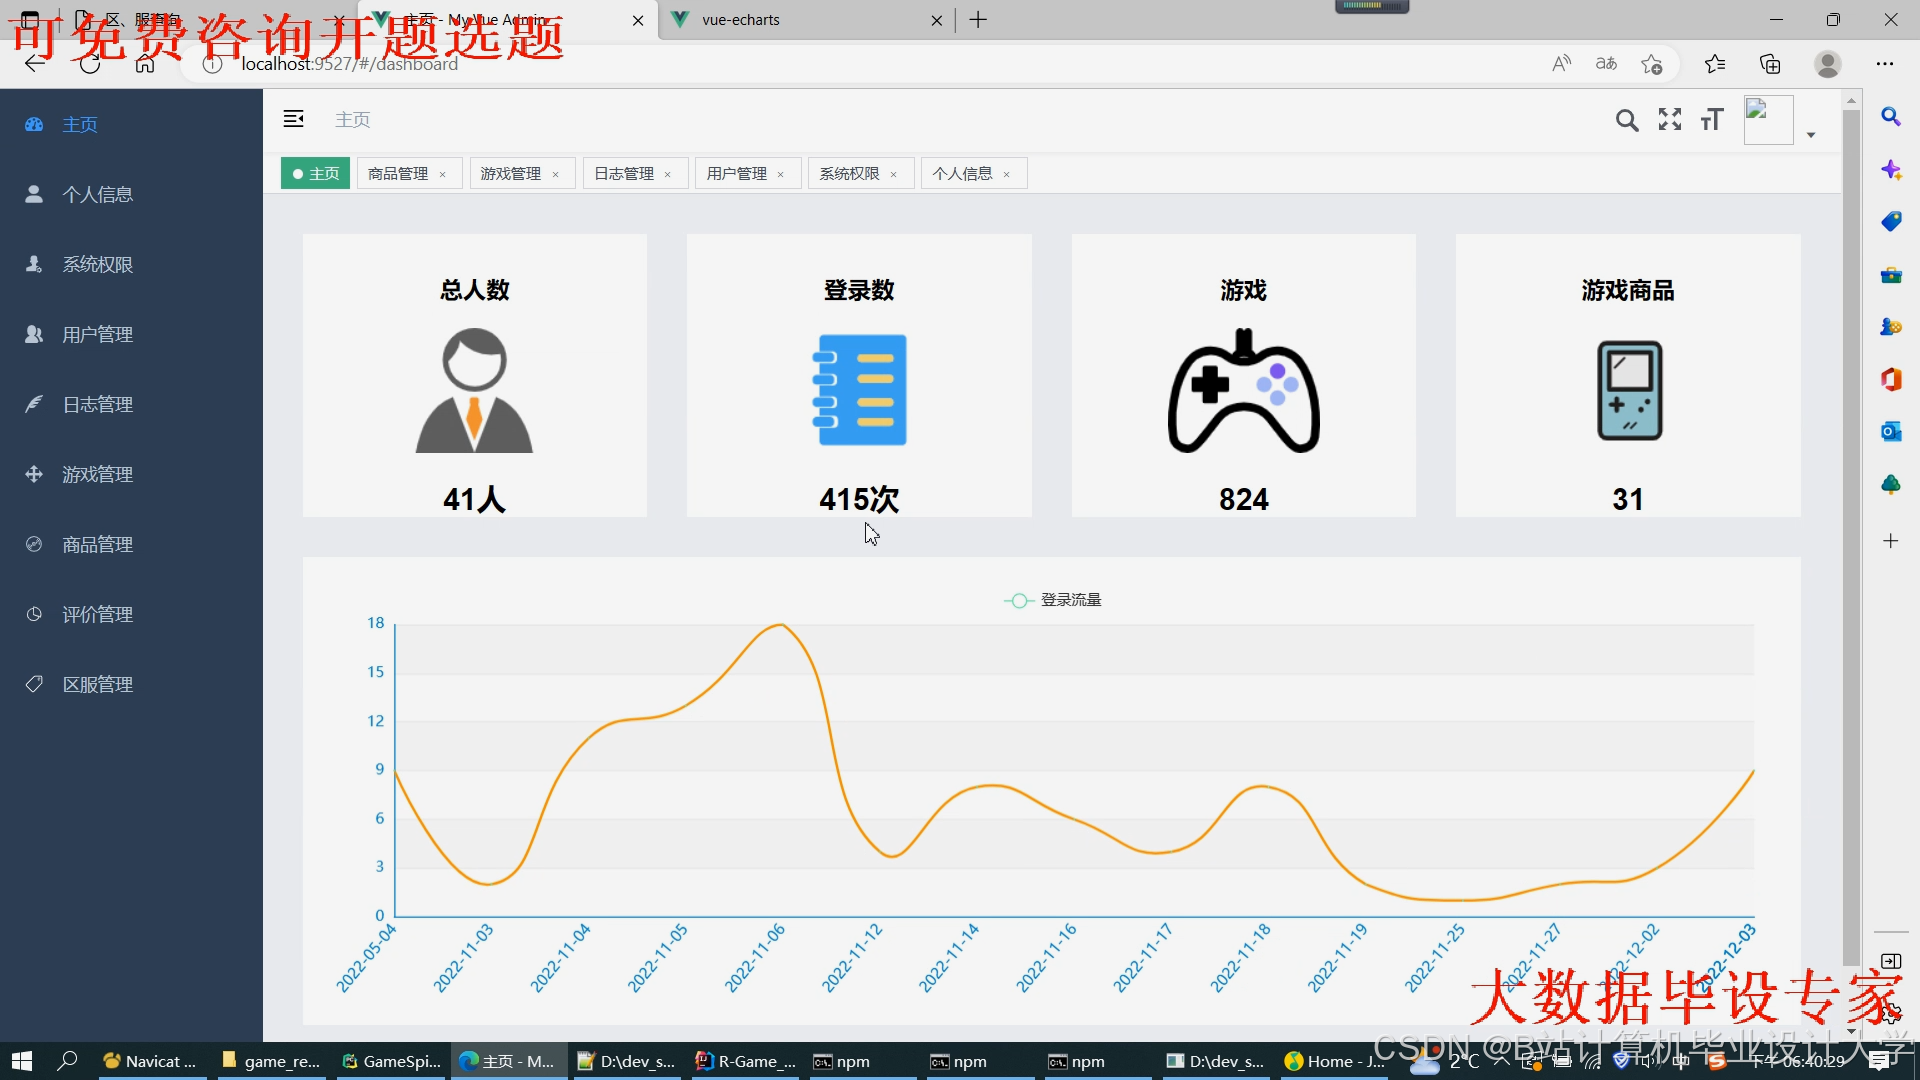
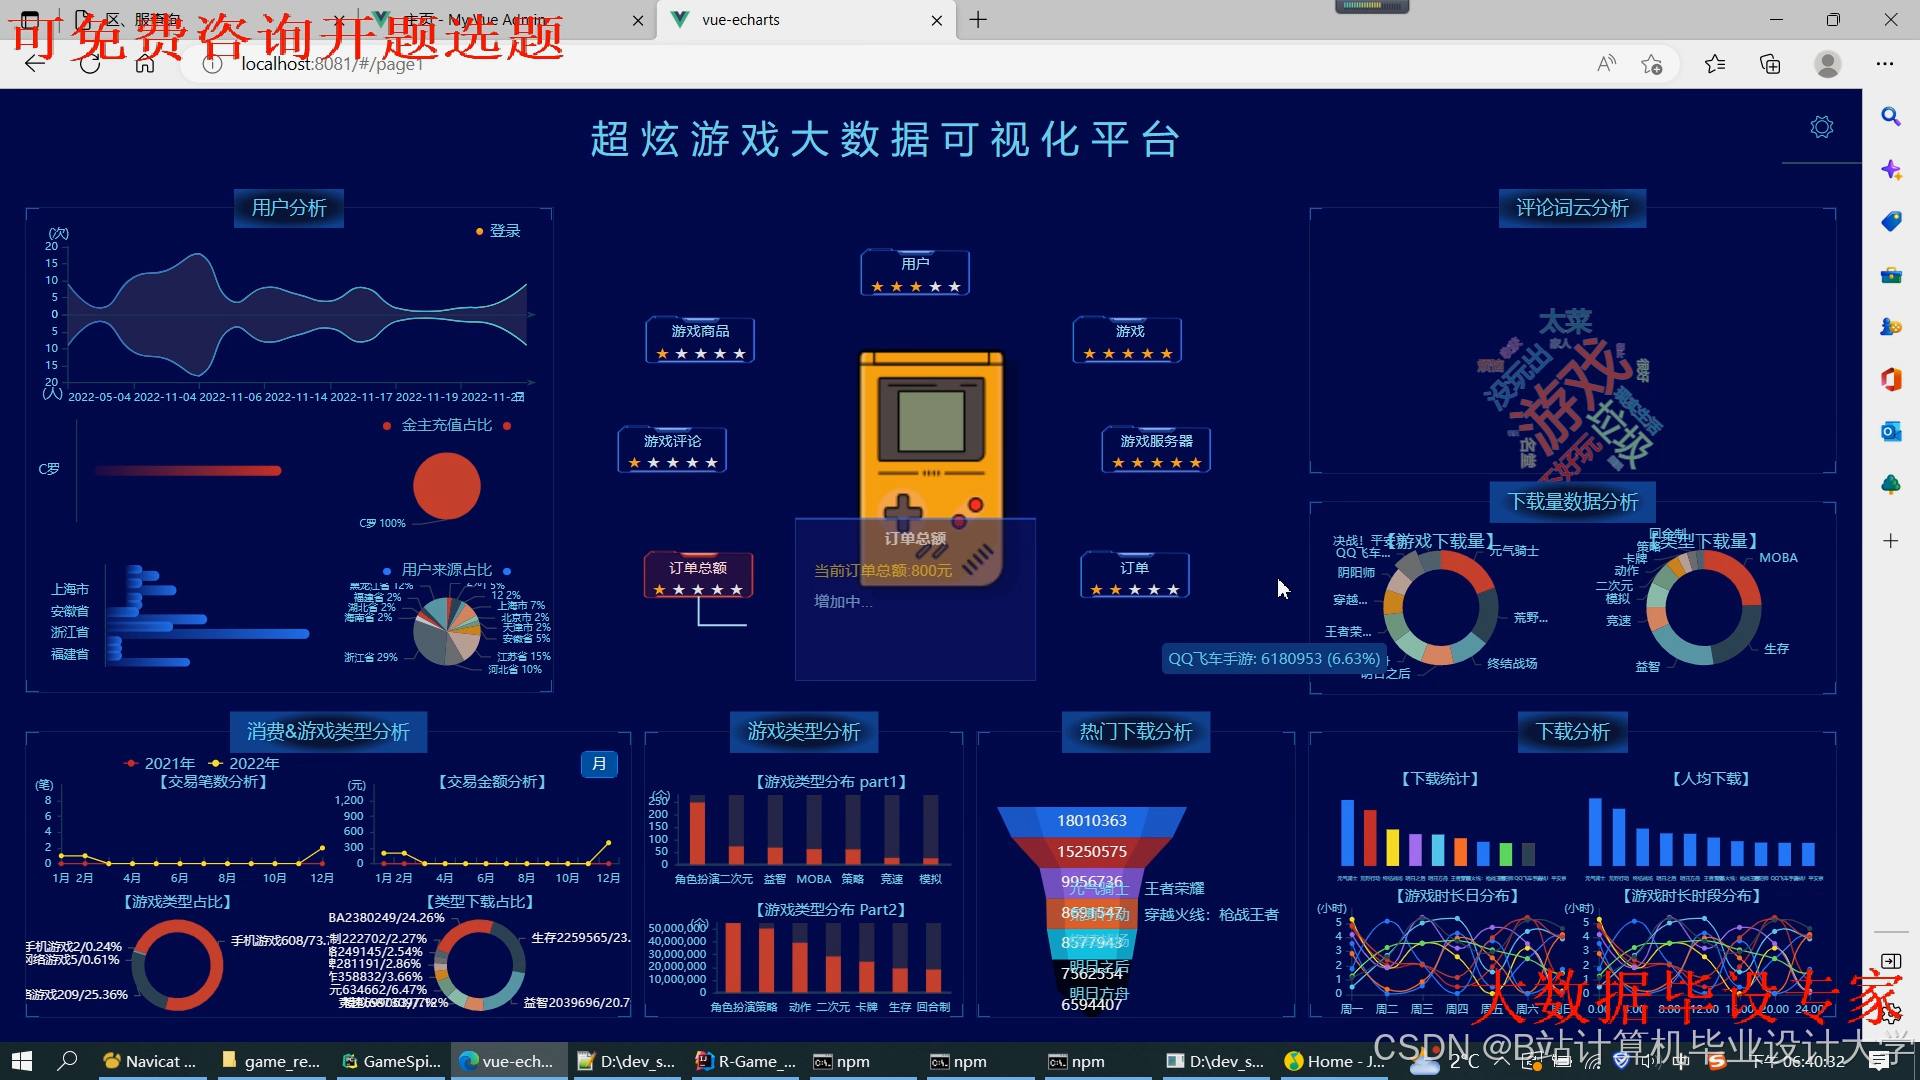
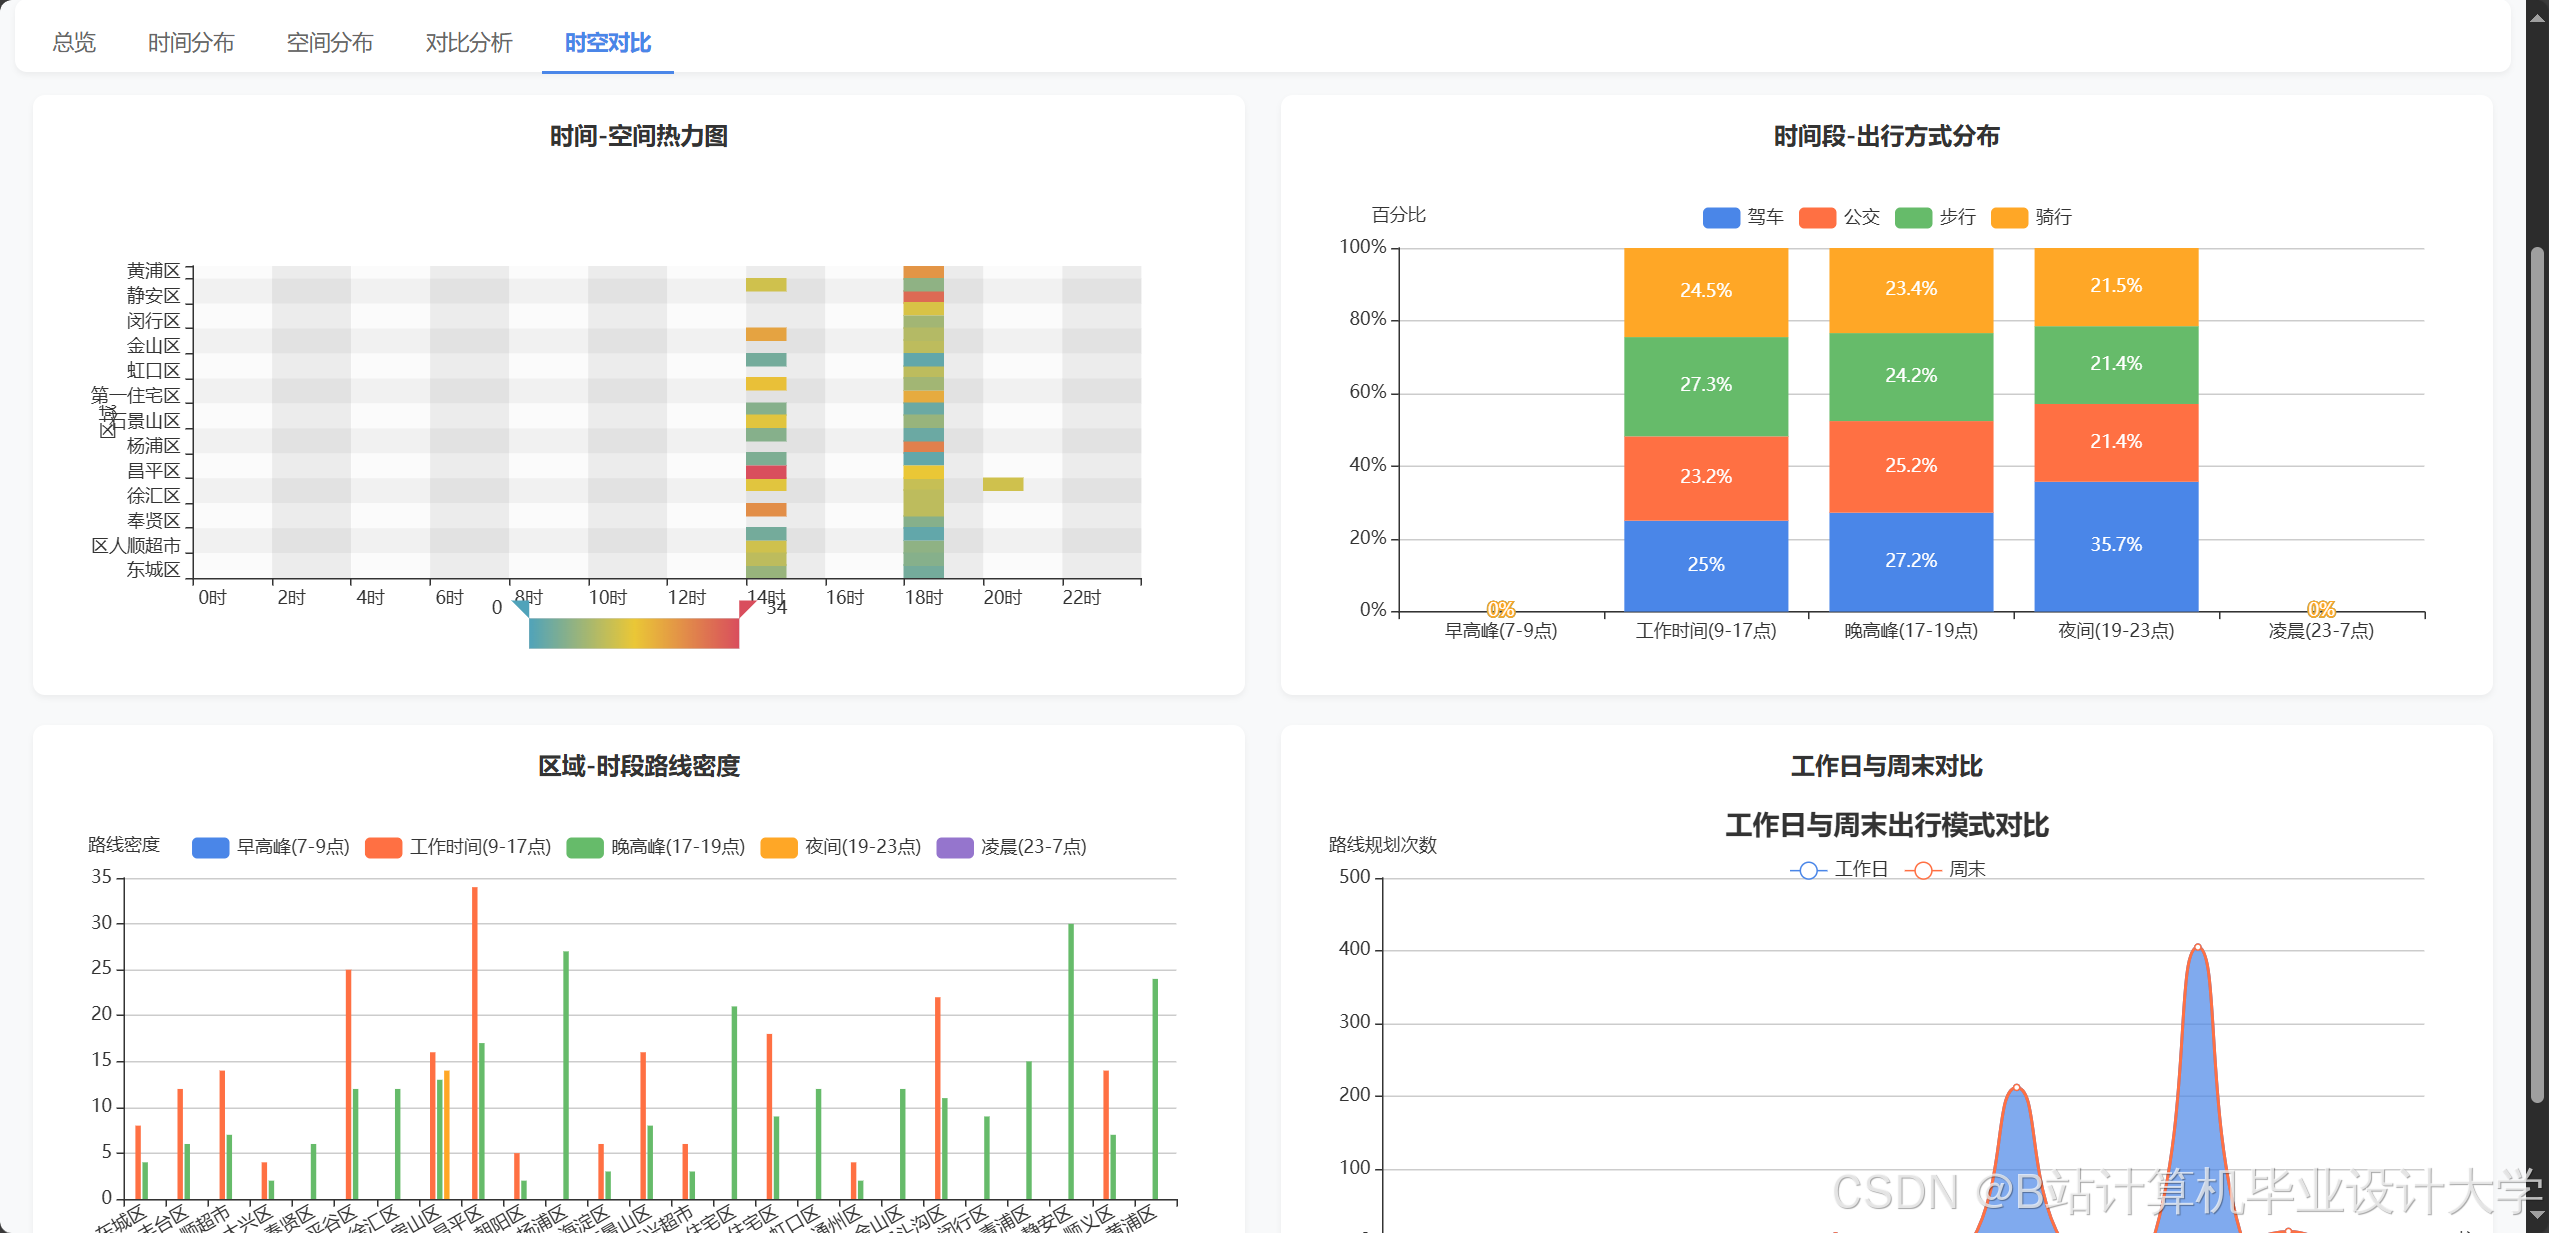
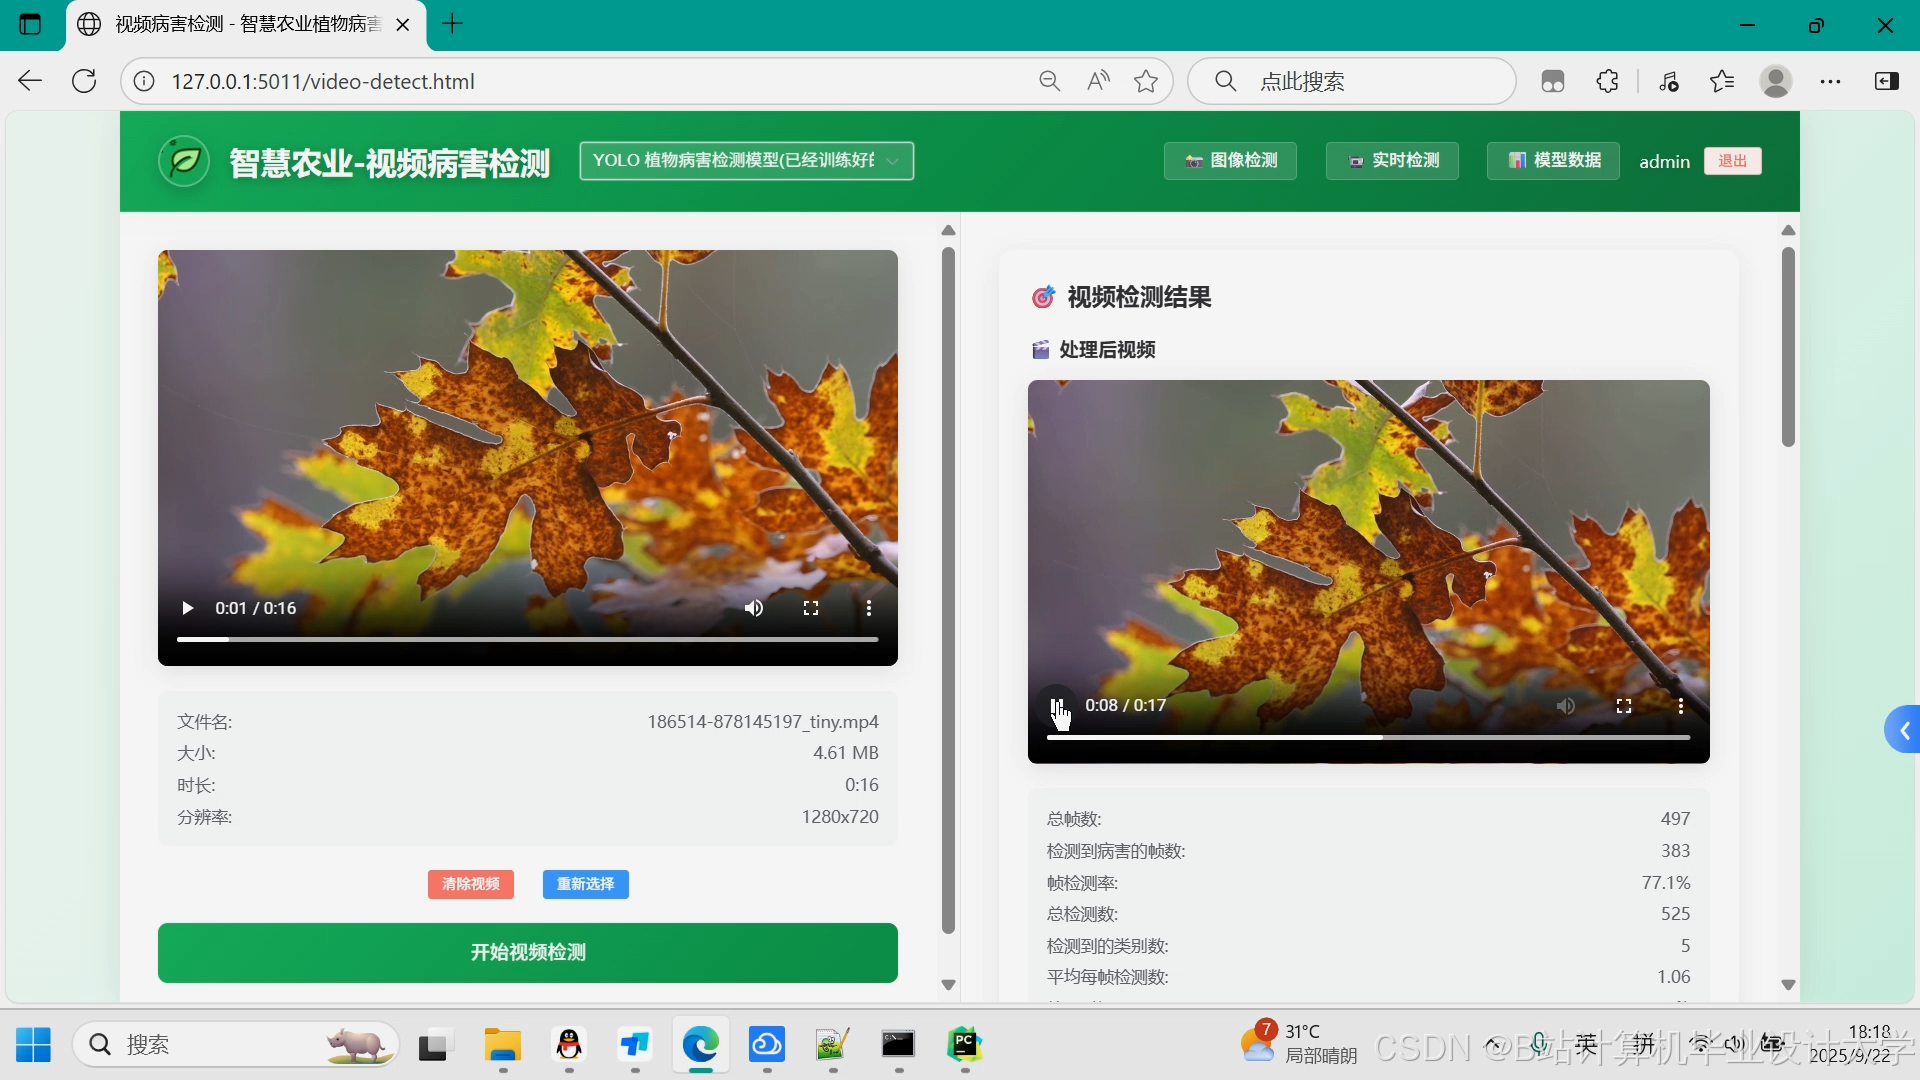
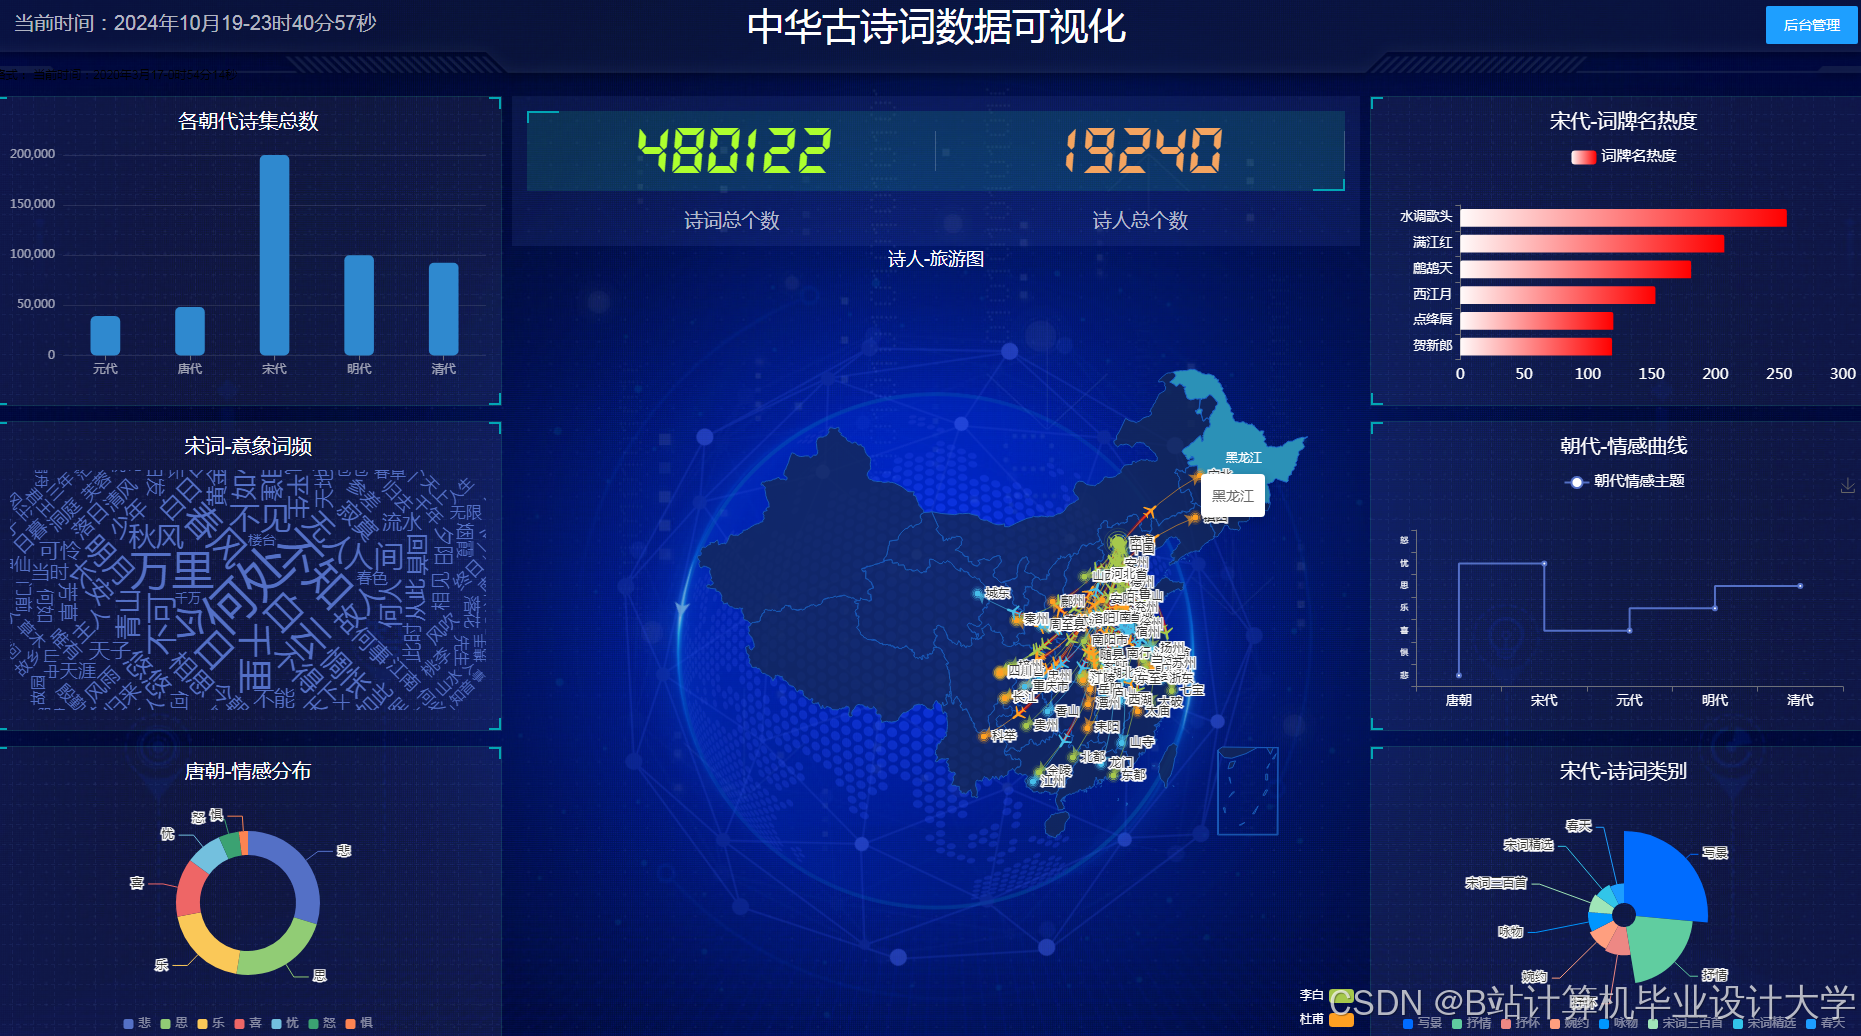
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 8
 0
- 0


 已为社区贡献583条内容

所有评论(0)