r5:天气预测
- **🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/o-DaK6aQQLkJ8uE4YX1p3Q) 中的学习记录博客**
- **🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)**
文章目录
概要
根据今天的天气数据,预测明天是否会下雨(Yes/No)。这是一个典型的二分类问题。
整体架构流程
原始数据 (weatherAUS.csv)
↓
第一步:数据探索 (EDA)
↓
第二步:数据预处理
↓
第三步:构建数据集
↓
第四步:搭建神经网络
↓
第五步:训练模型
↓
第六步:结果可视化
数据探索
data.head() → 看前几行数据
data.describe() → 看统计摘要
data.dtypes → 看每列数据类型
热力图 → 看各特征之间的相关性
countplot → 看下雨/不下雨的数量分布
crosstab → 看今天下雨和明天下雨的关联
城市降雨率图 → 看哪些城市更容易下雨
散点图 → 看气压和降雨的关系
数据预处理
问题1:Date是字符串
→ 解决:拆分成year/Month/day三列数字
问题2:有缺失值
→ 解决:
文本列 → 众数填充
数值列 → 中位数填充
特殊列 → 随机抽样填充
问题3:文本列模型不能用
→ 解决:LabelEncoder编码成数字
"Adelaide"→0, "Albany"→1 ...
问题4:各列数值范围差异大
→ 解决:MinMaxScaler归一化到0~1
构建数据集
X(特征)= 除RainTomorrow和day之外的所有列
↓
今天的气温、气压、风速、湿度...
y(标签)= RainTomorrow列
↓
明天是否下雨(0或1)
然后:
X, y → train_test_split → X_train, X_test
y_train, y_test
75%训练集 25%测试集
搭建神经网络
输入层:接收今天的天气数据(多个特征)
↓
隐藏层1:24个神经元,tanh激活,学习特征组合
↓
隐藏层2:18个神经元,tanh激活,进一步提取规律
↓
隐藏层3:23个神经元,tanh激活
↓
Dropout(0.5):随机关闭50%神经元,防止过拟合
↓
隐藏层4:12个神经元,tanh激活
↓
Dropout(0.2):随机关闭20%神经元
↓
输出层:1个神经元,sigmoid激活
输出0~1的概率
>0.5 → 明天下雨(Yes)
<0.5 → 明天不下雨(No)
代码运行
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings('ignore')

from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Activation, Dropout
from tensorflow.keras.callbacks import EarlyStopping
from sklearn.metrics import classification_report, confusion_matrix
from sklearn.metrics import r2_score
from sklearn.metrics import mean_absolute_error, mean_absolute_percentage_error

data = pd.read_csv("/Users/lilyj/Downloads/weatherAUS.csv")
df = data.copy()   # 保留原始数据备份
data.head()        # 查看前5行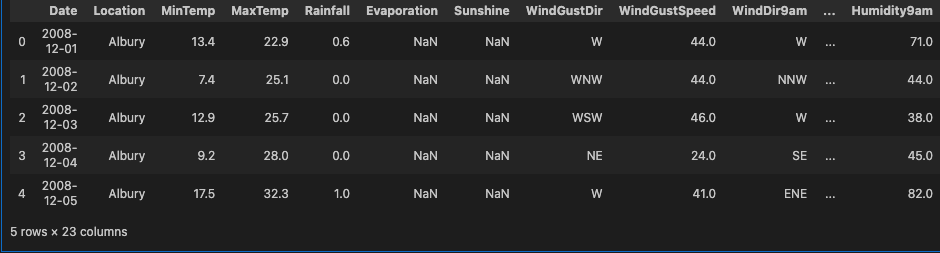
data.describe()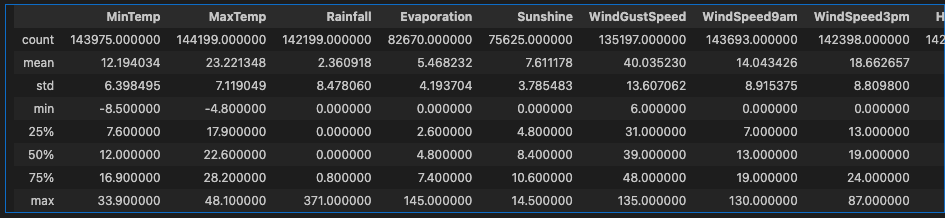
data.dtypes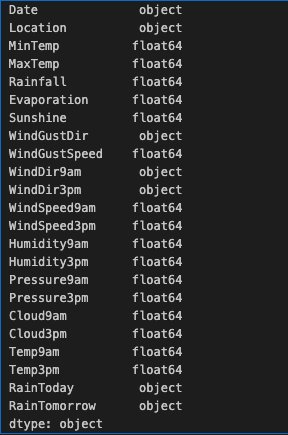
data['Date'] = pd.to_datetime(data['Date'])  # 字符串 → 日期格式

data['year']  = data['Date'].dt.year
data['Month'] = data['Date'].dt.month
data['day']   = data['Date'].dt.day

data.head()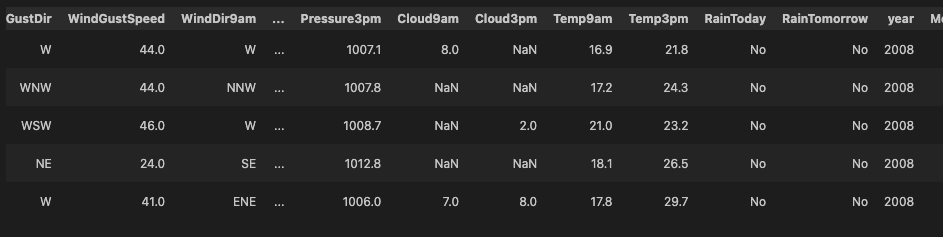
data.drop('Date', axis=1, inplace=True)  # 拆分完后删除原始Date列
data.columns  # 查看当前所有列名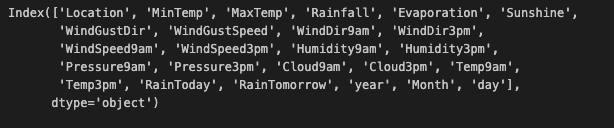
plt.figure(figsize=(15, 13))

ax = sns.heatmap(data.corr(numeric_only=True),  # 只对数值列计算,忽略字符串列
                 square=True,  # 每个格子都是正方形
                 annot=True,  # 在每个格子里显示具体数值
                 fmt='.2f')   # 显示数值,保留两位小数

ax.set_xticklabels(ax.get_xticklabels(), rotation=90)  # 旋转x轴标签90度,避免重叠
plt.show()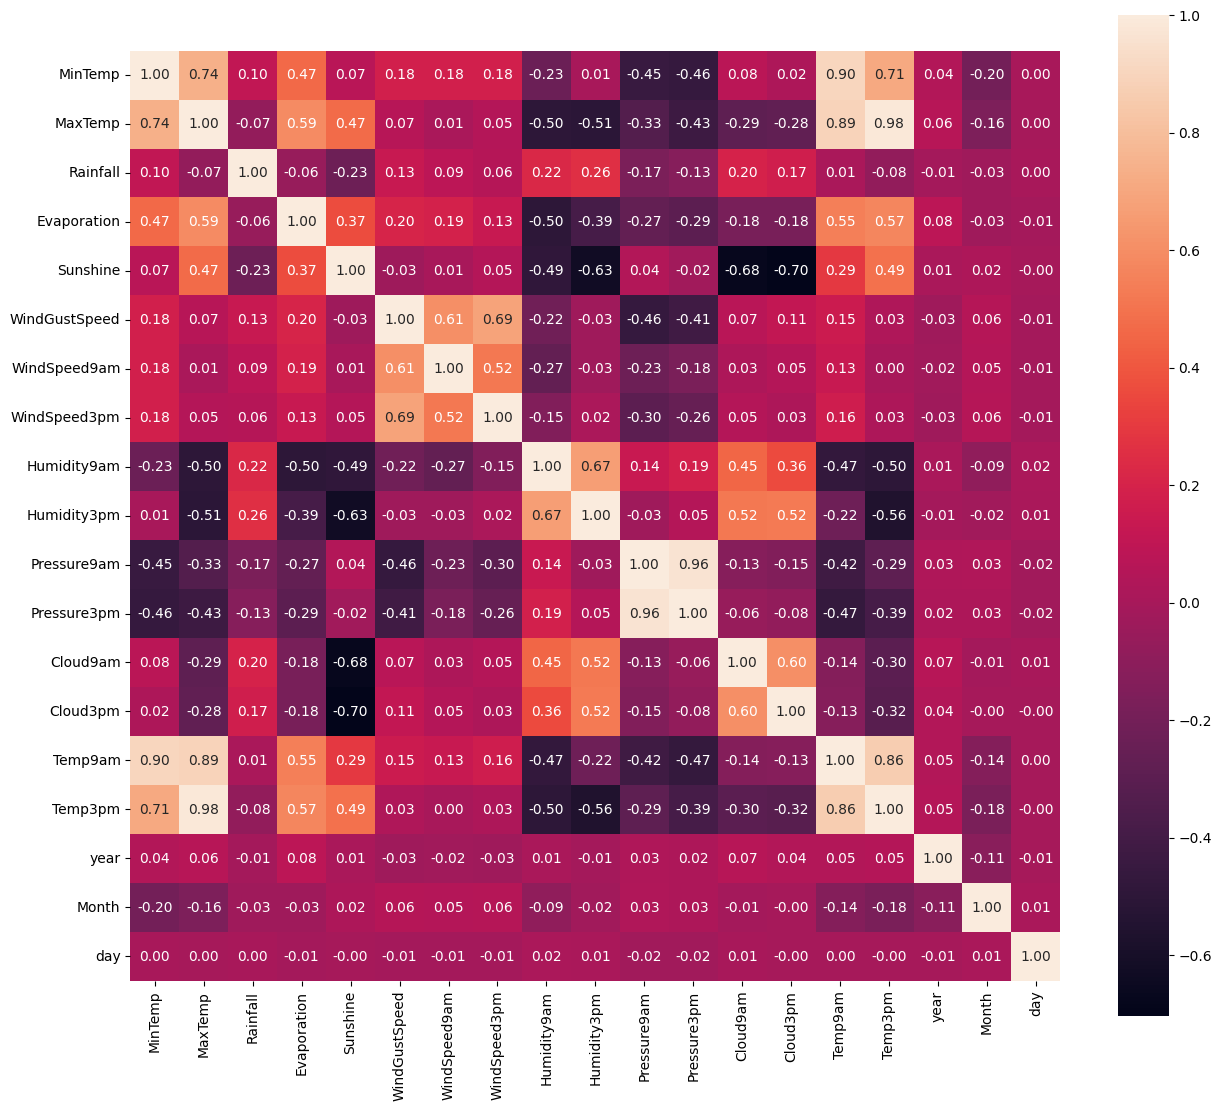
sns.set(style="whitegrid", palette="Set2")  # whitegrid → 白色背景 + 横向网格线;Set2 → 柔和配色,自动分配给不同类别
fig, axes = plt.subplots(1, 2, figsize=(10, 4))  # 1 行 2 列
title_font = {'fontsize': 14, 'fontweight': 'bold', 'color': 'darkblue'}

# 左图:RainTomorrow
sns.countplot(x='RainTomorrow', data=data,
              hue='RainTomorrow',
              palette='Set2',
              ax=axes[0],          # ← 必须指定画在哪个子图
              edgecolor='black')   # 给柱子加上黑色边框,更清晰
axes[0].set_title('Rain Tomorrow', fontdict=title_font)
axes[0].set_xlabel('Will it Rain Tomorrow?', fontsize=12)
axes[0].set_ylabel('Count', fontsize=12)

# 右图:RainToday
sns.countplot(x='RainToday', data=data,
              hue='RainToday',
              palette='Set2',
              ax=axes[1],          # ← 同样要指定
              edgecolor='black')
axes[1].set_title('Rain Today', fontdict=title_font)
axes[1].set_xlabel('Did it Rain Today?', fontsize=12)
axes[1].set_ylabel('Count', fontsize=12)

sns.despine()
plt.tight_layout()
plt.show()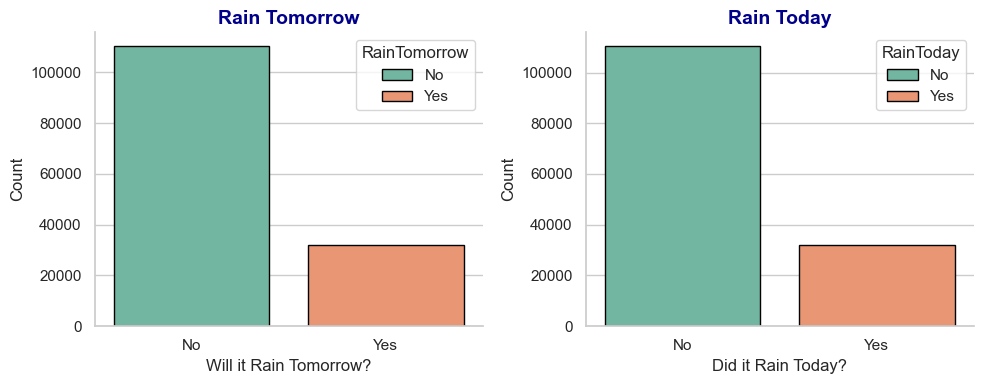
x = pd.crosstab(data['RainTomorrow'], data['RainToday'])
x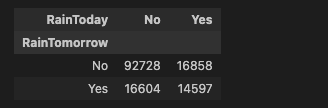
y = x / x.transpose().sum().values.reshape(2,1) * 100
y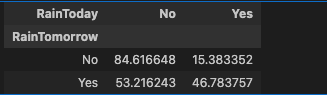
y.plot(kind="bar", figsize=(4,3), color=['#006666','#d279a6'])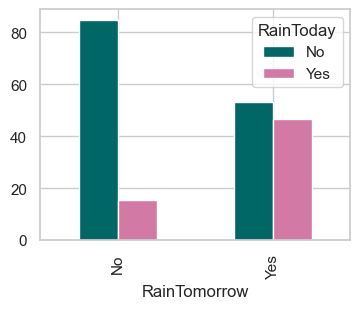
x = pd.crosstab(data['Location'], data['RainToday'])
y = x / x.transpose().sum().values.reshape(-1, 1) * 100  # 每行归一化为百分比
y = y.sort_values(by='Yes', ascending=True)               # 按下雨率升序排列

color = ['#cc6699','#006699','#006666','#862d86','#ff9966']
y.Yes.plot(kind="barh", figsize=(15,20), color=color)     # 水平柱状图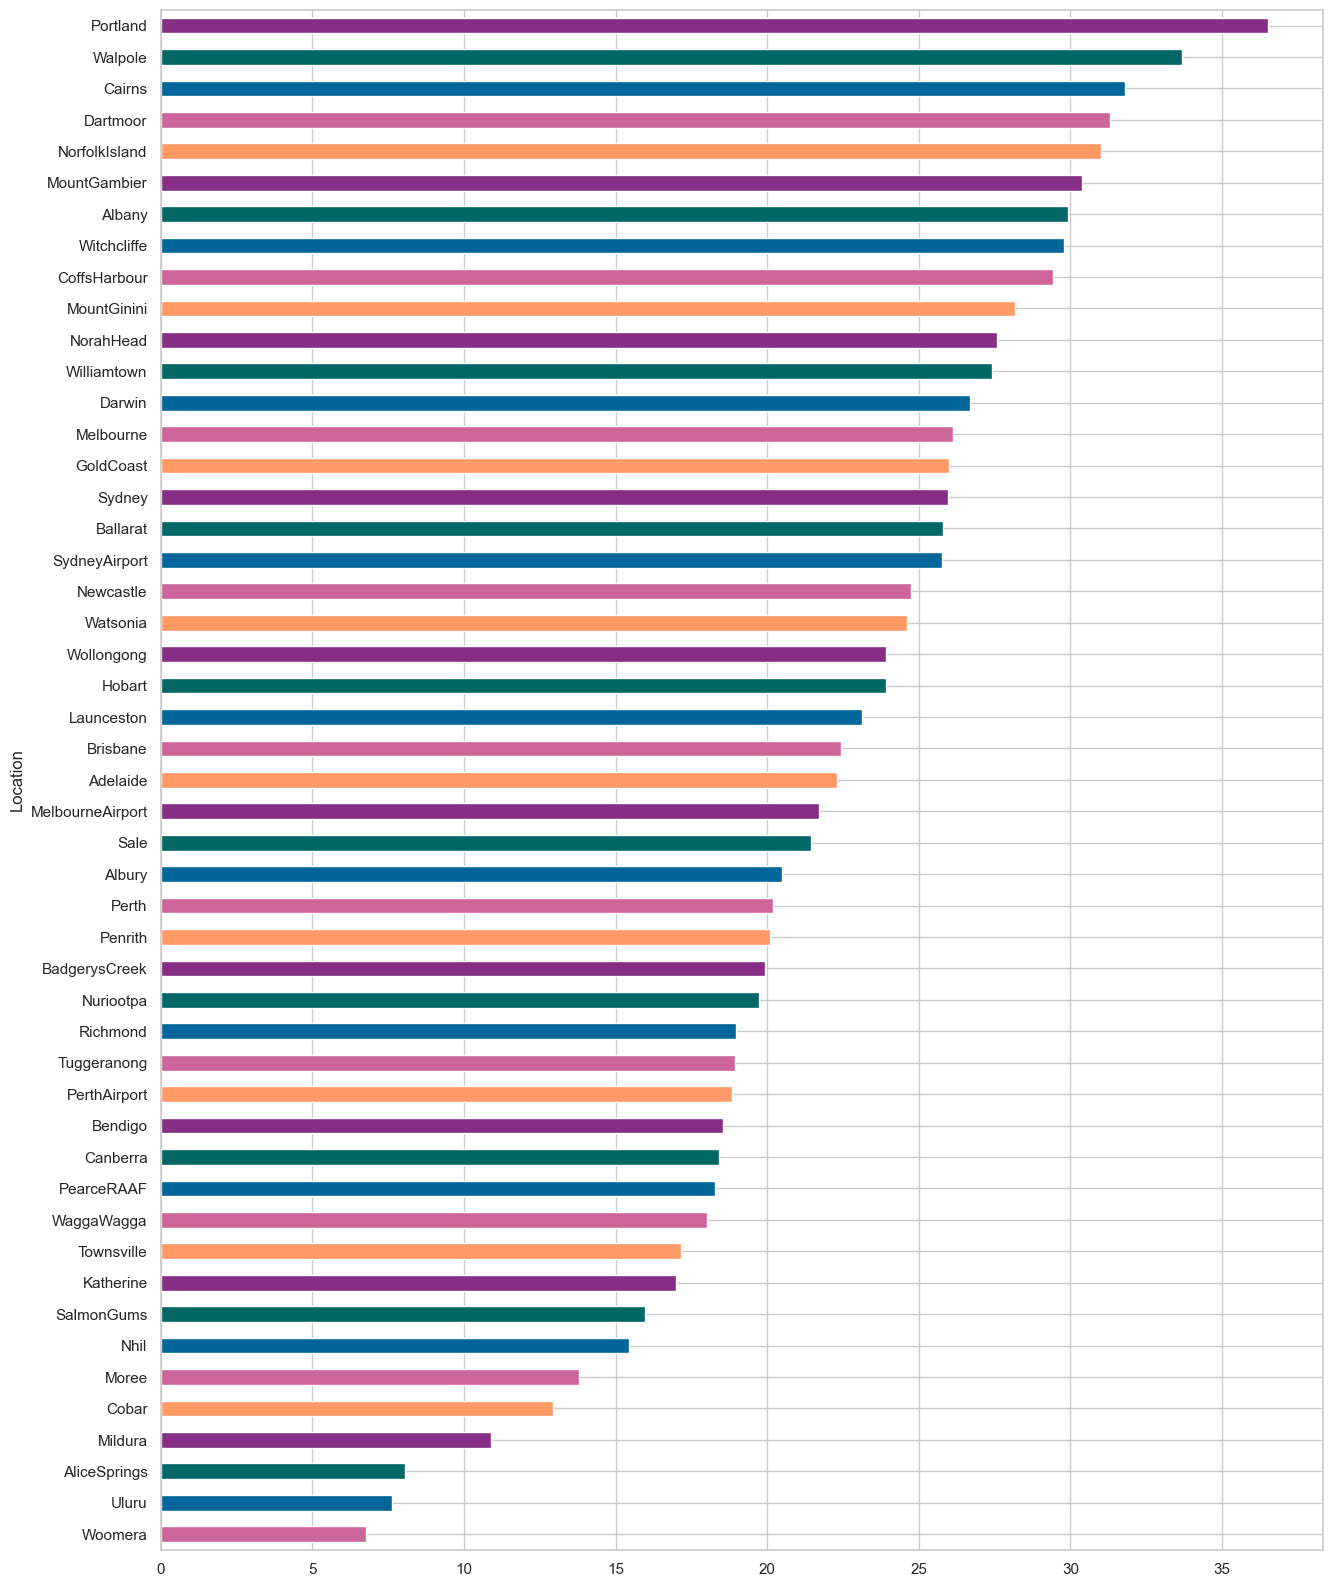
data.columns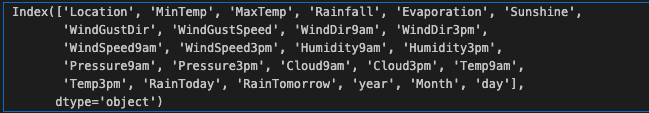
plt.figure(figsize=(8, 6))
sns.scatterplot(data=data,
                x='Pressure9am',
                y='Pressure3pm',
                hue='RainTomorrow')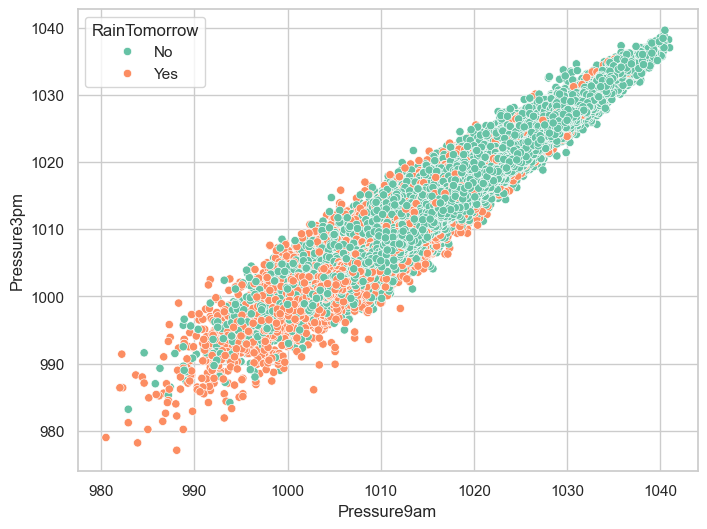
data.isnull().sum()/data.shape[0]*100
lst = ['Evaporation', 'Sunshine', 'Cloud9am', 'Cloud3pm']
for col in lst:
    fill_list = data[col].dropna()
    data[col] = data[col].fillna(pd.Series(np.random.choice(fill_list, size=len(data))))
s = (data.dtypes == "object")
object_cols = list(s[s].index)
object_cols
for i in object_cols:
    data[i].fillna(data[i].mode()[0], inplace=True)  # inplace=True:直接修改原数据,不需要重新赋值
t = (data.dtypes == "float64")
num_cols = list(t[t].index)

# .median():中位数
for i in num_cols:
    data[i].fillna(data[i].median(), inplace=True)
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
for i in object_cols:
    data[i] = label_encoder.fit_transform(data[i])
X = data.drop(['RainTomorrow', 'day'], axis=1).values
y = data['RainTomorrow'].values
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
scaler = MinMaxScaler()
scaler.fit(X_train)           # 只用训练集计算最大最小值
X_train = scaler.transform(X_train)   # 训练集归一化
X_test  = scaler.transform(X_test)    # 测试集用同样的标准归一

from tensorflow.keras.optimizers import Adam

model = Sequential()
model.add(Dense(units=24, activation='tanh'))
model.add(Dense(units=18, activation='tanh'))
model.add(Dense(units=23, activation='tanh'))
model.add(Dropout(0.5))
model.add(Dense(units=12, activation='tanh'))
model.add(Dropout(0.2))
model.add(Dense(units=1,  activation='sigmoid'))

optimizer = tf.keras.optimizers.Adam(learning_rate=1e-4)

model.compile(loss='binary_crossentropy',
              optimizer=optimizer,
              metrics=["accuracy"])


early_stop = EarlyStopping(monitor='val_loss',
                           mode='min',
                           min_delta=0.001,
                           verbose=1,
                           patience=25,
                           restore_best_weights=True)

model.fit(x=X_train,
          y=y_train,
          validation_data=(X_test, y_test),
          verbose=1,
          callbacks=[early_stop],
          epochs=10,
          batch_size=32)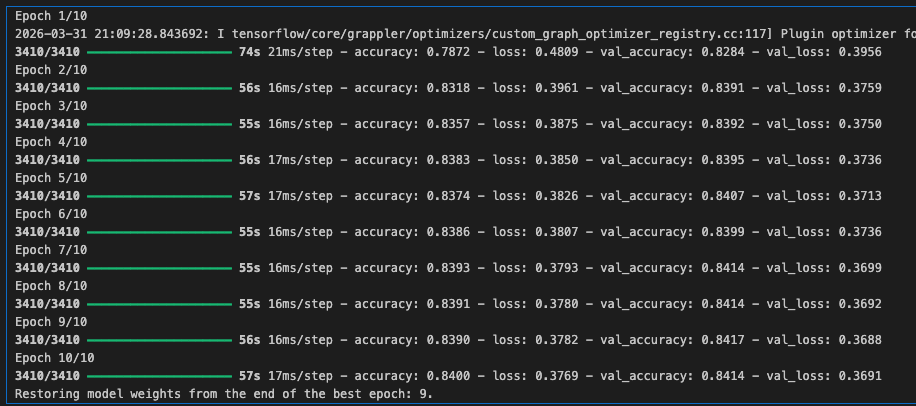
import matplotlib.pyplot as plt

acc     = model.history.history['accuracy']
val_acc = model.history.history['val_accuracy']
loss    = model.history.history['loss']
val_loss= model.history.history['val_loss']

epochs_range = range(10)

plt.figure(figsize=(14, 4))

# 左图:准确率曲线
plt.subplot(1, 2, 1)
plt.plot(epochs_range, acc,     label='Training Accuracy')
plt.plot(epochs_range, val_acc, label='Validation Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')

# 右图:损失曲线
plt.subplot(1, 2, 2)
plt.plot(epochs_range, loss,     label='Training Loss')
plt.plot(epochs_range, val_loss, label='Validation Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')

plt.show()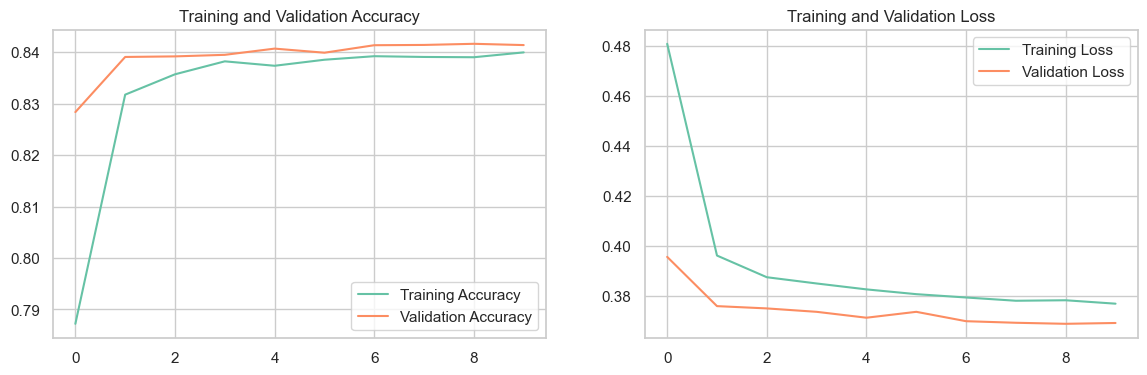
小结
收集澳大利亚各城市的历史天气数据 → 清洗处理 → 喂给神经网络学习 → 神经网络找到今天天气特征和明天是否下雨之间的规律 → 用这个规律预测未来是否下雨

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 13
 0
- 0


 已为社区贡献6条内容

所有评论(0)