DeepSeek辅助总结的chdb 4.0发版说明
chDB
chDB 是一个由 ClickHouse 驱动、进程内运行的 SQL OLAP 引擎 [^1]
更多详情:chDB 的诞生
特性
- 🐼 兼容 Pandas 的 DataStore API - 使用熟悉的 pandas 语法,获得 ClickHouse 性能
- 由 ClickHouse 驱动的进程内 SQL OLAP 引擎
- 无需安装 ClickHouse
- 利用 Python memoryview 最小化从 C++ 到 Python 的数据复制
- 输入&输出支持 Parquet、CSV、JSON、Arrow、ORC 及 60+ 更多格式
- 支持 Python DB API 2.0
架构
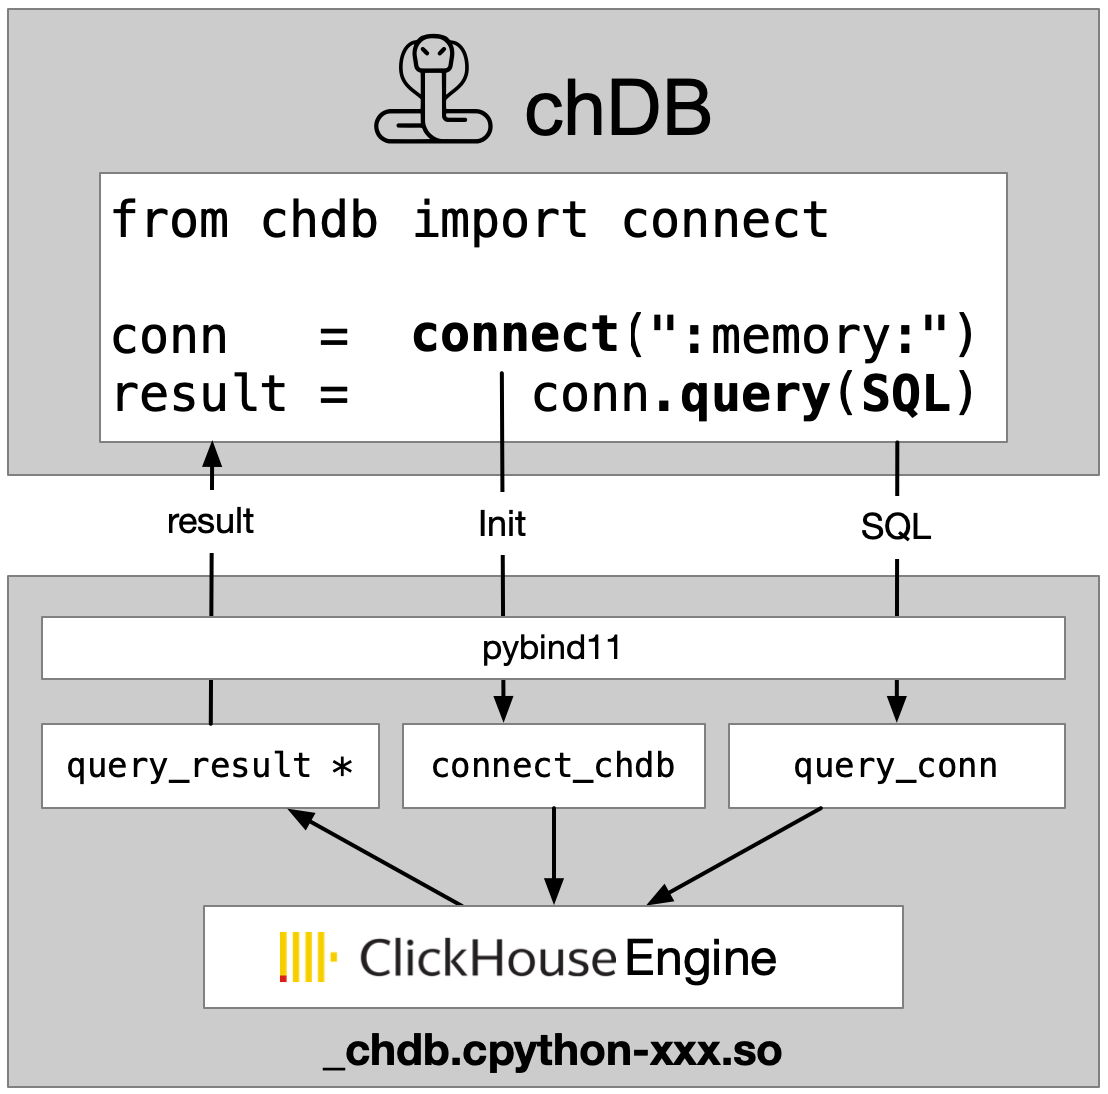
安装
目前,chDB 支持在 macOS 和 Linux (x86_64 和 ARM64) 上运行 Python 3.9+。
pip install chdb
🐼 DataStore:兼容 Pandas 的 API(推荐)
DataStore 提供 类似 pandas 的熟悉 API,具备自动 SQL 生成和 ClickHouse 性能。编写 pandas 代码,获得 SQL 性能——无需学习曲线。
快速开始(30 秒)
只需更改导入语句——使用您已知的 pandas API:
import datastore as pd  # 就是这样!像往常一样使用 pandas API

# 创建 DataFrame - 与 pandas 完全一样工作
df = pd.DataFrame({
    'name': ['Alice', 'Bob', 'Charlie', 'Diana'],
    'age': [25, 30, 35, 28],
    'city': ['NYC', 'LA', 'NYC', 'LA']
})

# 使用熟悉的 pandas 语法进行过滤
result = df[df['age'] > 26]
print(result)
#       name  age city
# 1      Bob   30   LA
# 2  Charlie   35  NYC
# 3    Diana   28   LA

# GroupBy 也同样有效
print(df.groupby('city')['age'].mean())
# city
# LA     29.0
# NYC    30.0
✨ 无需更改任何代码。 所有操作都是惰性的——它们被记录并编译成优化的 SQL,仅在需要结果时执行。
为什么选择 DataStore?
| 特性 | pandas | DataStore |
|---|---|---|
| API | ✅ 熟悉 | ✅ 相同的 pandas API |
| 大型数据集 | ❌ 受内存限制 | ✅ SQL 优化 |
| 学习曲线 | ✅ 简单 | ✅ 无——语法相同 |
| 性能 | ❌ 单线程 | ✅ ClickHouse 引擎 |
处理文件
from datastore import DataStore

# 加载任何文件格式
ds = DataStore.from_file("data.parquet")  # 或 CSV、JSON、ORC...

# 探索您的数据
print(ds.head())       # 预览前 5 行
print(ds.shape)        # (行数, 列数)
print(ds.columns)      # 列名

# 使用方法链构建查询
result = (ds
    .select("product", "revenue", "date")
    .filter(ds.revenue > 1000)
    .sort("revenue", ascending=False)
    .head(10))

print(result)
查询任何数据源
from datastore import DataStore

# S3(匿名访问)
ds = DataStore.uri("s3://bucket/data.parquet?nosign=true")

# MySQL
ds = DataStore.uri("mysql://user:pass@localhost:3306/mydb/users")

# PostgreSQL
ds = DataStore.uri("postgresql://user:pass@localhost:5432/mydb/products")

# 以及更多:SQLite、MongoDB、ClickHouse、HDFS、Azure、GCS...
Pandas API 覆盖范围
DataStore 实现了 全面的 pandas 兼容性:
| 类别 | 覆盖范围 |
|---|---|
| DataFrame 方法 | 209 个方法 |
| Series.str 访问器 | 56 个方法 |
| Series.dt 访问器 | 42+ 个方法 |
| ClickHouse SQL 函数 | 334 个函数 |
# 所有这些 pandas 方法都有效:
df.drop(columns=['unused'])
df.fillna(0)
df.assign(revenue=lambda x: x['price'] * x['quantity'])
df.sort_values('revenue', ascending=False)
df.groupby('category').agg({'revenue': 'sum', 'quantity': 'mean'})
df.merge(other_df, on='id')
df.pivot_table(values='sales', index='date', columns='product')
# ... 以及 200+ 更多方法
字符串和日期时间操作
# 通过 .str 访问器进行字符串操作
ds['name'].str.upper()
ds['email'].str.contains('@gmail')
ds['text'].str.replace('old', 'new')

# 通过 .dt 访问器进行日期时间操作
ds['date'].dt.year
ds['date'].dt.month
ds['timestamp'].dt.hour
文档
- Pandas 兼容性指南 - 支持方法的完整列表
- 函数参考 - 334 个 ClickHouse SQL 函数
- 迁移指南 - pandas 用户的逐步指南
SQL API
对于偏好 SQL 或需要高级 ClickHouse 功能的用户:
在命令行中运行
python3 -m chdb SQL [OutputFormat]
python3 -m chdb "SELECT 1,'abc'" Pretty
数据输入
可通过以下方法访问磁盘和内存数据格式:
🗂️ 基于连接的 API
import chdb

# 创建连接(默认内存数据库)
conn = chdb.connect(":memory:")
# 或使用基于文件的连接:conn = chdb.connect("test.db")

# 创建游标
cur = conn.cursor()

# 执行查询
cur.execute("SELECT number, toString(number) as str FROM system.numbers LIMIT 3")

# 以不同方式获取数据
print(cur.fetchone())    # 单行:(0, '0')
print(cur.fetchmany(2))  # 多行:((1, '1'), (2, '2'))

# 获取列信息
print(cur.column_names())  # ['number', 'str']
print(cur.column_types())  # ['UInt64', 'String']

# 将游标用作迭代器
cur.execute("SELECT number FROM system.numbers LIMIT 3")
for row in cur:
    print(row)

# 完成后始终关闭资源
cur.close()
conn.close()
更多详情,请参见 examples/connect.py。
🗂️ 对文件进行查询
(Parquet、CSV、JSON、Arrow、ORC 及 60+ 格式)您可以执行 SQL 并返回所需格式的数据。
import chdb
res = chdb.query('select version()', 'Pretty'); print(res)
处理 Parquet 或 CSV
# 更多数据类型格式请见 tests/format_output.py
res = chdb.query('select * from file("data.parquet", Parquet)', 'JSON'); print(res)
res = chdb.query('select * from file("data.csv", CSV)', 'CSV');  print(res)
print(f"SQL 读取 {res.rows_read()} 行,{res.bytes_read()} 字节,存储读取 {res.storage_rows_read()} 行,{res.storage_bytes_read()} 字节,耗时 {res.elapsed()} 秒")
参数化查询
import chdb

df = chdb.query(
    "SELECT toDate({base_date:String}) + number AS date "
    "FROM numbers({total_days:UInt64}) "
    "LIMIT {items_per_page:UInt64}",
    "DataFrame",
    params={"base_date": "2025-01-01", "total_days": 10, "items_per_page": 2},
)
print(df)
#         date
# 0 2025-01-01
# 1 2025-01-02
Pandas dataframe 输出
# 更多信息请见 https://clickhouse.com/docs/en/interfaces/formats
chdb.query('select * from file("data.parquet", Parquet)', 'Dataframe')
🗂️ 对表进行查询
(Pandas DataFrame、Parquet 文件/字节、Arrow 字节)对 Pandas DataFrame 进行查询
import chdb.dataframe as cdf
import pandas as pd
# 连接 2 个 DataFrame
df1 = pd.DataFrame({'a': [1, 2, 3], 'b': ["one", "two", "three"]})
df2 = pd.DataFrame({'c': [1, 2, 3], 'd': ["①", "②", "③"]})
ret_tbl = cdf.query(sql="select * from __tbl1__ t1 join __tbl2__ t2 on t1.a = t2.c",
                  tbl1=df1, tbl2=df2)
print(ret_tbl)
# 对 DataFrame 表进行查询
print(ret_tbl.query('select b, sum(a) from __table__ group by b'))
# Pandas DataFrames 会自动注册为 ClickHouse 中的临时表
chdb.query("SELECT * FROM Python(df1) t1 JOIN Python(df2) t2 ON t1.a = t2.c").show()
🗂️ 带状态会话的查询
from chdb import session as chs

## 在临时会话中创建数据库、表、视图,会话删除时自动清理。
sess = chs.Session()
sess.query("CREATE DATABASE IF NOT EXISTS db_xxx ENGINE = Atomic")
sess.query("CREATE TABLE IF NOT EXISTS db_xxx.log_table_xxx (x String, y Int) ENGINE = Log;")
sess.query("INSERT INTO db_xxx.log_table_xxx VALUES ('a', 1), ('b', 3), ('c', 2), ('d', 5);")
sess.query(
    "CREATE VIEW db_xxx.view_xxx AS SELECT * FROM db_xxx.log_table_xxx LIMIT 4;"
)
print("从视图查询:\n")
print(sess.query("SELECT * FROM db_xxx.view_xxx", "Pretty"))
另见:test_stateful.py。
🗂️ 使用 Python DB-API 2.0 进行查询
import chdb.dbapi as dbapi
print("chdb 驱动版本:{0}".format(dbapi.get_client_info()))

conn1 = dbapi.connect()
cur1 = conn1.cursor()
cur1.execute('select version()')
print("描述:", cur1.description)
print("数据:", cur1.fetchone())
cur1.close()
conn1.close()
🗂️ 使用 UDF(用户定义函数)进行查询
from chdb.udf import chdb_udf
from chdb import query

@chdb_udf()
def sum_udf(lhs, rhs):
    return int(lhs) + int(rhs)

print(query("select sum_udf(12,22)"))
关于 chDB Python UDF(用户定义函数)装饰器的一些说明。
- 函数应为无状态的。因此,仅支持 UDF,不支持 UDAF(用户定义聚合函数)。
- 默认返回类型为 String。如果想更改返回类型,可以将返回类型作为参数传入。
返回类型应为以下之一:https://clickhouse.com/docs/en/sql-reference/data-types - 函数应接受类型为 String 的参数。由于输入是 TabSeparated 格式,所有参数都是字符串。
- 该函数将对输入数据的每一行被调用。类似这样:
def sum_udf(lhs, rhs): return int(lhs) + int(rhs) for line in sys.stdin: args = line.strip().split('\t') lhs = args[0] rhs = args[1] print(sum_udf(lhs, rhs)) sys.stdout.flush() - 该函数应为纯 Python 函数。您必须在函数内部导入所使用的所有 Python 模块。
def func_use_json(arg): import json ... - 使用的 Python 解释器与运行脚本的解释器相同。从
sys.executable获取。
另见:test_udf.py。
🗂️ 流式查询
通过分块流式处理,以恒定的内存使用量处理大型数据集。
from chdb import session as chs

sess = chs.Session()

# 示例 1:使用流式查询的基本示例
rows_cnt = 0
with sess.send_query("SELECT * FROM numbers(200000)", "CSV") as stream_result:
    for chunk in stream_result:
        rows_cnt += chunk.rows_read()

print(rows_cnt) # 200000

# 示例 2:使用 fetch() 手动迭代
rows_cnt = 0
stream_result = sess.send_query("SELECT * FROM numbers(200000)", "CSV")
while True:
    chunk = stream_result.fetch()
    if chunk is None:
        break
    rows_cnt += chunk.rows_read()

print(rows_cnt) # 200000
更多详情,请参见 test_streaming_query.py。
🗂️ Python 表引擎
对 Pandas DataFrame 进行查询
import chdb
import pandas as pd
df = pd.DataFrame(
    {
        "a": [1, 2, 3, 4, 5, 6],
        "b": ["tom", "jerry", "auxten", "tom", "jerry", "auxten"],
    }
)

chdb.query("SELECT b, sum(a) FROM Python(df) GROUP BY b ORDER BY b").show()
对 Arrow 表进行查询
import chdb
import pyarrow as pa
arrow_table = pa.table(
    {
        "a": [1, 2, 3, 4, 5, 6],
        "b": ["tom", "jerry", "auxten", "tom", "jerry", "auxten"],
    }
)

chdb.query("SELECT b, sum(a) FROM Python(arrow_table) GROUP BY b ORDER BY b").show()
另见:test_query_py.py。
🧠 AI 辅助的 SQL 生成
chDB 可以将自然语言提示翻译成 SQL。通过连接(或会话)字符串参数配置 AI 客户端:
ai_provider:openai或anthropic。当设置了ai_base_url时,默认为 OpenAI 兼容,否则自动检测。ai_api_key:API 密钥;回退到AI_API_KEY、OPENAI_API_KEY或ANTHROPIC_API_KEY环境变量。ai_base_url:用于 OpenAI 兼容端点的自定义基础 URL。ai_model:模型名称(例如gpt-4o-mini、claude-3-opus-20240229)。
import chdb

# 使用环境变量 OPENAI_API_KEY/AI_API_KEY/ANTHROPIC_API_KEY 作为凭证
conn = chdb.connect("file::memory:?ai_provider=openai&ai_model=gpt-4o-mini")
conn.query("CREATE TABLE nums (n UInt32) ENGINE = Memory")
conn.query("INSERT INTO nums VALUES (1), (2), (3)")

sql = conn.generate_sql("按 n 降序选择 nums 中的所有行")
print(sql)  # 例如:SELECT * FROM nums ORDER BY n DESC

# ask():一次调用生成 + 执行
print(conn.ask("列出数字表", format="Pretty"))
演示和示例
- 项目文档 和 使用示例
- Colab Notebooks 及其他 脚本示例
基准测试
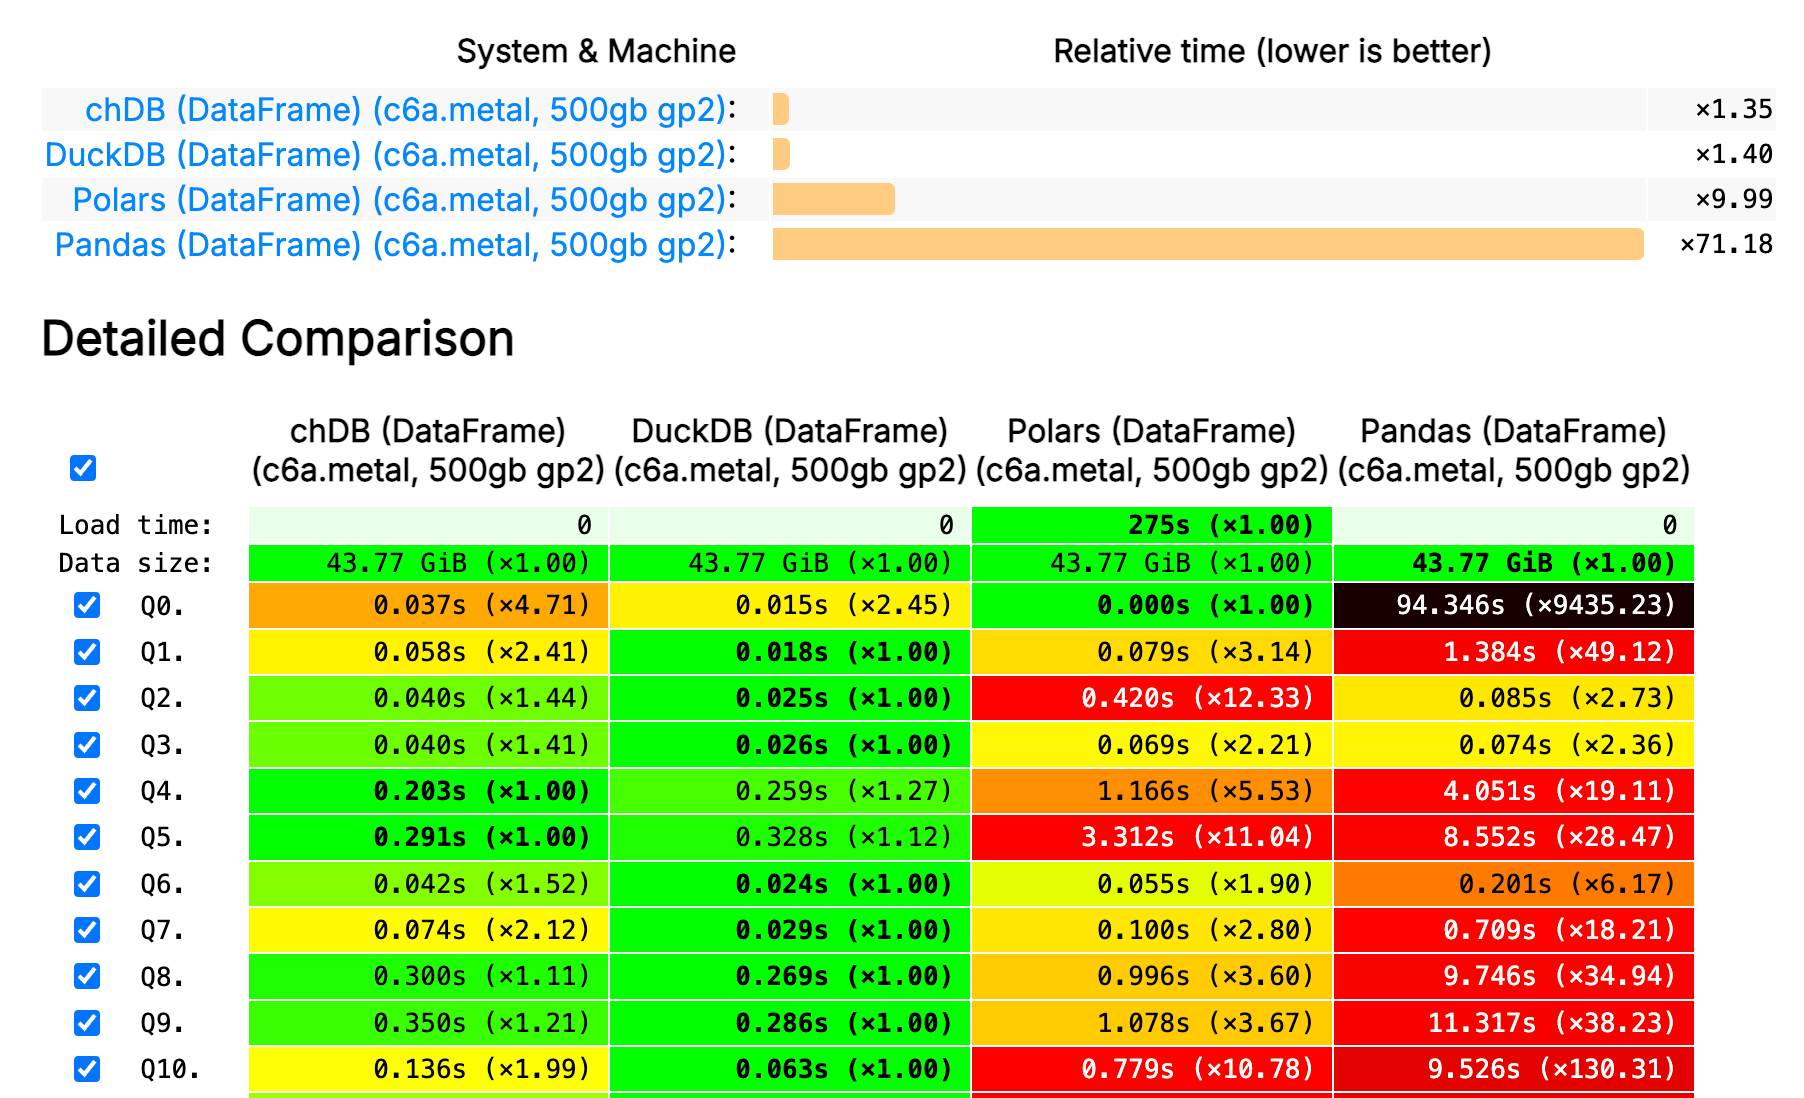
文档
- chdb 特定的示例和文档请参考 chDB 文档
- SQL 语法请参考 ClickHouse SQL 参考
- DataStore API 请参见 Pandas 兼容性指南
活动
- 在 ClickHouse v23.7 livehouse! 演示 chDB 并查看 幻灯片
贡献
贡献是开源社区成为学习、启发和创造的绝佳之地的原因。您的任何贡献都是非常受欢迎的。
您可以提供帮助的地方:
- 帮助测试并报告错误
- 帮助改进文档
- 帮助提高代码质量和性能
绑定
我们欢迎其他语言的绑定,请参阅 绑定 获取更多详情。
版本指南
请参阅 VERSION-GUIDE.md 获取更多详情。
论文
许可证
Apache 2.0,更多信息请参见 LICENSE。
致谢
chDB 主要基于 ClickHouse [^1]
由于商标和其他原因,我将其命名为 chDB。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 28
 0
- 0


 已为社区贡献65条内容

所有评论(0)