从RNN到LSTM、BiLSTM
NLP-AHU-206
循环神经网络(RNN)及其衍生变体,在自然语言处理、语音识别、时间序列预测等多个关键领域中占据着不可或缺的地位。但不容忽视的是,传统RNN在处理长序列数据时,普遍面临梯度消失或梯度爆炸的困境,这使得它难以精准捕捉序列中远距离的依赖关系,极大限制了其实际应用效果。长短期记忆网络(LSTM)的问世,针对性地缓解了这一核心痛点,而双向长短时记忆网络(BiLSTM)则在LSTM的基础上进一步升级,通过同时捕捉序列的正向时序信息与反向上下文关联,大幅增强了模型对时序数据的建模能力和理解精度。
一、RNN
1. 设计启发
人类处理序列信息时,会自然地将过去的记忆与当前的输入结合——比如读句子时,我们会根据前文语境理解当前词语的含义;听音乐时,会记住前面的旋律来感知整体节奏。传统的神经网络(如CNN)无法处理这种“时序依赖”,它们的输入是独立的,无法捕捉序列中元素的先后关联。
RNN(Recurrent Neural Network,循环神经网络)的设计灵感,正是源于对人类这种“时序记忆能力”的模仿:让网络在处理当前输入时,能够利用上一时刻的“记忆”(隐藏状态),从而建立序列中不同时刻的关联,实现对时序数据的建模。
2. 结构设计
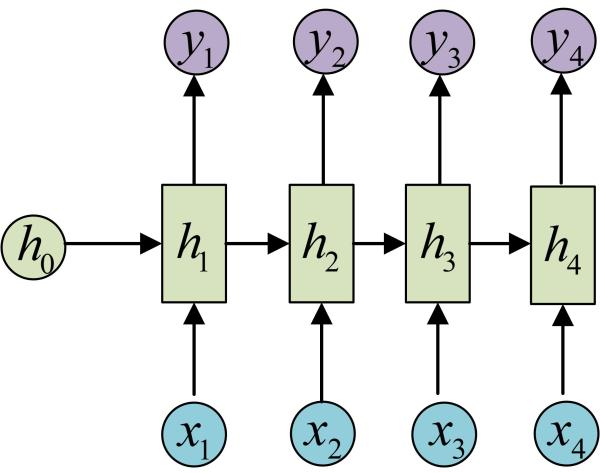
RNN的结构极其简洁,核心是一个“循环单元”(Recurrent Unit),其核心逻辑是:隐藏状态会在时间步上不断传递和更新,将过去的信息携带到当前时刻。
从结构上看,RNN可以理解为“将同一个神经网络单元,在不同时间步上重复使用”。具体来说,网络接收两个输入:当前时刻的输入数据,以及上一时刻的隐藏状态
;输出当前时刻的隐藏状态
(可进一步映射为任务输出
)。这种循环结构,让RNN能够“记住”之前的信息,并将其融入当前的计算中。
3. RNN的局限
尽管RNN作为时序建模的初代尝试,打破了传统神经网络输入独立的局限,实现了时序依赖的初步捕捉,但它存在诸多难以规避的局限性,这些缺陷严重限制了其实际应用场景和效果。
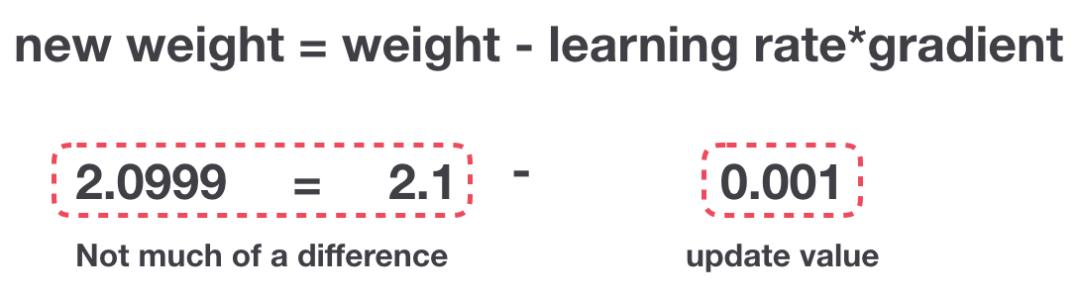
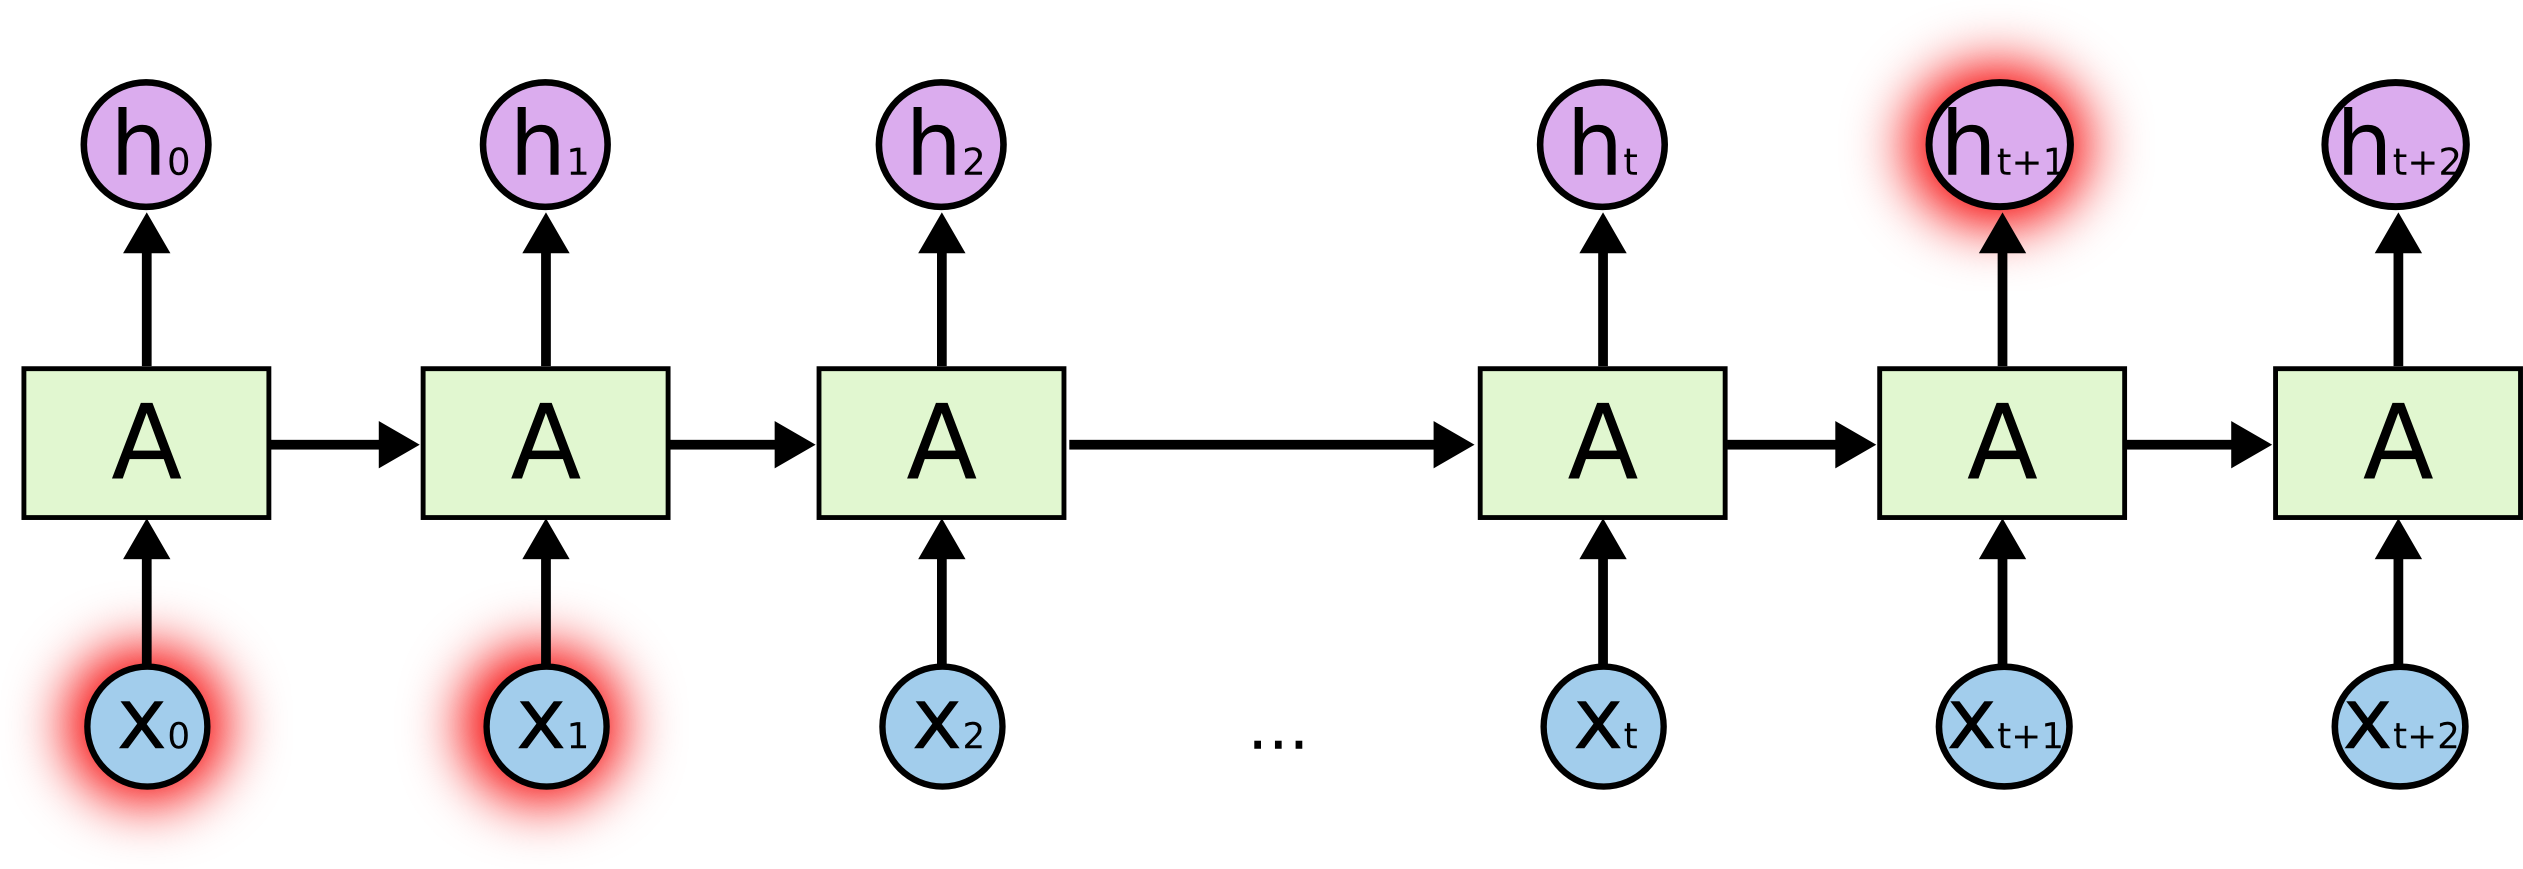
随着时间步的增加,梯度在反向传播时会出现梯度消失与梯度爆炸问题——当序列过长(比如超过20个时间步),早期时刻的信息会被逐渐“遗忘”,网络无法捕捉长距离的时序依赖,这也限制了RNN的实际应用。梯度是用于更新神经网络的权重值(新的权值 = 旧权值 - 学习率*梯度),梯度会随着时间的推移不断下降减少,而当梯度值变得非常小时,就不会继续学习。
其次,参数共享的局限性。RNN每个时间步共享同一套权重参数,虽能减少参数数量、提升训练效率,但无法针对不同时间步的输入特征进行差异化学习。例如在处理自然语言时,句子中不同位置的词语重要性不同,共享参数难以精准捕捉这种差异,导致建模精度受限。
此外,RNN还存在输出依赖偏差,即当前时刻的输出过度依赖于近期输入,对远期输入的响应微弱,难以处理长序列场景下的复杂依赖关系。换句话说,RNN 会受到短时记忆的影响。如果一条序列足够长,那它们将很难将信息从较早的时间步传送到后面的时间步。
RNN的核心算法细节(隐藏状态更新与数学表达)是理解其局限性的基础——核心数学公式如下:
1. 隐藏状态更新公式(核心):
2. 当前时刻输出公式):
其中,(隐藏层循环权重)的反复乘积的是梯度消失/爆炸的直接诱因,而tanh激活函数的饱和特性则进一步放大了这一问题。
二、LSTM
1. 设计启发
RNN的致命缺陷的是“记不住长序列”,而人类的记忆特点是“选择性记忆”——我们会主动记住重要的信息(比如朋友的生日),忘记无关的细节(比如昨天吃的早餐)。1997年,Sepp Hochreiter和Jürgen Schmidhuber正是受这种“选择性记忆机制”启发,提出了LSTM(Long Short-Term Memory,长短期记忆网络),核心目标是:让网络能够自主决定“记住什么、忘记什么”,从而解决梯度消失问题,捕捉长距离时序依赖。
更具体地说,LSTM的设计灵感还源于神经科学中神经元的长期电位机制,通过引入“记忆单元”模拟生物神经元对信息的选择性存储,后续经Yoshua Bengio、Razvan Pascanu等学者优化,逐渐形成了现代标准LSTM架构。其核心思想是:在RNN的基础上,增加“门控机制”和“记忆细胞”,实现对信息的精细化控制。
2. 结构设计
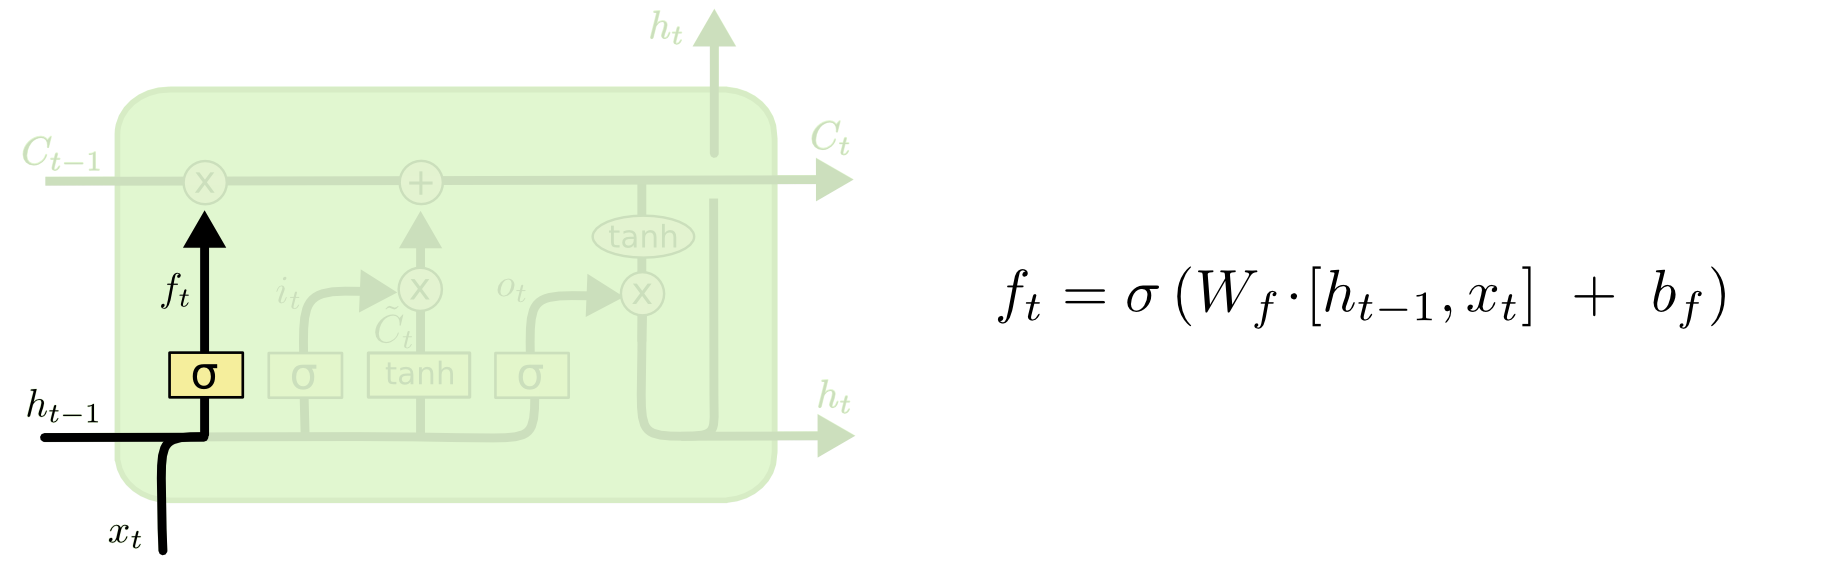
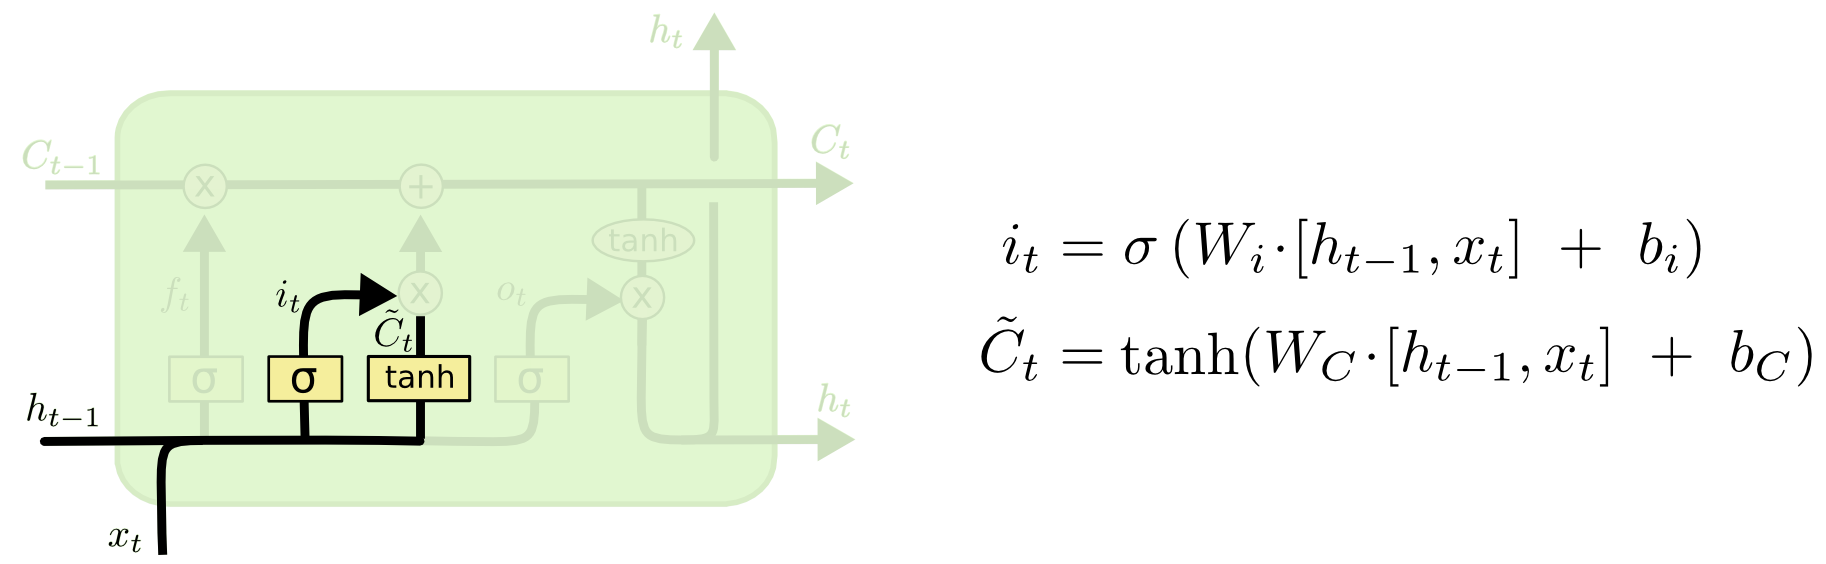
LSTM的核心改进的是引入了「记忆细胞」(Cell State)和「三个门控单元」(遗忘门、输入门、输出门),替代了RNN简单的隐藏状态更新逻辑。可以把LSTM的记忆细胞想象成“一条信息高速公路”,信息在这条公路上可以稳定传递,减少损耗;而三个门控单元则像“高速公路上的开关”,控制信息的进出和保留。
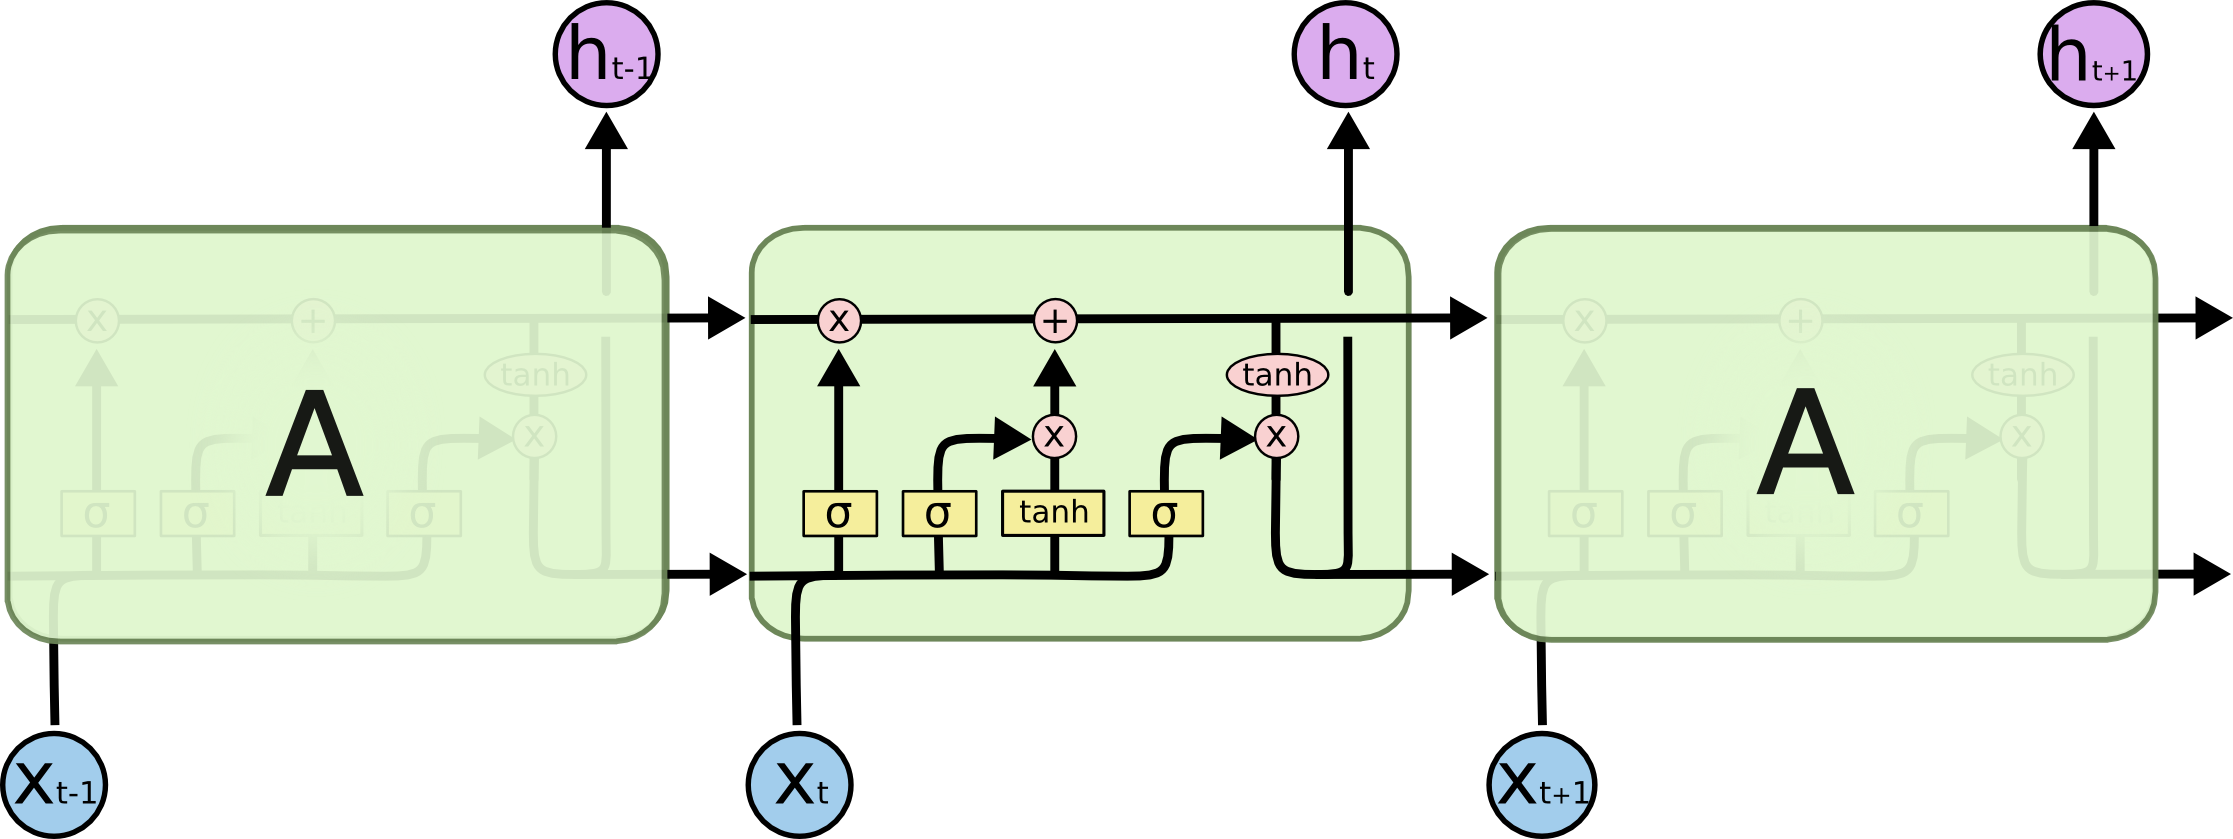
三个门控单元的核心作用:
-
遗忘门(Forget Gate):决定“遗忘”上一时刻记忆细胞中的哪些信息(比如处理句子时,遗忘与当前语义无关的前文细节);
-
输入门(Input Gate):决定“保留”当前输入中的哪些信息,并将其更新到记忆细胞中(比如处理情感分析时,强化情感关键词的权重);
-
输出门(Output Gate):决定“输出”记忆细胞中的哪些信息,作为当前时刻的隐藏状态(比如处理机器翻译时,优先输出与主句相关的信息)。
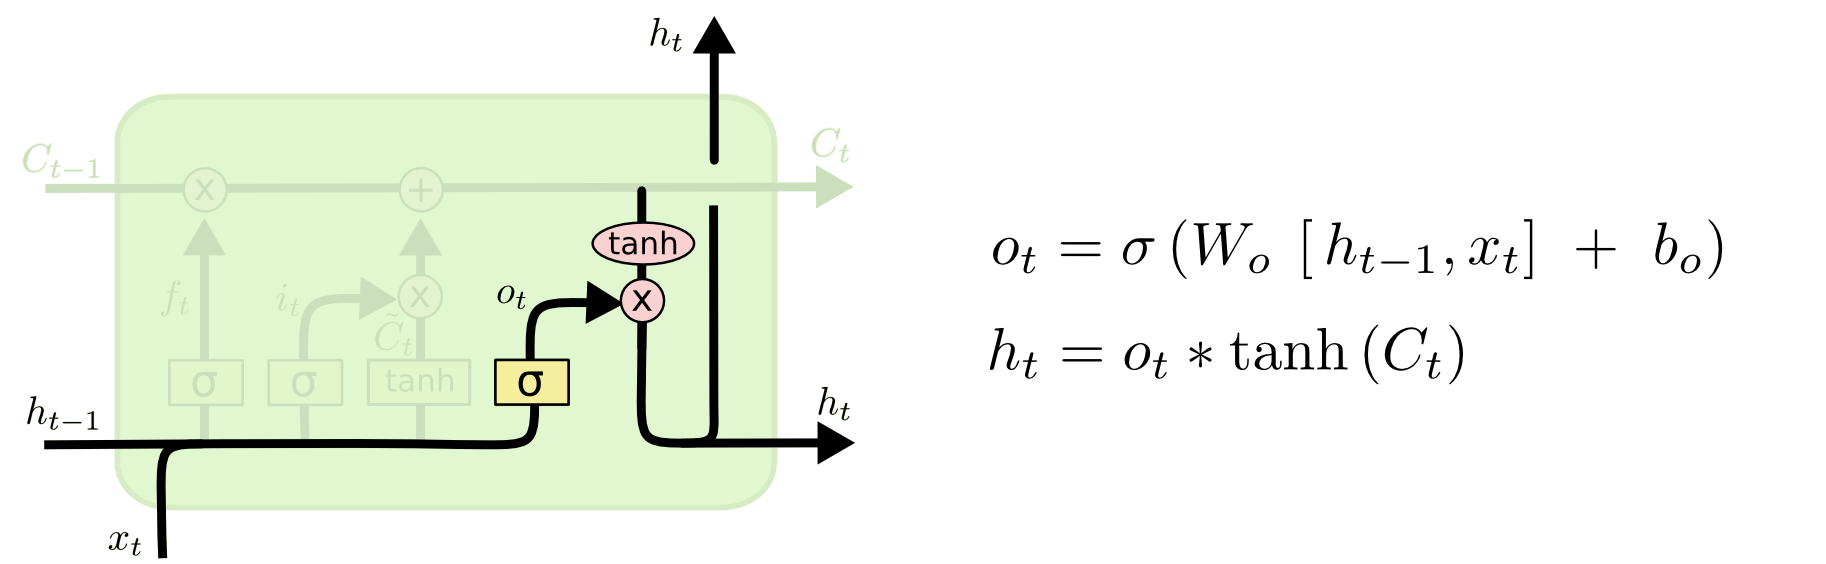
这种结构设计,让LSTM的记忆细胞能够“平稳更新”,梯度在反向传播时不会出现指数级衰减,从而有效解决了RNN的梯度消失问题,能够处理数百个时间步的长序列。
3. LSTM的局限
LSTM通过三门控机制和记忆细胞,有效解决了RNN的梯度消失问题,大幅提升了长序列建模能力,但它并非完美无缺,仍存在诸多局限性,制约了其在部分场景下的应用效果。
第一,计算复杂度高、参数冗余。相较于RNN,LSTM新增了遗忘门、输入门、输出门及候选记忆细胞四个核心结构,权重矩阵和偏置项数量大幅增加,导致模型参数规模显著扩大,训练速度变慢,对硬件资源的要求更高,难以适配算力有限的场景。
第二,无法捕捉双向上下文信息。LSTM本质上是单向模型,仅能从左到右(正向)处理序列,只能利用当前时刻之前的历史信息,无法利用当前时刻之后的未来信息。在自然语言处理、语音识别等需要双向上下文支撑的任务中,这种单向性会导致模型对语义、语境的理解不够全面,建模精度受限。
三、BiLSTM
1. 设计启发
LSTM解决了长距离记忆问题,但它有一个局限:只能“从左到右”(正向)处理序列,无法利用“未来”的信息。而人类理解序列信息时,往往会结合“过去”和“未来”的上下文;再比如语音识别中,当前音节的含义,需要结合前后音节才能准确判断。
BiLSTM(Bidirectional LSTM,双向长短期记忆网络)的设计灵感,正是源于这种“双向理解”的需求:将两个方向相反的LSTM并行结合,一个正向处理序列(从左到右),一个反向处理序列(从右到左),最终融合两个方向的特征,实现对双向上下文的捕捉。
2. 结构设计
BiLSTM的结构并不复杂,本质是“两个独立的LSTM(正向LSTM和反向LSTM)的并行组合”,核心特点是:
-
两个LSTM共享输入序列,但处理方向相反,权重参数完全独立(互不干扰);
-
正向LSTM(Forward LSTM):从序列起始位置
向结束位置
处理,捕捉“过去到现在”的时序依赖;
-
反向LSTM(Backward LSTM):从序列结束位置
-
每个时间步的最终输出,是正向LSTM和反向LSTM在该时刻隐藏状态的“拼接”(维度翻倍),融合双向上下文信息。
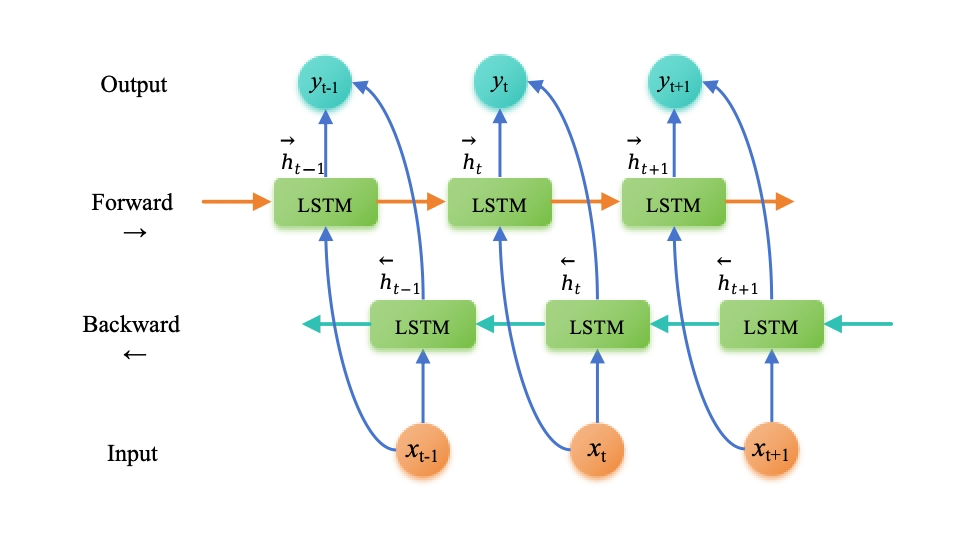
需要注意的是,BiLSTM并非“正向LSTM输出喂给反向LSTM”,而是两个LSTM并行运行、独立计算,最后仅在输出层进行特征融合——这种并行性保证了两个方向能学到互补的模式,避免了时序依赖的丢失。
四、总结
从RNN到LSTM再到BiLSTM,本质上是一场“不断弥补缺陷、贴合实际需求”的演进:
1. RNN打破了传统神经网络“输入独立”的局限,首次实现了时序依赖建模,但受限于梯度消失,无法处理长序列;
2. LSTM通过“三门控+记忆细胞”的仿生设计,解决了RNN的遗忘难题,让长序列建模成为可能;
3. BiLSTM在LSTM的基础上,补充了双向上下文的捕捉能力,贴合人类对序列信息的理解习惯,成为NLP等领域的主流算法。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)