DolphinScheduler 任务全卡死:点了「停止」,200+ 任务再没动过
📝 摘要:重启 DolphinScheduler 后 200+ 补数任务把刚恢复的 ClickHouse 再次打挂,串行等待的队伍随之全锁死。而点那下「停止」才是致命一击:队首本已是「失败」这个终态,被推回「准备停止」这个非终态,唤醒下一个的事件从此永不触发,重启也没用。UI 无解就下到元数据库,清掉两张实例表里 state=4/14 的僵尸记录,都带 process_definition_code 限定,再重新补数。⚠️ 别顺手改成「串行抛弃」——补数这类任务丢一个实例就是丢一段数据。
一次 ClickHouse 宕机引发的「血案」:200+ 补数任务把刚恢复的 CK 又打挂,串行等待的队伍随之全部锁死。我点了「停止」,它从「失败」变成「准备停止」,然后就再没动过。本文记录完整排查过程、对照源码讲清这下「停止」为什么反而是致命一击,以及 UI 无解时怎么下到元数据库救场。
一、事故背景
1.1 事故经过
时间线:
- 2026-02-03:ClickHouse 挂了,DolphinScheduler 任务随之停止
- 2026-02-04:发现问题,重启 Dolphin,瞬间产生 200+ 补数任务
- 结果:任务洪峰直接把刚恢复的 ClickHouse 再次打挂
重启 CK 后,发现任务全部阻塞,界面一片红:
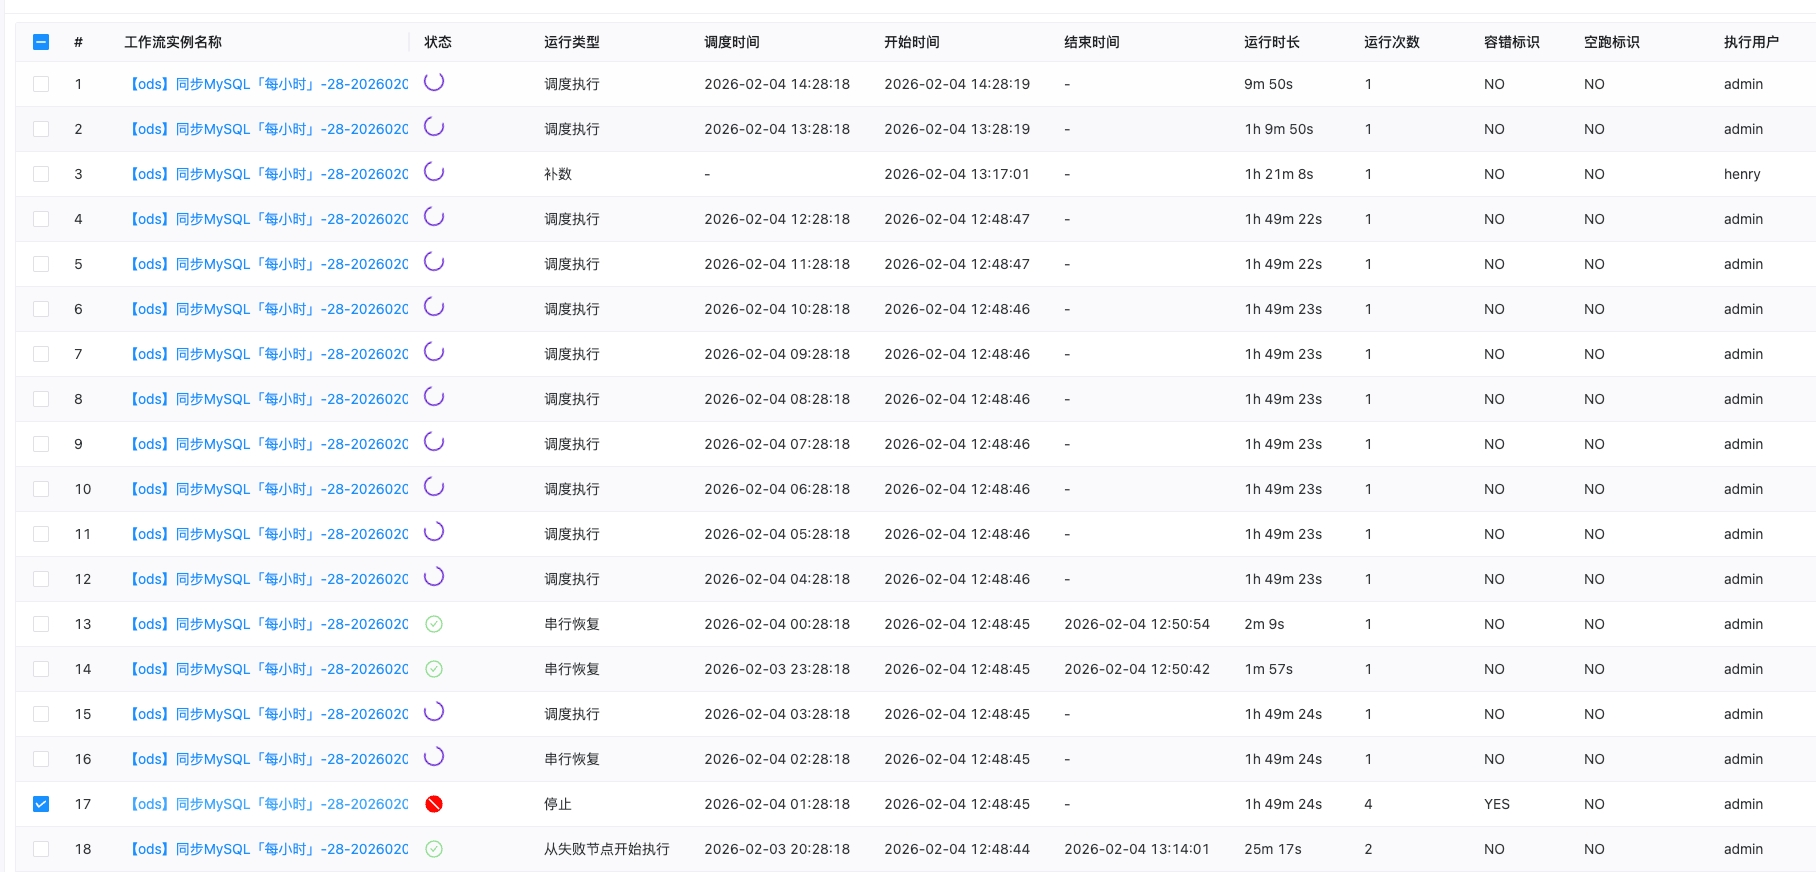
现象:
- 最底部的任务:状态 = 失败,点击停止后变成「准备停止」,卡住不动
- 后续所有任务:状态 = 串行等待
- 整个工作流:死锁,彻底动不了
机器配置:4C 32G,资源不是问题,问题出在调度策略上。
1.2 原因分析
罪魁祸首:任务执行策略配置了「串行等待」
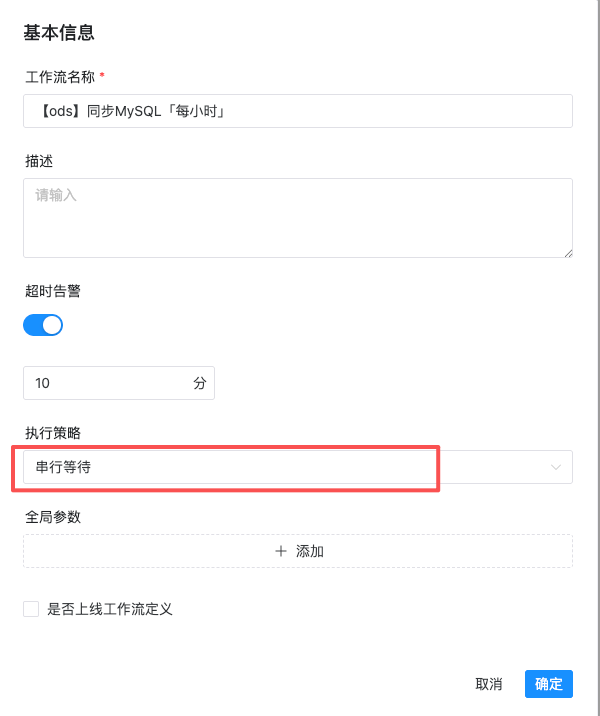
串行等待的坑(下面四条对着 DolphinScheduler 3.2.0 源码走一遍):
- 新实例进来先被置成
SERIAL_WAIT(state=14)。它要能自己转成运行中,前提是「比自己 id 小、且状态还落在运行态集合里」的实例一个都查不到。这个集合是{0, 1, 14, 17}——提交成功、正在运行、串行等待、等待运行; - 队伍往前挪只有一个入口:实例结束时触发
endProcess(),由它调checkSerialProcess(),给 id 最小的那个排队实例投一条RECOVER_SERIAL_WAIT命令; - 关键就卡在这——
endProcess()只在状态事件带着终态进来时才会被调用。而「准备停止」(state=4)不是终态,带着它进来的事件走的是另一条分支:去killAllTasks()杀任务,压根不碰唤醒逻辑; - 于是后面那一串
state=14的实例没有任何人来唤醒。唤醒是事件驱动的,系统里没有定时任务去重扫这条队列 → 死锁形成。
第 1 条那个集合值得多看一眼:
14 串行等待自己也在里面。所以队伍是一环扣一环的——实例 3 看见实例 2 挂在 14 上就继续等,实例 2 又在等实例 1。队首一旦不动,整条链条全锁死。
⚠️ 更扎心的是:点「停止」这个动作,本身可能就是压垮队伍的那一下。
回看 §1.1 的现象——队首原本的状态是失败,我点了停止,它才变成「准备停止」。对照上面第 3 条:失败(6)是终态,准备停止(4)不是。也就是说,那一点把队首从终态推回了非终态,从「本来还有机会触发唤醒」变成「彻底触发不了」。
之后它为什么就停在那儿不动了?源码里,READY_STOP 的实例会去 killAllTasks() 杀任务,只有任务真的杀干净、实例转成「停止」(5,终态)之后,才轮得到 endProcess()。而当时 ClickHouse 还挂着,任务卡在那儿杀不干净(这一步是推断,当时没留现场日志),实例就永远停在 4。
🤔 一个我至今没查实的疑点:既然「失败」本身就是终态,那在我点停止之前,唤醒就该已经发生过、队伍也该往前挪了才对。可当时后面确实全挂在「串行等待」上。
可能是我看到界面时队首其实还在跑、「失败」是之后才写进去的,也可能是唤醒发过但下一个接着失败、我正好撞见级联中间那一帧。现场日志没留,这条只能存疑。 但不管起点是哪种,点那下停止之后队伍彻底没救了——这一段是确定的。
尝试通过「补数运行」重新执行任务,直接报错:
「已经有一个进行中的任务了」(大意如此,现场没保留)
重启 Dolphin?没用。
再点一次停止?它已经卡在「准备停止」了,这个按钮此刻只会让它更死。
等它自己恢复?别做梦了。
第一条最反直觉——重启这么重的动作居然不解决问题。因为 Master 起来后并不会去重扫 SERIAL_WAIT 队列,它只等事件;而那个事件的产地,正是永远不会结束的队首。队首卡一天,队伍就排一天。
二、解决方案:直接改库
既然 UI 层面无能为力,那就釜底抽薪——直接操作 MySQL 元数据库。
这不是我第一次靠改元数据库救活调度了,另一次是数据库迁移后 AUTO_INCREMENT 回退导致工作流触发即死,同样是 UI 上完全看不出名堂、只能下到表里看。
2.1 定位关键表
打开 DolphinScheduler 的元数据库,共 65 张表(本文环境为 3.2.0,表数量和状态码都随版本变,照搬前先对一下自己的版本)。
根据命名规律,t_ds_process_* 开头的表与任务执行相关:
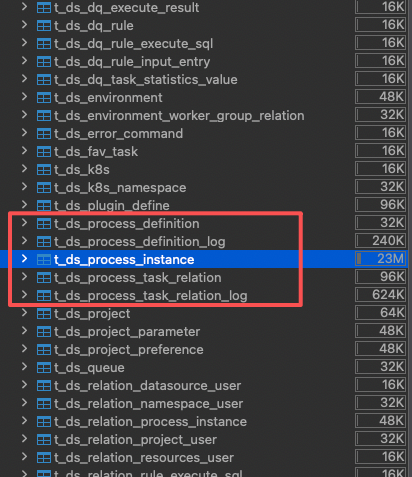
核心表:
| 表名 | 用途 |
|---|---|
t_ds_process_instance | 工作流实例(每次运行生成一条记录) |
t_ds_task_instance | 任务实例(工作流中每个节点的执行记录) |
t_ds_process_definition | 工作流定义 |
2.2 查看异常数据
查询 t_ds_process_instance 表,找到那些阻塞的任务实例:
SELECT id, name, state, start_time, end_time
FROM t_ds_process_instance
WHERE state NOT IN (7)  -- 7 = 执行成功
ORDER BY id DESC
LIMIT 50;
状态码对照(3.2.0 的 WorkflowExecutionStatus 枚举,想自查就搜这个类名):
| state | 含义 | 是否终态 |
|---|---|---|
| 0 | 提交成功 | 否 |
| 1 | 正在运行 | 否 |
| 2 | 准备暂停 | 否 |
| 3 | 暂停 | 是 |
| 4 | 准备停止 | 否 ← 本次卡死的就是它 |
| 5 | 停止 | 是 |
| 6 | 失败 | 是 |
| 7 | 成功 | 是 |
| 12 | 延时执行 | 否 |
| 14 | 串行等待 | 否 ← 排队中的全是它 |
| 15 / 16 | 准备阻断 / 阻断 | 否 / 是 |
| 17 | 等待运行 | 否 |
「是否终态」这一列是本文的关键——§1.2 说过,只有实例走到终态才会触发 endProcess() 去唤醒队伍。4 和 14 都不是终态,所以它们凑在一起就是一潭死水。
果然,一堆 state = 14(串行等待)和 state = 4(准备停止)的记录:
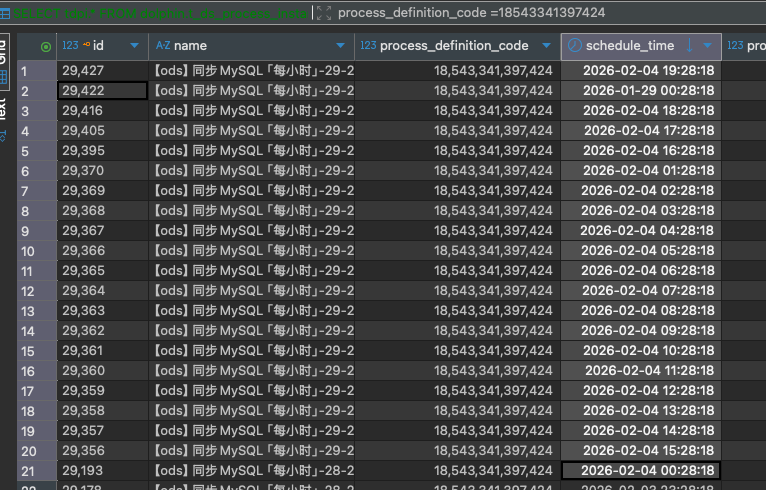
知道该盯哪两个状态码之后,用这条确认一下规模和积压时长:
SELECT state, COUNT(*) AS `条数`, MIN(start_time) AS `最早一条`
FROM t_ds_process_instance
WHERE state IN (4, 14)
GROUP BY state;
2.3 清理阻塞数据
方案一:直接删除(简单粗暴)
⚠️ 顺序是「先子表、后主表」,两条的过滤范围必须完全一致——理由见本节末的补注,别调换。
-- ① 先删任务实例(子表):此时主表记录还在,子查询才捞得到
DELETE FROM t_ds_task_instance
WHERE process_instance_id IN (
    SELECT id FROM t_ds_process_instance
    WHERE state IN (4, 14)  -- 准备停止、串行等待
      AND process_definition_code = <你的工作流code>
);

-- ② 再删工作流实例(主表):范围与①逐字一致
DELETE FROM t_ds_process_instance
WHERE state IN (4, 14)
  AND process_definition_code = <你的工作流code>;
方案二:修改状态(相对温和)
-- 把阻塞实例改成「失败」这个终态,让它不再占着队伍
UPDATE t_ds_process_instance
SET state = 6  -- 6 = 失败
WHERE state IN (4, 14)
  AND process_definition_code = <你的工作流code>;  -- ← 千万别省
注意:操作前务必备份数据,生产环境别直接 DELETE,先 SELECT 确认。
⚠️ 那行
process_definition_code不是可选项。省掉它,这条 UPDATE 会把整个库里所有工作流的「准备停止 / 串行等待」记录一起刷成失败——包括那些此刻正常排队、马上就轮到自己的实例。一条 SQL 从救一个工作流变成祸害全平台。💡 还要认清它到底做了什么:改库不会让队伍自己重新跑起来。唤醒靠的是 Master 进程里那个
endProcess()事件(见 §1.2),直接 UPDATE 数据库绕过了整条事件链。这一步的作用是把占位的僵尸记录清出去,让下一步的「重新补数」能建得起新实例——真正让任务跑起来的是 §2.4,不是这条 SQL。
⚠️ 补注(2026-08-24 发现,2026-09-12 已就地订正):方案一这两条 DELETE,本文最早发布的版本顺序是反的。
早期版本先删主表
t_ds_process_instance,再用子查询SELECT id FROM t_ds_process_instance WHERE state IN (4,14)去删子表。可主表记录已经没了,这个子查询再也查不到那些 id——于是t_ds_task_instance里对应的任务实例一条都删不掉,全变成孤儿留在库里。当时两条的过滤范围也不一致:第一条带process_definition_code,第二条没有。上面的 SQL 已按「先子表、后主表 + 范围逐字一致」改好,照抄即可。如果你抄的是更早的版本、已经按反序执行过了,用这条把孤儿记录捞出来再清:
SELECT * FROM t_ds_task_instance ti
WHERE NOT EXISTS (SELECT 1 FROM t_ds_process_instance pi WHERE pi.id = ti.process_instance_id);
方案二(改 state)没有孤儿这个问题——只更新不删除,主表记录还在,子表自然不会变孤儿。生产环境本来也更推荐方案二。但范围限定那条它一样躲不掉,别省
process_definition_code。
2.4 重新补数
清理完数据后,回到 DolphinScheduler 界面:
工作流定义 → 点击运行 → 选择「补数」
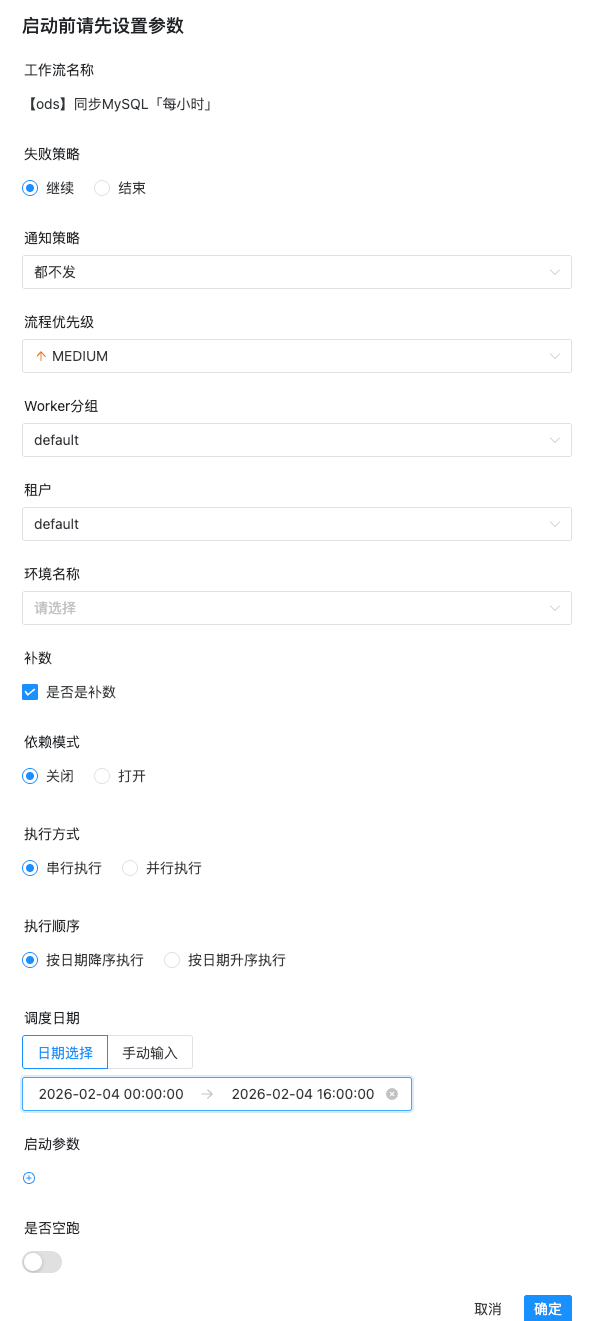
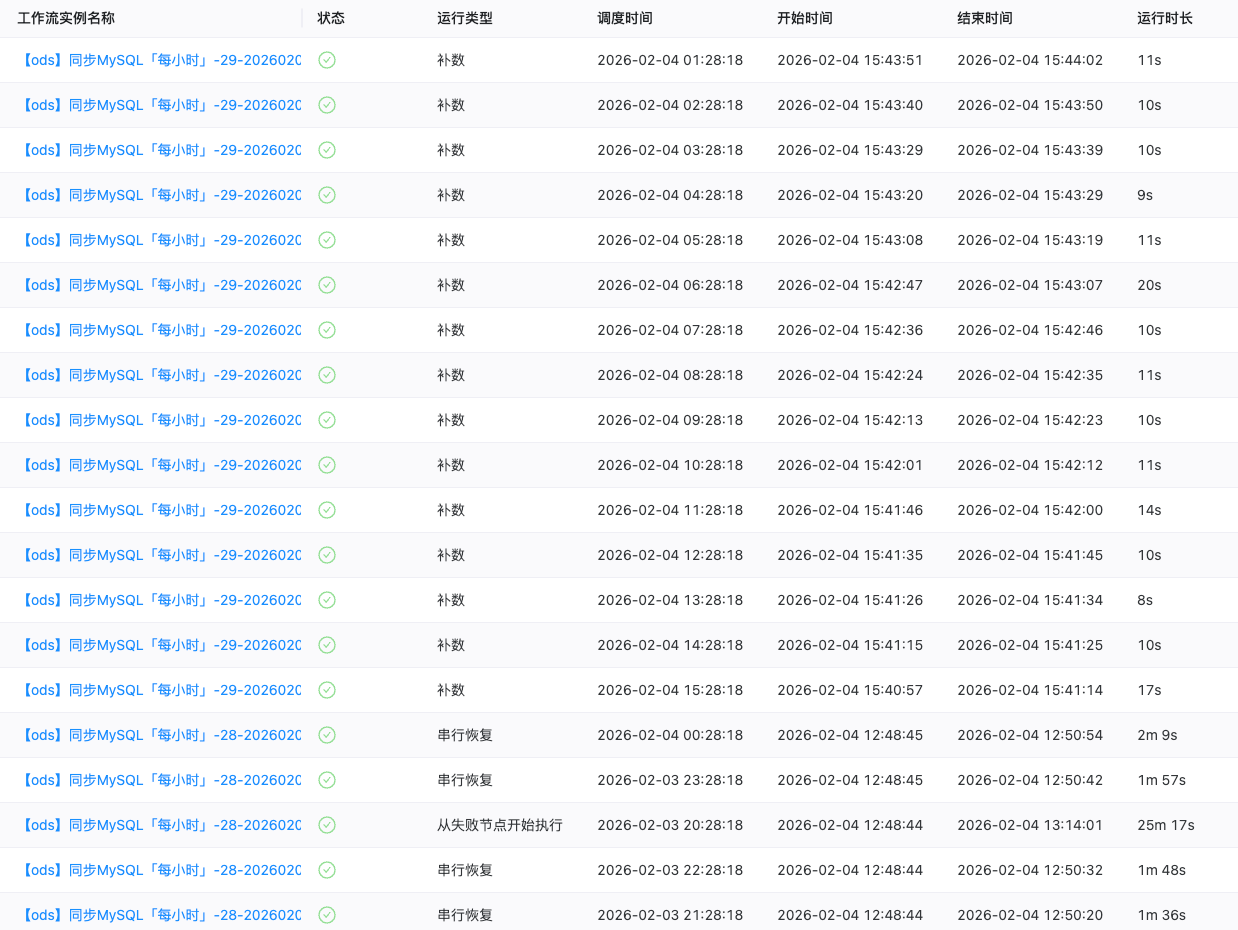
这次终于不报错了,任务顺利执行:
三、预防措施
吃一堑长一智,总结几点避坑经验:
3.1 执行策略怎么选(别顺手换成「串行抛弃」)
| 策略 | 实际行为 | 适用场景 |
|---|---|---|
| 并行 | 多个实例同时运行 | 无状态任务、幂等任务 |
| 串行等待 | 排队,前一个结束才轮到下一个 | 有严格顺序依赖的任务 |
| 串行抛弃 | 已有实例在跑时,把新来的这个置为「停止」丢掉,老的照常跑完 | 防止任务堆积 |
| 串行优先 | 把正在跑的都置为「准备停止」,让最新的实例上 | 只关心最新数据 |
⚠️ 查官方中文文档的话,「串行抛弃」那条会把你劝退。 它写的是「抛弃后生成的工作流实例并杀掉正在跑的实例」——又抛弃新的又杀掉老的,读着像两个都不留。
源码里不是这样。3.2.0 的串行分支逻辑很直白:发现有实例在跑,就把新来的这个置成
STOP(描述写的就是stop by serial_discard strategy)然后直接 return,正在跑的那个一根汗毛都没动。官方文档那半句是表述问题,不是行为描述。顺带提醒:真正会「停掉正在跑的」的是串行优先——它把在跑的实例全置成
READY_STOP(state=4)。眼熟吗?就是本文卡死的那个状态。所以串行优先反而更容易踩进同一个坑,别拿它当避坑方案。
那到底该换成哪个?先问一句:这个工作流丢一次调度,数据会不会缺?
| 你的任务 | 选哪个 | 为什么 |
|---|---|---|
| 每次跑的是全量 / 最新快照(丢一轮,下一轮自动补回来) | 串行抛弃 | 丢掉的是新实例,队伍永远不会堆,也就没有「队首卡死拖垮全队」这回事 |
| 每个调度时间点都必须跑一遍(增量同步、补数、按天分区落库) | 仍然用串行等待 | 换成抛弃 = 那个时间窗的数据永远不会被同步,除非你事后人工补数 |
⚠️ 本文这个工作流正好是第二类——它是往 ClickHouse 增量同步的补数任务,丢一个实例就是丢一段数据。所以对它而言,「串行等待」并没有选错,错的是没给这个策略配任何兜底。真正该补的是下面两条:§3.2 的超时失败(给队伍一个自动解锁开关)和 §3.3 的队列积压告警(队伍不动了要有人知道)。
别看完这一节就顺手把所有工作流都改成串行抛弃——上面表格第二行那类改完是会丢数据的,而且丢得悄无声息。
另外,改策略不会追溯清理历史积压——存量那些 state=14 还得按 §2.3 手工清一次,改策略只保证以后不再堆。
3.2 配置任务超时
在工作流定义的节点配置里打开「超时告警」,并勾上超时失败(只勾告警的话,任务照样无限期挂着)。
这一步在本文场景里格外值钱:超时失败会把实例推进终态,而终态才会触发 §1.2 那个 endProcess() 唤醒下一个排队实例。换句话说,超时时间不只是「别占资源」——它是串行队伍的兜底解锁开关。
值填多少? 串行等待的工作流有个额外约束:超时时间必须小于调度间隔,否则队伍排干的速度赶不上新实例进来的速度,照样越堆越多。所以取值先看两头——
- 下限:正常跑完的耗时留足余量,别让正常波动也被判超时
- 上限:调度间隔(小时级任务就别配 90 分钟的超时)
两头对不上,说明这个任务本身就跑得太久了,该先去优化任务,而不是靠调超时硬扛。
3.3 监控告警
- 监控下游服务(如 ClickHouse)的健康状态
- 任务失败及时告警——这次是隔天才发现 CK 挂了,一整晚的任务白跑
- 另外盯住串行队伍本身:光有「任务失败」告警不够,队伍卡死时可能一条失败都不再产生(后面全挂在「串行等待」上,根本轮不到它们失败)
第三条有个现成的信号可以直接抄,就是最老那个非终态实例已经挂了多久:
SELECT process_definition_code,
       COUNT(*)                                      AS `排队条数`,
       TIMESTAMPDIFF(MINUTE, MIN(start_time), NOW()) AS `最老一条已等分钟数`
FROM t_ds_process_instance
WHERE state IN (4, 14)
GROUP BY process_definition_code
HAVING `最老一条已等分钟数` > 60;
有结果就说明有队伍卡住了。这条比「任务失败数」更贴近本文这类故障——任务失败是正常的,失败之后队伍不动才是事故。
3.4 下游服务容灾
这次事故的根源是 ClickHouse 宕机。考虑:
- CK 集群部署,避免单点故障
- 任务侧增加重试机制和熔断逻辑
- 限制并发,防止重启后任务洪峰
最后一条是这次事故的起点——200+ 补数任务同时压上去,把刚喘过气的 CK 又按了回去(至于压垮队伍的那一下,见 §1.2)。怎么给下游 CK 做并发管控和多账号资源隔离,我另写过一篇:1800 行 INSERT 跑了 16 分钟:ClickHouse 并发洪流踩坑 + 多账号资源隔离方案。
四、总结
问题本质:串行等待的队伍只靠「前一个走到终态」这一个事件往前挪。队首一旦停在「准备停止」这种非终态上,就没有任何机制会再来推它一把——不是锁没释放,是根本没人来解锁。讽刺的是,把它推到非终态的正是我自己点的那下「停止」。
解决思路:UI 搞不定就下到元数据库,把 t_ds_process_instance 和 t_ds_task_instance 里 state=4/14 的僵尸记录清掉(两张表都要,且都带上 process_definition_code 限定),再回 UI 重新补数。
核心教训:
- 「串行等待」是把双刃剑——它假设队首总会走到终态,而这个假设会破。但补数、增量同步这类任务不能改成「串行抛弃」,那是拿丢数据换不堵车
- 别对已经失败的实例点「停止」——那是把它从终态推回非终态,等于亲手把队伍锁死
- 给任务配「超时失败」,等于给串行队伍装了个兜底解锁开关
- 调度系统的元数据库是最后的救命稻草,但改库只清占位、不触发调度事件,清完记得手动重跑
- 告警要盯「队伍不动了」,不能只盯「任务失败了」——这次前者才是事故
希望你永远用不上这篇文章的解决方案。但如果用上了,记得先备份再动手。
如果这篇文章帮你解决了问题,欢迎点赞收藏。有更优雅的方案,欢迎评论区交流。
延伸阅读
- DolphinScheduler 数据库迁移后工作流触发即死?AUTO_INCREMENT 回退引发 selectOne 翻车,全程追凶实录 —— UI 搞不定时,同样靠直接操作元数据库救活调度
- DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工 —— 另一次凌晨调度罢工,从现象到根因完整复盘
- 1800 行 INSERT 跑了 16 分钟:ClickHouse 并发洪流踩坑 + 多账号资源隔离方案 —— 本文正是补数洪峰把 CK 打挂,这篇讲怎么给下游 CK 做资源隔离
🏷️ 标签:DolphinScheduler 任务阻塞死锁 串行等待策略 ClickHouse 补数任务 调度容灾
📅 最后更新:2026-09-12,对照 DolphinScheduler 3.2.0 源码重写了死锁机制。如果你读过更早的版本,这三条务必看一眼:
- 🔴 §2.3 方案二的
UPDATE少了process_definition_code限定,照抄会把整个库里所有工作流的 4/14 记录一起刷成失败,包括正常排队中的。已补上。- 🔴 §2.3 方案一两条
DELETE的顺序反了(先主表后子表),照抄会让t_ds_task_instance的记录全变孤儿。已改成「先子表、后主表」,原处补注保留了孤儿捞回 SQL。- 🔴 §3.1 原来建议「用串行抛弃代替串行等待」,对补数 / 增量同步这类任务是错的——抛弃掉的实例意味着那个时间窗的数据永远不会被同步。已改成按「丢一次调度会不会缺数据」分流。
结论层面最大的变化:「失败任务不释放锁」这个说法被换掉了,它是比喻不是机制。真实链条是队伍只靠「前一个走到终态」这一个事件往前挪,而我点的那下「停止」恰好把队首从终态推回了非终态。标题也随之改成现在这个。
其余为补版本标注、状态码表加「是否终态」列、补监控 SQL 与内链、摘要与封面同步重渲。
📅 2026-09-11,正文顶部补引自制封面;§1.2 新增「串行等待死锁」时序图(mermaid 源码在正文)。
📅 2026-08-24,首次发现 §2.3 方案一的
DELETE顺序问题,当时以追加补注的形式给出正确顺序(正文 SQL 已于 2026-09-12 就地改正)。

腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 11
 0
- 0


 已为社区贡献12条内容

所有评论(0)