RAG大模型“外援“攻略:告别幻觉知识盲区,让你的AI秒变行业专家!
一、写在前面
如果你曾经把 GPT 接入过生产环境,大概率遇到过这样的尴尬:客户问“今年的企业所得税减免政策是什么”,模型却一本正经地给出了 2021 年的老黄历;或者用户把内部 API 文档贴给它,它愣是生造了一个根本不存在的接口。
幻觉、知识滞后、领域鸿沟,这些“大模型原生问题”并不是靠更多算力或更大参数就能彻底解决。
于是,社区开始把目光投向一种更务实、对开发者更友好的路线——RAG(Retrieval-Augmented Generation,检索增强生成)。
RAG 不是让模型“背得更多”,而是让它在答题前先去“翻书”。这听起来简单,却足以把我们从无穷无尽的微调、重训、对齐中解放出来。本文尝试用一个下午可读完的篇幅,把 RAG 的来龙去脉、落地细节、以及与传统 LLM 问答系统的差异讲透,让你能够在下一周的技术分享里直接拿来用。
二、为什么大模型需要“外援”
先放下对 AGI 的宏大叙事,回到工程现场。大语言模型在 2022 年之后突然变得好用,是因为它在“语言”这件事上做到了统计意义上的极致:**下一个 token 该出什么,它在概率上几乎从不犯错。**但语言之外,它有三个硬伤:
知识冻结
训练完成那一刻,世界就定格了。2024 年 1 月发布的新法规、上周才上线的内部接口文档,对模型来说都是盲区。
幻觉盛行
当概率分布不够尖锐时,模型会“打补丁”。于是你得到一段语法通顺、逻辑自洽,却完全捏造的回答。
领域盲区
通用语料再大,也覆盖不了企业的私有知识。客服对话里的“工单模板”、金融报告里的“科目映射表”,这些细节往往才是业务成败的关键。
过去,我们试图用“微调”去填补这些坑:收集最新语料、标注、再训、再对齐。流程长、成本高且不说,一旦业务规则又改了,循环又要重来。RAG 的思路则截然不同:与其让模型把知识“背”下来,不如让它在需要时去“查”资料。
三、RAG 的底层逻辑:检索 + 生成
把 RAG 想成一次开卷考试。学生(LLM)拿到题目(用户 query)后,先去图书馆(向量数据库)里找到最相关的章节(文档片段),再基于这些章节写答案。整套流程分为三步:
检索
用户问题被 Embedding 模型转成向量,在向量数据库里做近似最近邻(ANN)搜索,召回若干条最相关的文本块。
这里的关键是“文本块”的粒度:太粗(整篇文档)会引入噪音,太细(单句)可能缺少上下文。实践中常见做法是 256~512 token 的滑动窗口,再叠加标题、段落标签做二次过滤。
增强
把召回的文本块塞进 prompt,形成一段“增强上下文”。这一步看似简单,却暗藏玄机:
- 如果召回十条片段,一股脑塞进 prompt,容易超长。需要按相关度截断或做分层压缩。
- 片段之间可能有冲突,需要设计 prompt 模板告诉模型“若存在矛盾,以最新日期为准”。
- 私有知识往往包含表格、代码块,需要转成 Markdown 或纯文本,确保 LLM 能读懂。
生成
增强后的 prompt 进入 LLM,输出最终答案。由于 prompt 中已包含最新、最相关的证据,幻觉概率大幅下降;同时答案可以给出引用,方便人工复核。
四、RAG 的四大特征
实时性
向量数据库里的文档可以分钟级更新。法规、产品价格、FAQ 一改,只需把新文档切片、重新 Embedding,无需重训模型。
可溯源
回答里可以附带“出处”——第几页、第几段。对于金融、医疗、法律等高风险场景,这是合规审计的刚需。
低成本扩展领域
把私有 PDF、SQL 结果、工单记录统统丢进向量库,就能让通用 LLM 秒变“行业专家”。相比微调,数据准备周期从月降到天,甚至小时。
可控性
通过改写检索策略(BM25 + Embedding 混合打分)、调整 prompt 模板、甚至人工审核召回结果,开发者可以对最终答案做精细干预,而不是把命运交给黑盒模型。
五、RAG vs. 传统 LLM 问答系统:一场思维范式的迁移
传统做法:
- 把知识“预装”进模型,问答系统本质是一个函数调用:query → LLM → answer。
- 为了更新知识,需要重新训练或微调,成本高、周期长。
- 回答无法给出依据,一旦出错,只能“背锅”。
RAG 做法:
-
知识外置,模型只负责“阅读理解”。系统变成两段式:query → retriever → LLM → answer。
-
新增或修改知识只需操作向量库,分钟级生效。
-
回答附带出处,可人工复核,也可做自动评估(答案与出处的一致性打分)。
用一个真实场景做对比:
某券商客服每天要回答“科创板新股申购规则”。传统方案需要把监管文件、内部操作手册全部塞进微调语料,训练一次至少 GPU 周级;一旦交易所周末发补丁,又得重来。RAG 方案下,运维同学把最新 PDF 转成 Markdown,脚本自动切片入库,周一早上即可上线,问答准确率从 62% 提升到 91%,且每条答案都能跳转到原文条款。
六、动手之前:给开发者的三点建议
先验证“可检索性”
把私有文档丢进向量库之前,先用几条真实 query 做召回测试。如果发现“明明文档里有答案,却召不回来”,大概率是切片或 Embedding 模型不匹配。此时盲目上 prompt 模板只会南辕北辙。
把 prompt 当产品迭代
初期 prompt 可能只有三行:
已知信息:
{context}
问题:{query}
请用中文回答,并给出引用。
上线后根据用户反馈逐步加规则、加 fallback、加安全限制。prompt 的版本管理要像代码一样纳入 CI/CD。
留好“人工兜底”钩子
再完美的 RAG 也可能遇到召回为空的情况。设计一个阈值:当最高相关度低于 0.65 时,系统直接转人工客服,并把对话记录回流到知识库,实现闭环。
最近两年大模型发展很迅速,在理论研究方面得到很大的拓展,基础模型的能力也取得重大突破,大模型现在正在积极探索落地的方向,如果与各行各业结合起来是未来落地的一个重大研究方向
大模型应用工程师年包50w+属于中等水平,如果想要入门大模型,那现在正是最佳时机
2025年Agent的元年,2026年将会百花齐放,相应的应用将覆盖文本,视频,语音,图像等全模态
如果你对AI大模型入门感兴趣,那么你需要的话可以点击这里大模型重磅福利:入门进阶全套104G学习资源包免费分享!
扫描下方csdn官方合作二维码获取哦!

给大家推荐一个大模型应用学习路线
这个学习路线的具体内容如下:
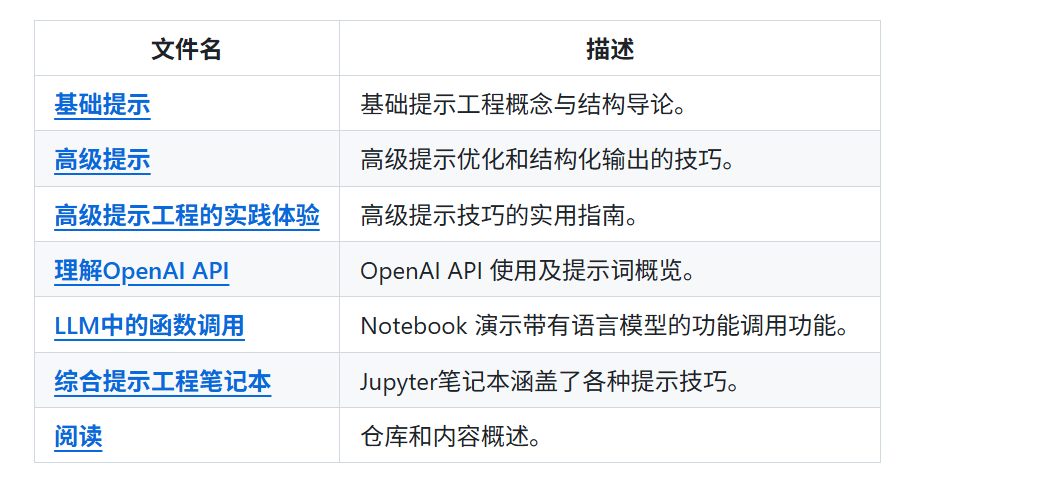
第一节:提示词工程
提示词是用于与AI模型沟通交流的,这一部分主要介绍基本概念和相应的实践,高级的提示词工程来实现模型最佳效果,以现实案例为基础进行案例讲解,在企业中除了微调之外,最喜欢的就是用提示词工程技术来实现模型性能的提升
第二节:检索增强生成(RAG)
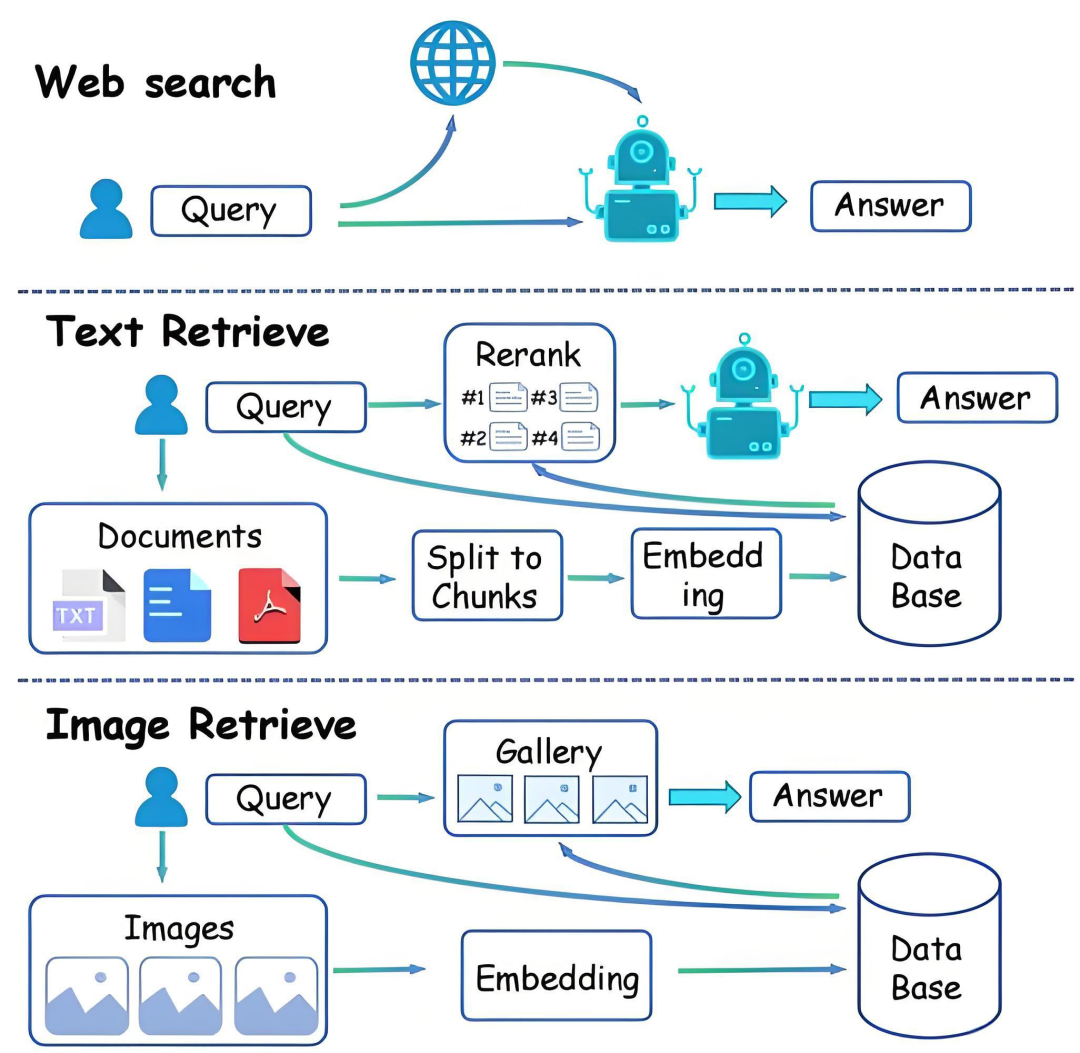
可能大家经常会看见RAG这个名词,这个就是将向量数据库与大模型结合的技术,通过外部知识来增强改进提升大模型的回答结果,这一部分主要介绍RAG架构与组件,从零开始搭建RAG系统,生成部署RAG,性能优化等
第三节:微调
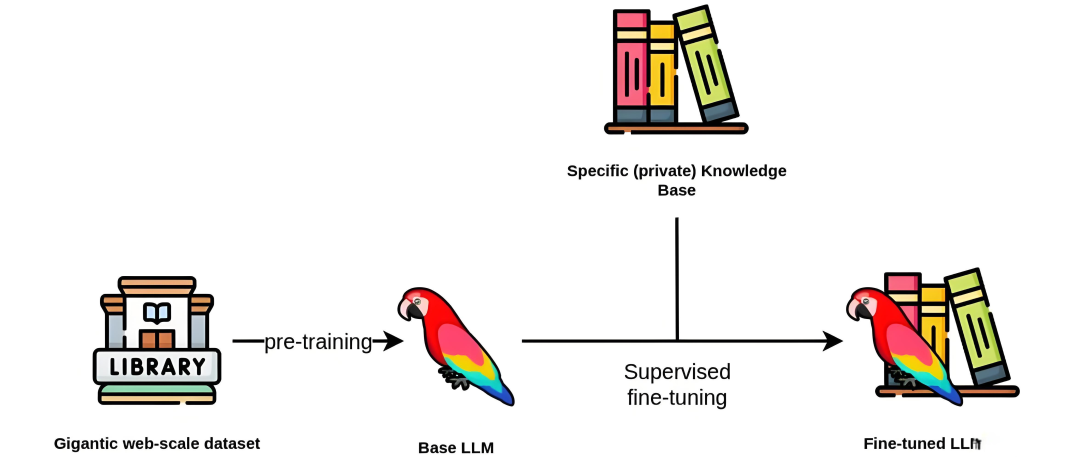
预训练之后的模型想要在具体任务上进行适配,那就需要通过微调来提升模型的性能,能满足定制化的需求,这一部分主要介绍微调的基础,模型适配技术,最佳实践的案例,以及资源优化等内容
第四节:模型部署
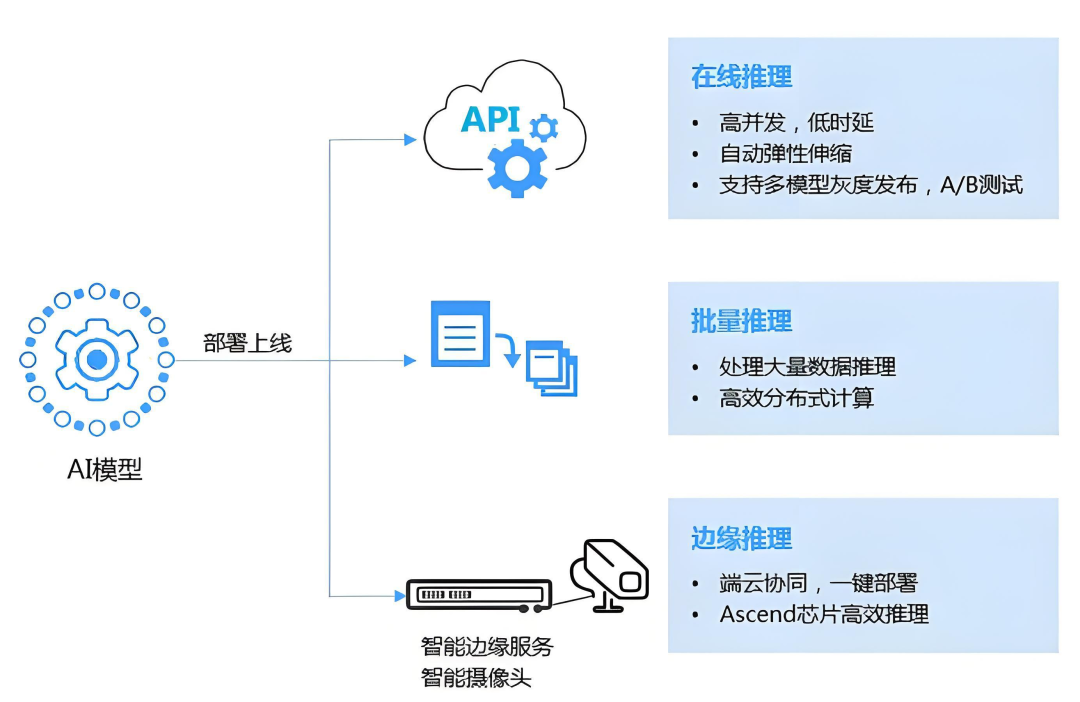
想要把预训练或者微调之后的模型应用于生产实践,那就需要部署,模型部署分为云端部署和本地部署,部署的过程中需要考虑硬件支持,服务器性能,以及对性能进行优化,使用过程中的监控维护等
第五节:人工智能系统和项目
这一部分主要介绍自主人工智能系统,包括代理框架,决策框架,多智能体系统,以及实际应用,然后通过实践项目应用前面学习到的知识,包括端到端的实现,行业相关情景等
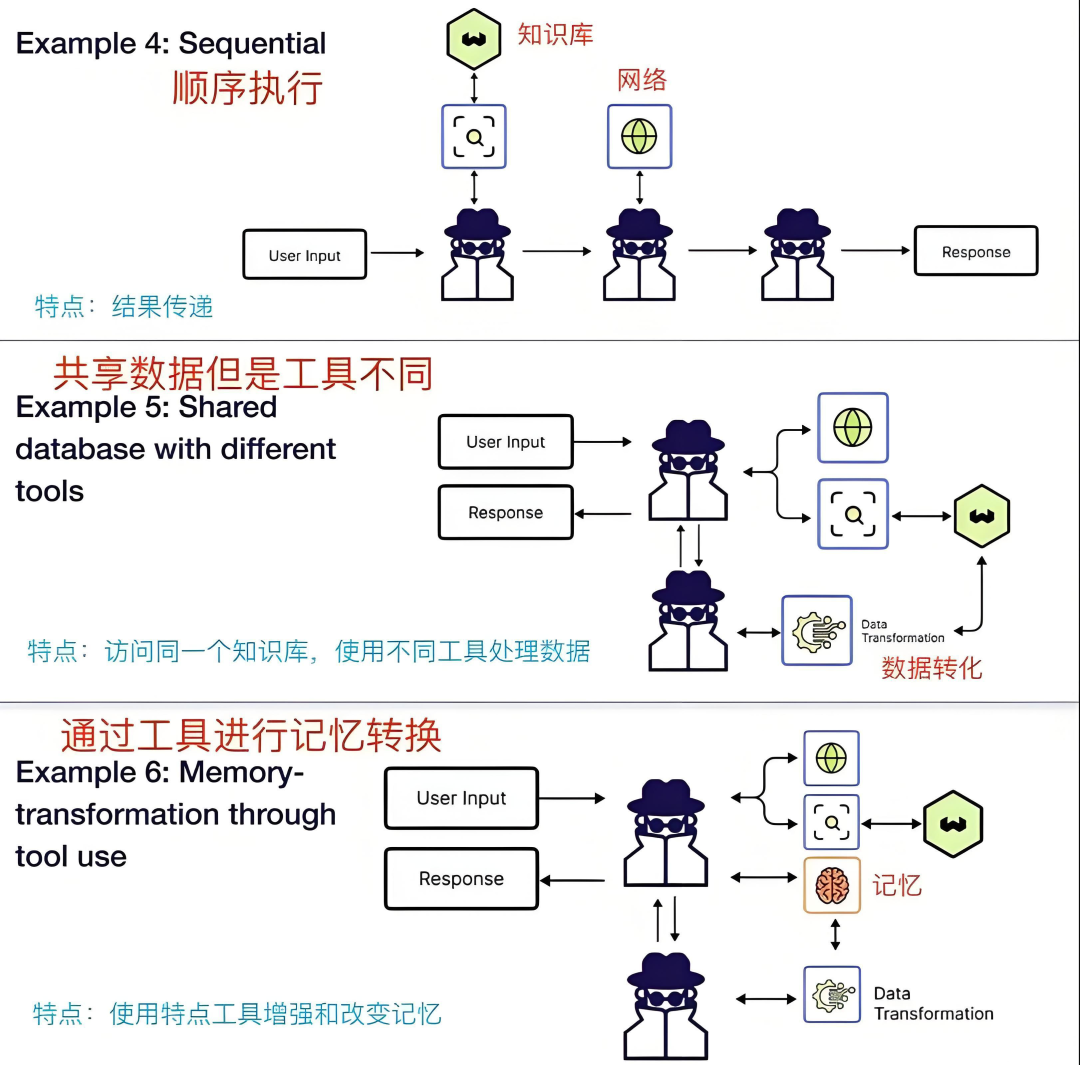
学完上面的大模型应用技术,就可以去做一些开源的项目,大模型领域现在非常注重项目的落地,后续可以学习一些Agent框架等内容
上面的资料做了一些整理,有需要的同学可以下方添加二维码获取(仅供学习使用)


腾讯云面向开发者汇聚海量精品云计算使用和开发经验,营造开放的云计算技术生态圈。
更多推荐
 7
 0
- 0


 已为社区贡献42条内容

所有评论(0)