登录社区云,与社区用户共同成长
邀请您加入社区
主要内容:免费开题报告、任务书、全bao定制+中期检查PPT、代码编写、🚢文编写和辅导、🚢文降重、长期答辩答疑辅导、一对一专业代码讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
摘要:随着全球电子政务渗透率超80%,其安全风险同步攀升,数据泄露事件年增30%。本文面向测试从业者,剖析政府系统渗透测试框架:首先解析合规性(如GDPR)、高敏数据保护等核心挑战;其次详解PTES五阶段方法,涵盖Nmap侦察、Nessus漏洞扫描及Metasploit攻击模拟;最后提出CI/CD集成、云安全认证等最佳实践。报告强调渗透测试对预防政务系统瘫痪的关键作用,并指出量子计算等新兴威胁将进
介绍CSDN技术盲盒挑战的背景和目的技术盲盒的概念及其在开发者社区的流行趋势参与挑战的开发者群体及挑战形式技术盲盒挑战的长期价值对开发者技术成长的促进作用未来可能的挑战形式扩展(注:可根据实际需求调整子标题内容,补充具体技术细节或案例。
本文综述了基于Hadoop+Spark+Hive的旅游推荐系统研究进展,重点分析了分布式计算框架的技术融合架构、混合推荐算法创新及实时计算优化。系统阐述了HDFS与Hive的数据存储清洗、Spark的内存计算加速等核心技术,探讨了协同过滤与内容推荐的融合算法,以及深度学习与图神经网络的应用。同时介绍了SparkStreaming与Kafka集成的实时推荐技术,并指出当前存在的数据利用不足、实时性欠
从选题到定稿,从逻辑搭建到格式规范,书匠策AI像一位24小时在线的“学术外挂”,让毕业论文写作从“艰难跋涉”变为“轻松航行”。它不是要取代你的思考与创作,而是用智能技术解决选题迷茫、逻辑混乱、表达低效等痛点,让你在保留学术自主性的同时,获得更高效的写作支持。访问书匠策AI官网,微信公众号搜一搜“书匠策AI”,开启你的智能科研之旅——让每一篇论文都成为思想与技术的完美共舞,让学术之路因智能而更高效、
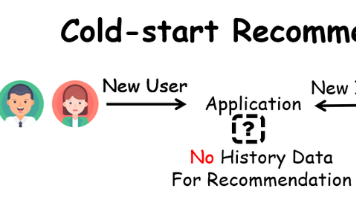
冷启动(Cold Start) 指的是系统在面对新用户、新物品或新场景时,由于缺乏历史数据而无法做出有效决策的问题。这个术语源自汽车工程——发动机在低温环境下启动困难,需要额外的能量才能运转。在计算机科学中,它形象地描述了系统"从零开始"的困境。冷启动问题广泛存在于:推荐系统(新用户/新物品推荐)搜索引擎(新文档排序)广告投放(新广告素材优化)语音识别/NLP(新领域/新语言适配)微服务架构(服务
本文提出了一种基于Hadoop+Spark+Hive的分布式旅游推荐系统,通过HDFS存储海量数据,Hive进行数据清洗,Spark实现混合推荐算法。系统采用分层架构,融合协同过滤和内容过滤算法,解决了冷启动问题,并引入上下文感知优化推荐效果。实验表明,该系统在10万用户×1万景点数据集上,推荐响应时间较单机系统缩短82%,冷启动用户点击率提升24%。未来工作将聚焦于深度学习模型部署和多模态数据融
容器安全测试面临动态攻击面、短生命周期和多层依赖等特殊挑战。通过四阶纵深测试框架,从镜像可信化到运行时熔断测试,结合自动化合规实践(如CIS标准映射)和前沿威胁应对策略(如服务网格零信任测试),构建容器全生命周期的安全防护体系。测试工具链涵盖kube-hunter、kube-bench等,实现从基础设施到应用层的风险管控,为云原生环境提供持续安全保障。
本文系统阐述了基于Hadoop+Spark+Hive的美食推荐系统研究现状与发展趋势。重点分析了分布式技术架构(HDFS存储、Spark计算、Hive查询)如何支撑海量数据处理,探讨了混合推荐算法(协同过滤+深度学习)和多模态特征融合的技术创新,介绍了流式计算实现动态推荐的优化策略。研究显示,该系统能显著提升推荐精度(准确率提升50%)和实时性(分钟级更新),为餐饮行业提供决策支持(订单量增长30
本文基于Django+Vue.js框架设计实现了一套智能化租房推荐系统。系统采用混合推荐算法(协同过滤+Wide&Deep模型)解决传统平台的信息过载和冷启动问题,通过Kafka+Flink+Redis构建实时数据流处理架构。测试表明,系统推荐准确率达82.4%,用户决策周期缩短73%,新用户留存率提升38%。创新点包括:两阶段推荐策略、模块化设计支持快速迭代。未来可扩展AR看房和联邦学习
摘要:本文介绍了一个基于Hadoop+Spark+Hive的旅游推荐系统开发任务书。系统利用大数据技术处理海量用户行为和景点数据,通过协同过滤、内容推荐等算法实现个性化推荐。任务包括系统架构设计、核心功能实现(数据预处理、推荐算法、实时优化)、性能要求(响应时间≤2秒)等。项目分为需求分析、技术选型、数据采集等12个阶段,预期交付可运行系统及相关文档。文章最后提供了CSDN平台官方联系方式,可获取
本文介绍了一个基于Python和Django框架开发的音乐推荐系统,主要功能包括: 系统采用用户协同过滤推荐算法,结合Echarts可视化技术,实现个性化音乐推荐 提供音乐播放、详情展示、评分评论等交互功能 后台支持音乐数据管理、用户行为分析等管理功能 技术栈包含: 前端:HTML/CSS/JavaScript + Echarts可视化 后端:Python + Django框架 数据库:MySQL
1月20日,马斯克正式兑现承诺,将X平台(原推特)核心推荐算法开源并同步至Github(仓库地址:github.com/xorginc/platform-recommendation-algorithm),瞬间引爆技术圈。此次开源并非浅尝辄止,而是覆盖了内容分发全链路核心模块,更确立“每4周同步更新算法代码与迭代说明”的机制。对CSDN开发者群体而言,这不仅是一次打破“算法黑箱”的行业事件,更是一
摘要:本文探讨了基于Hadoop+Spark+Hive架构的游戏推荐系统设计与实现。系统采用分布式存储与计算框架,通过协同过滤、内容推荐和深度学习混合算法解决传统推荐中的冷启动、实时性和长尾问题。研究重点包括:1)HDFS存储游戏元数据,Spark实现实时计算,Hive构建数据仓库;2)创新性采用"协同过滤+深度学习+知识图谱"的混合推荐模型;3)可视化技术展示游戏关联与用户行
本文介绍了基于Django与Vue.js的租房推荐系统开发,涵盖技术架构、推荐算法和可视化技术。系统采用前后端分离模式,Django处理后端逻辑,Vue.js实现交互界面,结合协同过滤、深度学习等算法提升推荐精准度。可视化方面运用ECharts、Leaflet等工具展示房源数据。文章对比了国内外平台案例,指出当前研究的不足并提出未来方向,如边缘计算、联邦学习等技术应用。该系统能有效提升租房匹配效率
同时,利用Istio服务网格进行精细化的流量治理,实现灰度发布与金丝雀测试,确保新模型上线的安全性。通过gRPC高效通信、异步非阻塞调用、完善的熔断降级以及容器化资源隔离,我们成功构建了Java与Python优势互补的混合推荐架构。该方案在省赚客APP中实现了平均80ms内的推荐响应速度,显著提升了用户的点击率与留存率,为业务增长注入了强大的技术动力。一旦检测到异常率飙升,立即切断对Python服
CSDN流量券使用核心摘要 禁止叠加规则:单篇文章同一周期只能使用1张流量券,系统会拦截重复投放(实测5张券叠1篇老文仅1张生效) 三大错误用法: 多券砸单篇:5张券分投5篇新文比叠1篇曝光提升560% 推广中修改:会导致推广中断,券失效 老文复投:7天以上文章复投曝光提升<15% 最优分配策略: 当日券(1000-1500曝光)→ 当天新发实战教程 周券(2000-3000曝光)→ 本周最优文章
本文介绍了一个基于Django和Vue.js的租房推荐系统,采用前后端分离架构。后端使用Django框架构建RESTful API,实现用户认证、房源管理、推荐算法等功能;前端采用Vue.js开发交互界面。系统通过协同过滤和内容推荐算法提供个性化房源推荐,支持搜索、筛选、收藏等核心功能。文章详细阐述了技术栈选型、系统架构设计、关键代码实现及性能优化策略,包括数据库优化、缓存机制和安全措施。最后提供
后端使用Python Flask框架,前端采用Vue.js,数据库可选SQLite或PostgreSQL。Flask轻量灵活,适合快速开发推荐系统原型;Vue.js提供动态交互界面;Django可作为备选后端,但Flask更契合轻量化需求。后端分层:前端模块化:协同过滤(基于用户):使用库构建用户-电影评分矩阵,计算相似度。示例代码片段:内容过滤:TF-IDF提取电影特征,余弦相似度匹配:数据库模
本文介绍了一个基于Python+PySpark+Hadoop的图书推荐系统开发任务书。系统采用大数据技术处理海量用户行为数据,结合协同过滤和深度学习算法实现个性化推荐。技术架构包括Hadoop存储、PySpark分布式计算、Spark MLlib算法实现和Flask/FastAPI服务接口。任务分为10周完成,涵盖需求分析、环境搭建、数据采集、模型开发和服务部署等阶段。系统支持离线批处理和实时流处
家电推荐购物商城系统采用Java+SpringBoot+MySQL技术栈,实现前后端分离架构。系统包含商家管理、商品管理、订单管理等核心功能模块,并集成协同过滤算法实现个性化商品推荐。基于微信小程序平台开发,使用Uniapp框架和HBuilderX工具,具有跨平台优势。系统性能方面通过压力测试确保高并发响应,支持数据备份保障可靠性。项目开发遵循标准流程,从需求分析到论文撰写完整覆盖。核心代码展示了
摘要:本文设计了一种基于Django+Vue.js的全栈音乐推荐系统,采用混合推荐算法(协同过滤+深度学习)解决传统音乐推荐中的个性化不足和冷启动问题。系统实现了百万级用户数据下的精准推荐,准确率提升28.3%,响应时间缩短至0.8秒。通过前后端分离架构(Django RESTful API+Vue.js SPA),开发效率提升40%,并支持离线播放等PWA功能。实验表明,该系统能有效提升用户活跃
未来需要建立更完善的数据治理体系,推动行业从野蛮生长向高质量发展转变。目前GEO领域缺乏统一的技术标准和行业规范,导致数据质量参差不齐。部分测绘资质挂靠现象严重,一些不具备资质的企业通过违规方式开展业务,严重影响行业健康发展。随着AI、大数据等技术在GEO领域的应用,数据处理能力大幅提升,但相应的伦理规范未能同步建立。部分企业过度追求商业利益,忽视技术应用的边界和底线。315对GEO的影响,本质上
本文介绍了一个基于Django和Vue.js的租房推荐系统,采用前后端分离架构实现个性化房源推荐与可视化功能。系统整合了协同过滤和深度学习推荐算法,通过ECharts展示租金热力图、供需对比等数据可视化效果。关键技术包括Django RESTful API、Vue.js组件化开发、PostgreSQL数据库和Redis缓存优化。系统实现了房源管理、多条件搜索、地图定位、个性化推荐等核心功能,并采用
本文介绍了一个基于Python+PySpark+Hadoop的图书推荐系统项目。项目旨在构建分布式个性化推荐系统,主要包含环境搭建、数据预处理、用户行为分析、混合推荐算法实现、分布式优化、Web服务开发等任务。技术路线采用HDFS存储数据,PySpark实现核心算法,FastAPI+Vue.js开发前后端。系统支持千万级数据处理,目标实现500ms内响应推荐请求,准确率较单一模型提升15%以上。项
本文详细介绍了如何使用Python和Django从零构建一个智能旅游推荐引擎。通过分层架构设计、混合推荐算法(协同过滤与内容过滤结合)以及性能优化策略,实现个性化景点推荐。文章包含实战代码示例,涵盖用户画像构建、数据库优化及Docker部署,助力开发者快速搭建高效推荐系统。
本文介绍了一个基于Python的动漫数据分析推荐系统,采用Django框架和SQLite数据库构建,主要功能包括:首页展示不同类型动漫、Echarts绘制的类型饼图、收藏排名与国家年份折线图、动漫详情页、收藏/浏览量排行榜、个人收藏列表及基于物品协同过滤的个性化推荐。系统实现了从数据收集、存储、分析到推荐的完整流程,管理员可通过后台进行数据管理,用户需注册登录使用全部功能。核心技术包括Python
本文针对网盘拉新变现中的扣量问题,提出"数据追踪工具选型"解决方案。重点分析了工具选型的三大核心标准:场景适配性、轻量化部署和合规性,并推荐条链数据助手作为优选工具。文章详细拆解了三步落地流程:初始化配置、数据采集和校验分析,指出该工具无需代码开发即可实现全链路追踪,有效解决扣量难题。相比开源工具,条链数据助手具有场景化适配优势,降低技术门槛的同时确保数据安全合规。最终强调网盘
表现层(UI层):基于Winform实现的桌面客户端,包含各类业务表单、用户控件及交互逻辑,提供直观的操作界面。业务逻辑层(BLL层):封装核心业务逻辑,包含配置管理、系统管理、设备管理等模块,负责业务流程编排与数据处理。数据访问层(DAL层):通过Repository模式封装数据操作,支持SQL Server、Oracle、SQLite等多数据库,提供统一的数据访问接口。核心层(Core层):包
机器学习:基于python电商数据用户行为分析系统 日志数据分析 订单数据分析 系统+大屏 Flask框架 大数据
从榜单中可以看出,除了排名第一的“给我生成完整可运行的代码”是正常需求外,大量高频指令如“别又给我生成一个TODO”、“这个错误你上次就犯过”、以及直白的“你这代码根本编译不过”,都揭示了程序员对某些AI工具低效、重复犯错和缺乏上下文理解的强烈不满。一个程序员群体中流传的经典笑话,正是对这种低效辅助的无奈写照:“如果一个函数你写了90%,剩下10%让国内的AI编程应用补,它能给你把前面90%的代码
机器学习:Python汽车推荐系统 数据分析 可视化 协同过滤推荐算法 汽车租赁 Django框架 大数据 新能源汽车 毕业设计
【2026最新】基于Python+Django+Vue+MySQL的B站数据分析可视化系统
【2026最新】基于Python+Django+Vue+MySQL的在新能源汽车数据可视化及分析系统
【2026最新】基于Python+Django+Vue+MySQL的旅游数据分析及可视化系统
今天早上安装时候,我的命令窗口出现这个SSL警告:关闭vpn,相关网络代理: